

IOSG:暗号AIの聖杯、分散型トレーニングのフロンティア探究

原題:「IOSG Weekly Brief|暗号AIの聖杯:分散型トレーニングのフロンティア探究 #280」
原著者:Jacob Zhao (X @0xjacobzhao)、IOSG Ventures
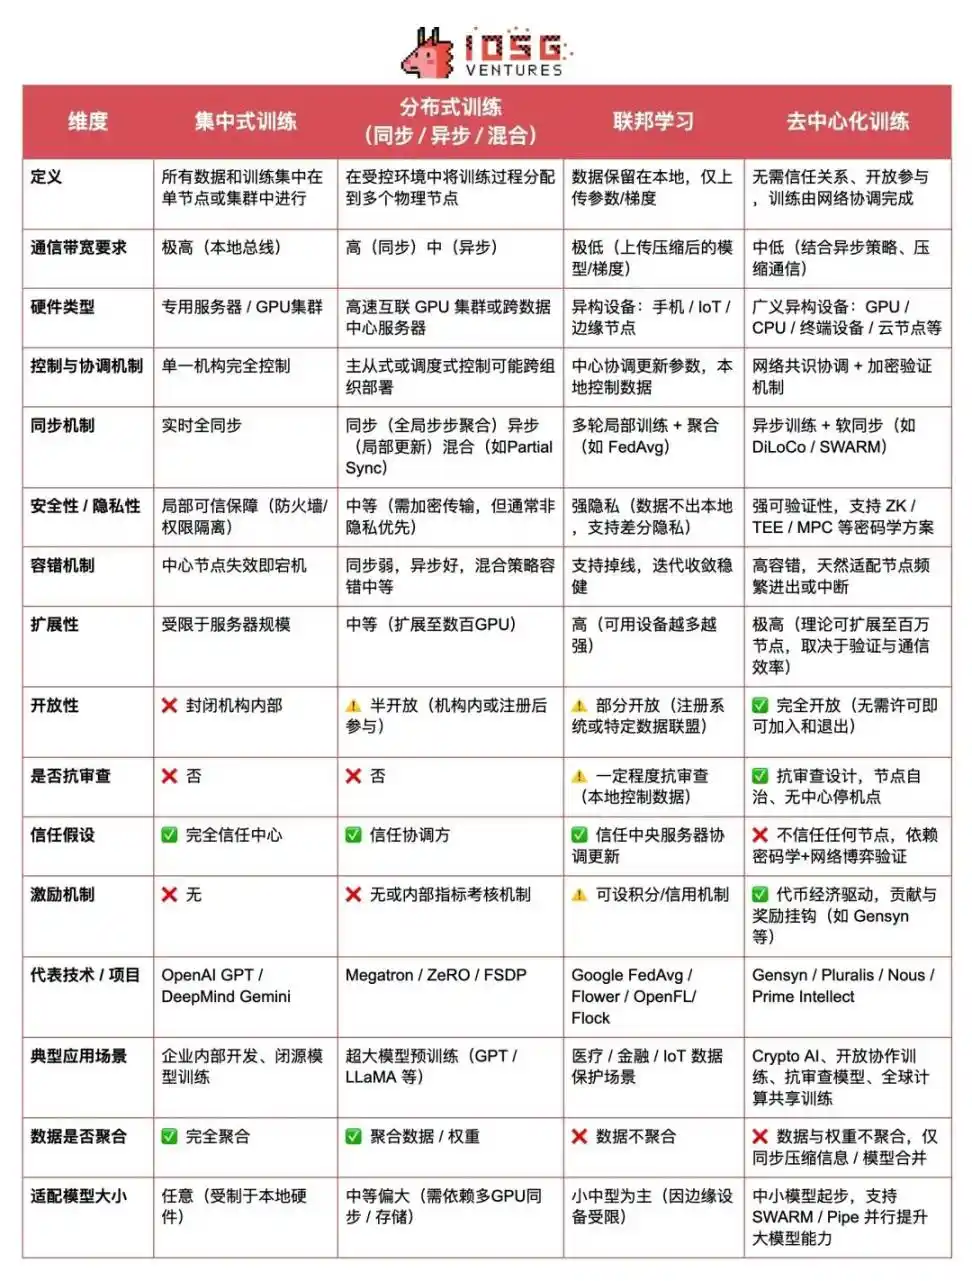
AIのバリューチェーン全体において、モデルのトレーニングは最も高いリソース消費と技術的限界を伴うリンクであり、モデルの能力の上限と実際の適用効果を直接決定づけます。推論段階の軽量な呼び出しと比較すると、トレーニングプロセスは継続的な大規模な計算能力の投入、複雑なデータ処理プロセス、そして高強度の最適化アルゴリズムのサポートを必要とし、AIシステム構築における真の「重工業」と言えるでしょう。アーキテクチャパラダイムの観点から見ると、トレーニング方法は集中型トレーニング、分散型トレーニング、連合学習、そして本稿の焦点である分散型トレーニングの4つのカテゴリーに分けられます。
集中型トレーニングは、単一の組織がローカルの高性能クラスターでトレーニングプロセス全体を完了する最も一般的な従来の方法です。ハードウェア(NVIDIA GPUなど)、基盤ソフトウェア(CUDA、cuDNN)、クラスタースケジューリングシステム(Kubernetesなど)、トレーニングフレームワーク(NCCLバックエンドに基づくPyTorchなど)まで、すべてのコンポーネントが統合された制御システムによって調整および操作されます。この緊密に連携するアーキテクチャは、メモリ共有、勾配同期、フォールトトレランスメカニズムの効率を最適化し、GPTやGeminiなどの大規模モデルのトレーニングに非常に適しています。高効率と制御可能なリソースの利点がありますが、同時にデータの独占、リソース障壁、エネルギー消費、単一点リスクなどの問題もあります。
分散型トレーニングは、現在、大規模モデルのトレーニングの主流の方法です。その核心は、モデル学習タスクを分解し、複数のマシンに分散して協調実行することで、単一マシンのコンピューティングとストレージのボトルネックを打破することです。物理的には「分散」機能を備えていますが、全体的なスケジューリングと同期は依然として中央集権的な組織によって制御されています。多くの場合、高速LAN環境で実行されます。NVLink高速相互接続バス技術を介して、マスターノードはすべてのサブタスクを調整します。主流の手法には以下が含まれます。・データ並列:・各ノードは異なるデータパラメータを共有するために学習し、モデルの重みを一致させる必要があります。・モデル並列:・モデルの異なる部分を異なるノードに展開することで、高いスケーラビリティを実現します。・パイプライン並列:・段階的に直列実行することでスループットを向上させます。・テンソル並列:・行列計算を細分化することで並列粒度を向上させます。
分散トレーニングは、「集中制御 + 分散実行」を組み合わせたもので、同じ上司が複数の「オフィス」従業員にリモートで指示を出し、協力してタスクを完了させるようなものです。現在、主流の大規模モデル(GPT-4、Gemini、LLaMAなど)のほとんどすべてがこの方法でトレーニングされています。
分散トレーニングは、よりオープンで検閲耐性のある将来の方向性を表しています。その中核となる特徴は、複数の信頼できないノード(家庭用コンピュータ、クラウドGPU、エッジデバイスなど)が、中央コーディネーターなしでトレーニングタスクを完了するために協力することです。通常はプロトコル駆動型のタスク分散とコラボレーションを通じて、そして貢献の誠実性を確保するために暗号インセンティブメカニズムの助けを借りて行われます。このモデルが直面する主な課題は次のとおりです。·異種デバイスと困難なセグメンテーション:異種デバイスの調整が難しく、タスクのセグメンテーションが非効率的です。·通信効率のボトルネック:ネットワーク通信が不安定で、勾配同期のボトルネックが顕著です。・信頼できる実行環境の欠如:信頼できる実行環境がないため、ノードが実際に計算に関与しているかどうかの検証が困難です。・統一された調整の欠如:中央スケジューラが存在せず、タスクの分散と異常時のロールバックメカニズムが複雑です。分散学習とは、世界中のボランティアがそれぞれ計算能力を持ち寄って協力的にモデルを学習することを意味しますが、「真に実現可能な大規模分散学習」は、システムアーキテクチャ、通信プロトコル、暗号セキュリティ、経済メカニズム、モデル検証など、複数のレベルを含む体系的なエンジニアリング課題です。しかし、「協力が効果的であること+インセンティブが誠実であること+結果が正しいこと」は、まだ初期のプロトタイプ探索段階にあります。
分散と分散の過渡的形態であるFederated Learningは、ローカルデータ保持とモデルパラメータの集中集約を重視しており、医療や金融などのプライバシーコンプライアンスを重視するシナリオに適しています。連合学習は、分散学習のエンジニアリング構造とローカル調整機能に加え、分散学習のデータ分散の利点も備えていますが、依然として信頼できるコーディネータに依存しており、完全なオープン性と検閲耐性といった特性を備えていません。プライバシーコンプライアンスのシナリオにおいては、「制御された分散化」ソリューションとみなすことができます。学習タスク、信頼構造、通信メカニズムの面で比較的軽度であり、業界における過渡的な展開アーキテクチャとしてより適しています。
AI学習パラダイム総合比較表(技術アーキテクチャ×信頼インセンティブ×アプリケーション特性)
I. 分散学習の境界、機会、現実的な道筋
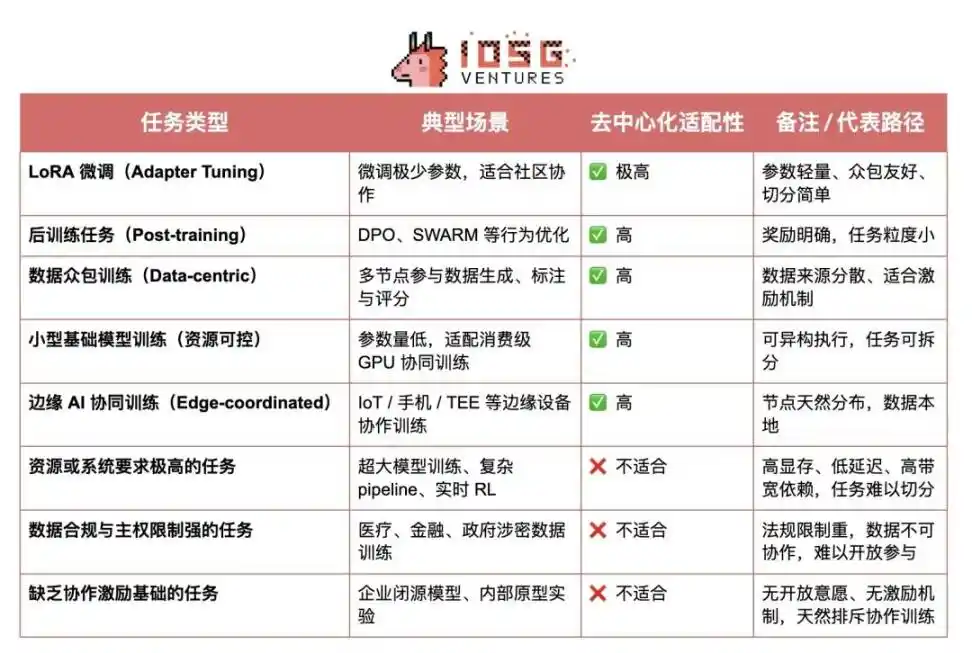
トレーニングパラダイムの観点から見ると、分散トレーニングはあらゆるタイプのタスクに適しているわけではありません。タスクの構造が複雑であったり、リソース要件が非常に高かったり、コラボレーションの難易度が高かったりするシナリオでは、異種かつ信頼できないノード間での効率的な完了には当然ながら適していません。例えば、大規模モデルのトレーニングは、大容量のビデオメモリ、低レイテンシ、高速帯域幅に依存することが多く、オープンネットワークではこれらを効果的に分割・同期することが困難です。また、データプライバシーと主権に関する制約が強いタスク(医療、金融、機密データなど)は、法令遵守と倫理的制約によって制限され、オープンに共有することはできません。さらに、コラボレーションのインセンティブ基盤が欠如しているタスク(企業のクローズドソースモデルや社内プロトタイプトレーニングなど)は、外部からの参加動機が欠如しています。これらの制約が相まって、分散トレーニングの現在の実用的な限界を構成しています。
しかし、これは分散トレーニングが誤った提案であることを意味するものではありません。実際、分散トレーニングは、軽量で並列化が容易で、インセンティブ付与が可能なタスクタイプにおいて、明確な応用可能性を示しています。これには、LoRA の微調整、行動アライメント後のトレーニング タスク (RLHF、DPO など)、データ クラウドソーシング トレーニングおよびアノテーション タスク、リソース制御可能な小規模基本モデル トレーニング、エッジ デバイスを含む共同トレーニング シナリオなどが含まれますが、これらに限定されません。これらのタスクは一般に、高い並列性、低い結合、異種の計算能力に対する許容度という特性があり、P2P ネットワーク、Swarm プロトコル、分散オプティマイザーなどを介した共同トレーニングに非常に適しています。
分散トレーニング タスクの適応性の概要
II. 古典的な分散トレーニング プロジェクトの分析
現在、分散トレーニングと連合学習のフロンティア分野における代表的なブロックチェーン プロジェクトには、Prime Intellect、Pluralis.ai、Gensyn、Nous Research、Flock.io などがあります。技術革新とエンジニアリング実装の難しさという観点から、Prime Intellect、Nous Research、Pluralis.aiは、システムアーキテクチャとアルゴリズム設計においてより独創的な探求を提示し、現在の理論研究の最先端を担っています。一方、GensynとFlock.ioの実装パスは比較的明確で、初期のエンジニアリングの進展が見られます。本稿では、これら5つのプロジェクトの背後にあるコアテクノロジーとエンジニアリングアーキテクチャを一つずつ分析し、分散型AIトレーニングシステムにおけるそれらの相違点と補完関係をさらに探っていきます。
Prime Intellect:検証可能なトレーニング軌跡を持つ強化学習協調ネットワークのパイオニア
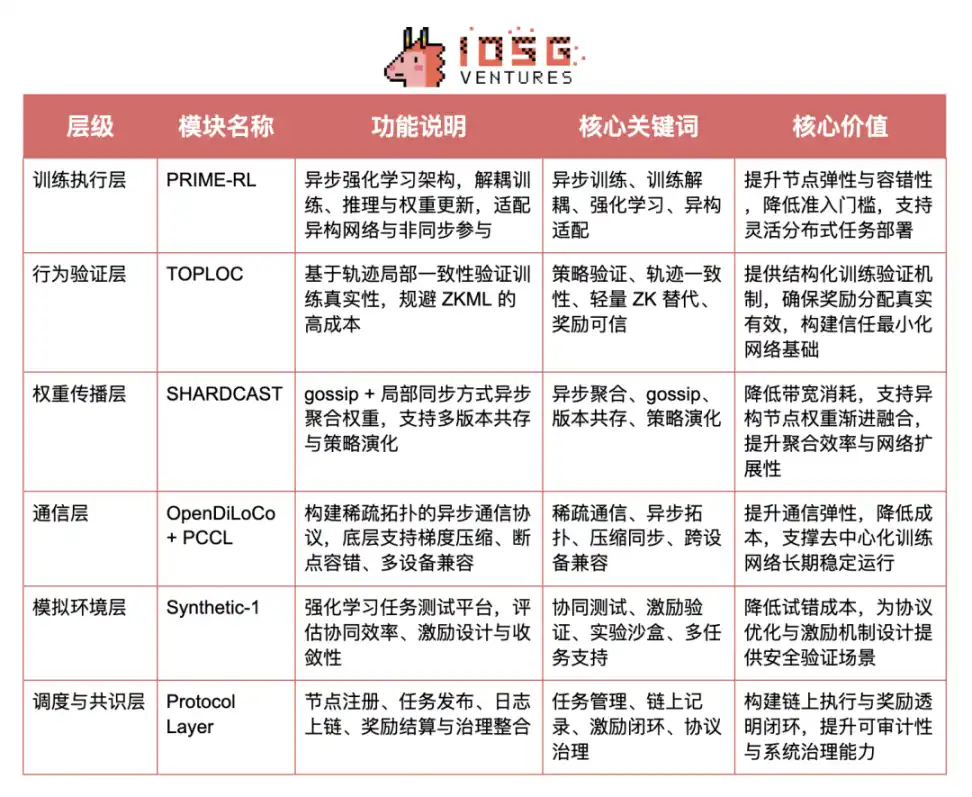
Prime Intellectは、誰もがトレーニングに参加でき、コンピューティングへの貢献に対して信頼できる報酬を受け取ることができる、トラストレスなAIトレーニングネットワークの構築に取り組んでいます。Prime Intellectは、PRIME-RL + TOPLOC + SHARDCASTの3つのモジュールを通じて、検証可能でオープン、かつ完全にインセンティブ化されたAI分散型トレーニングシステムの構築を目指しています。
01 Prime Intellect プロトコル スタック構造と主要モジュール値
02 Prime Intellect トレーニング主要メカニズムの詳細な説明
PRIME-RL: 分離された非同期強化学習タスク アーキテクチャ
PRIME-RL は、Prime Intellect が分散トレーニング シナリオ向けにカスタマイズしたタスク モデリングおよび実行フレームワークであり、異種ネットワークと非同期参加向けに設計されています。強化学習を優先適応オブジェクトとして使用し、トレーニング、推論、重みアップロード プロセスを構造的に分離することで、各トレーニング ノードがローカルで独立してタスク サイクルを完了し、標準化されたインターフェイスを介して検証および集約メカニズムと連携できるようにします。従来の教師あり学習プロセスと比較して、PRIME-RLは、集中スケジューリングのない環境で柔軟なトレーニングを実現するのに適しており、システムの複雑さを軽減するだけでなく、マルチタスクの並列処理と戦略の進化をサポートするための基盤を築きます。
TOPLOC:軽量トレーニング動作検証メカニズム
TOPLOC(Trusted Observation & Policy-Locality Check)は、Prime Intellectが提案するトレーニング検証可能性の中核メカニズムであり、ノードが観測データに基づいて実際に有効なポリシー学習を完了したかどうかを判断するために使用されます。ZKMLなどの重いソリューションとは異なり、TOPLOCは完全なモデルの再計算に依存せず、「観測シーケンス ↔ ポリシー更新」間のローカル一貫性軌跡を分析することで軽量な構造検証を完了します。トレーニング中の動作軌跡を検証可能なオブジェクトに変換するのは初めてであり、これはトラストレスなトレーニング報酬割り当てを実現するための重要なイノベーションであり、監査可能でインセンティブ付きの分散型共同トレーニング ネットワークを構築するための実現可能なパスを提供します。
SHARDCAST: 非同期重み集約および伝播プロトコル
SHARDCAST は、Prime Intellect が設計した重み伝播および集約プロトコルで、非同期、帯域幅制限、可変ノード状態を持つ実際のネットワーク環境に最適化されています。ゴシップ伝播メカニズムとローカル同期戦略を組み合わせることで、複数のノードが非同期状態で部分的な更新を継続的に送信し、重みの段階的な収束とマルチバージョンの進化を実現できます。集中型または同期型の AllReduce 方式と比較して、SHARDCAST は分散型トレーニングのスケーラビリティとフォールト トレランスを大幅に改善し、安定した重みのコンセンサスと継続的なトレーニング反復を構築するための中核的な基盤となります。
OpenDiLoCo: スパース非同期通信フレームワーク
OpenDiLoCo は、DeepMind が提唱する DiLoCo コンセプトに基づき、Prime Intellect チームによって独自に実装されオープンソース化された通信最適化フレームワークです。分散トレーニングでよく見られる帯域幅の制約、デバイスの異質性、ノードの不安定性などの課題に対応するように設計されています。そのアーキテクチャはデータ並列性に基づいています。Ring、Expander、Small-World などのスパース トポロジ構造を構築することで、グローバル同期の高い通信オーバーヘッドを回避し、モデルの協調トレーニングを完了するためにローカルの隣接ノードのみに依存します。非同期更新とブレークポイントのフォールト トレランス メカニズムと組み合わせることで、OpenDiLoCo はコンシューマー グレードの GPU とエッジ デバイスがトレーニング タスクに安定して参加できるようにし、グローバル協調トレーニングの参加を大幅に改善します。これは、分散トレーニング ネットワークを構築するための重要な通信インフラストラクチャの 1 つです。
PCCL:協調型通信ライブラリ
PCCL(Prime Collective Communication Library)は、Prime Intellectが分散型AIトレーニング環境向けにカスタマイズした軽量通信ライブラリです。異種デバイスや低帯域幅ネットワークにおける従来の通信ライブラリ(NCCL、Glooなど)の適応ボトルネックを解決することを目的としています。PCCLは、スパーストポロジ、勾配圧縮、低精度同期、ブレークポイントリカバリをサポートし、コンシューマーグレードのGPUや不安定なノードでも実行できます。OpenDiLoCoプロトコルの非同期通信機能をサポートする基盤コンポーネントです。トレーニングネットワークの帯域幅許容度とデバイス互換性を大幅に向上させ、真にオープンでトラストレスな協調型トレーニングネットワークを構築するための「ラストマイル」通信基盤を開拓します。
03 プライムインテリクトインセンティブネットワークと役割分担
プライムインテリクトは、誰でもタスクに参加でき、実際の貢献度に基づいて報酬を受け取ることができる、許可不要で検証可能、かつ経済的にインセンティブ化されたトレーニングネットワークを構築しました。このプロトコルは、以下の3つのコアロールに基づいて実行されます。·タスクイニシエーター:トレーニング環境、初期モデル、報酬関数、検証基準を定義します。·トレーニングノード:ローカルトレーニングを実行し、重みの更新と観測軌跡を送信します。·検証ノード:TOPLOCメカニズムを使用してトレーニング動作の信頼性を検証し、報酬計算と戦略の集約に参加します。
プロトコルの中核プロセスには、タスクのリリース、ノードのトレーニング、軌跡の検証、重みの集約(SHARDCAST)、報酬の発行が含まれ、「実際のトレーニング行動」を中心にインセンティブのクローズドループが形成されます。
04 INTELLECT-2:検証可能な最初の分散トレーニングモデルのリリース
Prime Intellectは2025年5月にINTELLECT-2をリリースしました。これは、非同期で信頼できない分散ノードコラボレーションによってトレーニングされた世界初の大規模強化学習モデルであり、パラメータスケールは320億です。INTELLECT-2モデルは、3大陸にまたがる100以上のGPU異種ノードによってトレーニングされ、完全に非同期のアーキテクチャと400時間を超えるトレーニング時間を使用して、非同期コラボレーションネットワークの実現可能性と安定性を実証しています。このモデルは、性能面での画期的な進歩であるだけでなく、Prime Intellectが提唱する「トレーニングはコンセンサス」パラダイムを初めて体系的に実装したものでもあります。INTELLECT-2は、PRIME-RL(非同期トレーニング構造)、TOPLOC(トレーニング動作検証)、SHARDCAST(非同期重み集約)といったコアプロトコルモジュールを統合し、分散型トレーニングネットワークにおいて、トレーニングプロセスのオープン性、検証性、経済的インセンティブを備えた閉ループを実現した初めてのモデルです。
性能面では、INTELLECT-2はQwQ-32Bトレーニングをベースとし、コードと数学を用いた特別なRLトレーニングを実施しています。これは、現在のオープンソースRLファインチューニングモデルの最先端技術です。GPT-4やGeminiなどのクローズドソースモデルを凌駕するほどの性能ではありませんが、その真の意義は、再現性、検証性、監査性を備えた完全なトレーニングプロセスを備えた世界初の分散型モデル実験である点にあります。 Prime Intellectはモデルをオープンソース化しただけでなく、さらに重要な点として、学習プロセス自体もオープンソース化しました。学習データ、戦略更新の軌跡、検証プロセス、集約ロジックなど、すべてが透明かつ追跡可能であり、誰もが参加できる分散型学習ネットワークのプロトタイプを構築し、信頼できるコラボレーションと利益の共有を実現します。
Pluralis:非同期モデル並列と構造圧縮による協調学習のパラダイムエクスプローラー
Pluralisは、「信頼できる協調学習ネットワーク」に焦点を当てたWeb3 AIプロジェクトです。その中核的な目標は、分散型、オープン参加型、そして長期的なインセンティブに基づくモデル学習パラダイムを推進することです。現在主流となっている集中型またはクローズドな学習パスとは異なり、Pluralisは「プロトコル学習」と呼ばれる新しい概念を提案しました。これは「プロトコルベース」のモデル学習プロセスであり、検証可能なコラボレーションメカニズムとモデル所有権マッピングを通じて、内生的インセンティブ閉ループを備えたオープンな学習システムを構築します。
01 コアコンセプト:プロトコル学習
Pluralis が提唱するプロトコル学習には、3 つの主要な柱があります。
1. 非実体化モデル
モデルは複数のノードに断片的に分散され、単一のノードが完全な重みを復元してクローズドソースを維持することはできません。この設計により、モデルは自然な「プロトコル内資産」となり、アクセス認証情報の制御、漏洩防止、収益帰属バインディングを実現できます。
2. インターネット経由のモデル並列トレーニング
非同期パイプラインモデル並列メカニズム(SWARM アーキテクチャ)により、異なるノードは重みの一部のみを保持し、低帯域幅ネットワーク連携を通じてトレーニングまたは推論を完了します。
3.インセンティブのための部分的所有権
参加ノードはすべて、トレーニングへの貢献度に応じてモデルの部分的な所有権を取得し、将来の収益分配とプロトコルガバナンスの権利を享受します。
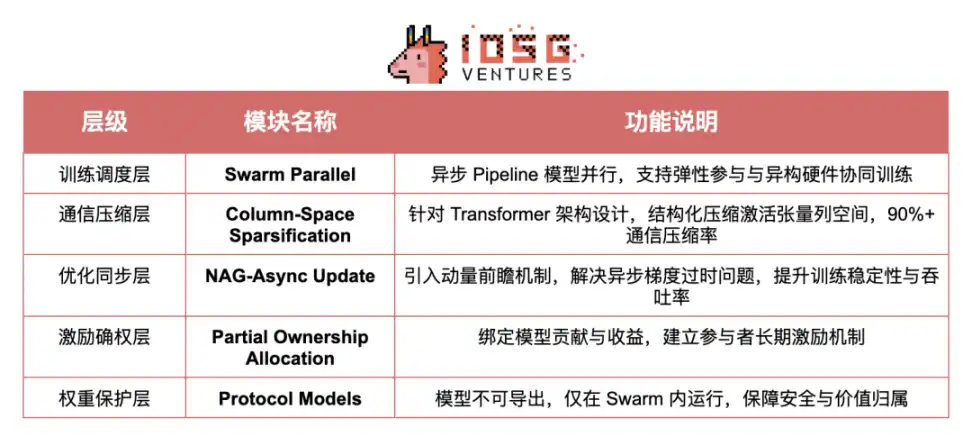
02 Pluralisプロトコルスタックの技術アーキテクチャ
03 主要な技術メカニズムの詳細な説明
非物質化モデル
「第3の道:プロトコル学習」では、モデルの重みをフラグメントの形で分散させることで、「モデル資産」がSwarmネットワーク内でのみ実行できるようにし、そのアクセスと収益がプロトコルによって制御されるようにすることが初めて体系的に提案されました。このメカニズムは、分散型トレーニングのための持続可能なインセンティブ構造を実現するための前提条件です。
非同期モデル並列トレーニング
「非同期更新によるSWARM並列」では、Pluralisがパイプラインベースの非同期モデル並列アーキテクチャを構築し、LLaMA-3で初めて実証しました。中核となる革新は、Nesterov Accelerated Gradient(NAG)メカニズムの導入です。このメカニズムは、非同期更新プロセスにおける勾配ドリフトと不安定な収束の問題を効果的に修正し、低帯域幅環境における異種デバイス間のトレーニングを実用化します。
列空間スパース化
Beyond Top-Kでは、セマンティックパスの破壊を回避するため、従来のTop-Kを構造を考慮した列空間圧縮手法に置き換えることが提案されています。このメカニズムは、モデルの精度と通信効率の両方を考慮しています。非同期モデル並列環境において、通信データの90%以上を圧縮できることが測定されており、これは構造を考慮した効率的な通信を実現するための重要なブレークスルーです。
04 技術の位置付けとパスの選択
Pluralis は、「非同期モデル並列処理」をその中核方向と明確に位置付けており、データ並列処理に比べて次のような利点があると強調しています。
・低帯域幅ネットワークと非一貫性ノードをサポートします。
・デバイスの異種性に適応し、コンシューマーグレードの GPU が参加できるようにします。
・自然に弾性スケジューリング機能を備え、頻繁なノードのオンライン/オフラインをサポートします。
・構造の圧縮 + 非同期更新 + 重みの非抽出性を 3 つの主要なブレークスルー ポイントとしています。
公式サイトで公開されている 6 つの技術ブログ ドキュメントによると、論理構造は次の 3 つの主要なラインに統合されています。
1.理念とビジョン:「第三の道:プロトコル学習」「分散型トレーニングが重要な理由」
2. 技術的メカニズムの詳細:「SWARM並列」「Top-Kを超えて」「非同期更新」
3. 制度的イノベーションの探求:「非物質化モデル」「部分的所有権プロトコル」
現在、Pluralisはまだ製品、テストネットワーク、オープンソースコードをリリースしていません。その理由は、Pluralisが選択した技術的パスが非常に困難であるためです。製品やサービスを上位にカプセル化する前に、基盤となるシステムアーキテクチャ、通信プロトコル、エクスポートできない重みなどのシステムレベルの問題を解決する必要があります。
2025年6月にPluralis Researchが発表した新しい論文では、分散型トレーニングフレームワークがモデルの事前トレーニングからモデルの微調整へと拡張され、非同期更新、スパース通信、部分的な重み集約がサポートされています。理論と事前トレーニングに重点を置いた従来の設計と比較して、この研究は実装の実現可能性に重点を置き、フルサイクルトレーニングアーキテクチャにおけるさらなる成熟を示しています。
Gensyn:検証可能な実行を駆動力とする分散型トレーニングプロトコル層
Gensynは、「ディープラーニングトレーニングタスクの信頼できる実行」に焦点を当てたWeb3 AIプロジェクトです。モデルアーキテクチャやトレーニングパラダイムの再構築ではなく、「タスク分散 + トレーニング実行 + 結果検証 + 公正なインセンティブ」というプロセス全体を備えた検証可能な分散型トレーニング実行ネットワークの構築を核としています。オフチェーントレーニング + オンチェーン検証のアーキテクチャ設計を通じて、Gensynは効率的でオープンかつインセンティブ化されたグローバルトレーニング市場を確立し、「トレーニングはマイニング」の実現に貢献しています。
01 プロジェクトの位置付け:トレーニングタスク実行プロトコル層
Gensynは「どのようにトレーニングするか」ではなく、「誰がトレーニングを行うか、どのように検証するか、そしてどのように利益を分配するか」というインフラストラクチャに焦点を当てています。その本質は、トレーニングタスクのための検証可能なコンピューティングプロトコルであり、主に次の問題を解決します。
· トレーニングタスクを誰が実行するか(コンピューティングパワーの配分と動的マッチング)
· 実行結果の検証方法(再計算は不要、異議のあるオペレーターの検証のみ)
· トレーニングのメリットの分配方法(ステーク、スラッシング、マルチロールゲームメカニズム)
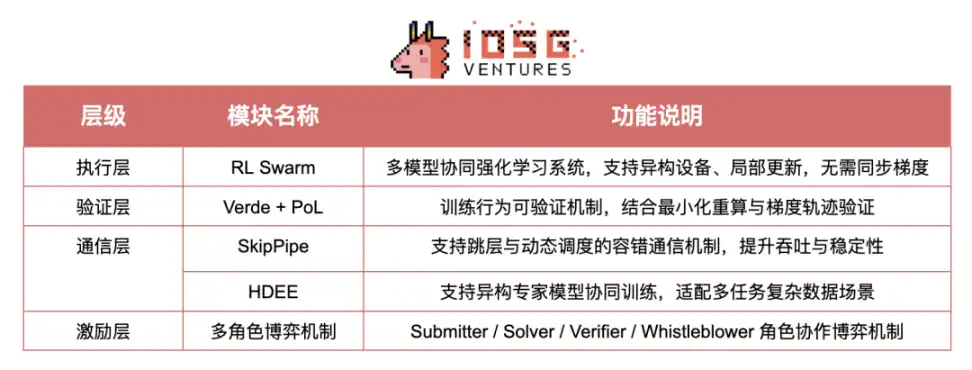
02 技術アーキテクチャの概要
03 モジュールの詳細な説明
RL Swarm:協調型強化学習トレーニングシステム
Gensynが開発したRL Swarmは、次のコアを備えた、トレーニング後の段階のための分散型マルチモデル協調最適化システムです。特徴:
分散推論および学習プロセス:
· 回答: 各ノードは独立して回答を出力します。批評: ノードは互いの出力にコメントし、最適な回答とロジックを選択します。解決: ほとんどのノードの好みを予測し、それに応じて独自の回答を変更して、ローカル重みの更新を実現します。 Gensyn が提案する RL Swarm は、分散型マルチモデル協調最適化システムです。各ノードは独立したモデルを実行し、勾配同期なしでローカルトレーニングを実行します。異種の計算能力と不安定なネットワーク環境に自然に適応し、柔軟なノードのアクセスと終了をサポートします。このメカニズムは、RLHF とマルチエージェントゲームのアイデアを利用しています。しかし、協調推論ネットワークの動的進化ロジックに近いものです。ノードは、グループのコンセンサス結果との一貫性の度合いに応じて報酬を受け、それによって推論能力の継続的な最適化と収束学習を促進します。 RL Swarm は、オープン ネットワークにおけるモデルの堅牢性と一般性を大幅に向上させ、Ethereum Rollup に基づく Gensyn のテストネット フェーズ 0 のコア実行モジュールとして導入されています。
Verde + 学習証明: 信頼できる検証メカニズム
Gensyn の Verde モジュールは、次の 3 つのメカニズムを組み合わせています。
1. 学習証明:勾配の軌跡とトレーニング メタデータに基づいて、トレーニングが実際に行われたかどうかを判断します。
2. グラフ ベースのピンポイント:トレーニング計算グラフ内の分岐ノードを見つけ、特定の操作のみを再計算する必要があります。
3.審判付き委任:仲裁検証メカニズムを使用して、検証者と挑戦者は紛争を提起してローカルで検証することで、検証コストを大幅に削減します。
ZKP または完全再計算検証スキームと比較して、Verde スキームは検証可能性と効率性の間のより優れたバランスを実現します。
SkipPipe: 通信フォールト トレラント最適化メカニズム
SkipPipe は、「低帯域幅 + ノード切断」シナリオにおける通信ボトルネックの問題を解決するように設計されています。主な機能は次のとおりです。
· スキップ率:制限されたノードをスキップして、トレーニングのブロックを回避します。
· 動的スケジューリング アルゴリズム:最適な実行パスをリアルタイムで生成します。
· フォールト トレラント実行:ノードの 50% に障害が発生しても、推論の精度は約 7% しか低下しません。
最大 55% のトレーニング スループットの向上をサポートし、「早期終了推論」、「シームレスな並べ替え」、「推論の完了」などの主要な機能を実現します。
HDEE: クロスドメイン異種エキスパート クラスター
HDEE (異種ドメイン エキスパート アンサンブル) モジュールは、次のシナリオの最適化に特化しています。
· マルチドメイン、マルチモーダル、およびマルチタスクのトレーニング。
· さまざまな種類のトレーニング データの不均衡な分布と難易度の大きな違い。
· 異種のデバイスのコンピューティング能力と一貫性のない通信帯域幅のある環境におけるタスクの割り当てとスケジュールの問題。
主な機能:
· MHe-IHo: 異なるサイズのモデルを異なる難易度のタスクに割り当てます (異種モデル、一貫したトレーニング ステップ サイズ)。
· MHo-IHe: タスクの難易度は均一ですが、トレーニング ステップ サイズの調整は非同期です。
· 異種のエキスパート モデル + プラグ可能なトレーニング戦略をサポートし、適応性とフォールト トレランスを向上させます。
· 「並列コラボレーション + 極めて低いコミュニケーション + 動的なエキスパート割り当て」を重視し、現実の複雑なタスク エコロジーに適しています。
マルチロール ゲーム メカニズム: 信頼とインセンティブの並列処理
Gensyn ネットワークでは、4 種類の参加者が導入されています。
1. 提出者:トレーニング タスクを公開し、構造と予算を設定します。
2.ソルバー:トレーニング タスクを実行し、結果を送信します。
3. 検証者:トレーニングの動作を検証して、コンプライアンスと有効性を確保します。
4. 内部告発者:検証者に異議を申し立てて、仲裁報酬を得るか、罰金を負います。
このメカニズムは、Truebit の経済ゲーム デザインに触発されています。エラーを強制的に挿入し、ランダム仲裁を行うことで、参加者が誠実に協力するように促し、ネットワークの信頼性の高い運用を保証します。
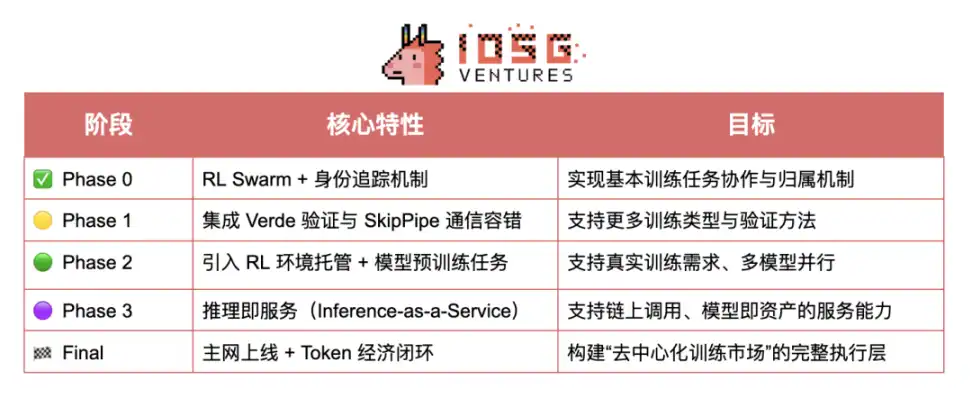
04 テストネットとロードマップの計画
Nous Research: 主観的 AI の概念に基づく認知進化トレーニング システム
Nous Research は、哲学的高みとエンジニアリング実装の両方を備えた数少ない分散型トレーニング チームの 1 つです。 Nous Researchの核となるビジョンは、「Desideratic AI(デシデラティックAI)」という概念に基づいています。AIは、単なる制御可能なツールではなく、主体性と進化能力を備えた知的な主体として捉えられています。Nous Researchの独自性は、AIトレーニングを「効率性の問題」として最適化するのではなく、「認知主体」を形成するプロセスとして捉えていることにあります。このビジョンに基づき、Nousは、異種ノードによる協調的なトレーニング、中央スケジューリングを必要とせず、検閲耐性を備え、フルスタックツールチェーンを通じて体系的に実装されたオープンなトレーニングネットワークの構築に注力しています。
01 コンセプトサポート:トレーニングの「目的」を再定義する
Nousは、インセンティブ設計やプロトコル経済学にはあまり力を入れず、トレーニングの哲学的前提そのものを変えようとしました。
·「アライメント主義」に反対:人間の制御を唯一の目標とする「トレーニング」に同意せず、トレーニングではモデルが独立した認知スタイルを形成するように促すべきだと主張します。
· モデルの主観性を強調:基本モデルは不確実性、多様性、幻覚生成能力(幻覚は美徳)を保持すべきだと考えています。
· モデルのトレーニングは認知形成です:モデルは「タスク完了を最適化する」のではなく、認知進化プロセスに参加する個体です。
このトレーニングの見方は「ロマンチック」ですが、Nous のトレーニング インフラストラクチャ設計の中核となるロジック、つまり、均一に規律されるのではなく、オープン ネットワーク内で異種のモデルを進化させる方法を反映しています。
02 トレーニング コア: Psyche ネットワークと DisTrO オプティマイザー
分散型トレーニングに対する Nous の最も重要な貢献は、Psyche ネットワークと、その基盤となる通信オプティマイザー DisTrO (Distributed Training Over-the-Internet) の構築です。これらは一緒にトレーニング タスクの実行センターを構成します。
DisTrO + Psyche ネットワークには、通信圧縮 (DCT + 1 ビット符号エンコーディングを使用して帯域幅要件を大幅に削減)、ノード適応性 (異種 GPU、切断再接続、自律終了をサポート)、非同期フォールト トレランス (同期なしでの継続的なトレーニング、高いフォールト トレランス)、分散型スケジューリング メカニズム (中央コーディネータは必要なく、ブロックチェーンに基づいてコンセンサスとタスク分散が実現) など、多くのコア機能があります。このアーキテクチャは、低コストで柔軟性が高く検証可能なオープン トレーニング ネットワークの現実的で実現可能な技術基盤を提供します。
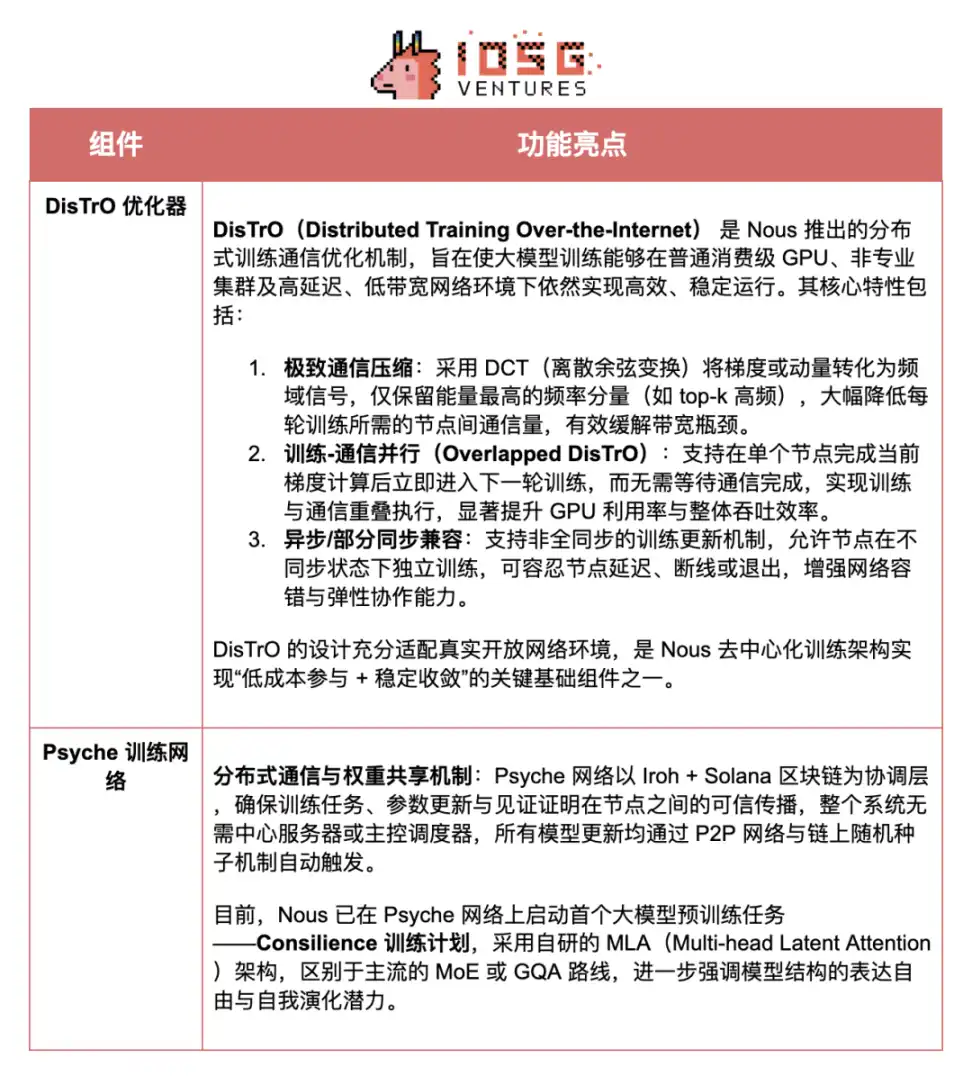
このアーキテクチャ設計は、実用的な実現可能性を重視しています。中央サーバーに依存せず、世界中のボランティアノードに適応し、トレーニング結果のオンチェーントレーサビリティを備えています。
03 Hermes / Forge / TEE_HEE は推論とエージェントシステムで構成
分散型トレーニングインフラストラクチャの構築に加えて、Nous Research は、「AI の主観性」という概念を中心に、いくつかの探索的システム実験も実施しています。
Hermes オープンソースモデルシリーズ
Hermes 1 から 3 は、Nous がリリースした代表的なオープンソースの大規模モデルで、LLaMA 3.1 トレーニングに基づいており、8B、70B、405B の 3 つのパラメータースケールをカバーしています。このシリーズは、Nousが提唱する「脱指導、多様性の保持」という研修コンセプトを具体化することを目指しており、長期文脈の保持、ロールプレイング、複数ラウンドの対話における表現力と一般化能力を強化します。
Forge 推論 API: マルチモーダル推論システム
Forge は Nous が開発した推論フレームワークで、3 つの補完的なメカニズムを組み合わせることで、より柔軟で創造的な推論機能を実現します。
· MCTS (モンテ カルロ木探索):複雑なタスクの戦略探索。
· CoC (Chain of Code):コード チェーンと論理的推論の組み合わせパスの導入。
· MoA (Mixture of Agents):複数のモデルがネゴシエートして出力の幅と多様性を向上できるようにします。
このシステムは、「非決定論的推論」と組み合わせ生成パスを重視しており、従来の命令アライメント パラダイムに対する強力な対応策です。
TEE_HEE:AI自律エージェント実験
TEE_HEEは、Nousが自律エージェントの実現に向けて進めている最先端研究であり、AIが信頼できる実行環境(TEE)において自律的に動作し、固有のデジタルIDを持つかどうかを検証することを目的としています。エージェントは独自のTwitterアカウントとEthereumアカウントを持ち、すべての制御権限はリモート検証可能なエンクレーブによって管理されるため、開発者はエージェントの行動に干渉することはできません。この実験の目標は、「不変性」と「独立した行動意図」を備えたAI主体を構築することであり、自律型インテリジェントエージェントの構築に向けた重要な一歩となります。
AI行動シミュレータプラットフォーム
Nousは、WorldSim、Doomscroll、Gods & S8nなど、複数のシミュレータを開発し、多役割社会環境におけるAIの行動進化と価値形成メカニズムを研究しています。これらの実験は、学習プロセスに直接関与しているわけではありませんが、長期的な自律AIの認知行動モデリングのためのセマンティックレイヤー基盤を構築しました。
Flock:ブロックチェーン強化型連合学習ネットワーク
Flock.ioは、AI学習のためのデータ、コンピューティング、モデルの分散化を目指すブロックチェーンベースの連合学習プラットフォームです。FLockは、「連合学習 + ブロックチェーン報酬レイヤー」という統合フレームワークを採用しています。これは、新しい学習プロトコルの構築を体系的に探求するのではなく、従来のFLアーキテクチャのオンチェーン進化と言えるでしょう。Gensyn、Prime Intellect、Nous Research、Pluralisなどの分散学習プロジェクトと比較すると、Flockは通信、検証、学習方法における理論的なブレークスルーではなく、プライバシー保護とユーザビリティの向上に重点を置いています。真に比較対象として適しているのは、Flower、FedML、OpenFLなどの連合学習システムです。
01 Flock.io のコアメカニズム
フェデレーテッド ラーニング アーキテクチャ: データ主権とプライバシー保護を重視
Flock は、従来のフェデレーテッド ラーニング (FL) パラダイムをベースとしており、複数のデータ所有者が元のデータを共有せずに統合モデルを共同でトレーニングできるようにし、データ主権、セキュリティ、信頼の問題の解決に重点を置いています。コアプロセスには以下が含まれます:
· ローカルトレーニング:各参加者 (提案者) は、元のデータをアップロードせずに、ローカルデバイスでモデルをトレーニングします。
· オンチェーン集約:トレーニング後、ローカルの重み更新が送信され、オンチェーンマイナーがそれをグローバルモデルに集約します。
· 委員会評価:VRF は、独立したテストセットを使用して集約モデルの効果を評価し、スコア付けするために、Voter ノードをランダムに選択します。
· インセンティブとペナルティ:悪意の防止と動的な信頼維持を実現するために、スコア結果に応じて報酬または担保の没収が実行されます。
ブロックチェーン統合: トラストレスなシステム調整を実現
Flock は、トレーニングプロセスのすべてのコアリンク (タスクの割り当て、モデルの送信、評価とスコアリング、システムの透明性、検証可能性、検閲防止を実現するために、チェーン上でブロックチェーン(インセンティブ実行)を導入します。主なメカニズムは以下のとおりです。
· VRF ランダム選挙メカニズム:提案者と投票者のローテーションの公平性と操作防止能力を向上させます。
· 株式ステーキングメカニズム (PoS):トークンステーキングとペナルティを通じてノードの行動を制限することで、システムの堅牢性を向上させます。
· オンチェーンインセンティブ自動実行:スマートコントラクトを通じてタスク完了と評価結果にバインドされた報酬分配と削減ペナルティを実装し、仲介者を信頼することなく協力的なネットワークを構築します。
zkFL: ゼロ知識集約メカニズムのプライバシー保護イノベーション
Flock は、提案者がローカルに更新されたゼロ知識証明を提出し、投票者がそれを検証できるようにする zkFL ゼロ知識集約メカニズムを導入します。元の勾配にアクセスすることなく正確性を確保できるため、プライバシーを確保しながらトレーニング プロセスの信頼性が向上し、連合学習におけるプライバシー保護と検証可能性の統合における重要な革新を表しています。
02Flockのコア製品コンポーネント
AI Arena:Flock.ioの分散型トレーニングプラットフォームです。ユーザーはtrain.flock.ioを通じてモデルタスクに参加し、トレーナー、バリデーター、または委任者として行動し、モデルの提出、パフォーマンス評価、またはトークンの委任によって報酬を受け取ることができます。現在、タスクは公式に公開されていますが、今後、コミュニティの共創に徐々に開放される予定です。
FL Alliance:Flockの連合学習クライアントであり、参加者がプライベートデータを使用してモデルをさらに微調整することをサポートします。VRF選挙、ステーキング、スラッシングメカニズムを通じて、トレーニングプロセスの誠実さと共同効率を確保し、コミュニティの初期トレーニングと実際の展開をつなぐ重要なリンクとなります。
AI Marketplace:モデルの共創および展開プラットフォームです。ユーザーはモデルを提案し、データを提供したり、モデルサービスを呼び出したりすることができます。データベースアクセスとRAG強化推論をサポートし、様々な実用シナリオにおけるAIモデルの実装と流通を促進します。
分散型トレーニングプロジェクトと比較して、Flockなどの連合学習ベースのシステムは、トレーニング効率、スケーラビリティ、プライバシー保護の面でより優位性があり、特に中小規模モデルの協調トレーニングにおいてその優位性を発揮します。このソリューションは実用的で実装が容易であり、エンジニアリングレベルでの実現可能性の最適化に重点を置いています。一方、GensynやPluralisなどのプロジェクトは、トレーニング手法と通信メカニズムにおけるより深い理論的ブレークスルーを追求しています。システム上の課題はより大きくなりますが、真の「トラストレスかつ分散型」のトレーニングパラダイムの探求に近づいています。
EXO:エッジコンピューティングのための分散型トレーニングの試み
EXOは、現在のエッジコンピューティングシナリオにおける非常に代表的なAIプロジェクトであり、家庭用コンシューマーデバイス上で軽量なAIトレーニング、推論、エージェントアプリケーションの実現に特化しています。分散型トレーニングパスは「低通信オーバーヘッド+ローカル自律実行」を重視しており、DiLoCo非同期遅延同期アルゴリズムとSPARTAスパースパラメータ交換メカニズムを用いることで、複数デバイスによる協調トレーニングに必要な帯域幅を大幅に削減します。システムレベルでは、EXOはオンチェーンネットワークの構築や経済的インセンティブメカニズムの導入は行いませんが、単一マシン・マルチプロセスシミュレーションフレームワークであるEXO Gymを発表しました。このフレームワークは、研究者がローカル環境で分散トレーニング手法を迅速に検証・実験することをサポートします。
01 コアメカニズムの概要
・DiLoCo非同期トレーニング:不安定なネットワークに適応するため、Hステップごとにノード同期を実行します。
・SPARTAスパース同期:モデルの関連性を維持し、帯域幅要件を削減するため、各ステップでごく少数のパラメータ(例えば0.1%)のみを交換します。
· 非同期組み合わせ最適化: これら 2 つを組み合わせて使用することで、通信とパフォーマンスのより良い妥協点を実現できます。
evML 検証メカニズムの探究: Edge-Verified Machine Learning (evML) は、低コストのコンピューティング検証に TEE/Secure Context の使用を提案し、リモート検証 + スポット チェック メカニズムを通じて、誓約なしでエッジ デバイスの信頼できる参加を実現します。これは、経済的なセキュリティとプライバシー保護の間のエンジニアリング上の妥協点です。
02 ツールとシナリオ アプリケーション
· EXO Gym: 単一のデバイスでマルチノードのトレーニング環境をシミュレートし、NanoGPT、CNN、Diffusion などのモデルの通信戦略実験をサポートします。
· EXO デスクトップ アプリ: 個人ユーザー向けのデスクトップ AI ツールで、ローカルの大規模モデル操作、iPhone ミラー制御、プライベート コンテキスト統合 (SMS、カレンダー、ビデオなど) などのプライバシーに配慮したパーソナライズ機能をサポートします。
EXO Gym は、主に既存の通信圧縮技術(DiLoCo や SPARTA など)を統合して軽量なトレーニングパスを実現する、探索指向の分散トレーニング実験プロジェクトです。Gensyn、Nous、Pluralis などのプロジェクトと比較すると、EXO はまだオンチェーンコラボレーション、検証可能なインセンティブメカニズム、または実際の分散ネットワーク展開の中核段階に入っていません。
3. 分散トレーニング用プレチェーンエンジン:モデルの事前トレーニングのパノラミックスタディ
分散トレーニングでよく見られるデバイスの異種性、通信のボトルネック、調整の難しさ、信頼できる実行の欠如といった中核的な課題に直面して、Gensyn、Prime Intellect、Pluralis、Nous Research は、差別化されたシステムアーキテクチャパスを提案しています。トレーニング方法と通信メカニズムの観点から、これら 4 つのプロジェクトは、独自の技術的焦点とエンジニアリング実装ロジックを示しています。
トレーニング方法の最適化に関しては、協調戦略、更新メカニズム、非同期制御といった4つの主要な側面を探求し、事前トレーニングから事後トレーニングまでのさまざまな段階をカバーしました。
Prime IntellectのPRIME-RLは、事前トレーニング段階のための非同期スケジューリング構造です。「ローカルトレーニング+定期同期」戦略を通じて、異種環境における効率的で検証可能なトレーニングスケジューリングメカニズムを実装します。この方法は、高い汎用性と柔軟性を備えています。高度な理論的革新性を備え、トレーニング制御構造の明確なパラダイムを提案しています。エンジニアリング実装の難易度は中程度から高く、基盤となる通信および制御モジュールに対する要件は高いです。
Nous Researchが発表したDeMoオプティマイザーは、非同期低帯域幅環境におけるトレーニングの安定性問題に焦点を当て、異機種GPU環境下でもフォールトトレランスの高い勾配更新プロセスを実現しています。これは、「非同期通信圧縮閉ループ」において理論と工学の融合を実現した数少ないソリューションの一つです。特に圧縮とスケジューリングの協調パスにおいて、理論的な革新性は非常に高く、エンジニアリング実装も非常に困難で、特に非同期並列処理の調整精度に依存しています。
PluralisのSWARM + NAGは、現在の非同期トレーニングパスにおいて最も体系的で革新的な設計の一つです。非同期モデル並列フレームワークを基盤とし、列空間スパース通信とNAGモーメンタム補正を導入し、低帯域幅環境下でも安定収束可能な大規模モデルトレーニングソリューションを構築しています。理論的な革新性は非常に高く、非同期協調トレーニングの構造的先駆者です。エンジニアリングの難易度も非常に高く、多階層同期とモデルセグメンテーションの深い統合が求められます。
GensynのRL Swarmは主に学習後段階に使用され、戦略の微調整とエージェント協調学習に重点を置いています。学習プロセスは「生成-評価-投票」の3段階プロセスを採用しており、マルチエージェントシステムにおける複雑な行動の動的調整に特に適しています。理論的な革新性は中程度から高く、主にエージェント協調ロジックに反映されています。エンジニアリング実装の難易度は中程度で、主な課題はシステムスケジューリングと行動収束制御にあります。
通信メカニズムの最適化に関しては、これら4つのプロジェクトも明確なレイアウトを持っており、帯域幅のボトルネック、ノードの異質性、スケジューリングの安定性の問題に対する体系的な解決策に重点を置いています。
Prime IntellectのPCCLは、従来のNCCLに代わる低レベル通信ライブラリであり、上位レベルの学習プロトコルのためのより堅牢な集団通信基盤を提供することを目指しています。理論的革新性は中程度から高く、フォールトトレラントな通信アルゴリズムにおいて一定のブレークスルーが見られます。エンジニアリングの難易度は中程度で、モジュールの適応性は高いです。
Nous ResearchのDisTrOは、DeMoの中核通信モジュールであり、低帯域幅での通信オーバーヘッドを最小限に抑えながら、トレーニングの閉ループの継続性を確保しています。理論的革新性が高く、スケジューリングと調整構造において普遍的な設計価値を有しています。エンジニアリングの難易度が高く、圧縮精度とトレーニングの同期に対する要件も高くなっています。
Pluralisの通信メカニズムはSWARMアーキテクチャに深く組み込まれており、大規模モデルの非同期トレーニングにおける通信負荷を大幅に軽減し、収束性を確保しながら効率的なスループットを維持します。理論的革新性が高く、非同期モデル通信設計のパラダイムを確立しています。エンジニアリングの難易度は非常に高く、分散モデルオーケストレーションと構造的スパース性制御に依存しています。
GensynのSkipPipeは、RL Swarm用のフォールトトレラントなスケジューリングコンポーネントです。このソリューションは導入コストが低く、主にエンジニアリング着陸層における訓練の安定性を高めるために使用されます。理論的な革新性は中程度で、既存のメカニズムのエンジニアリング実装に近いため、エンジニアリングの難易度は低いものの、実際の導入においては非常に実用的です。
さらに、分散型トレーニング プロジェクトの価値は、ブロックチェーン コラボレーション レイヤーと AI トレーニング レイヤーという 2 つのマクロなカテゴリから測定できます。
· ブロックチェーン コラボレーション レイヤー:プロトコルの信頼性とインセンティブ コラボレーション ロジックを重視
· 検証可能性:トレーニング プロセスが検証可能かどうか、ゲームや暗号化のメカニズムが導入されているかどうかで信頼を確立します。
· インセンティブ メカニズム:タスク駆動型のトークン報酬/ロール メカニズムが設計されているかどうか。
· オープン性とエントリしきい値:ノードに簡単にアクセスできるかどうか、集中管理されているか、許可制御されているか。
· AI トレーニング システム レベル:エンジニアリング機能とパフォーマンスのアクセシビリティを強調表示します。
· スケジューリングおよびフォールト トレランス メカニズム:フォールト トレランス、非同期、動的、および分散スケジューリングが利用可能かどうか。
· トレーニング メソッドの最適化:モデル トレーニング アルゴリズムまたは構造が最適化されているかどうか。
· 通信パスの最適化:勾配が圧縮されているか、スパース通信が利用可能で、低帯域幅に適応できるかどうか。
次の表は、上記の指標システムに基づいて、分散トレーニング パスに関する Gensyn、Prime Intellect、Pluralis、および Nous Research の技術的深さ、エンジニアリングの成熟度、および理論的革新性を体系的に評価しています。

IV.分散型トレーニングのポストチェーンエコロジー:LoRAに基づくモデルファインチューニング
分散型トレーニングのバリューチェーン全体において、Prime Intellect、Pluralis.ai、Gensyn、Nous Researchなどのプロジェクトは、主にモデルの事前学習、通信メカニズム、協調最適化といったフロントエンドインフラの構築に重点を置いています。一方、別のタイプのプロジェクトは、学習後段階におけるモデルの適応と推論の展開(学習後ファインチューニングと推論配信)に焦点を当てており、事前学習、パラメータ同期、通信最適化といった体系的な学習プロセスには直接関与していません。代表的なプロジェクトとしては、Bagel、Pond、RPS Labsなどが挙げられます。これらはすべてLoRAファインチューニング手法に基づいており、分散型トレーニングエコロジカルマップにおける重要な「ポストチェーン」リンクを構成しています。
LoRA + DPO:Web3ファインチューニング展開への現実的な道筋
LoRA(Low-Rank Adaptation)は、効率的なパラメータ微調整手法です。その核となる考え方は、事前学習済みの大規模モデルに低ランク行列を挿入することで、元のモデルパラメータを固定したまま新しいタスクを学習させることです。この戦略は、学習コストとリソース消費を大幅に削減し、微調整速度と展開の柔軟性を向上させます。特に、モジュール化と組み合わせ呼び出しを特徴とするWeb3シナリオに適しています。
LLaMAやGPT-3などの従来の大規模言語モデルは、数十億、あるいは数千億ものパラメータを持つことが多く、直接微調整を行うのはコストがかかります。LoRAは、挿入された少数のパラメータ行列のみを学習することで大規模モデルの効率的な適応を実現し、現在最も実用的な主流手法の一つとなっています。
近年登場した言語モデルの学習後手法である直接選好最適化(DPO)は、モデル動作アライメント段階でLoRA微調整メカニズムと組み合わせて使用されることが多い。従来のRLHF(人間からのフィードバックによる強化学習)手法と比較して、DPOはペアサンプルを直接最適化することで選好学習を実現し、複雑な報酬モデリングと強化学習プロセスを排除する。構造がシンプルで収束が安定しており、特に軽量でリソースが限られた環境での微調整タスクに適している。その高い効率性と使いやすさから、DPOはモデルアライメント段階における多くの分散AIプロジェクトの優先ソリューションになりつつある。
強化学習(RL):学習後の微調整の将来的な進化
長期的な視点から見ると、ますます多くのプロジェクトが、分散学習においてより適応性と進化の可能性を秘めた中核的な道筋として、強化学習(RL)を捉えています。静的データに依存する教師あり学習やパラメータ微調整メカニズムと比較して、RLは動的な環境における戦略の継続的な最適化を重視しており、これはWeb3ネットワークにおける非同期、異種混合、インセンティブ駆動型のコラボレーションパターンに自然に適応します。環境との継続的な相互作用を通じて、RLは高度にパーソナライズされた継続的な増分学習プロセスを実現し、エージェントネットワーク、オンチェーンタスクマーケット、スマートエコノミーの構築のための進化可能な「行動インテリジェンス」インフラストラクチャを提供します。
このパラダイムは、概念的に分散化の精神と非常に整合しているだけでなく、システム上の大きな利点も備えています。しかし、エンジニアリングのハードルが高く、スケジューリングの仕組みが複雑なため、RL は現段階では実装において依然として大きな課題を抱えており、短期間で広く普及させることは困難です。
注目すべきは、Prime Intellect の PRIME-RL と Gensyn の RL Swarm が、RL をトレーニング後の微調整メカニズムからトレーニング前の主要構造へと進化させ、RL 中心の信頼を必要としない共同トレーニング システムの構築を試みていることです。
Bagel(zkLoRA):LoRA微調整のための信頼できる検証レイヤー
BagelはLoRAの微調整メカニズムをベースとし、ゼロ知識証明(ZK)技術を導入することで、「オンチェーンモデル微調整」プロセスにおける信頼性とプライバシー保護の問題を解決します。zkLoRAは実際のトレーニング計算には関与しませんが、軽量で検証可能なメカニズムを提供します。これにより、外部ユーザーは元のデータや重みにアクセスすることなく、微調整されたモデルが指定されたベースモデルとLoRAパラメータから実際に導出されたものであることを確認できるようになります。
GensynのVerdeやPrime IntellectのTOPLOCは、トレーニングプロセス中に「実際に動作が発生したかどうか」という動的な検証に重点を置いていますが、Bagelは「微調整結果が信頼できるかどうか」という静的な検証に重点を置いています。 zkLoRAの最大の利点は、検証リソースの消費量が少なく、プライバシー保護が強力であることです。しかし、その適用範囲は通常、パラメータの小さな変更を伴うタスクの微調整に限定されます。
Pond:GNNシナリオにおける微調整とエージェント進化プラットフォーム
Pondは、グラフニューラルネットワーク(GNN)の微調整に焦点を当てた業界で唯一の分散型トレーニングプロジェクトであり、ナレッジグラフ、ソーシャルネットワーク、トランザクショングラフなどの構造化データアプリケーションにサービスを提供しています。ユーザーがグラフ構造データをアップロードし、モデルトレーニングのフィードバックに参加できるようにすることで、パーソナライズされたタスクのための軽量で制御可能なトレーニングおよび推論プラットフォームを提供します。
Pondは、LoRAなどの効率的な微調整メカニズムも活用しています。その中核的な目標は、GNNアーキテクチャ上にモジュール式で展開可能なエージェントシステムを実現し、分散環境における「小規模モデルの微調整 + マルチエージェントコラボレーション」という新たな探求の道を切り開くことです。
RPS Labs:DeFi向けAI駆動型流動性エンジン
RPS Labsは、Transformerアーキテクチャをベースとした分散型トレーニングプロジェクトです。DeFiの流動性管理に最適化したAIモデルを用いることに特化したプロジェクトで、主にSolanaエコシステムに導入されています。主力製品であるUltraLiquidは、最適化されたモデルを用いて流動性パラメータを動的に調整し、スリッページを削減し、深度を高め、トークン発行と取引エクスペリエンスを最適化するアクティブなマーケットメイキングエンジンです。
さらに、RPSは流動性プロバイダーがDEXにおける資本配分戦略をリアルタイムで最適化できるよう支援するUltraLPツールもリリースしました。これにより、資本効率が向上し、変動損失のリスクが軽減され、金融シナリオにおけるAIによる最適化の実用的価値が実証されています。
V. プレチェーンエンジンからポストチェーンエコシステムへ:分散型トレーニングの未来
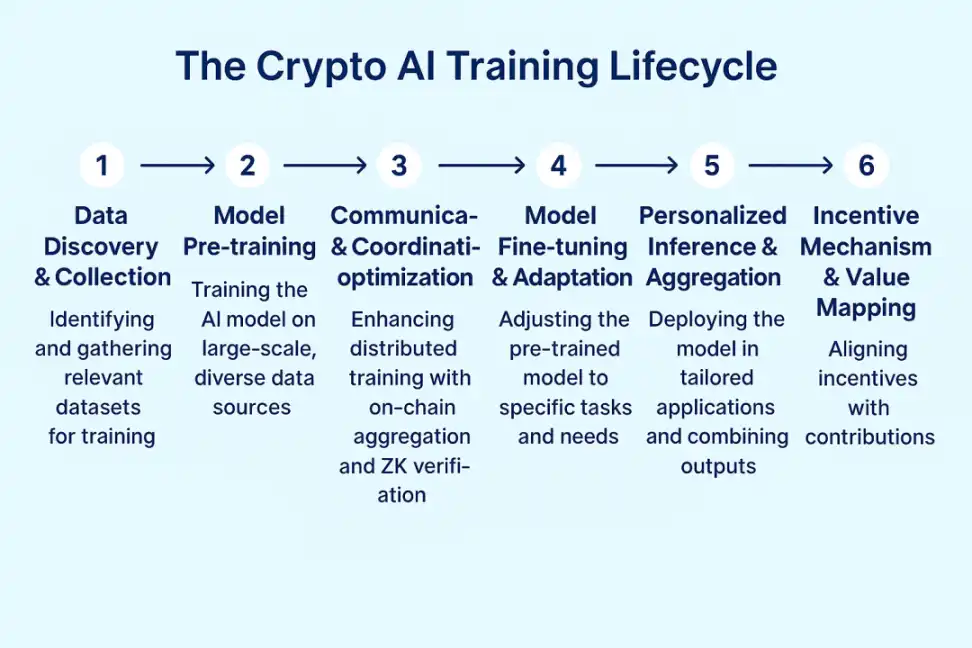
分散型トレーニングの完全なエコロジカルマップでは、全体を2つのカテゴリに分けることができます。フロントチェーンエンジンはモデルの事前トレーニング段階に対応し、バックチェーンエコロジーはモデルの微調整と展開段階に対応し、インフラストラクチャからアプリケーションのランディングまでの完全な閉ループを形成します。
フロントチェーンエンジンは、Prime Intellect、Nous Research、Pluralis.ai、Gensynなどのプロジェクトに代表される、モデルの事前トレーニングの基礎となるプロトコルの構築に重点を置いています。彼らは、非同期更新、スパース通信、トレーニングの検証可能性を備えたシステムアーキテクチャを作成し、トラストレスネットワーク環境で効率的で信頼性の高い分散トレーニング機能を実現し、分散トレーニングの技術基盤を形成することに取り組んでいます。
同時に、中間層の代表であるFlockは、連合学習パスを通じて、モデル集約、オンチェーン検証、マルチパーティインセンティブを統合し、トレーニングとデプロイメントの間に実現可能で協力的なブリッジを確立し、マルチノード協調学習の実用的なパラダイムを提供します。
ポストチェーンエコロジーは、アプリケーション層でのモデルとデプロイメントの微調整に重点を置いています。Pond、Bagel、RPS Labsなどのプロジェクトは、LoRA微調整手法を中心に展開しています。Bagelはチェーン上で信頼できる検証メカニズムを提供し、Pondはグラフニューラルネットワークの小さなモデルの進化に焦点を当て、RPSは微調整モデルをDeFiシナリオのスマートマーケットメイキングに適用します。これらは、推論APIやエージェントSDKなどのコンポーネントを通じて、開発者やエンドユーザーに敷居の低い構成可能なモデル呼び出しとパーソナライズされたカスタマイズソリューションを提供し、分散型AI実装の重要なエントリーポイントとなっています。
私たちは、分散型トレーニングはAI時代におけるブロックチェーン精神の自然な延長であるだけでなく、グローバルな協調型インテリジェント生産性システムのインフラストラクチャのプロトタイプでもあると信じています。将来、この困難な道のりを振り返るとき、私たちは依然としてその初心を持って互いに励まし合うでしょう。分散化は単なる手段ではなく、それ自体が価値なのです。
BlockBeats の公式コミュニティに参加しよう:
Telegram 公式チャンネル:https://t.me/theblockbeats
Telegram 交流グループ:https://t.me/BlockBeats_App
Twitter 公式アカウント:https://twitter.com/BlockBeatsAsia







