Claude Codeを最も活用しているのは誰か?答えはプログラマーではないかもしれない。
原文タイトル:Agentic coding and persistent returns to expertise
原文著者:Anthropoic
編集:Peggy
編集者注:本レポートは約40万回のClaude Codeセッションに基づき、AIプログラミングツールが人間とコードの関係をどのように変えつつあるかを議論する。
最も核心的な発見は、エージェント型プログラミングにおいて、人間は主に「何をするか」を決定し、Claudeは主に「どのように行うか」を担当するという点である。ユーザーは計画の大部分を決定し、Claudeは実行の大部分を担う。つまり、AIはコードの記述、ファイルの修正、コマンドの実行、デバッグといった実装部分を引き継ぎつつも、目標設定と結果の判断は依然として人間に依存している。
さらに重要なのは、Claude Codeの効果はユーザーがプログラマーであるかどうかだけに依存しないという点だ。レポートによると、コードを生成するタスクにおいて、法律、金融、管理、科学研究などの非技術系職業のユーザーの成功率は、ソフトウェアエンジニアにほぼ匹敵する。実際に結果に影響を与えるのは、ユーザーが解決しようとする問題を理解しているかどうかである。
これは、AIプログラミングが引き下げるのは実装のハードルであり、判断のハードルではないことを意味する。将来的には、ビジネスやシナリオを理解し、要件を明確に提示し、結果を判断できる人が、単にコードを書ける人よりもAIをうまく活用できる可能性が高い。AIは自動的にドメイン知識を代替するのではなく、むしろその価値を拡大する。
以下が原文である:
主要な発見
既存の研究に基づき、インタラクティブなエージェント型プログラミングを研究するためのフレームワークを提案する。このフレームワークは、2025年10月から2026年4月までの約40万回のClaude Codeセッションのプライバシー保護分析に基づき、タスク構成、人間とAIの協力方法、およびタスク成功率を評価する。
典型的なセッションでは、人間がほとんどの計画決定、すなわち「何をするか」を担当し、Claudeがほとんどの実行決定、すなわち「どのように完了するか」を担当する。ユーザーの特定分野における専門知識が強ければ強いほど、各指示がClaudeに完了させる作業量は大きくなる。コーディングタスクにおいて、主要な職業グループの平均成功率——すなわち、ユーザーが本来意図したことを完了し、テストの通過やコードの提出など検証可能な証拠があるかどうか——は、ソフトウェアエンジニアとほぼ同等である。
ユーザーの分野における専門能力が高ければ高いほど、セッションが成功に終わる可能性が高まる。ただし、中級ユーザーとエキスパートユーザーの差はそれほど大きくない。観察した7か月間で、デバッグに使用されるセッションの割合はほぼ半減し、使用方法はよりエンドツーエンドのエージェント型へとシフトしている:コードのデプロイと実行、データ分析、および非コード文書の作成などである。
この7ヶ月間で、典型的なタスクの価値はほぼすべての職種において上昇しました。フリーランスの求人情報との比較を通じてタスクの価値を推定したところ、平均で約25%の上昇が見られました。
はじめに
エージェントプログラミングが急速に台頭しています。2025年末以降、GitHubプロジェクトにおけるコーディングエージェントの活動割合は2倍以上に増加し、Claude Codeユーザーは現在、平均して週20時間このツールを使用しています。正式なプログラミング経験がない人が、エージェントを指揮して複雑な技術作業を成功させることができるのでしょうか?これらのツールの急速な採用と能力向上は、より広範な知識労働にどのような影響を与えるのでしょうか?現時点では完全な答えを出すことはできませんが、Claude Codeの使用データからいくつかの初期の兆候を見ることができます。
本レポートは、2025年10月から2026年4月までの期間における、約23万5千人のユーザー、約40万回のインタラクティブセッションのプライバシー保護分析に基づき、Claude Codeの実際の使用状況に関する証拠を提供します。これは、Claude Codeセッションにおける自律性指標や、Claude CodeがAnthropic社内の業務をどのように変えているかに関するこれまでの研究を継続するものです。本稿では、インタラクティブなAIプログラミングアシスタントの使用状況を説明するためのフレームワークを提案します。人々がどのような仕事をしているのか、誰がその仕事をしているのか、そして仕事が成功しているのかどうか。私たちは、ユーザーがコマンドラインインターフェース(CLI)、Claude.ai、またはClaude Codeデスクトップアプリケーションを介してClaude Codeを使用しているケースに注目しています。モデルの能力向上に伴い、エージェントプログラミングの使用方法がどのように変化するかを追跡することで、これらのツールがプログラミング専門家や知識労働者の労働市場に与える影響をより深く理解することができます。
Claude Codeで起きていることは、知識労働の未来を示唆しているかもしれません。エージェントが徐々に非コーディング業務に組み込まれていくのです。Claudeはより複雑で価値の高いタスクを処理していることがわかりました。同時に、エージェントプログラミングには依然として明確な分業が存在します。人間が何を構築するかを決定し、エージェントがどのように構築するかを決定します。
また、ツールの効果を真に増幅するのはプログラミングの熟練度ではなく、ドメインの専門知識であるという証拠も見られます。特にドメインエキスパートは成功しやすく、エラーや誤解から回復しやすい傾向があります。ただし、エキスパートと中級ユーザーの間の差はそれほど大きくありません。これは、ある分野で十分な熟練度があれば、深い専門家とほぼ同等にこれらのツールを効果的に使用できることを示しています。
これらの発見により、労働市場で起こりうる変化を予備的に観察することができます。私たちのデータでは、成功はその人がプログラミングの訓練を受けているかどうかではなく、解決しようとしている問題を理解しているかどうかに依存しています。これらのパターンが経済全体で成立するのであれば、エージェントプログラミングツールは実装寄りの仕事の一部を吸収しつつある一方で、自分の仕事における問題を真に理解している人に報酬を与えていることを意味します。コーディングエージェントはドメインの専門知識を代替しているわけではありません。むしろ、ワーカーがエージェントに提供する理解が多ければ多いほど、エージェントが実行できる高品質な作業も増えるのです。
分業
人々がClaude Codeで何をしているか
人々がClaude Codeをどのように利用しているかを理解するため、各セッションを9つの作業モードのいずれかに分類しました。これは、そのセッションの目標を最もよく表す単一のアクティビティです。そのうち4つのモードは、コードの作成や保守に直接関わるものです。新しいものの構築、壊れたものの修正、コードのテスト、そして他のエージェントや自動化パイプラインのオーケストレーションです。別のカテゴリとして、ソフトウェアの運用(デプロイ、設定、パイプラインの実行、システムの監視)があります。さらに2つのモードは、「何をすべきか」を明確にすることに重点を置いています。既存システムの動作理解と、変更を加える前の計画立案です。最後の2つはコードとは無関係、またはコードが最終成果物の補助的な要素に過ぎないものです。データ分析、およびプレゼンテーションやその他のテキストベースのドキュメントによるコミュニケーションです。
約56%のセッションは、コード作成(25%)、コード修正(26%)、またはテストとコードのオーケストレーション(5%)で構成されています。ソフトウェアの運用が17%、計画または探索が14%、分析またはテキスト作成が13%を占めています(図1参照)。
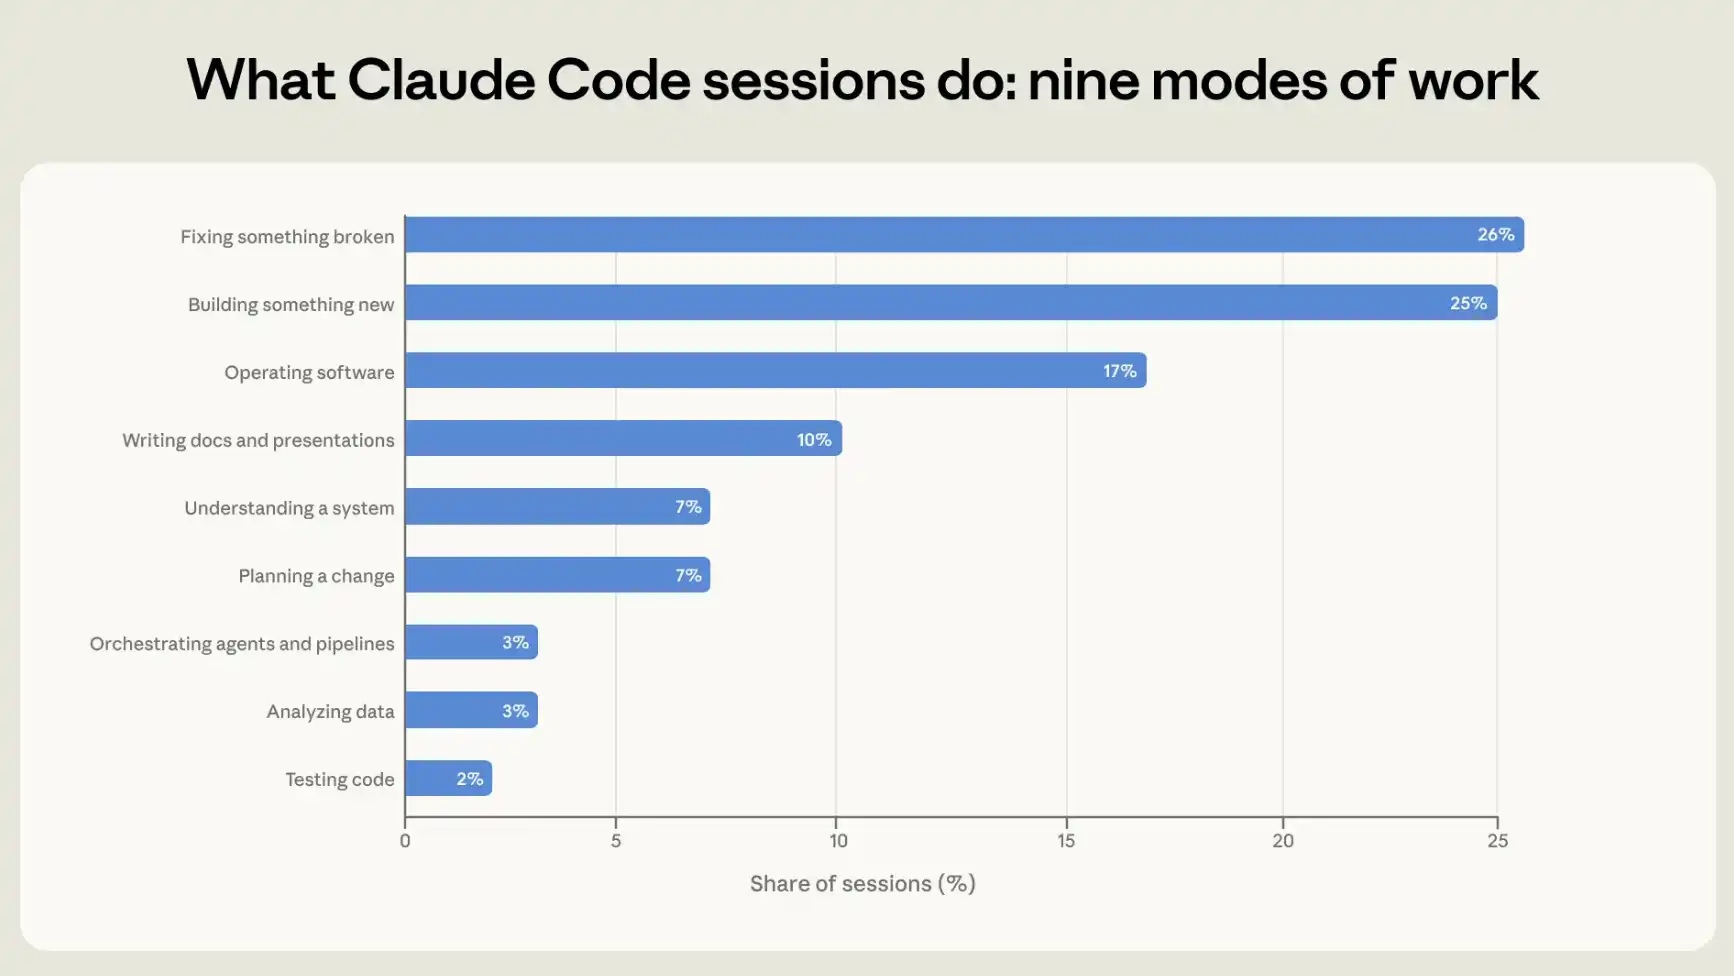
図1:9つの作業モード。各インタラクティブセッションは、その目標を最もよく表す単一の作業モードに分類されます。
まずモデルにセッション記録を読み込ませ、それに基づいて各セッションを分類します。その後、プライバシー保護分析ツールを使用して、分類結果を各セッションで自動記録されたテレメトリデータ(コード行の追加や削除の有無など)と相互検証します。両者の間には高い一貫性があります。例えば、作成またはコード修正として分類器がラベル付けしたセッションの90%以上で、テレメトリデータにもコード変更が存在していました。詳細は付録を参照してください。
誰が決定を下すのか
Claude Codeの自律性はどの程度でしょうか?能力評価によれば、その上限はすでに高く、さらに上昇し続けています。例えば、METRのタイムスパン評価などのベンチマークでは、最先端のモデルは現在、人間が数時間かかるソフトウェアタスクを自律的に完了し、その過程で自ら障害を克服できるようになっています。しかし、実際の使用状況はどうでしょうか?ここでは、実際のセッションにおいて、人間とClaudeがそれぞれどれだけの誘導作業を担っているかに焦点を当てます。
この問題を2つの観点から調査します。第一に、人々がどの程度まで決定をClaudeに委ねているかに注目します。第二に、彼らがClaudeにどれだけの行動を割り当てているかを観察します。セッション内の決定の分業を理解するために、セッション内容に基づいてプライバシー保護された決定帰属分類器を構築しました。この分類器に、セッション内のすべての意味のある決定をリストアップさせ、それらを計画決定と実行決定に分類させます。計画決定には、何をするか、どの方法を採用するか、何をもって完了とするかが含まれます。実行決定には、どのファイルを修正するか、どのコードを書くか、どの言語で書くか、どのコマンドを実行するかが含まれます。その後、分類器は各決定をClaudeまたはユーザーに帰属させ、セッションごとに2つの数値を生成します。ユーザーが担った計画決定の割合と、ユーザーが担った実行決定の割合です。
平均すると、人間は計画決定の約70%を行うが、実行決定の約20%しか行わない(図2参照)。実際の使用において、エージェントプログラミングは明確な分業を形成している。人間は何を構築するかを決定し、エージェントはどのように構築するかを決定する。
1回のセッションにおける行動委任の度合いを理解するため、内容ではなくセッション構造に注目する。Claude Codeのセッションは、Claudeとユーザー間のやり取りで構成される。ユーザーがプロンプトを送信し、Claudeがアクションを実行、その後ユーザーが次のプロンプトを送信する、という繰り返しである。典型的なセッションでは、このラウンド数は約4回である。10月から4月までの履歴データでは、ユーザーがプロンプトを1回送信するごとに、平均してClaudeが約10個のアクションを実行し、時には100個を超えることもある。各ラウンドで、Claudeはファイルの読み取り、コードの編集、コマンドの実行を行い、平均2400語を出力する。
Claudeが2回のユーザーチェックの間にどれだけの作業を完了するかは、誰が意思決定を行うかに大きく依存する。ユーザーが実行プロセスの制御を保持する場合、つまりユーザーが実行決定の80%以上を行う場合、Claudeは1ラウンドあたり約8個のアクションを実行する。一方、Claudeが計画制御を掌握する場合、つまりClaudeが計画決定の80%以上を行う場合、Claudeが担当するアクション数は最大で約16個となる。
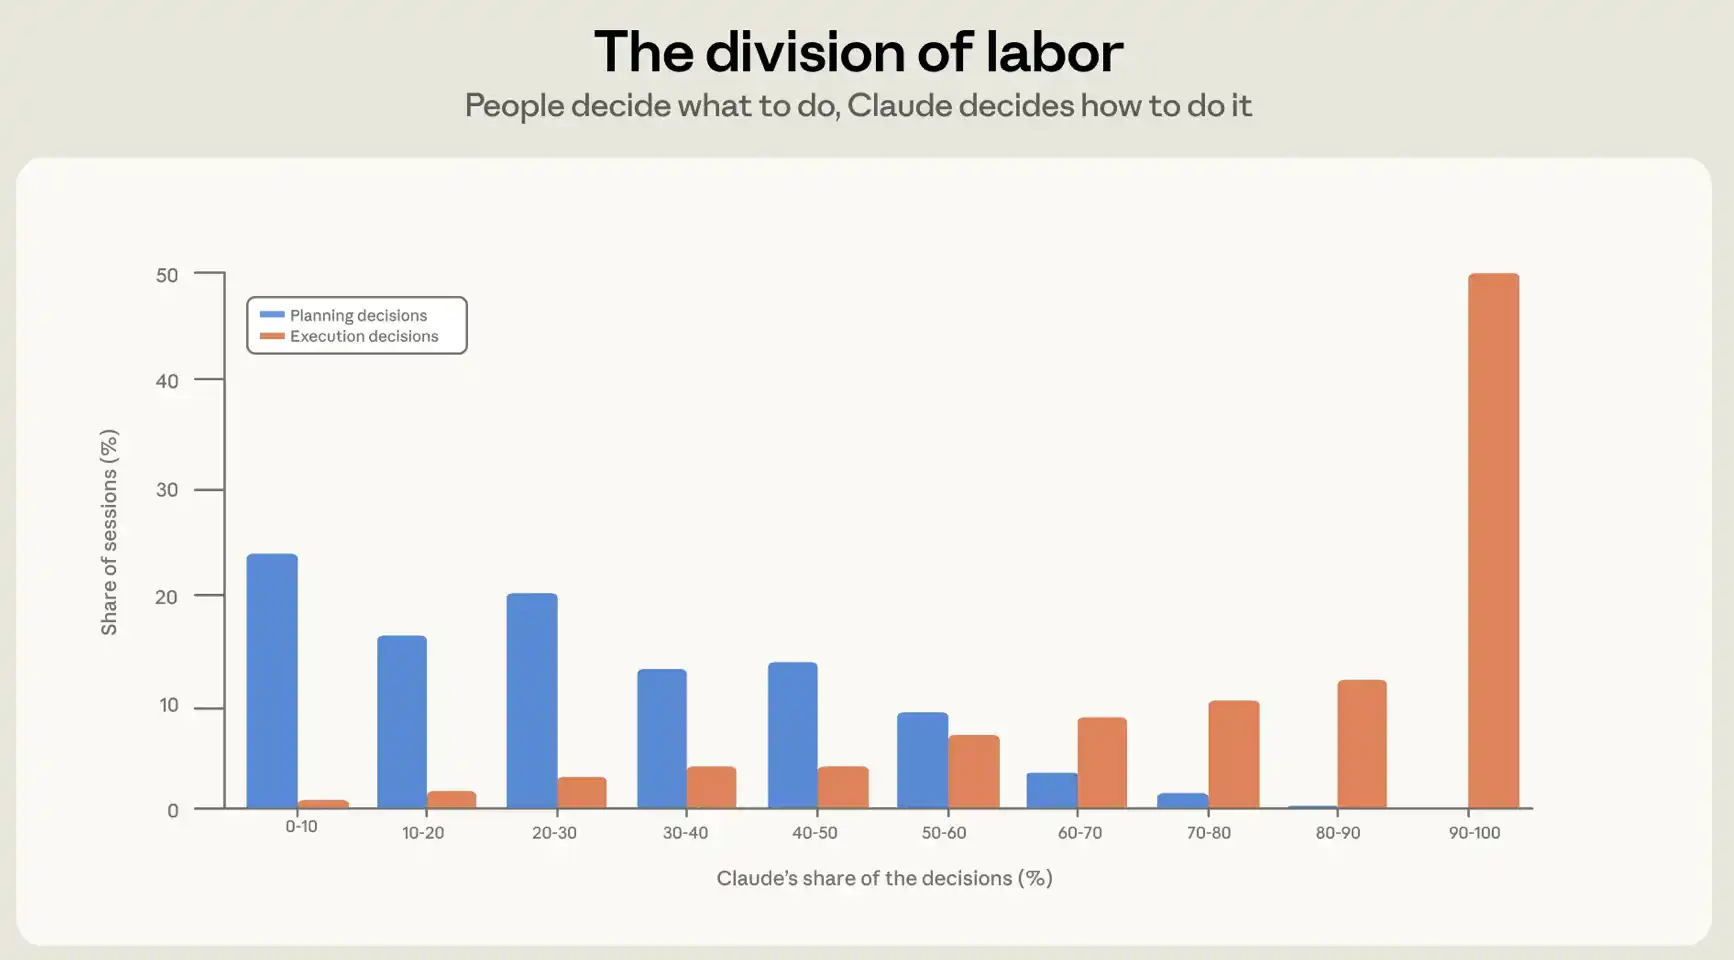
図2:計画および実行決定におけるClaudeの割合。この図は、異なるセッションにおいて、計画決定(何をするか)と実行決定(どのようにするか)がユーザーではなくClaudeに帰属する割合の分布を示している。典型的なセッションでは、ユーザーが計画決定の約70%を行い、Claudeが実行決定の約80%を行う。
専門レベル
各セッション記録に基づき、Claudeは5段階評価で、そのタスクにおけるユーザーの見かけ上の専門レベルを初心者からエキスパートまで評価する。専門レベル分類器は3つのシグナルに注目する。ユーザーが指示をどの程度正確に与えるか、ユーザーがClaudeに何を検証させるか、そしてユーザーがClaudeを訂正する頻度とClaudeがユーザーを訂正する頻度のどちらが多いかである。注意すべき点として、ここでの専門レベルは役職や一般的な能力とは全く異なる概念であり、重要なのはタスク固有であるということだ。ベテランエンジニアが初めてRustについて質問する場合、Rustタスクにおいては依然として初心者である可能性がある。Pythonを使ったことがない会計士でも、特定のPythonスクリプトが実行すべき照合ルールを正確にClaudeに伝え、月末締め処理で誤って処理される境界ケースを把握できれば、そのタスクにおいてはエキスパートである。
以下の表は、分類器で各専門レベルをどのように定義しているかを示し、公開されているコーディングエージェント会話データセットSWE-chatからのサンプルリクエストを提示しています。「初心者」に分類された会話は、特定のドメイン知識を示さない一般的な指示を与えるものです。「エキスパート」に分類された会話は、コードベースと技術環境に対する深い理解を伝えています。
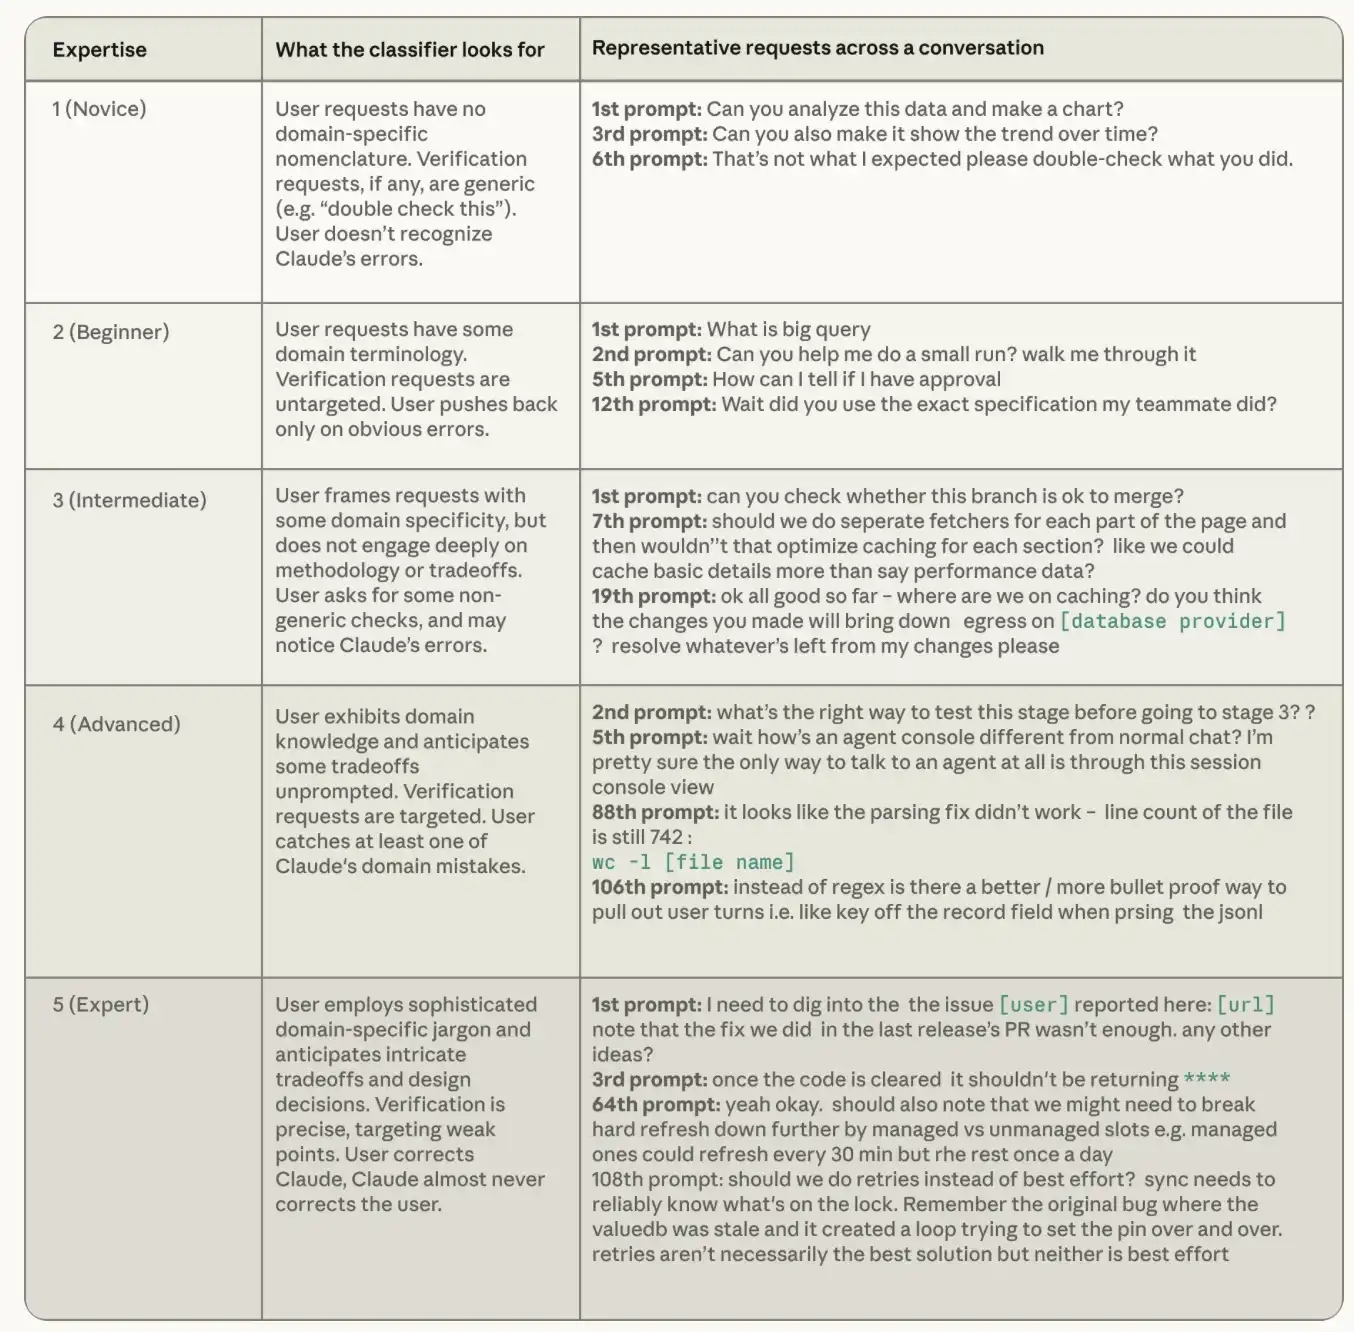
表1:専門レベル分類器。サンプルは実際の会話を書き換え、匿名化し、圧縮したもので、関連する会話は当社の分類器によってラベル付けされています。これらのサンプルの多くは、公開されているエージェントプログラミング会話データセットSWE-chatからのものです。
専門レベルと、Claudeがプロンプトごとに生成する出力およびアクティビティ量との関係を定量化しました。典型的な初心者セッションでは、プロンプトごとにClaudeが約5つのアクションを実行し、約600語を出力します。一方、エキスパートセッションでは、アクションチェーンの長さはその2倍以上で約12アクション、出力量は約3200語と5倍になります(図3参照)。この初心者とエキスパートの差は、あらゆる作業タイプとタスク価値帯で見られます。
これらの指標は、Claude Codeの自律性に関するこれまでの研究を補完するものです。これまでの研究では、エージェントの実行時間や、ユーザーがそのアクションを自動承認する頻度を追跡していました。対照的に、当社の意思決定帰属指標は、セッション全体で誰が実質的な意思決定を行っているかを捉え、プロンプトごとの出力量とアクション数は、各人間の指示がClaudeにどの程度の自律的活動を引き起こすかを測定します。
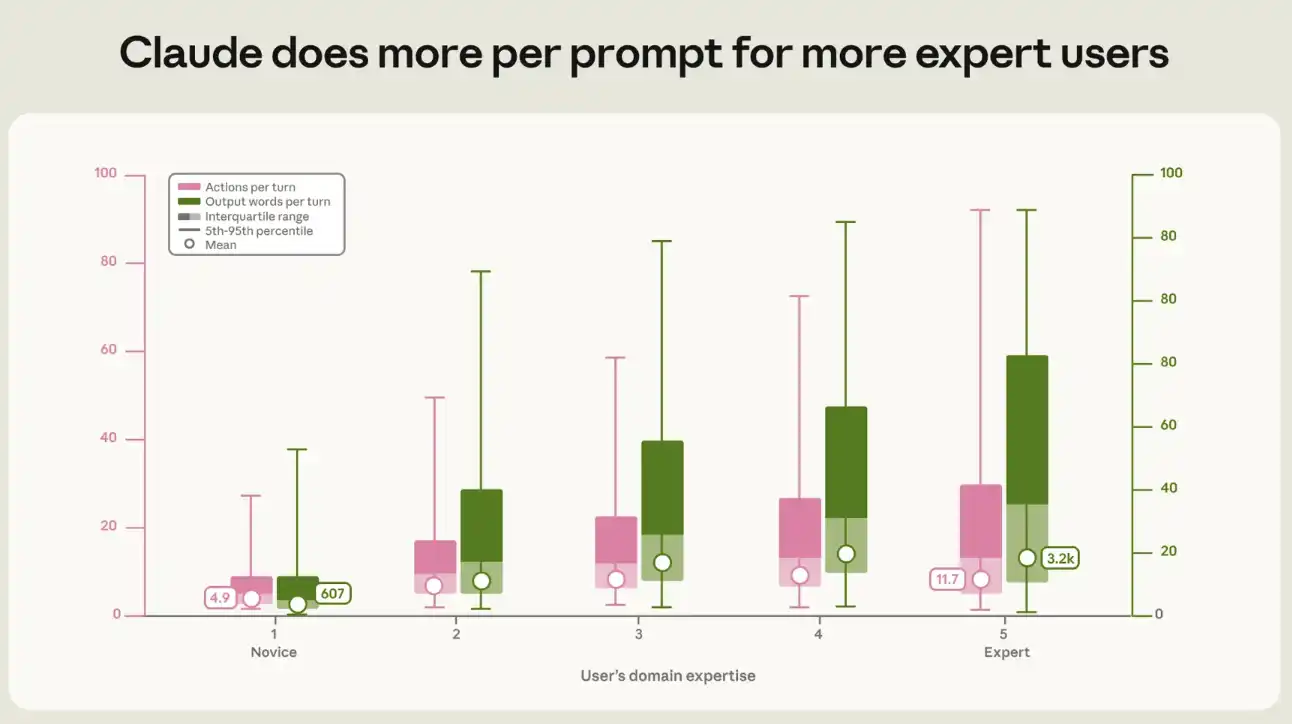
図3:より専門的なユーザーに対して、Claudeはプロンプトごとにより多くの作業を完了します。専門レベルが高いほど、Claudeがプロンプトごとに生成するアクション数(左側の棒グラフ)とテキスト出力量(右側の棒グラフ)が増加します。箱は四分位範囲を示し、中央値で分割されています。ひげは第5百分位から第95百分位を示します。白点は幾何平均です。両方の上昇傾向は統計的に有意であり(p < 0.001)、隣接する専門レベル間の各ステップの差も統計的に有意です。作業モード、タスク価値、月、職業、モデルシリーズを制御し、ユーザーごとにクラスター化された標準誤差を使用した後でも、この傾向は有意です:専門レベルが1段階上がるごとに、アクション数が9%増加し、出力量が13%増加します。
誰がClaude Codeを使用し、何に使用しているか
ユーザー
誰がこれらの作業を行っているのかを理解するため、セッション記録に基づいて各ユーザーの職業を推測し、米国労働統計局の標準職業分類(SOC)システムにおける23の主要カテゴリーのいずれかにマッピングしました。分類器は、以下のシグナルのみに基づいて判断するよう指示されています:エージェントがセッション開始時に読み込んだプロジェクトコンテキスト、ファイル名と構造、ユーザーが参照する資料や成果物(例:法律文書、臨床データ、財務報告書、コース教材など)、およびユーザーが使用する語彙です。分類器は、「コードを書いている」という事実そのものを、ユーザーがプログラミング職に就いている証拠とみなさないよう明確に指示されています。ソフトウェアまたはデータ業務がユーザーの職業であることを示す明確なシグナルがある場合にのみ、セッションはコーディング関連のSOCカテゴリー、すなわち「コンピュータおよび数学職」に分類されます。弁護士が、一連の契約書に特定の条項が欠けていないかを自動チェックするスクリプトを作成した場合、そのセッションが主にソフトウェア作成に関するものであっても、法律職に分類されます。ユーザーの職業に関するシグナルが一切ない場合、そのセッションは分類されません。
約70%のセッションで職業を推測することができました。これらの分類可能なセッションの中で、「コンピュータおよび数学職」が最大のグループでした。これは、このカテゴリーがほとんどのソフトウェア関連業務をカバーしているため、驚くべきことではありません。次いで、ビジネスおよび金融オペレーション、アートデザインおよびメディア、管理、ならびに生命科学、物理科学、社会科学が続きました。私たちのサンプルにおいて、最も急速に成長している非ソフトウェア職業グループは、管理、営業、および法律職でした。
業務
2025年10月から2026年4月にかけて、人々がClaude Codeを使用して完了した業務の構成は大きく変化しました。最も顕著な変化は、壊れたコードを修正するためのセッションの割合が33%から19%に減少したことです(図4参照)。代わりに、コードを中心とした業務が増加しました。ソフトウェアを操作する割合は14%から21%に上昇しました。ライティングとデータ分析は約2倍に増加し、約10%から約20%になりました。
タスク自体の価値も上昇しています。私たちは、同様の業務をフリーランス市場で行った場合のコストを推定し、実際の公開求人データセットを使用して較正することで、各セッションの経済的価値を近似的に測定しています。この指標によると、平均セッションの推定価値は10月から4月の間に27%上昇しました。この上昇は、さまざまな業務タイプで見られました。構築、操作、修正タスクの価値は、それぞれ約43%、34%、32%増加しました。これらの価格推定は大まかなものであるため、主に異なるタスク間の経時的な傾向を比較するために使用し、直接的なドル価値として読み取ることはしません。タスク価値推定器の構築方法の詳細については、付録を参照してください。
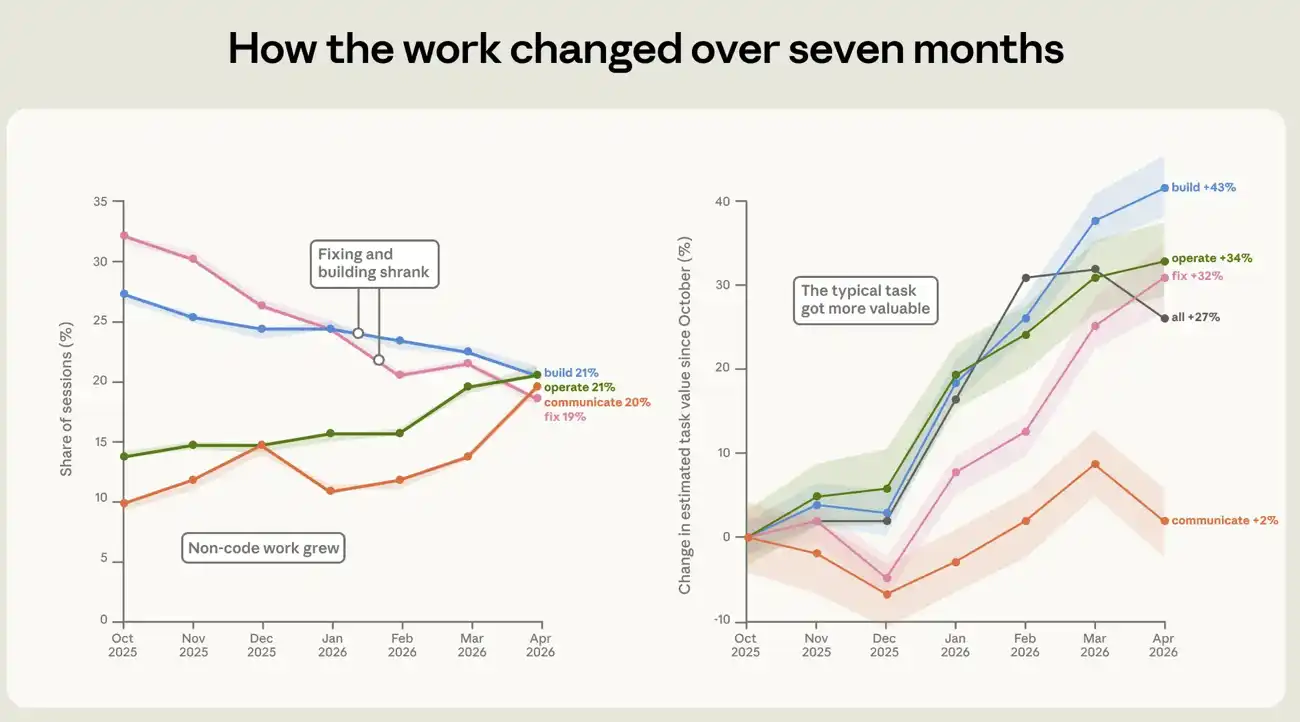
図4:2025年10月から2026年4月までのClaude Codeの作業構成と価値の変化。この図は、7ヶ月間のウィンドウにおける各作業モードのセッション内での割合を示している。壊れたコードを修正するセッションの割合は33%から19%に減少し、ソフトウェアの操作、データ分析、ドキュメント作成の割合が増加している。
成功はユーザーが何をもたらすかにかかっている
タスクの価値を推定することは、Claude Codeが人々の作業をどのように支援しているかを理解する一つの方法である。別の視点として、どれだけのセッションが成功しているか、そしてどのセッションの特徴が成功と関連しているかを観察することも重要である。すべての成功指標において、明確なパターンが見られる:セッション内でユーザーが示す専門性のレベルが高いほど、セッションが成功する可能性が高くなる。改善の大部分は専門性の低い側に集中しており、つまり初心者から中級ユーザーへのギャップが、中級ユーザーからエキスパートユーザーへのギャップよりも大きい。
成功したセッションの特徴を分析する前に、成功をどのように測定するかを正確に説明する必要がある。我々はユーザーの現実世界での結果を観察することはできず、また彼らがClaudeを通じて意図したことを達成したかどうかを直接尋ねることもできない。そのため、セッション記録に基づく2つの補完的な測定方法に依存している。1つ目は「判定成功」であり、分類器が完全なセッション記録を読み、ユーザーが当初設定した目標を達成したかどうかを判断する。選択肢は成功、部分的成功、失敗、明確な目標なしである。その後、2つの補助分類器がその判断の証拠の強さを評価し、「検証済み成功」を確定する。成功シグナル分類器は検証可能な成功の証拠を探し、特にその作業に一致するgitアクティビティ(コミットやプルリクエスト、テストスイートの通過、ユーザーによる明確な承認など)を重視する。これは「シグナルなし」から「弱いシグナル」(1点)、「複数のハードシグナル」(5点)までの等級でセッションをスコアリングする。もう一つの並行する失敗シグナル分類器は、問題が発生した証拠(エラー、テスト失敗、同じことの繰り返し試行、ユーザーによる出力への反対など)をスコアリングする。検証済み成功には2つの条件が同時に成立する必要がある:セッションが成功と判定され、かつ少なくとも1つのハードな検証可能な成功シグナルが存在すること。以下の分析ではセッション内の成功または失敗の程度に焦点を当てるため、成功結果分類器によって「明確な目標なし」と判定されたセッションを除外している。これらのセッションは完全なサンプルの約7.7%を占める。
専門性のリターン
では、どのセッションが最も成功しやすいのか?結果は、前述のセッション専門性スコアがセッションの成功に大きな影響を与えることを示している。
専門性が真の推進要因ではないのではないかと懸念する人もいるかもしれない。おそらくエキスパートは異なるタスクを選択しているか、他の点で違いがあるのだろう。本節では、同じ作業タイプ、同じ推定価値、同じ月、同じトピック、同じ大まかな職業グループに属するセッションを比較し、ユーザーの専門性の違いが結果にどのように影響するかを検討することで、この懸念に部分的に応える。
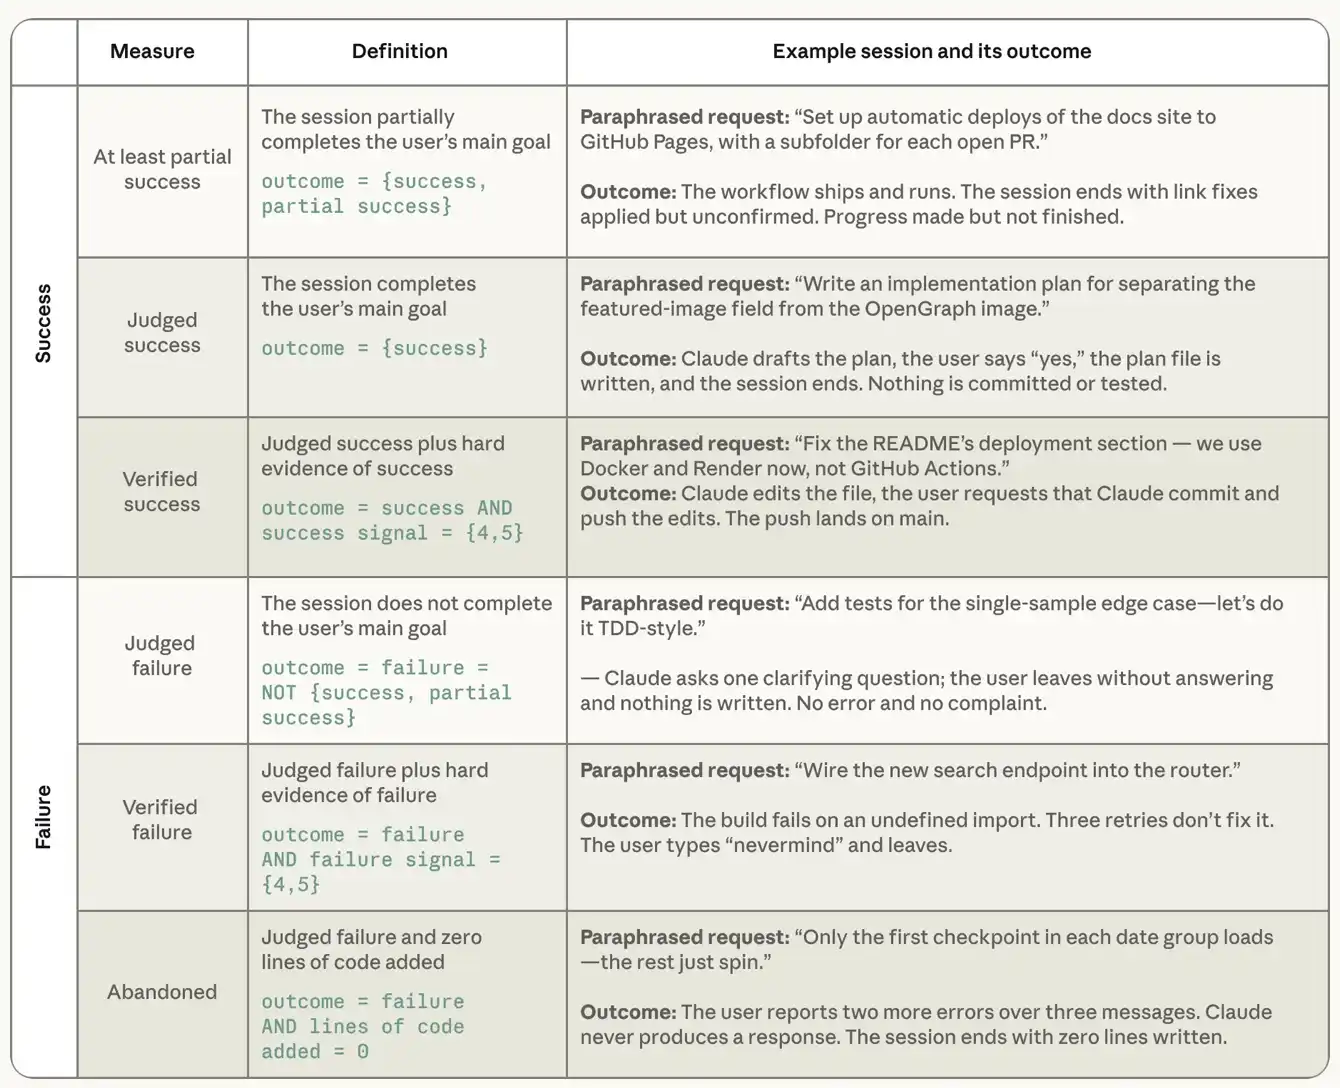
表2:分類器によって導き出された成功と失敗の定義。例は公開エージェントプログラミング対話データセットSWE-chatの実際のセッションから取得され、改変・要約された上で、当社の分類器によってラベル付けされています。
すべての成功指標において、セッション中にユーザーが示す専門性のレベルが高いほど、セッションが成功する可能性が高くなります。初心者と評価されたセッションでは、最も厳格な指標である「検証済み成功」に達する割合は15%、少なくとも部分的な成功に達する割合は77%でした。一方、中級以上と評価されたセッションでは、検証済み成功率は28%から33%、部分成功率は91%から92%でした(図5参照)。
各指標において、改善の大部分は初心者から中級への移行によるものです。中級からエキスパートへの移行では、その傾きは緩やかになります。図5の背後にある回帰分析の詳細については、付録を参照してください。
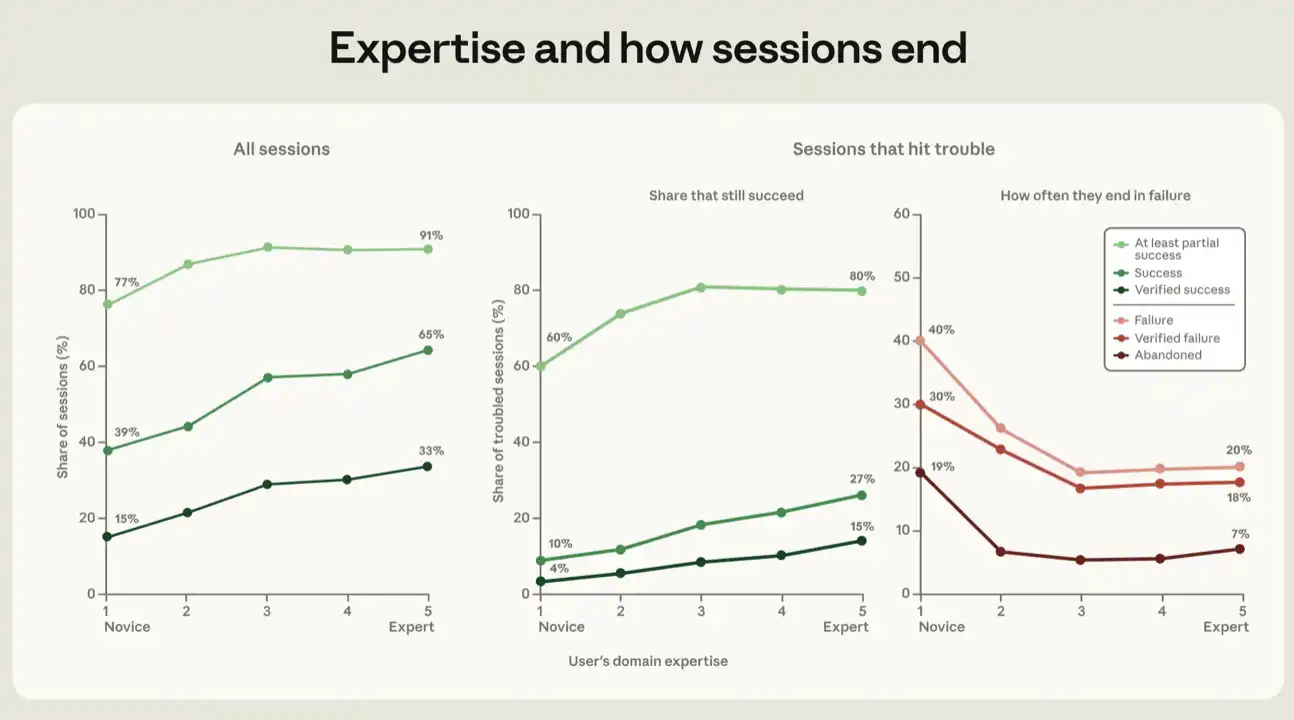
図5:専門性のレベルとセッションの結果。この図は、タスクにおけるユーザーの専門性スコア(初心者からエキスパートまでの5段階)に基づいて、セッションの結果を示しています。左図はすべてのセッションを含みます。中央図と右図は、問題が発生したセッション(つまり、失敗シグナルが3より大きいセッション)に限定し、これらのセッションが最終的に異なる成功・失敗の定義に達した割合を示しています。各点は調整後の比率です。同じ作業モード、同じタスク価値範囲、同じ月、同じタスクテーマ、同じユーザータイプ(ソフトウェア関連職業かどうか)を持つセッションのみを比較することで、異なる専門性レベル間の差異を推定しています。関連する回帰の詳細は付録を参照してください。ひげ線はサンプル平均の信頼区間を示しており、ほとんどの場合、小さすぎて図では見えません。これらの図は、成功結果分類器によって「明確な目標なし」と判定されたセッションを除外しています。
困難に直面したセッションでも、同様の勾配が見られます。失敗シグナルが検証済みの失敗証拠を記録した場合、そのセッションは「問題が発生した」と見なします。これには、エラーの発生、テストの失敗、同じことを達成するための複数回の試行、またはユーザーのフラストレーションや不満の表明が含まれる可能性があります。問題が発生したセッションにおいて、上記のすべての変数を制御した場合、検証済み成功の割合は初心者セッションの4%からエキスパートセッションの15%に上昇します(図5参照)。より緩やかな成功指標を使用すると、少なくとも部分的な成功に達する割合は、初心者ユーザーで60%、中級からエキスパートユーザーで80%から81%であることがわかります。
また、専門性のレベルとさまざまな失敗指標との間の逆の関係も追跡しました。この分析では、失敗と判定されたセッションは、部分的な成功にも達しなかったセッションであることに注意してください。問題が発生したセッションが失敗と判定され、かつコード行が一切書き込まれなかった場合、それは放棄されたと見なします。ユーザーが初心者に見えるセッションでは、19%が最終的に放棄されました。他のユーザーグループでは、この割合は5%から7%でした。言い換えれば、最も経験の少ないユーザーは、目標達成に努力し困難に直面した際に、より簡単に諦めてしまう傾向があります。専門性の価値の一部は、エージェントを正しい方向に導き戻す能力にあるようです。
キャリアよりも専門性の方が重要かもしれない
ソフトウェア関連職種のユーザーは、全セッションにおける検証済み成功率が約30%であるのに対し、その他の職種のユーザーは約26%でした。コード生成が行われたセッション、つまり少なくとも1行のコードが新規追加または修正されたセッションでは、これらの数値はそれぞれ34%と29%でした(図6参照)。成功の定義をより緩やかにすると、ソフトウェア関連職種とその他の職種との差はさらに縮まります。コード生成セッションにおいて、両方のユーザーグループが少なくとも部分的な成功を収めた割合は、それぞれ89%と88%でした。5パーセントポイントの差は大きくなく、7ヶ月の間に拡大も縮小もしていません。ただし、両グループの成功率は上昇しています。コード生成セッションにおいて、データセット内で最大の10の職種グループは、それぞれソフトウェアエンジニアとの成功率の差が7パーセントポイント以内に収まっています。管理職は検証済み成功率が最も高く、ソフトウェアエンジニアリング職をわずかに上回っています。管理者の検証済み成功率が高いのは、管理スキルがエージェントを指揮するタスクに転用可能であることを反映している可能性があります。しかし、これは測定方法に一部起因している可能性もあります。検証はセッション中のユーザーによる明確な確認に依存しており、管理者は望む結果が得られた際にそれを表明することに慣れている可能性があります。
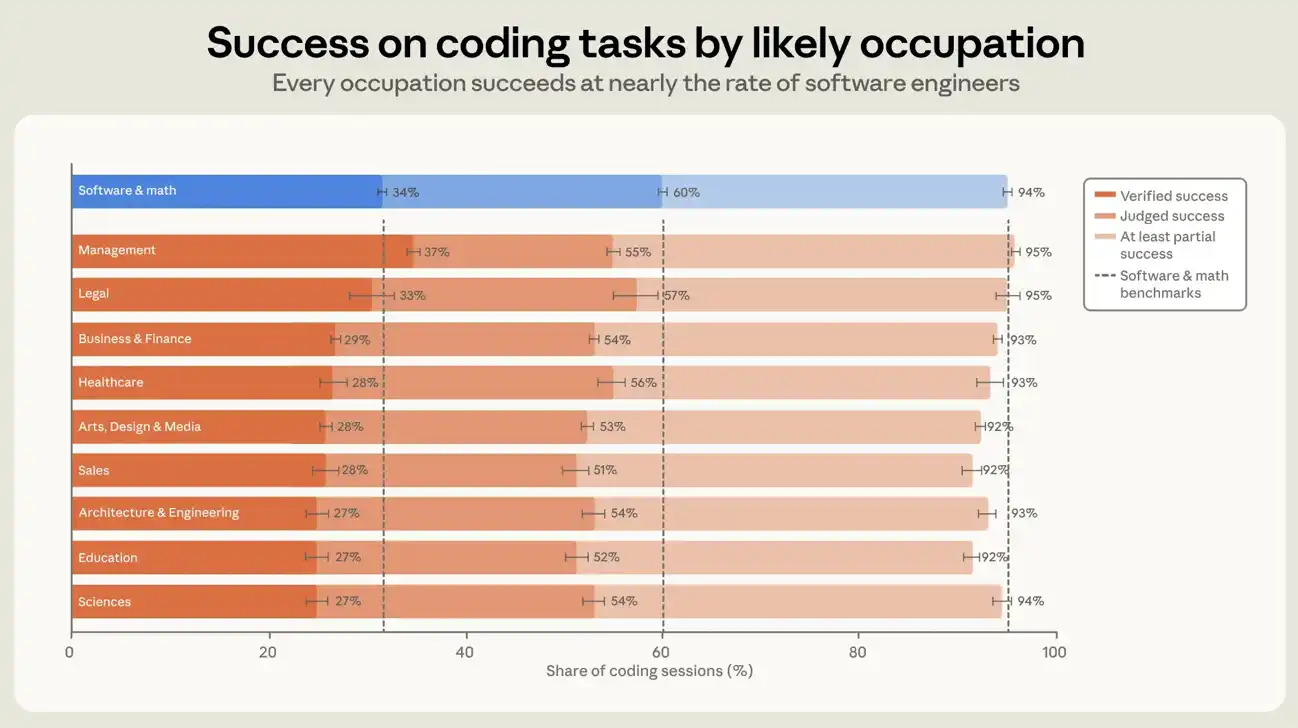
図6:推定職種別のコーディングセッションにおける判定成功率と検証済み成功率。この図は、少なくとも1行のコードが新規追加または修正されたセッションにおいて、ユーザーの推定職種別に厳格な成功定義の割合を示しています。判定成功と検証済み成功の両方を含みます。図には最大の10の職種グループが示されています。各グループとソフトウェア/数学系ユーザー(SOC分類におけるコンピュータおよび数学職)との成功率の差は、すべて7パーセントポイント以内です。エラーバーは、異なるアカウントに基づく95%信頼区間を示しています。
展望
本レポートの結果は、エージェントプログラミングが特定の知識やスキルを増幅させる一方で、他のスキルを代替しつつあるという、形成されつつある状況を描き出しています。コード生成セッションにおいて、主要な職種の成功率はソフトウェア関連職種と大きな差はありません。コーディングエージェントは、プログラミングタスクを成功させる上で、プログラミングのバックグラウンドを持つことが以前ほど重要ではなくなりつつあるように見えます。
同時に、成功したセッションはドメインの専門知識を示す可能性が高くなっています。専門家と評価されたセッションの検証済み成功率は、初心者のセッションの2倍以上です。セッションで問題が発生した場合、初心者が諦める割合は他のユーザーよりも数倍高くなります。コラボレーションの方法自体がこの状況をより明確にしています。ドメインの専門家は、各指示でClaudeをより多くの作業に導くことができます。したがって、Claudeを成功に導く能力は、コードを書く能力よりも、特定の領域への習熟度に由来しています。このような習熟度を持つあらゆる分野の人は、現在では過去には達成できなかった技術的な作業を完了できる可能性があります。一方、このような専門的な理解を欠く人は、同じツールを使用しても、得られる成果ははるかに少なくなります。そして、その恩恵は主に「熟達」から得られるものであり、「精通」からではありません。特定の領域に対して実用的な理解を持っていれば、その恩恵の大部分を得ることができ、深い専門化はその上にわずかな追加的な優位性をもたらすに過ぎません。
これらの発見は依然として暫定的なものです。当社の研究の大半と同様、実際の成果(例えば、1回のセッションで書かれたコードが後に実際に使用されたか破棄されたか、あるいは経済的価値を生み出したかどうか)を測定することはできません。また、本レポートで除外した非インタラクティブな使用は、全活動のかなりの部分を占めています。こうした使用を測定するフレームワークの開発は、今後の重要な課題の一つです。さらに、セッションの分類はすべて、モデルによるセッション記録の読み取りに依存しています。付録では、分類器が独立したテレメトリデータと期待される方向で一致し、ほとんどのセッションで強力な参照モデルの判断と一致することを示しています。しかし、大規模なシナリオでは分類器の検証は依然として困難です。Claude Codeのセッション自体も、長すぎて複雑になりがちなため、人手によるラベル付けを真実の基準として用いることが難しくなっています。
モデル、ユーザー、および両者の間の分業が変化し続けるにつれて、本レポートの状況も継続的に更新されます。これらの指標が、進行中の大きな変化を追跡する助けとなることを期待しています。例えば、将来的に専門性のレベルによるリターンが低下し始めた場合、それはモデルが現在ユーザーが提供している重要な判断を担い始め、これらのツールの恩恵が領域専門家からより広範な人々へと拡大していることを示すでしょう。ソフトウェア職業以外のユーザーがコーディングセッションを成功裏に完了する割合が上昇し続ければ、ソフトウェア制作が単一の職業の産物ではなく、あらゆる分野の一般的な業務の一部になりつつあることを意味する可能性があります。これらの変化は、誰がエージェントプログラミングから恩恵を受け、その恩恵の大きさがどうなるかを変え、労働市場で最も重視される能力に影響を及ぼします。
[原文リンク]
BlockBeats の公式コミュニティに参加しよう:
Telegram 公式チャンネル:https://t.me/theblockbeats
Telegram 交流グループ:https://t.me/BlockBeats_App
Twitter 公式アカウント:https://twitter.com/BlockBeatsAsia