中国AI算力反撃戦
文 | Sleepy.txt
八年前、中興(中国の通信機器メーカー)の心臓が停止した。
2018年4月16日、米商務省産業安全局(BIS)の禁輸令により、従業員数8万人を擁し、年間売上高1000億ドルを超える世界第4位の通信機器メーカーである中興通信は一夜にして停滞した。禁輸令の内容は非常に単純で、今後7年間、米企業による中興への部品、製品、ソフトウェア、技術の提供を禁止するものだ。
クアルコムのチップがなければ、基地局は製造中止となる。GoogleのAndroidの使用許諾がなければ、スマートフォンには運用可能なシステムがない。23日後、中興は公表し、主要な事業活動をもう継続できないと述べた。
しかし、中興は最終的に生き残ったが、その代償は14億ドルだった。
10億ドルの罰金を一括払い、4億ドルの保証金を米国の銀行の信託口座に預け入れる。さらに、全ての幹部が入れ替わり、米国側のコンプライアンス監視団が派遣された。2018年、中興は年間で70億人民元の純損失を記録し、売上高は前年比21.4%急落した。
当時の中興の会長である尹衍民は内部文書で次のように述べた。「私達は、世界の供給チェーンに高度に依存している複雑な産業に身を置いています。」 この言葉は、当時においては反省であり、無念であった。
八年後の2026年2月26日、中国のAIユニコーン企業DeepSeekは、今後発売予定のV4多モード大型モデルを、国産チップメーカーと緊密に協力し、NVIDIA以外の完全なプリトレーニングからファインチューニングまでのプロセスを初めて実現すると発表した。
つまり、私達はNVIDIAを使わなくてもよいのだ。
このニュースが発表されると、市場の最初の反応は疑問だった。NVIDIAは世界のAIトレーニングチップ市場で90%以上のシェアを持ち、それを諦めることはビジネス的に妥当なのだろうか?
しかし、DeepSeekの選択肢の背後には、ビジネスロジック以上の問題が潜んでいた:中国のAIは、果たしてどのような算力独立が必要なのか?
「首を絞められた」のは何か
多くの人々は、チップの禁輸令がハードウェアを止めたと考えているが、実際に中国のAI企業を窒息させたのはCUDAと呼ばれるものだ。
CUDAは、Compute Unified Device Architectureの略で、NVIDIAが2006年に発表した並列計算プラットフォーム兼プログラミングモデルである。これにより、開発者はNVIDIA GPUの算力を直接呼び出し、さまざまな複雑な計算タスクを加速させることができる。
AI 時代が到来する前、これは少数のギークに属するツールに過ぎませんでした。しかし、ディープラーニングの波が押し寄せて、CUDA はAI産業全体の基盤となりました。
AI モデルのトレーニングは、本質的に大量の行列演算です。そして、これがちょうど GPU が最も得意とする作業です。
NVIDIA は10年以上も前からの戦略に基づき、CUDA を使用して、ハードウェアからアプリケーションまでの完全なツールチェーンを世界のAI開発者に提供しました。今日、Google の TensorFlow から Meta の PyTorch まで、世界中のすべての主要なAIフレームワークは、CUDA と深く結びついています。
AIの専門家となる博士課程の学生は、入学初日からCUDAの環境で学習し、プログラミングし、実験を行っています。彼が書くコードのそれぞれは、NVIDIA の砦を固めています。
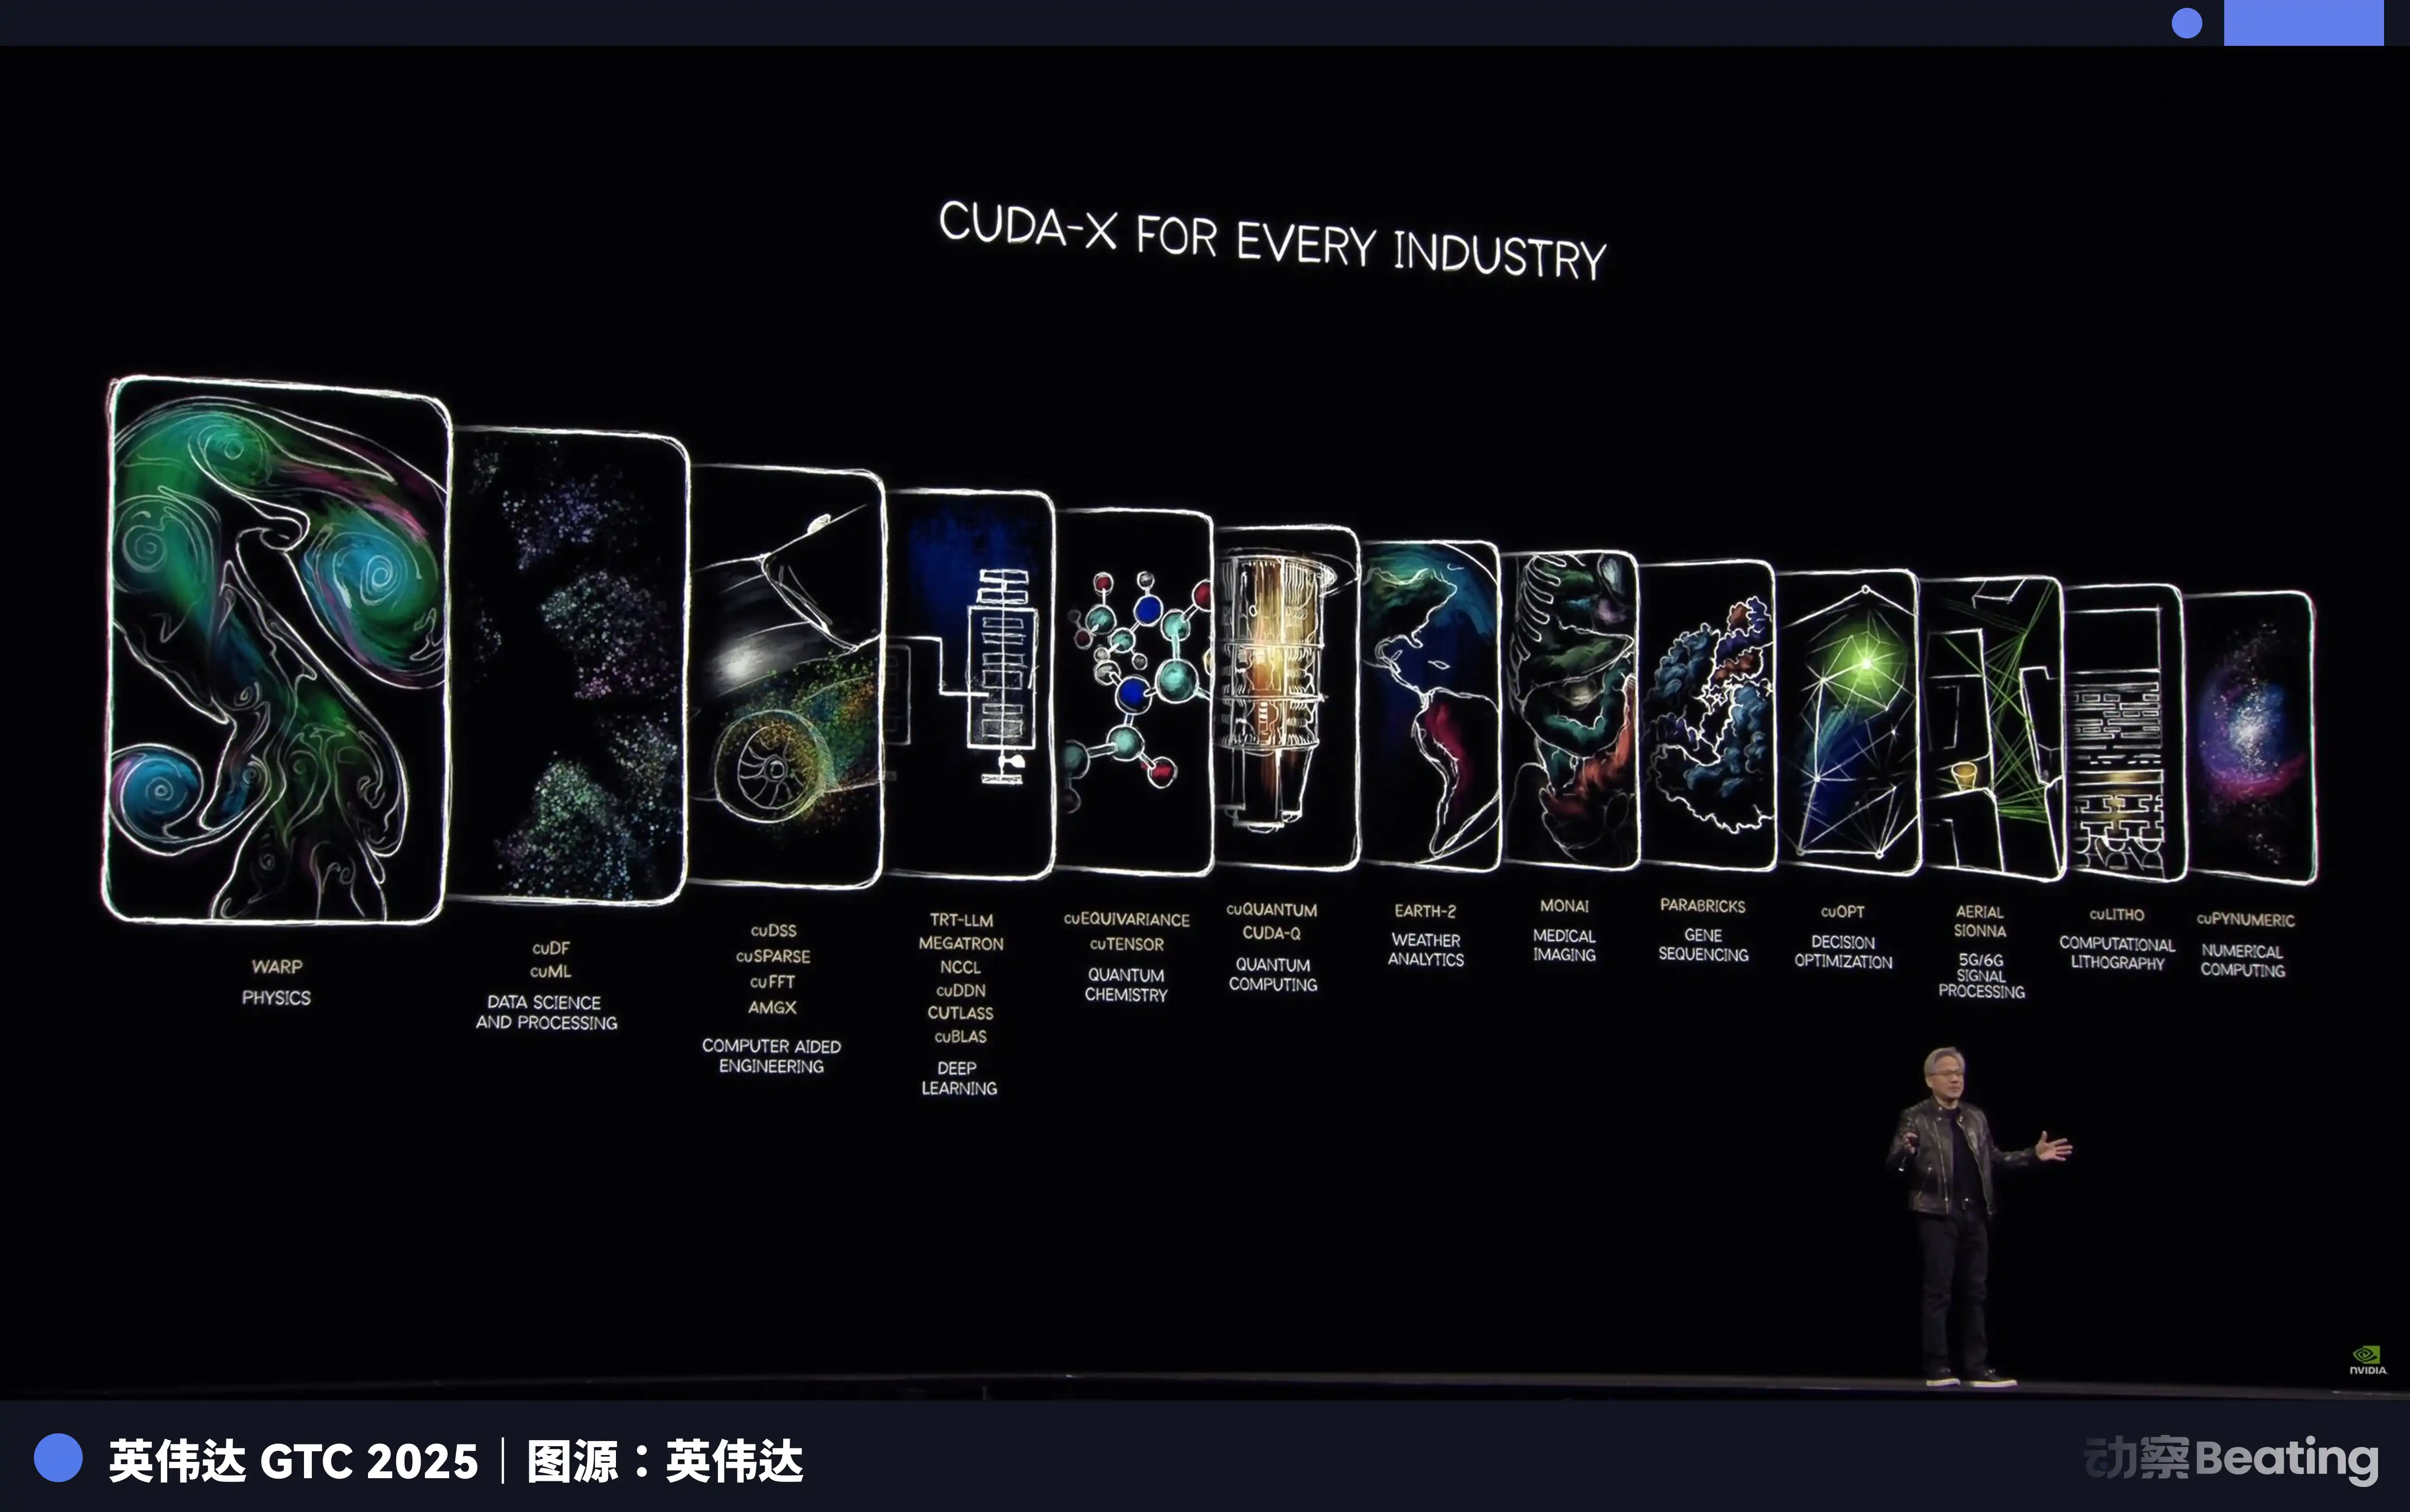
2025年までに、CUDA エコシステムには450万人以上の開発者がおり、3000を超えるGPUアクセラレーションアプリケーションがカバーされ、世界中で4万社以上の企業がCUDAを使用しています。この数字は、世界のAI開発者の90%以上が NVIDIA のエコシステムに拘束されていることを意味しています。
CUDA の恐ろしいところは、それが飛輪であることです。より多くの開発者が使用すればするほど、より多くのツール、ライブラリ、およびコードが生まれ、エコシステムはより繁栄します。エコシステムが繁栄すればするほど、さらに多くの開発者が参加するようになります。この飛輪が一度回り始めると、ほとんど動かすことができません。
その結果、NVIDIA はあなたに最も高価なスコップを売り、唯一の採掘姿勢を定義しています。スコップを変えたいですか?できます。しかし、過去10年間で、世界中の何万人もの最も賢い脳がこのポジションで積み重ねたすべての経験、ツール、コードを一から書き直さなければなりません。
これらのコストは誰が負担するのでしょうか?
そのため、2022年10月7日、BIS が初めて規制を実施し、NVIDIA A100とH100の中国への輸出を制限したとき、中国のAI企業は初めて ZTE のような窒息感を集団で感じました。その後、NVIDIA は「中国専用版」のA800とH800を発売し、チップ間のインターコネクト帯域幅を低下させ、供給を何とか維持しました。
しかし、わずか1年後の2023年10月17日、2回目の規制が再度強化され、A800とH800も禁止され、13社の中国企業が物理リストに掲載されました。NVIDIA はさらに切り詰められた H20 を発売せざるを得なくなりました。2024年12月までに、バイデン政権任期内の最後の規制が施行され、H20の輸出さえ厳しく制限されました。
スリーレベル管理、段階的強化。
しかし、今回の物語の展開は、かつての中興とはまったく異なります。
非対称的な突破
禁止令の下、誰もが中国AIの大規模モデルの夢がここで終わると思っていました。
皆が間違っていました。ブロック対処に直面して、中国の企業は正面からぶち当たることを選択せず、突破口を開始しました。この突破の最初の戦場は、チップではなくアルゴリズムにありました。
2024年末から2025年、中国のAI企業は集団で1つの技術方向にシフトしました:ハイブリッドエキスパートモデル。
簡単に言えば、巨大なモデルを多くの小さな専門家に分割し、タスクを処理する際には関連性の高いいくつかだけをアクティブにし、モデル全体を動かすのではないというものです。
DeepSeekのV3は、この発想の典型的な例です。6710億のパラメータを持っていますが、推論ごとに370億個だけをアクティブ化し、総量の5.5%にすぎません。トレーニングコスト面では、2048個のNVIDIA H800 GPUを使用し、58日間トレーニングを行い、総額557.6万ドルかかりました。比較として、GPT-4のトレーニングコストの外部見積もりは約7800万ドルです。オーダーの違いがあります。
アルゴリズム上の究極の最適化は、価格に直接反映されます。DeepSeekのAPI価格は、入力毎に100万トークンあたりわずか0.028〜0.28ドルで、出力は0.42ドルです。一方、GPT-4の入力価格は5ドルで、出力は15ドルです。Claude Opusはさらに高く、入力は15ドルで、出力は75ドルです。換算すると、DeepSeekはClaudeよりも25〜75倍安いです。
この価格差は、世界の開発者市場で大きな反響を呼んでいます。2026年2月、世界最大のAIモデルAPI集約プラットフォームであるOpenRouter上で、中国のAIモデルの週間コール数が3週間で127%急増し、初めてアメリカを超えました。1年前、中国のモデルはOpenRouterのシェアが2%未満でした。1年後、421%増加し、アメリカのシェアに迫っています。
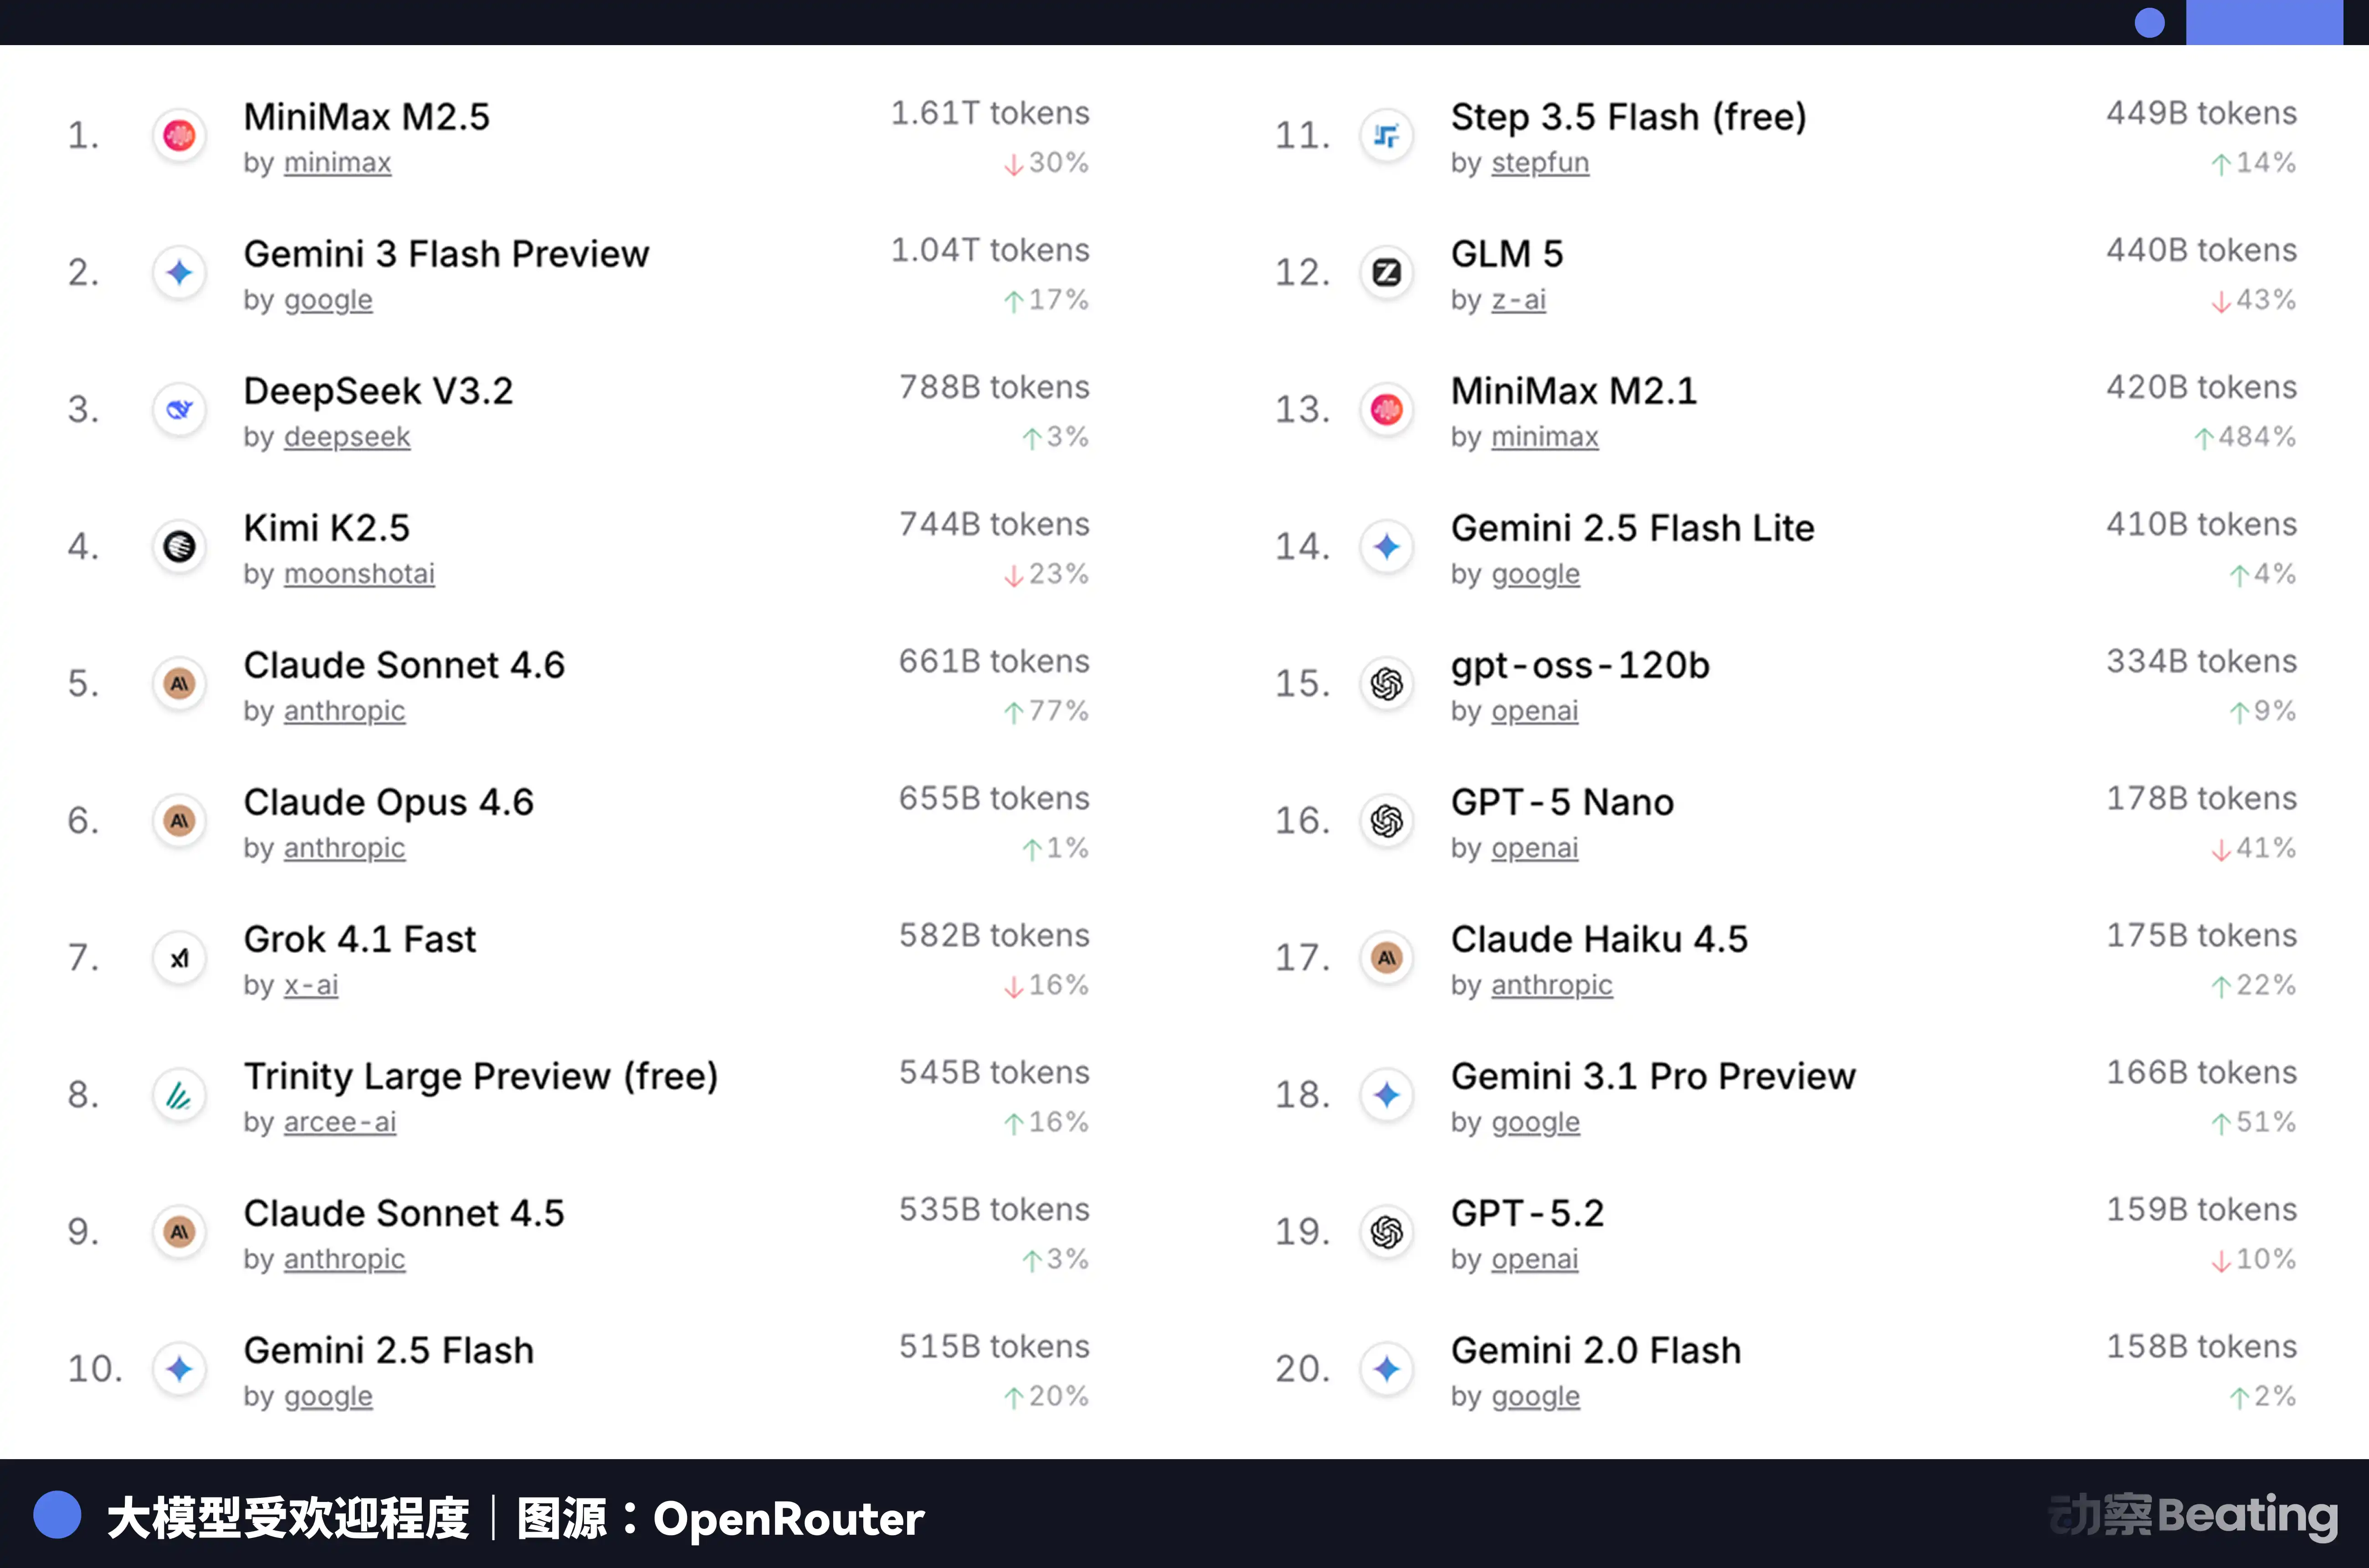
このデータセットの背後には、見落とされがちな構造的変化があります。2025年下半期以降、AIアプリケーションの主要なシナリオは、チャットからエージェントへ移行しました。エージェントシナリオでは、1つのタスクのトークン消費量が通常のチャットの10〜100倍です。トークン消費量が指数関数的に増加すると、価格が決定要因となります。中国モデルの究極のコストパフォーマンスは、ちょうどこのウィンドウにヒットしました。
しかし、課題は、推論コストの低下がトレーニングの根本的な問題を解決していないことです。最新のデータで持続的にトレーニングおよびイテレーションできない大規模モデルは、能力が急速に低下します。トレーニングは、回避できない計算リソースのブラックホールです。
それでは、トレーニングの「シャベル」はどこから来るのでしょうか?
スペアタイヤの正式採用
江蘇省興化市、蘇中の小さな町は、ステンレス製品と健康食品で知られており、以前は AI とはまったく関係がありませんでした。しかし、2025 年には、ここで148メートルの国産計算リソースサーバー生産ラインが建設され、稼働しました。契約から投産まで、わずか180日でした。
この生産ラインの中心には、2つの完全国産のチップがあります:Loongson 3C6000プロセッサーとTaisulai T100 AIアクセラレーターカード。Loongson 3C6000 は、命令セットからマイクロアーキテクチャまで、すべて自主研究開発されています。Taisulai T100 は、国家スーパーコンピューティング中心と清華大学チームによるもので、異構造のマルチコアアーキテクチャを採用しています。
この生産ラインは、フル稼働時に1台のサーバーを5分ごとに生産し、この生産ラインの総投資額は110億元で、年間10万台の生産を予定しています。
さらに重要なのは、これらの国産チップで構成される万カードクラスターが、すでに本格的な大規模モデルトレーニングタスクを引き受け始めていることです。
2026年1月、Zhipu AI はファーウェイとGLM-Imageを発表しました。これは、完全に国産チップに依存して実施された SOTA 画像生成モデルの最初のものです。2月には、中国電信の千億規模の「Starlight」大規模モデルが、上海・リンガンの国産万カード計算リソースプールでフルプロセスのトレーニングを完了しました。
これらの事例の意義は、国産チップがすでに「推論に使用可能」から「トレーニングに使用可能」に飛躍したことを証明していることです。これは質的変化です。推論にはすでにトレーニングされたモデルを実行するだけであり、チップへの要件は比較的低いです。一方、トレーニングには大量のデータの処理、複雑な勾配計算およびパラメータ更新が必要であり、チップの計算リソース、インターコネクト帯域幅およびソフトウェアエコシステムの要求は1つの数量レベル高くなります。
これらのタスクを担う中核的な力は、ファーウェイのアセンションシリーズチップです。2025年末までに、アセンションエコシステムの開発者数は400万人を超え、パートナーは3000を超え、43の業界主要大規模モデルがアセンションをベースに事前訓練を完了し、200以上のオープンソースモデルが適応されました。2026年3月2日のMWC会議では、ファーウェイは海外市場向けに新世代の計算リソースベースのSuperPoDを初めて発表しました。
昇腾 910B の FP16 パフォーマンスはすでに NVIDIA A100 と同等になっています。まだ差はありますが、利用可能から利用中へ、そして利用中から使いやすいへと進化しました。エコシステムの構築は、チップが完璧になるのを待つべきではなく、使える段階で大規模に展開し、ビジネスニーズに基づいてチップとソフトウェアを進化させる必要があります。バイトダンス、テンセント、バイトダンスは、国産のパワフルサーバーを導入する目標を掲げ、2026 年に前年比で倍増することが一般的になると見込まれています。中国の工業情報化省のデータによると、中国のスーパーコンピューティング能力はすでに 1590 エクサフロップスに達しています。2026 年は、国産のコンピューティング能力が展開される元年となりつつあります。
米国の電力不足と中国の進出
2026 年初め、世界の多くのデータセンタートラフィックを支えてきたバージニア州は、新しいデータセンター建設プロジェクトの承認を一時停止しました。この動きに続いてジョージア州も2027 年まで承認を停止しました。イリノイ州やミシガン州も制限措置を打ち出しています。
国際エネルギー機関のデータによると、2024 年には米国のデータセンターの消費電力が183 テラワット時に達し、全国消費電力の約 4% を占めています。2030 年までに、この数字は426TWh に倍増し、全体の消費量の 12% を超える可能性があります。Arm 社の CEO はさらに、2030 年までに AI データセンターがアメリカ全体の電力の 20% から 25% を消費すると予想しています。
米国の電力ネットワークは既に限界に達しています。米国東部の13の州をカバーする PJM 電力網は、6GW の容量不足に直面しています。2033 年までには、米国全体で175GW の電力不足に直面し、約1.3億世帯分の電力が不足する見込みです。データセンターの集中エリアの卸売電力コストは、5年前から267% 上昇しています。
計算能力の限界はエネルギーにあります。そしてエネルギーの面において、中米間の差はチップよりも大きく、ただし逆転しています。
中国の年間発電量は10.4兆kWh、米国は4.2兆kWh で、中国は米国の2.5倍です。さらに重要なのは、中国の住民向け電力消費が全消費量の15% に過ぎず、米国では36% になります。つまり、中国はアメリカよりもはるかに大きな工業用電力余裕があり、コンピューティング構築に投入できるということです。
電力価格に関して、米国のAI企業集中地帯の電力価格は1kWh あたり0.12〜0.15ドルですが、中国西部の工業用電力価格はおおよそ0.03ドルで、米国の4分の1から5分の1に過ぎません。
中国の発電増加量は、すでに米国の7倍に達しています。
アメリカが電気問題に直面している間、中国のAIは静かに海外に展開しています。しかし、今回の展開は製品や工場ではなく、トークンです。
トークンは、情報を処理するAIモデルの最小単位であり、新しいデジタルアセットの一種となっています。中国の計算能力工場で生成され、海底ケーブルを介して世界中に輸送されています。
DeepSeekのユーザー分布データはこの問題をよく示しています:中国が30.7%を占め、インドが13.6%、インドネシアが6.9%、アメリカが4.3%、フランスが3.2%です。 DeepSeekは37の言語をサポートし、ブラジルなどの新興市場で人気を博しています。世界中に2.6万社の企業がアカウントを開設し、3200社の機関が企業版を展開しています。
2025年には、新しいAIスタートアップの58%がDeepSeekをテクノロジースタックに組み込んでいます。中国では、DeepSeekが市場シェアの89%を占めています。他の制裁対象国では、市場シェアが40%〜60%の間で推移しています。
この光景は、40年前の産業の自主権に関する別の戦争を思わせます。
1986年の東京では、アメリカの強い圧力の下、日本政府が『米日半導体協定』に署名しました。その協定の中心的な条項は次の3つでした:日本に半導体市場を開放するよう求め、米国のチップが日本市場で20%以上のシェアを持つよう要求;日本の半導体がコスト以下で輸出されることを厳禁する;日本向けに3億ドル相当のチップを輸出した際には、100%の懲罰関税を課す。同時に、アメリカは富士通による仙童半導体の買収を拒否しました。
その年、日本の半導体産業は頂点に達していました。1988年には、日本が世界の半導体市場の51%のシェアを占め、アメリカは36.8%に過ぎませんでした。世界のトップ10半導体企業のうち、日本は6社を独占していました:NECは2位、東芝は3位、日立は5位、富士通は7位、三菱は8位、松下は9位でした。1985年、Intelは米日の半導体争いで1.73億ドルの損失を出し、破綻寸前でした。
しかし、協定締結後、すべてが変わりました。
アメリカは301調査などの手段を使い、日本の半導体企業に対して包括的な抑圧を開始しました。同時に、韓国のサムスンやハイニックスを支援し、より低価格で日本市場に挑みました。日本のDRAMシェアは80%から10%に急落しました。2017年までに、日本のIC市場シェアはわずか7%にまで減少しました。かつて不滅の巨人たちは、分割または買収されるか、絶え間ない赤字で舞台を去るかのいずれかに直面しました。
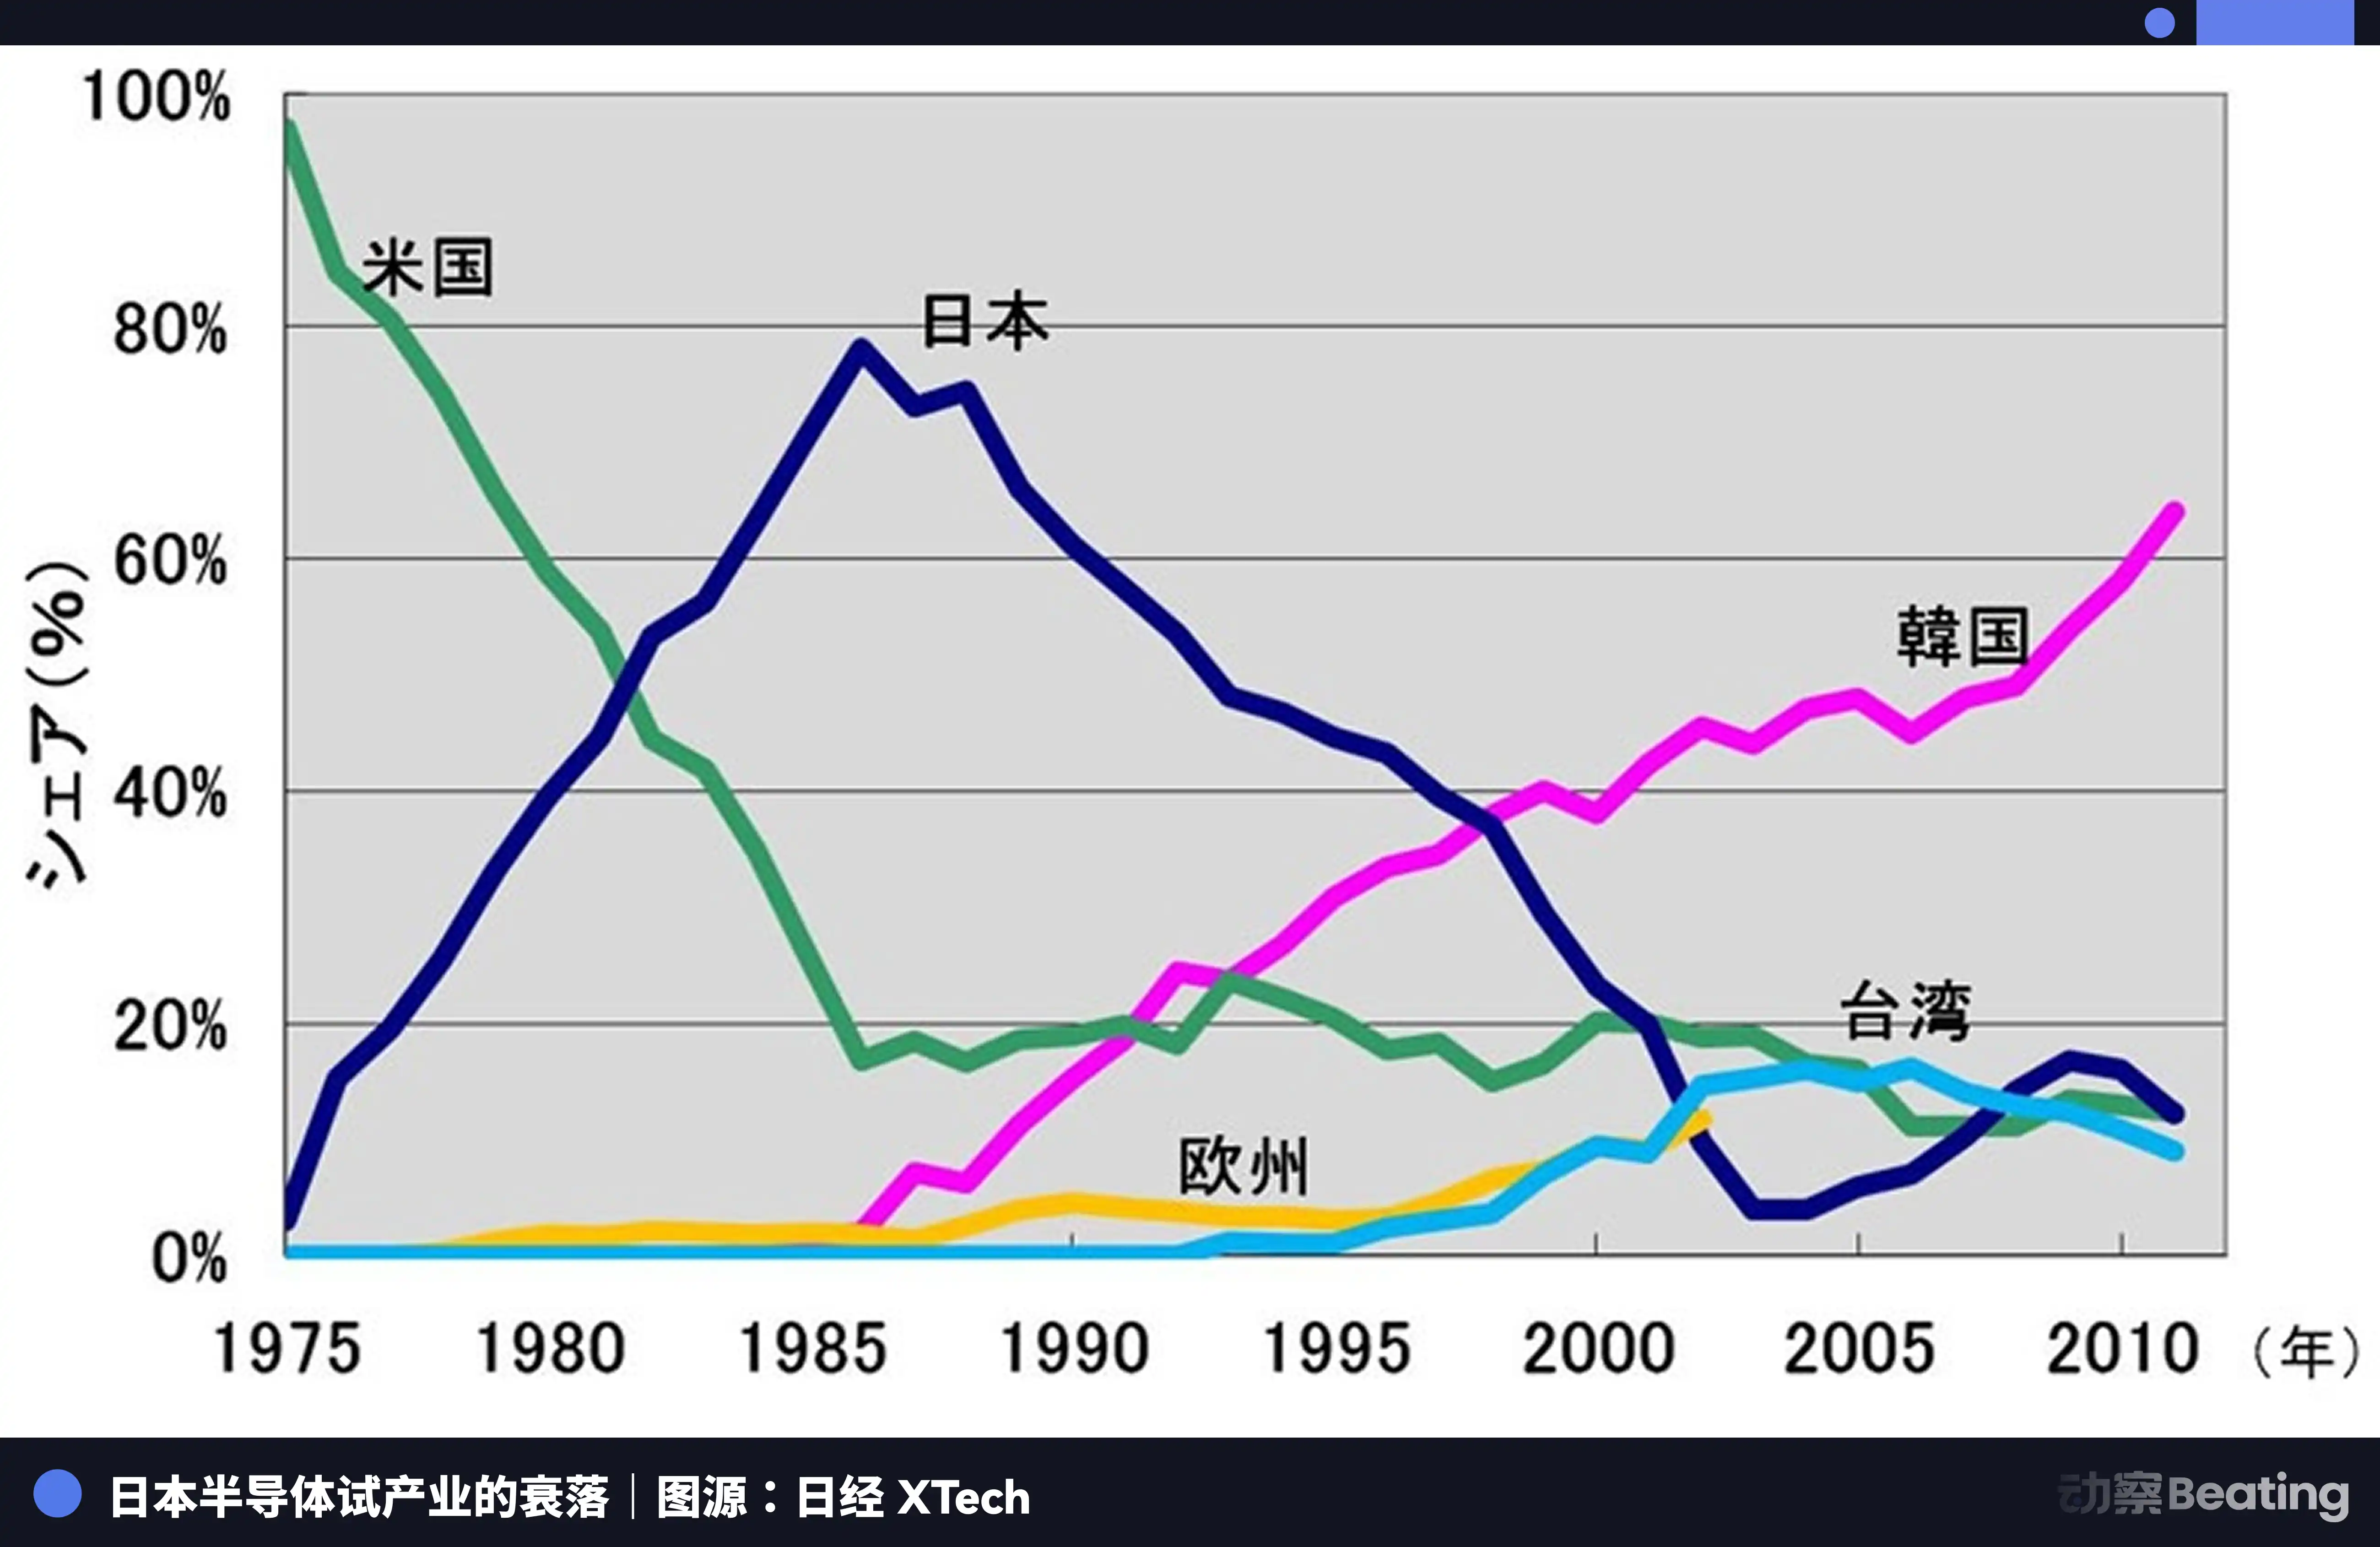
日本半導体の悲劇は、単一の外部力によって支配されるグローバルな分業体制の中で、最も優れた生産者であることに満足していたが、独自の生態系を構築することは決して考えられていませんでした。潮が引いて初めて、自らが生産そのもの以外には何も持っていないことに気づきました。
今日の中国のAI産業は、類似していますが完全に異なる岐路に立っています。
類似点は、我々も外部からの巨大な圧力に直面していることです。チップの三重規制は段階的に厳しくなり、CUDAエコシステムの壁はまだ高いままです。
異なる点は、今回選んだ道がより困難な道であることです。アルゴリズムレベルの究極の最適化から、国産チップの推論からトレーニングへの飛躍、そしてアセンションエコシステムにおける400万人の開発者の蓄積、さらにはTokenによるグローバル市場への浸透まで。この道のりのそれぞれの段階が、日本がかつて持っていなかった独立した産業エコシステムを構築しています。
結び
2026年2月27日、国内のAIチップ企業からの3つの業績報告書が同じ日に発表されました。
寒武紀は、売上高が453%増加し、初めて年間利益を上げました。モア線は売上が243%増加しましたが、純損失は10億です。ムシは売上が121%増加し、純損失はほぼ8億です。
半分は炎であり、半分は海水です。
炎は市場の極度の渇望です。ファン・スンフンが95%の空白を作った後、これらの国内企業の売上数字が市場の隅々まで埋め尽くされつつあります。性能やエコシステムにかかわらず、市場はNVIDIA以外の第2の選択肢を求めています。これは地政学的に開かれた、前代未聞の構造的機会です。
海水はエコシステム構築の巨額なコストです。各損失は、CUDAエコシステムに追いつくために支払われた真の金額です。それは研究開発への投資、ソフトウェアへの補助金、顧客現場への配置、1つずつコンパイルの問題を解決するエンジニアの人件費です。これらの損失は、経営の問題ではなく、独立したエコシステムを構築するために支払わなければならない戦争税です。
これらの3つの財務諸表は、いかなる業界レポートよりも、この計算パワー戦争の真の姿をより正直に記録しています。これは順調に勝利する戦いではなく、血を流しながら前線で戦う過酷な塹壕戦です。
ただし、戦争の形態は確かに変わっています。8年前、私たちは「生き残れるかどうか」について議論していました。今日、私たちは「生き残るためにどれだけの代償を支払う必要があるか」について議論しています。
その代償そのものが進歩です。
BlockBeats の公式コミュニティに参加しよう:
Telegram 公式チャンネル:https://t.me/theblockbeats
Telegram 交流グループ:https://t.me/BlockBeats_App
Twitter 公式アカウント:https://twitter.com/BlockBeatsAsia