AIコンピューティングの金融化:オープンソースモデルが計算能力を資本市場へ押し上げている(前編)
本稿は OKX Ventures が制作した詳細な調査レポートです。篇幅が長いため、上下2編に分けて公開します:上編は算力資産化、リスクエクスポージャーとデリバティブ価格設定ロジックに焦点を当て、下編では算力金融インフラ、推論資産化の機会、業界トレンドを重点的に分析します。本稿は上編です。
序論:算力の資産化とリスクエクスポージャー
AIインフラは資本集約型の拡大段階に入りつつあり、算力の経済的性質もそれに伴って変化しています。かつて企業は算力をオンデマンドで調達するITコストと見なすことが多かったですが、現在ではGPU、データセンター容量、複数年にわたる調達契約がますますバランスシートに計上されるようになり、算力は資本資産の特徴を備え始めています:先行投資が大きく、資金回収に数年を要し、将来の収益と設備価値は需給や技術の進化に継続的に影響されます。
GPU調達とデータセンター建設も債務資金への依存度を高めています。今日のGPUクレジットは設備担保と長期顧客契約によって融資を完了できるようになりましたが、市場には依然として公開・標準化されたGPU時間の先渡価格とヘッジツールが不足しています。債務は定められたペースで返済する必要があり、数年後にこのGPU群がどれだけのレンタル収入を生み、どれだけの価値を持つかは、その時点の市場次第です。レバレッジが高ければ高いほど、この価格不確実性が債務返済と借り換えに与える影響は大きくなります。
一、背景:算力市場の資本構造
1.1 算力拡大がレバレッジ段階に入り始める
過去数年間、AIインフラにおける最も注目すべき変化の一つは、資本支出が企業内部のキャッシュフロー拡大を上回るペースで増加し始めたことです。2020年から2023年にかけて、トップ5クラウドベンダーのAI関連CapExは営業キャッシュフローに占める割合がおおむね20%〜30%でしたが、2025年には約94%に近づいています。2026年に入ると、トップ5クラウドベンダーの確定済みCapEx規模は合計で7000億米ドルを超えています。
これらの企業は依然として強力な現金創出力を持っていますが、インフラ建設が長期間にわたり数千億ドル規模で拡大する場合、債務資本が自然とより大きな役割を担うことになります。算力資産は独自の資金調達ロジックを形成し始めています。
GPU、サーバー、データセンターは収益が発生する前に資金投入が必要であり、Neocloudなどの算力オペレーターは通常、Hyperscalerのような成熟した主体信用を持っていません。そのため貸し手は融資判断を徐々にプロジェクト自体に置くようになっています:将来のキャッシュフローが十分に安定しているか、債務元本と利息をカバーできるか、デフォルト後に回収できる資産価値はどれだけか。
Take or Pay 長期契約は、この仕組みが成立するための鍵となる。顧客は予約した容量を完全に利用しなくても、契約に従って所定の費用を支払う必要がある。オペレーターにとっては、将来の収入の一部を事前に固定化することに相当し、貸し手にとっては、不確実性の高いGPU稼働率を、より予測しやすい契約キャッシュフローに変換するものである。
CoreWeaveはこのモデルの最も典型的な事例である(その収入の98%以上がTake or Pay条項付き契約に由来する)。投資適格格付けの顧客との複数年にわたる長期契約の割合が高まるにつれ、その資金調達はますます購入者の信用力と契約カバレッジに依存するようになっている。Nebius、IRENなど、大規模顧客との長期契約を有するオペレーターもその後、同様の構造を採用し始めた。
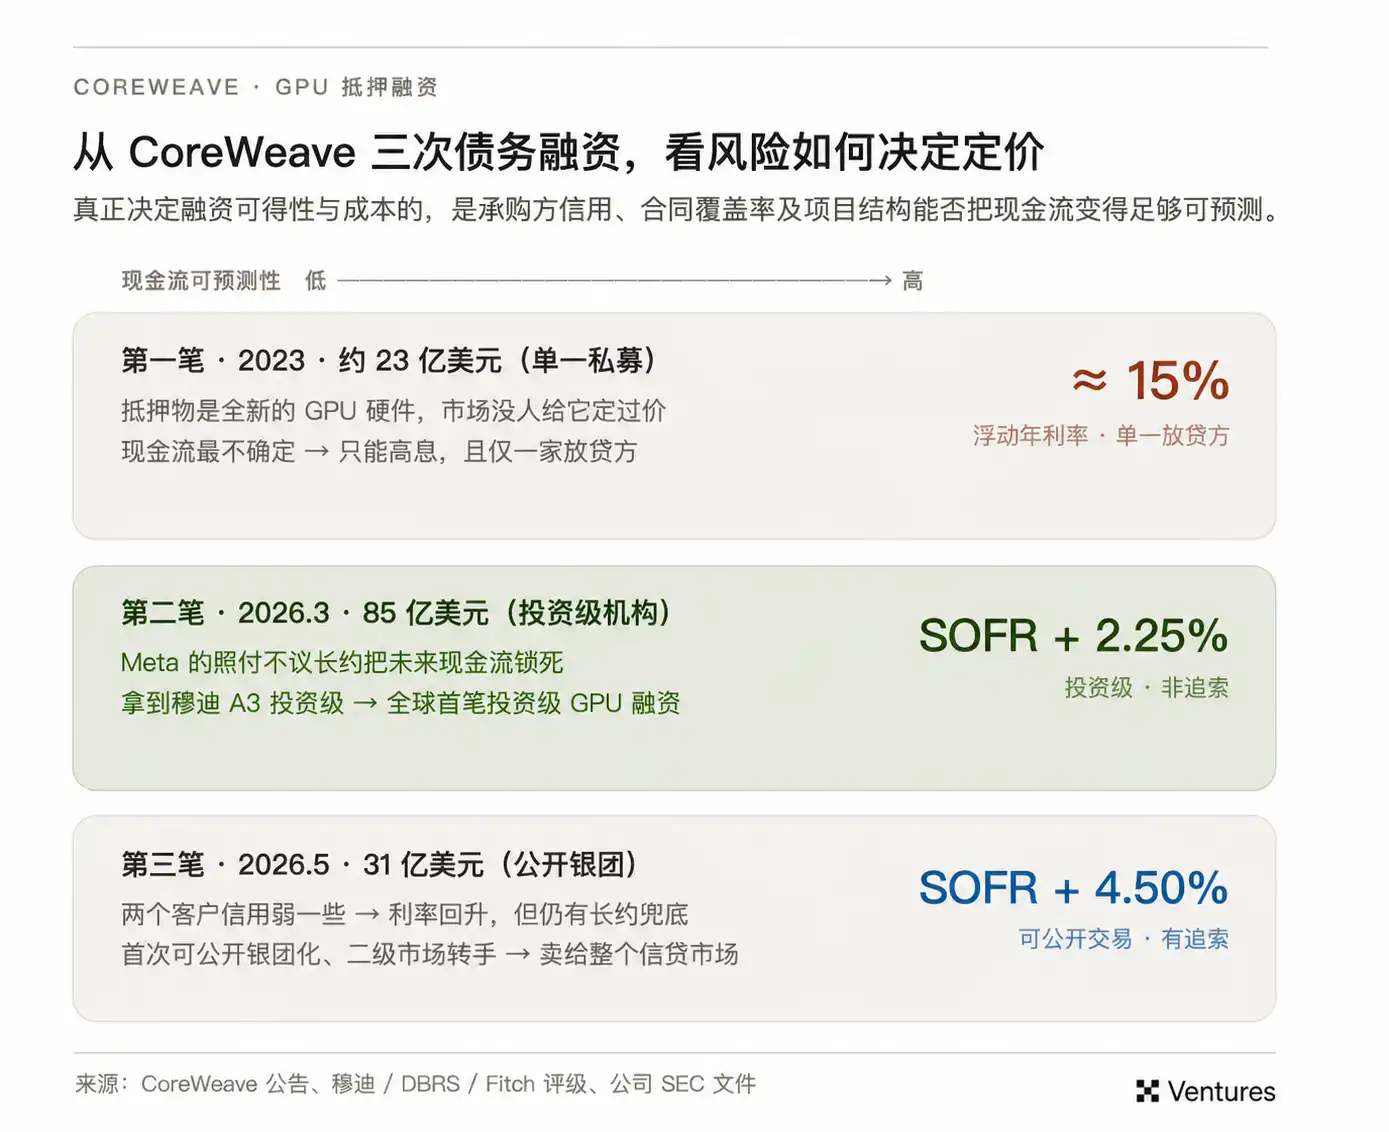
これにより、GPU融資のリスク序列が変化した。貸し手はまず、契約キャッシュフローが債務をカバーできるかどうかを判断し、最後にデフォルト時にGPUがどれだけ回収できるかを評価する。GPUの数量が担保の規模を決定し、長期契約がさらに、これらの資産がどのような融資条件を得られるかを左右する。
1.2 キャッシュフローが固定化された後、残るのは資産価格リスクである。
Take or Payは債務返済キャッシュフローの可視性を高めるが、GPU自体の経済的価値は変動し続ける。数年後、これらの設備がどれだけの収入を生み出し、どれだけの価値を持つかは、依然としてバランスシート上に残るリスクである。
GPUは生産設備と技術製品の二つの性質を併せ持つ。継続的にレンタル収入を生み出す一方で、極めて速い技術革新サイクルの中にある。新世代チップが登場した後、前世代の設備への影響は徐々にレンタル料金、稼働率、契約更新価格、中古市場価値に反映される。
そのため、GPUの会計上の減価償却と経済的な減価償却は完全に一致することは難しい。会計上は固定年数で設備コストを償却できるが、市場は毎日、1枚のGPUがどれだけ競争力のある計算能力を生み出せるかを再評価している。貸し手にとって、中核となる変数は最終的に、残存融資期間内のキャッシュフローと、デフォルト時に回収できる価値に集約される。(大手クラウドベンダーのデータセンター資産の減価償却方針をめぐっては、市場で既に疑問が生じている)
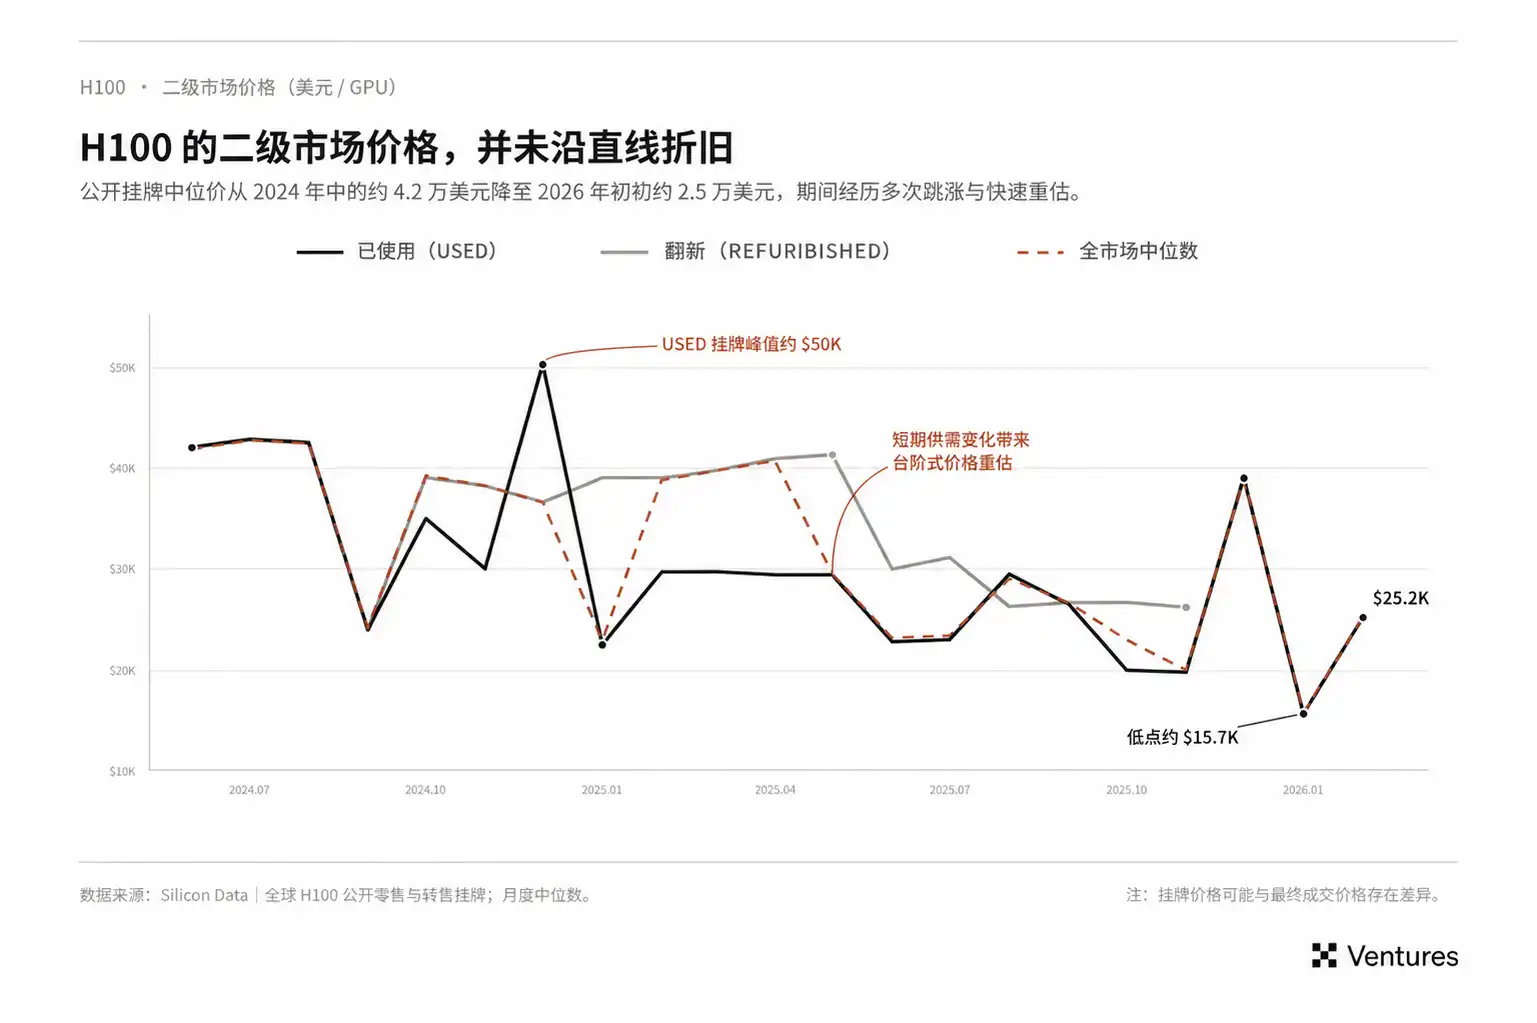
これは、現在のGPUクレジットがレンタル価格下落時にも一時的に安定を保てる理由も説明している。オフテイク顧客が契約を履行し続ける限り、スポット価格の変動が必ずしも当期の債務返済に即座に影響するわけではない。リスクはむしろ、契約更新、借り換え、デフォルト処理といった局面に集中する。これらの時点に至ると、GPUの市場レンタル価格と残存価値がローンの安全余白を再決定する。
レンタル価格と設備価値の下落がローン元本の償却よりも速ければ、LTVは再び上昇し、ローンの安全余白は縮小する。長期契約はリスクを先送りできるが、設備のライフサイクル全体にわたる経済的価値を固定化することはできない。
現在の算力クレジット構造のギャップは、そのため明確である。契約は一部の顧客支払いを固定するが、GPUの市場価格は依然として変動する。
市場は現在、主に複数年のキャパシティ契約による事前価格固定に依存している。初期のH100一年契約はスポット価格に対して明確なディスカウントがあったが、スポット価格の下落と先渡契約価格の上昇に伴い、両者の価格差は大幅に縮小した。供給改善と契約条件の変化がこの結果に影響を与えるが、同時に、より根本的な問題を反映している。標準化された先渡、先物、スワップ商品が不足する中、産業参加者は長期の実物契約に調達と価格管理の二つの機能を同時に担わせるしかない。
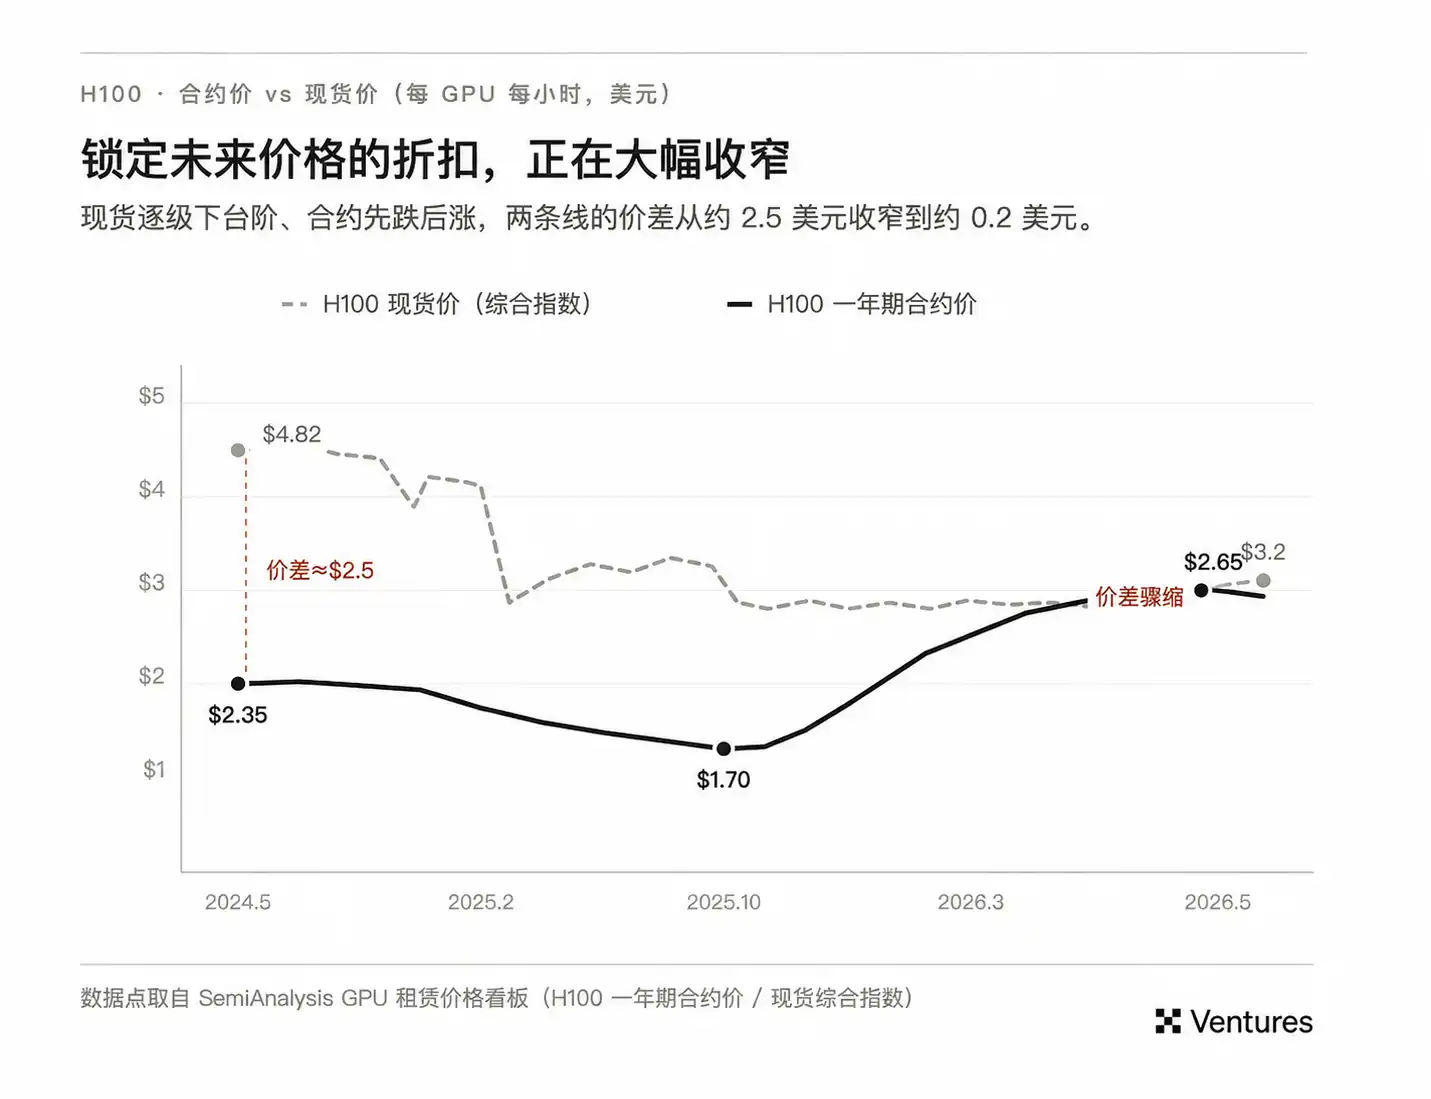
長期契約は個別の取引当事者間でのリスク配分を完了できる。市場が継続的に公開価格を形成し、機関間でリスクを移転する必要がある場合、さらなる標準化された金融商品が必要となる。ますます多くのGPU資産が債務資本によって支えられるにつれ、この需要はますます顕著になるだろう。
二、算力市場が本当に取引すべきものは何か?
算力が資本構造に入ると、価格変動には明確な負担者が生まれる。Neocloudはレンタル価格下落リスクを保有し、AI企業は調達コスト上昇リスクを保有し、債権者は残存価値と借り換えリスクを保有する。デリバティブ市場は、こうしたバランスシートが自ら吸収できないリスクから実際に形成され始めることが多い。
2.1 三つの参加者タイプとリスクエクスポージャー
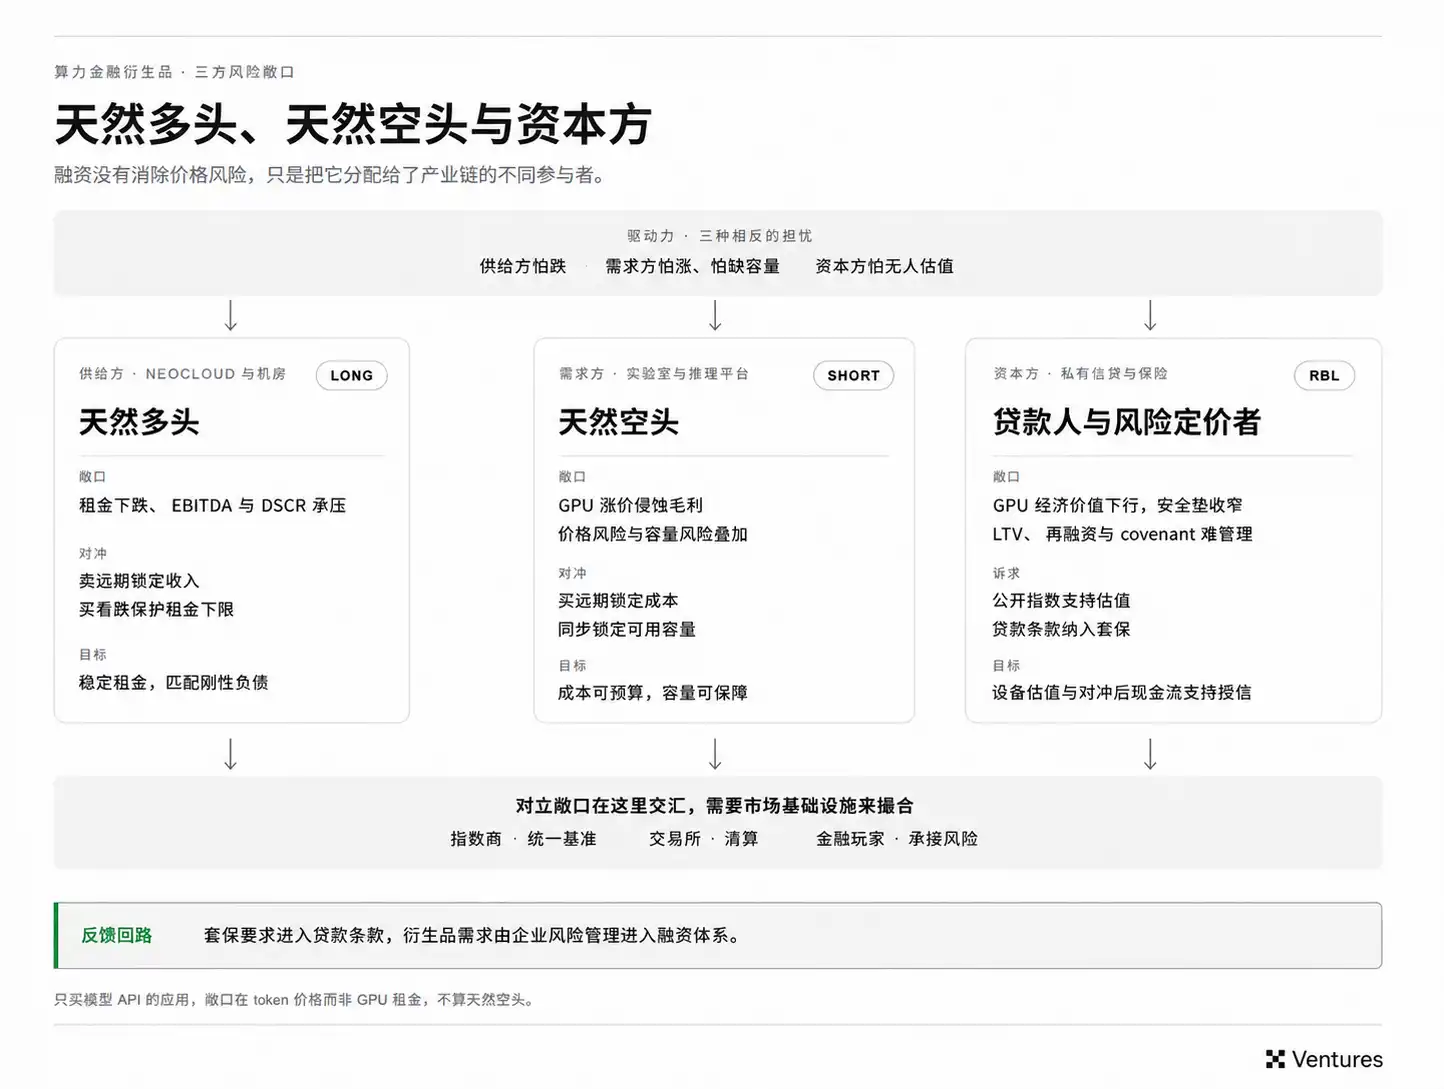
算力価格変動は最終的に三つのバランスシートに影響を及ぼす。Neocloudは前期にGPU、データセンター、資金調達コストを固定するが、将来のレンタル価格は依然として再設定される。長期契約のカバレッジが不十分な場合、レンタル価格の下落はEBITDAとDSCRを急速に圧縮するため、先渡売却による収入の事前固定に最も強い動機を持つ。AIラボと推論プラットフォームは反対側に位置し、GPU価格の上昇は直接粗利益を侵食し、市場逼迫時には価格とキャパシティのリスクが同時に発生することが多いため、コストと利用可能なキャパシティの両方を同時に固定する必要がある。貸し手は、ローン残高とGPUの経済的価値の間に残る安全余白をより重視し、公開指数と先渡カーブが不足する中、LTV、借り換え、コベナンツの動的管理は困難である。ヘッジ要件が徐々にローン条件に組み込まれるにつれ、算力デリバティブの需要は企業の自主的なリスク管理から、さらに資金調達システムへと浸透していく。
2.2 潜在市場規模:どのリスクエクスポージャーがデリバティブ市場に入るのか
世界のGPU出荷台数、データセンターのCapEx、AIインフラ規模から直接コンピューティングデリバティブのTAMを推定すると、結果が一桁大きくなりがちだ。
実際にデリバティブ市場に入ることができるのは、依然として市場価格に晒され、かつ他の方法で吸収されていないリスクの部分だけである。
ハイパースケーラーが自社構築し内部で使用するGPUは、リスクの大部分が自社のバランスシートに留まる。すでに複数年の固定価格契約を結んでいるキャパシティも、価格リスクは事前にバイラテラル契約の中で配分済みだ。これらには経済的リスクがあるが、必ずしも毎日市場で取引する必要はない。
したがって、世界のコンピューティング需要から実際のデリバティブTAMに至るまでには、少なくとも数層のフィルターを通過する必要がある:
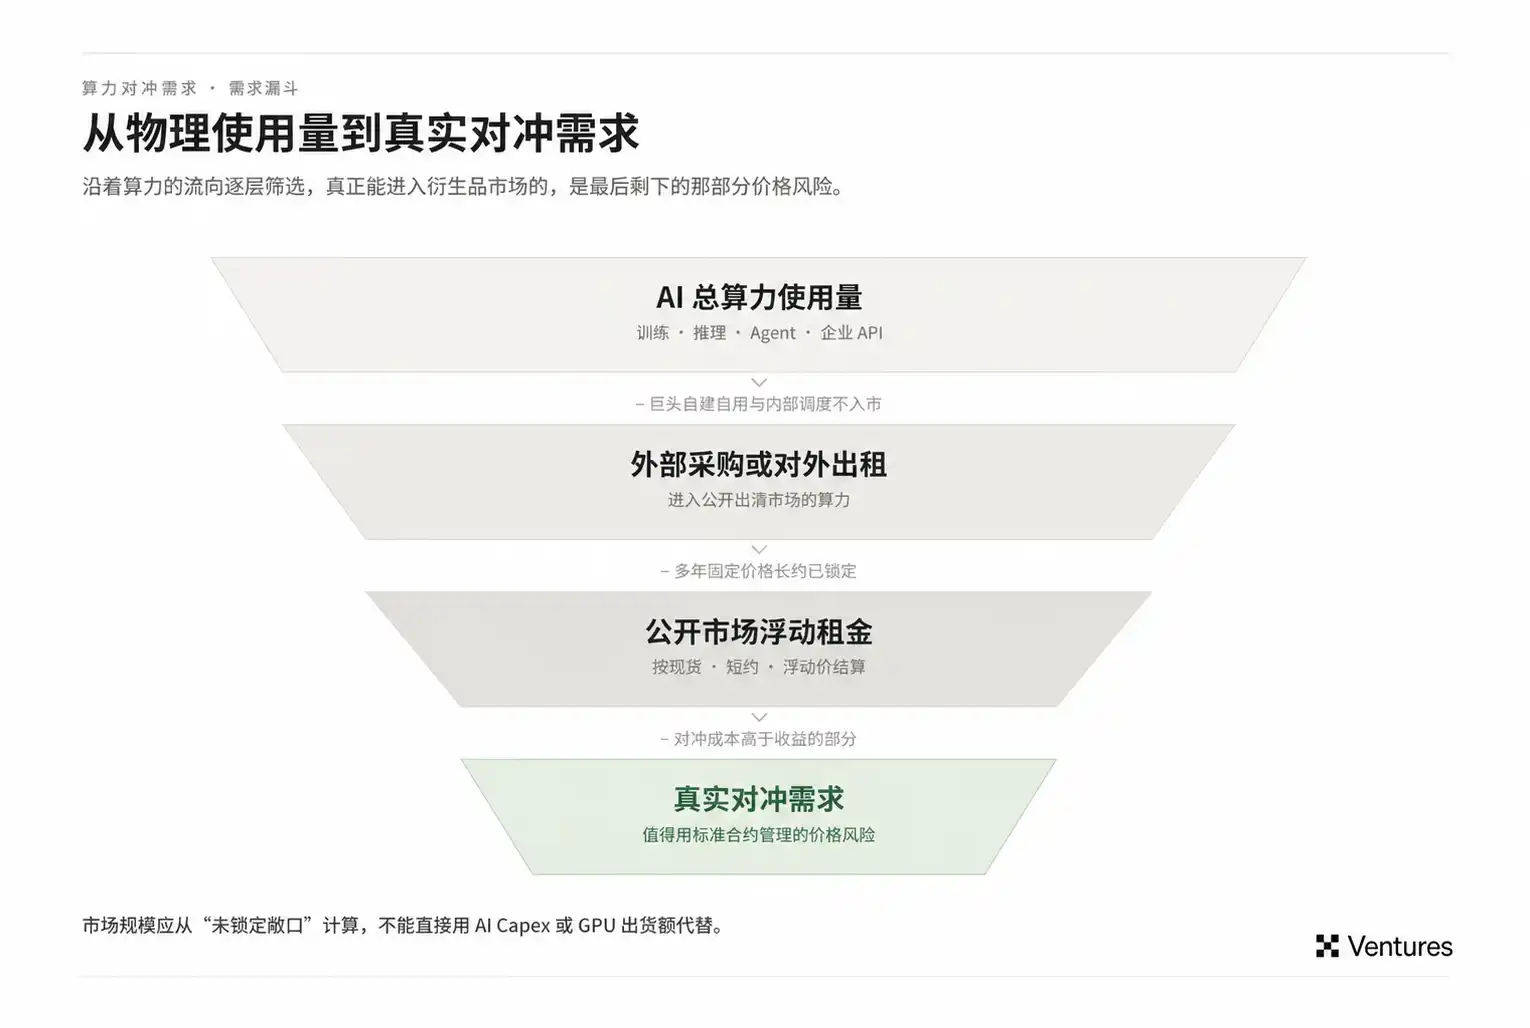
これが、将来のコンピューティングデリバティブ市場の規模が、世界のGPU設置台数の単純な線形成長よりも、マーチャントコンピュートの比率と大きく関係する可能性が高い理由でもある。
これまで多くの先進モデルは少数の大規模ラボやハイパースケーラー内部で稼働し、コンピューティング調達も高度に内部化されていた。オープンソースモデルの性能向上に伴い、ますます多くの企業が自社でデプロイするか、ワークロードを第三者Neocloudや推論プラットフォームに委託できるようになった。かつて少数の大規模バランスシートに閉じ込められていたコンピューティング需要は、徐々に公開市場での調達注文へと転換していく。これがオープンソースモデルの発展が注目に値する理由でもある:
第一に、より多くのコンピューティングが実際の取引価格を形成し始める。 十分な外部取引がなければ、インデックスは形成されにくく、フォワードカーブはなおさら語れない。
第二に、需要ショックがより迅速にスポット市場へ伝播する。 人気モデルがリリースされた後、多くの企業が同時にデプロイを増やせば、新規需要は直接第三者GPUキャパシティに影響し、価格と可用率は急速に変化する。公開市場が担う限界需要が多ければ多いほど、レンタル価格の変動は企業が実際に管理すべきP&Lリスクとなる可能性が高まる。
したがって、オープンソースモデルがコンピューティングの金融化にとって本当に重要な点は、市場化された調達比率を高める可能性にある。コンピューティングは十分な外部取引を経て初めて、インデックス化・フォワード化・金融化に値する価格を徐々に形成する。最終的にコンピューティングデリバティブ市場の規模を決定する変数には、1) どれだけのコンピューティングが公開市場に入るか、2) どれだけの価格が変動を維持するか、そして3) そのうちどれだけのリスクが元のバランスシートに留まり続けられないか、が含まれる。
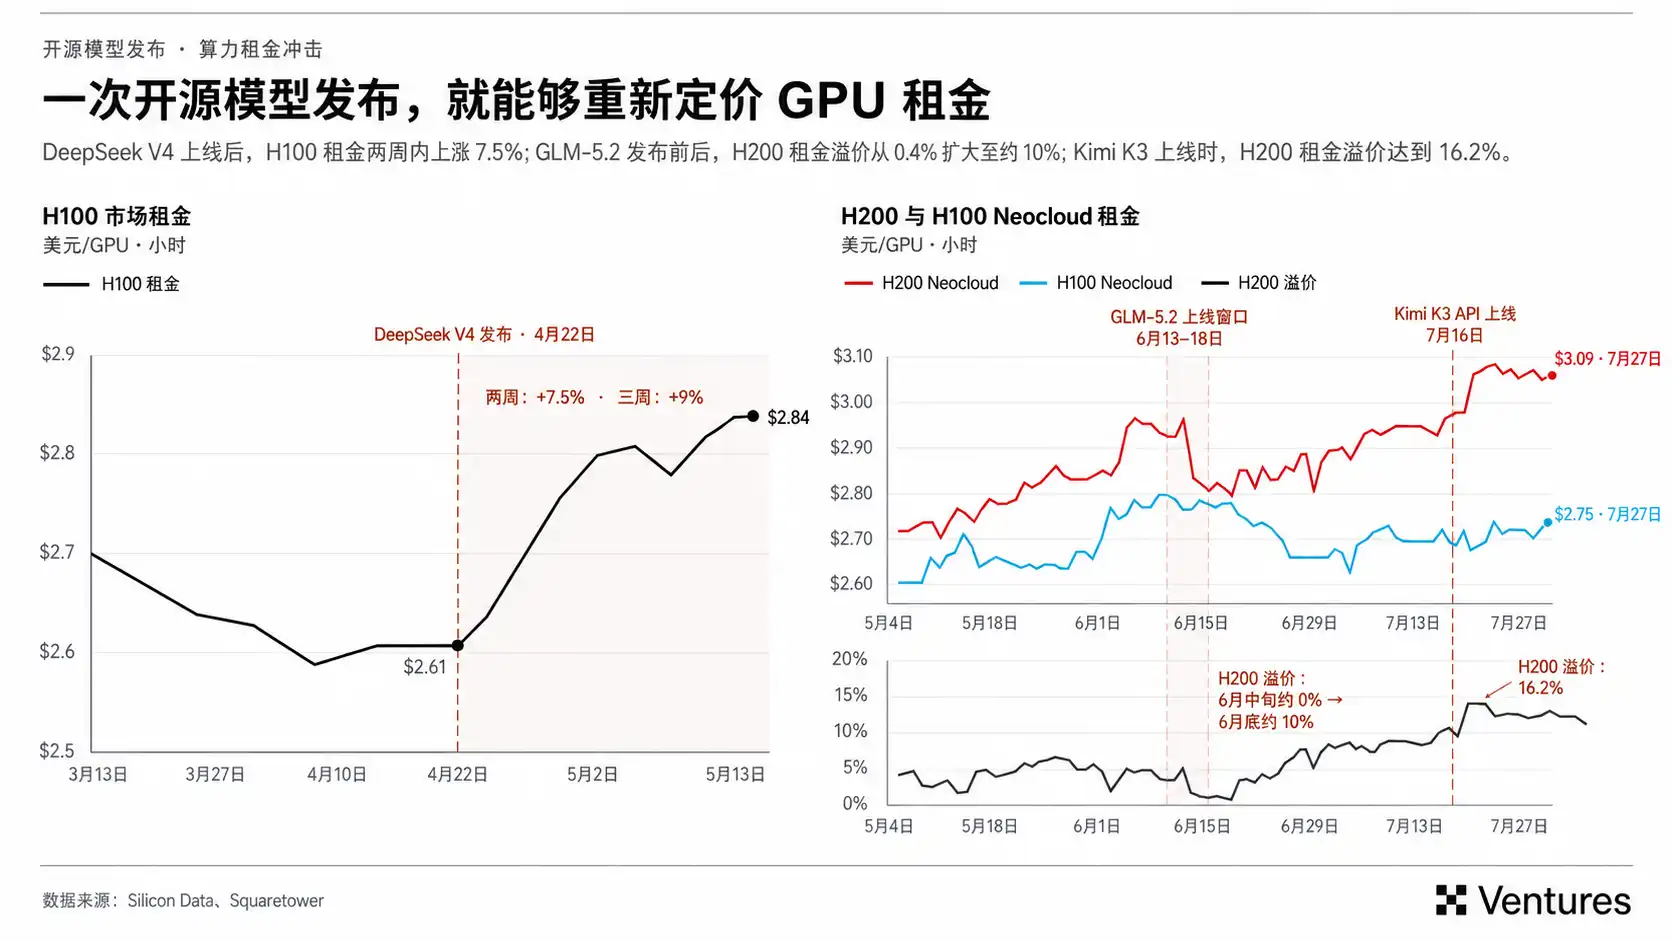
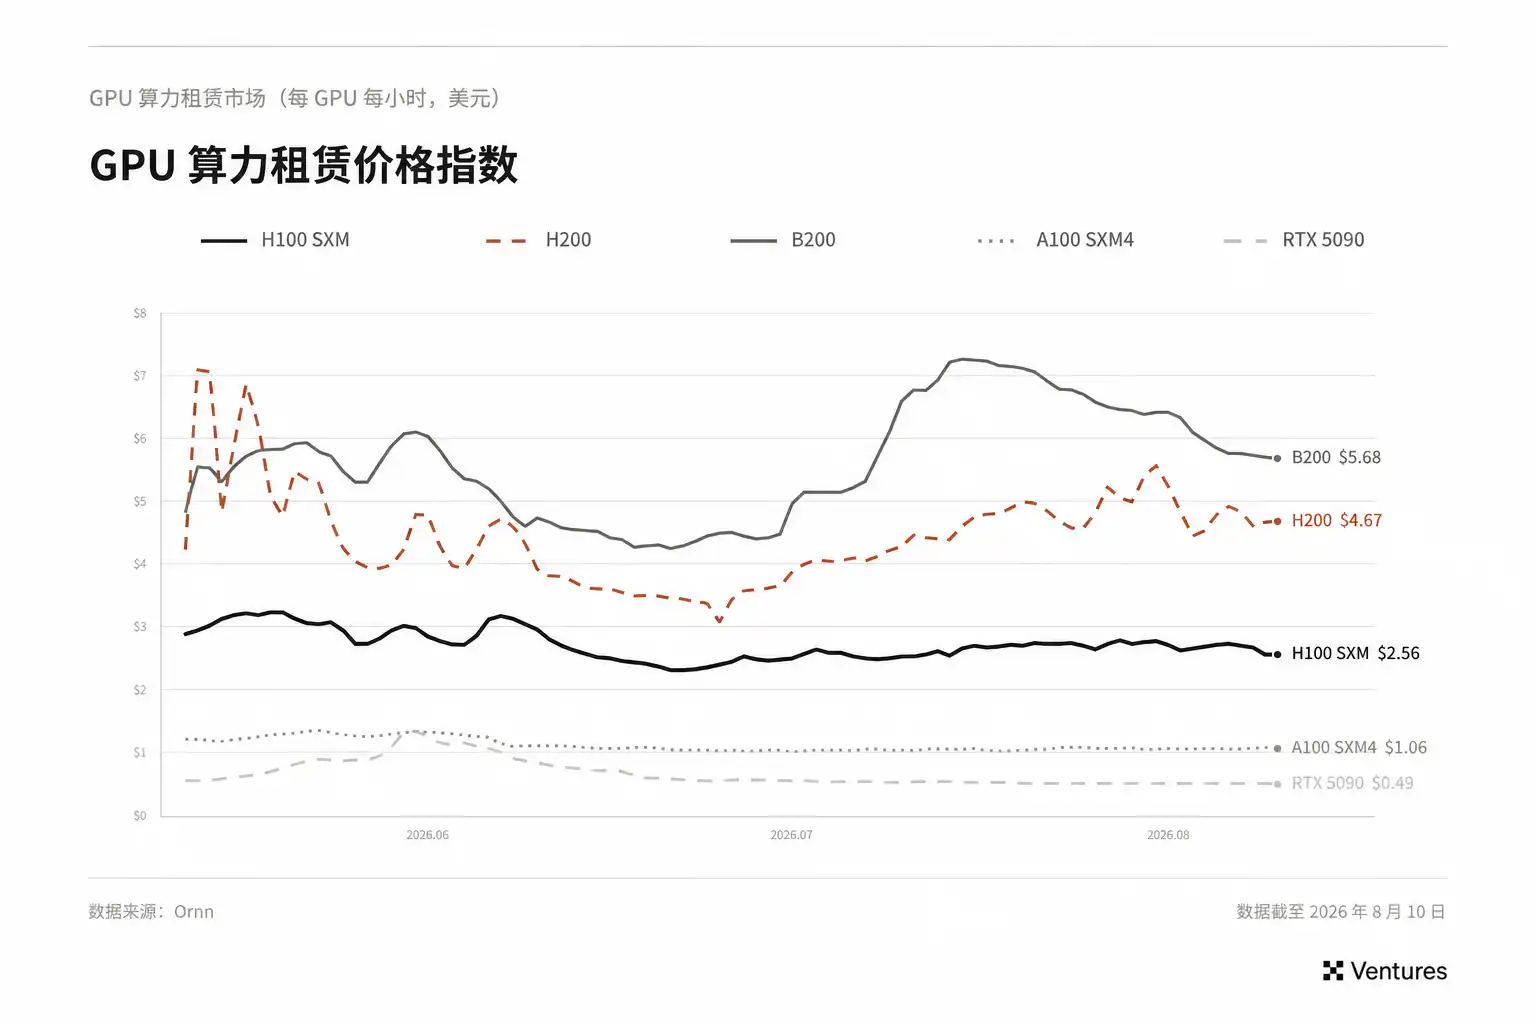
DeepSeek V4のリリース後、H100のレンタル料金は2週間で約7.5%上昇しました。Kimi K3とGLM 5.2の登場前後でも、H100、H200のレンタル料金に同様の強気傾向が見られました。人気のあるオープンソースモデルは短期間で大量のデプロイメントと推論需要をもたらします。これらの新規負荷が主にNeocloudやサードパーティの推論プラットフォームによって処理される場合、市場ではまず可用性の低下、待ち行列、割り当ての厳格化が発生し、その後オンデマンドのレンタル料金に反映されます。
三、製品と価格設定:将来の算力にどう価格を付けるか?
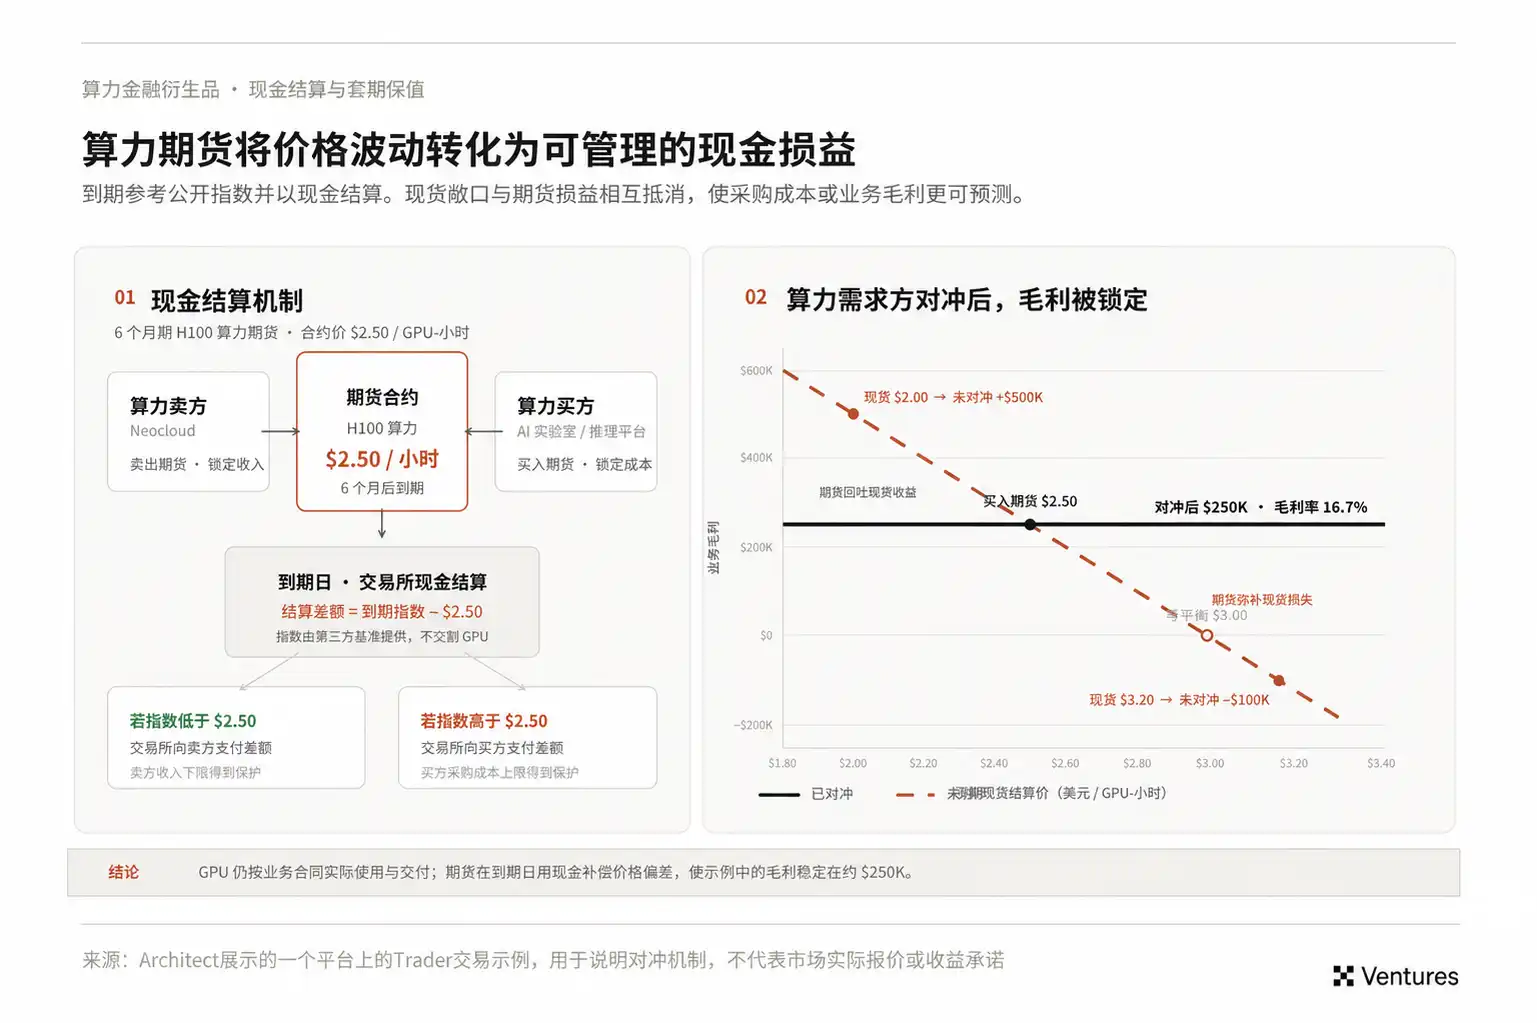
算力先物の難しさは、市場がまだ十分に信頼できる期間別価格曲線を形成していない点にあります。
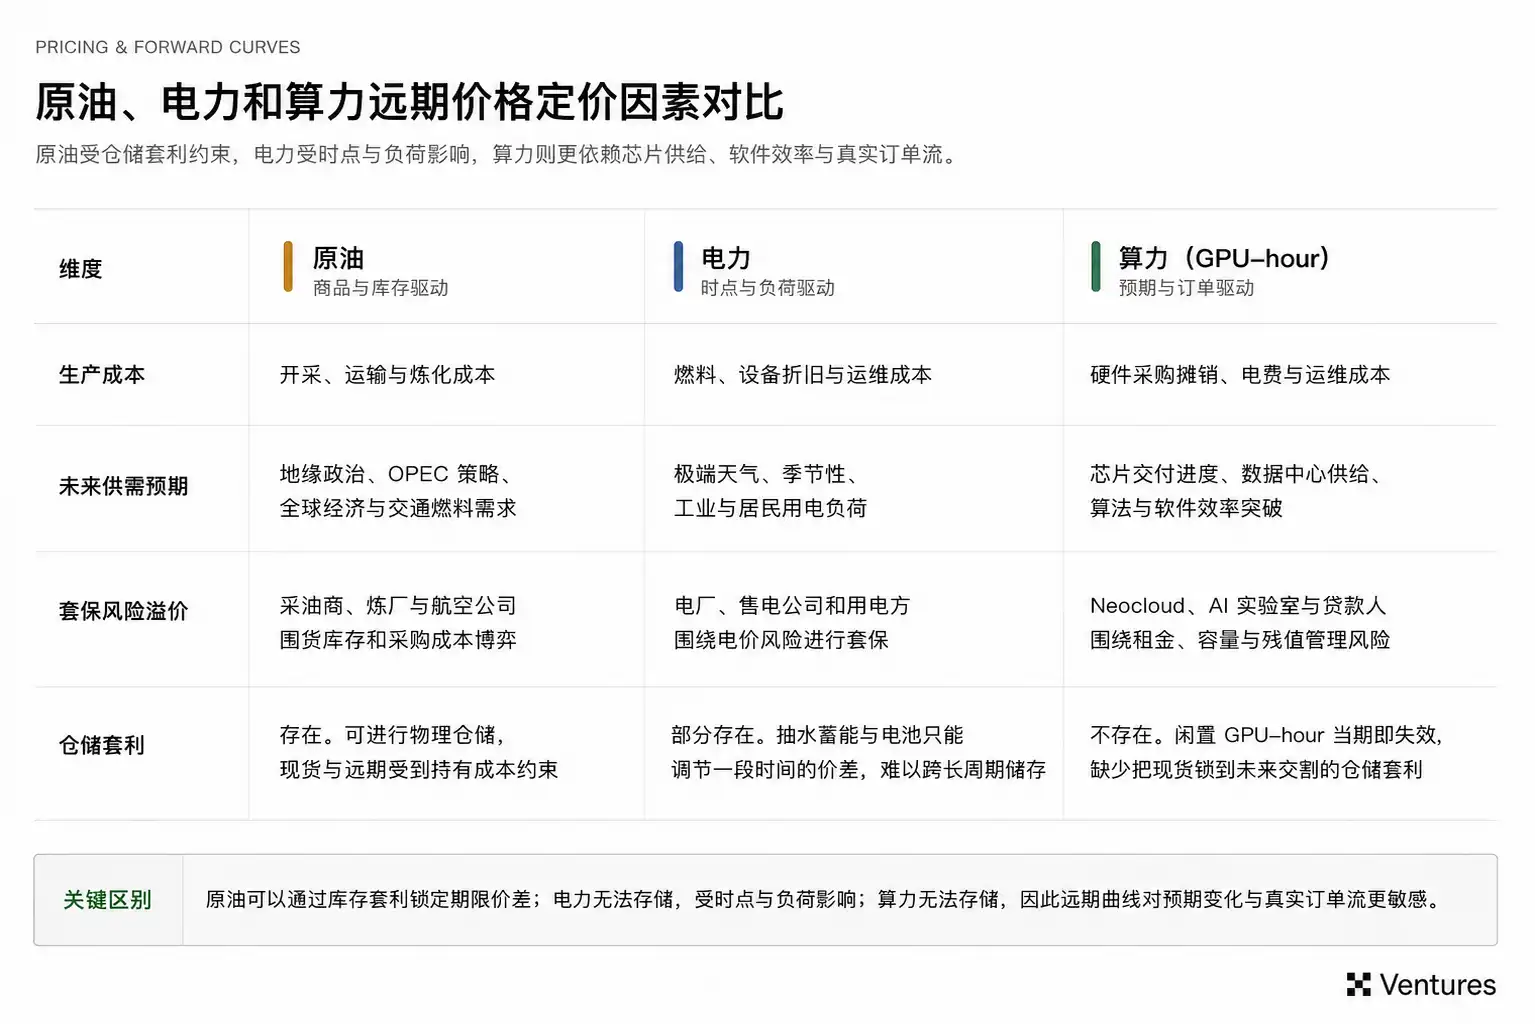
GPU時間は貯蔵できません。今日遊休している1時間のH100は、この時間枠を過ぎると永久に消滅し、スポット価格が安い時に事前に購入して半年後に受け渡すこともできません。伝統的な商品は在庫裁定取引によって構築されたスポット-先物の制約を持っていますが、算力市場ではこの制約は自然と弱くなります。
これは、6ヶ月後のGPUがどのような価格で取引されるべきかが、その時点のチップ納品、データセンターと電力供給、モデル効率、そして実際の注文強度に依存することを意味します。ハードウェアの遅延は将来の容量を急速に逼迫させ、ソフトウェアの最適化はGPU数を増やさずに大量の有効な算力を解放する可能性があります。算力先物曲線は、ハードウェア供給、エネルギー制約、アルゴリズム進歩に対する市場の判断を同時に含んでいます。
3.1 在庫裁定取引がないため、先物価格は期待と注文フローに依存する
原油市場の期間構造には、比較的安定した倉庫保管裁定取引の制約があります。先物価格がスポット価格に資金調達コストと保管コストを加えたものを明確に上回る場合、トレーダーは直接スポットを購入し、在庫を保有して先物を売却できるため、価格差は長期間保有コストから乖離しにくくなります。
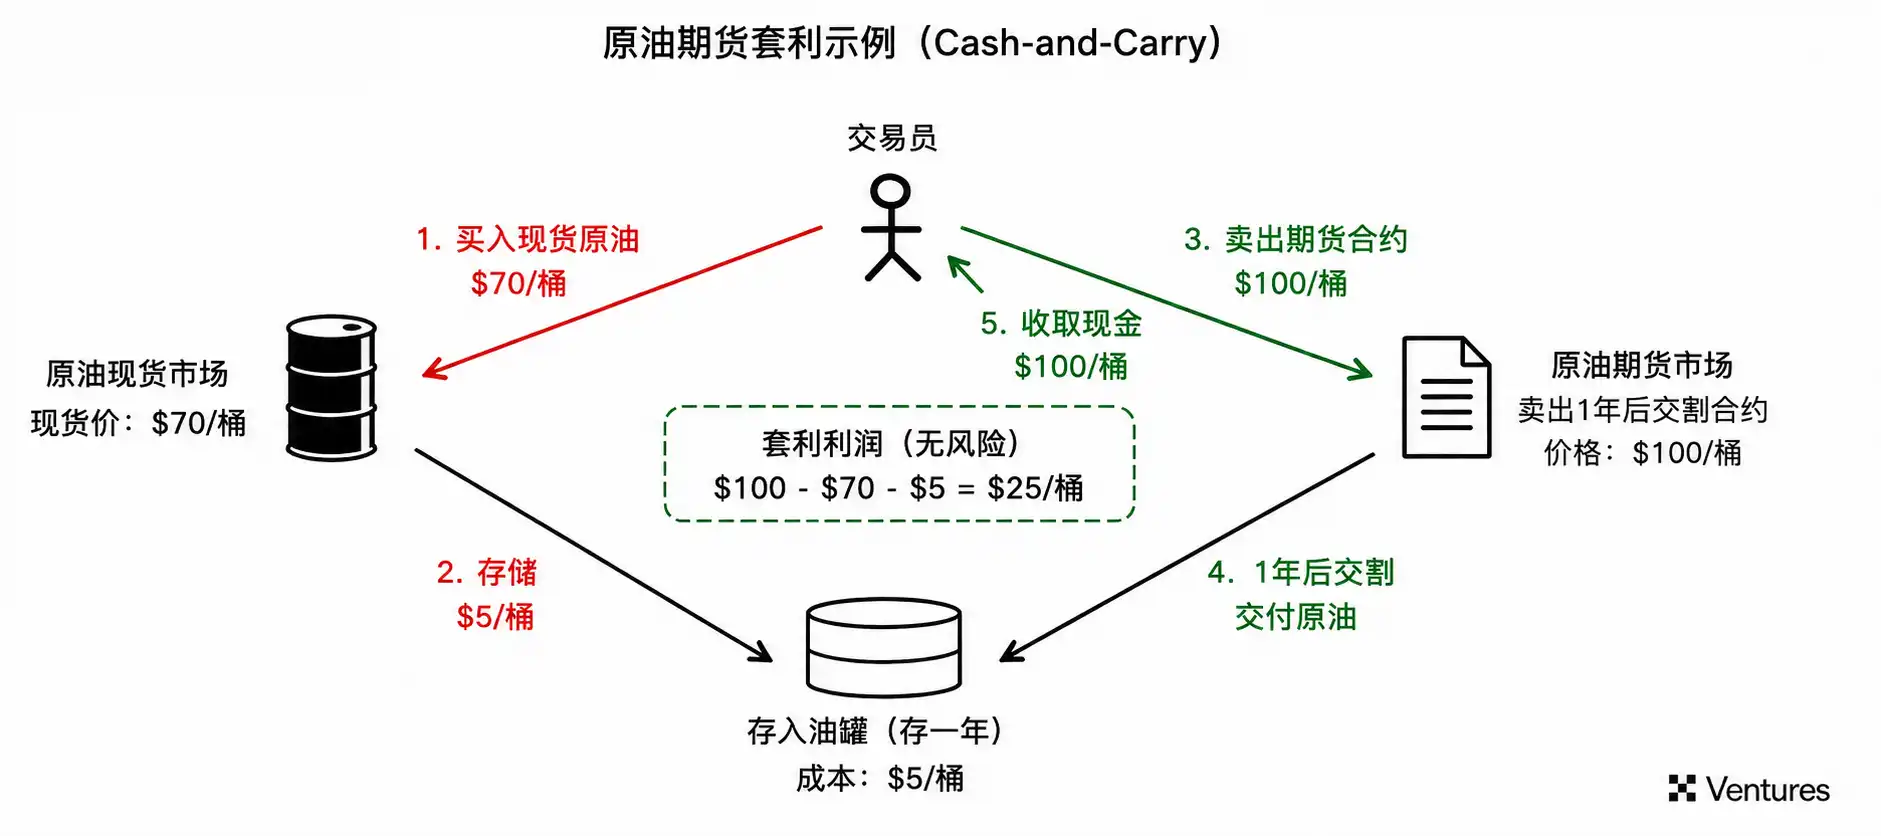
算力にはキャリーアンドキャリーの裁定取引という制約が欠けており、スポット価格が先物曲線に与える制約はより弱くなります。
そのため、将来価格は限界的な情報に非常に敏感になります。Blackwellの納品遅延やデータセンターの送電遅延は予想供給を減少させ、モデルの蒸留、推論最適化、または新世代チップによる単位計算効率の向上は、ネットワーク全体の有効な算力を増加させます。多くの変化が数ヶ月以内に先物の需給を書き換える可能性があります。
これにより、実際の注文フローの価値も高まります。公開スポット価格は今日何が起こっているかを市場に伝えるだけですが、長期容量注文は将来の需給をより早く明らかにします。NeocloudとAI Labを継続的にマッチングするブローカーやディーラーは、どのデータセンターに空き容量が発生し始めているか、どのバイヤーが半年後のGPUにプレミアムを支払う意思があるかを把握できます。このような情報は最終的に先物価格に直接反映されます。
したがって、算力指数の価値は、高度に分散した非標準的な相場を、契約、信用、デリバティブが共通して参照できる価格基準に圧縮することにあります。ある指数が長期容量契約、融資評価、OTC決済、先物受渡しに継続的に組み込まれれば、それは徐々に市場全体が共有する価格アンカーとなります。今後、指数プロバイダーとディーラーが参入障壁を築けるかどうかは、実際の成約や将来の注文にどれだけ近いかに大きく依存します。
3.2 GPUアワーとAIトークンの金融化のペースは同期しない
AI産業チェーンには実際に2層の価格が存在します。上流はGPUキャパシティを販売し、中流の推論プラットフォームはGPUアワーをモデル呼び出しに変換し、さらに下流にAIトークン、API、または特定のワークロードを販売します。
推論プラットフォームにとって、営業利益は両端に依存します。GPUレンタル価格の上昇はインプットコストを押し上げ、AIトークン販売価格の下落は収入を圧迫します。両端で取引可能な価格が形成されれば、推論プラットフォームは理論上、コンピュートからインテリジェンスへのスプレッドを固定化できます。これはエネルギー市場で製油業者がクラックスプレッドを管理するロジックに近いものです。
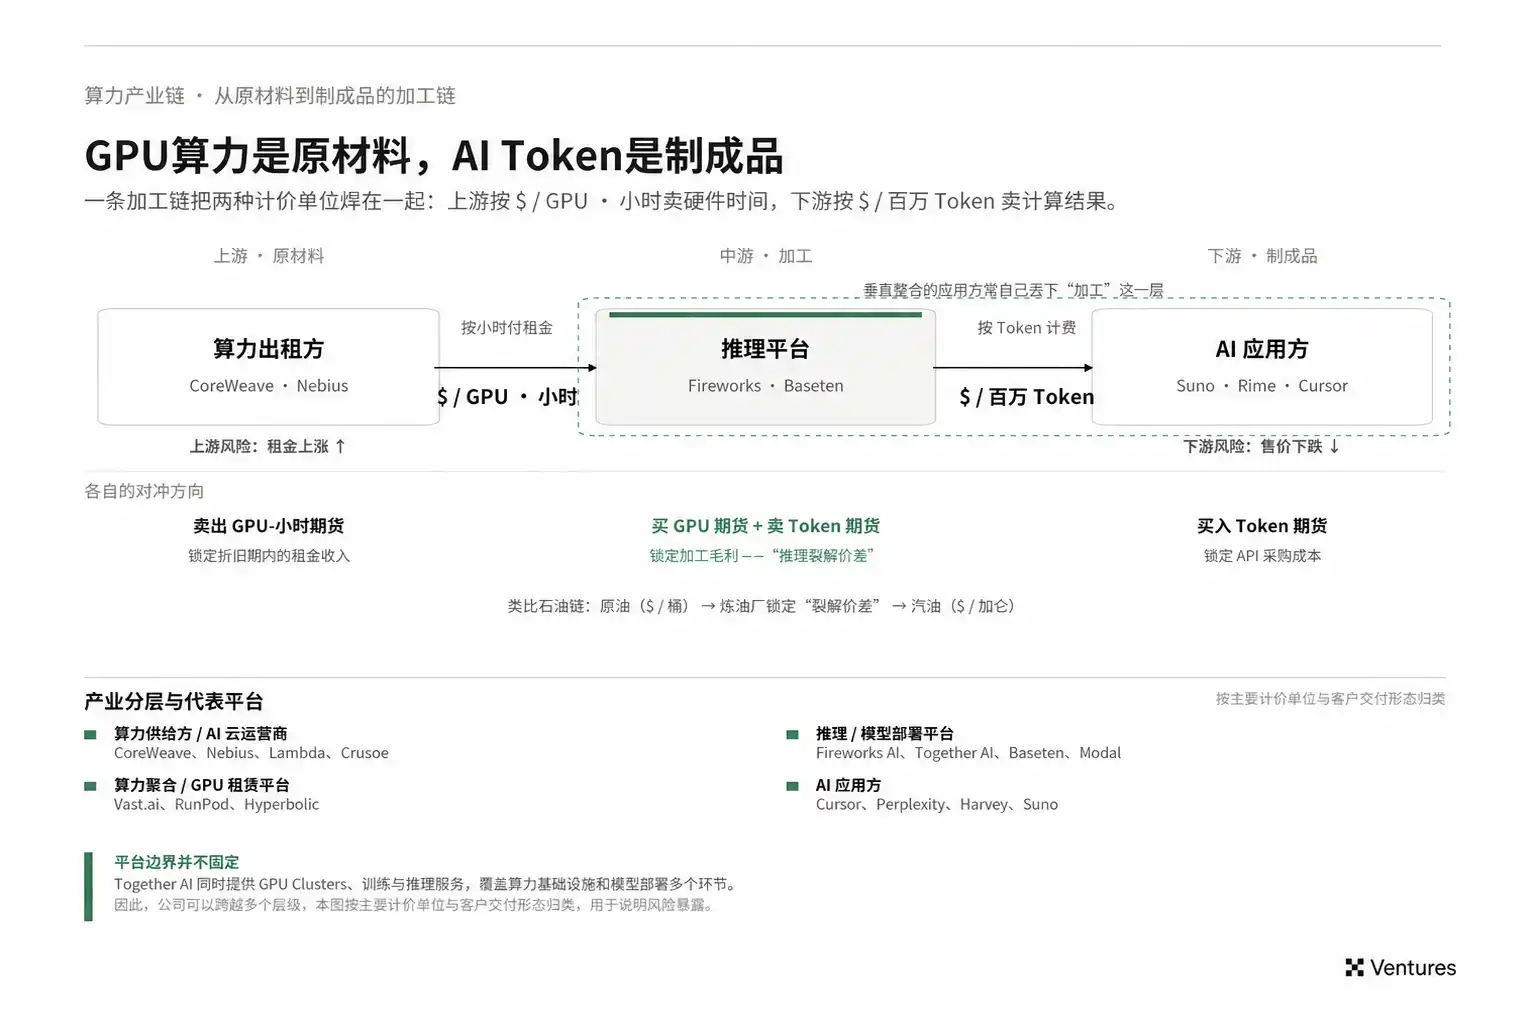
ただし、GPUアワーとAIトークンは現在、標準化の度合いが大きく異なります。
GPUはモデル、地域、相互接続方式、クラスター規模、SLAの違いはあるものの、少なくとも特定世代のチップ、納期、地域に基づいて標準仕様を段階的に定義できます。H100やH200は技術的属性において比較的明確な境界を持っています。
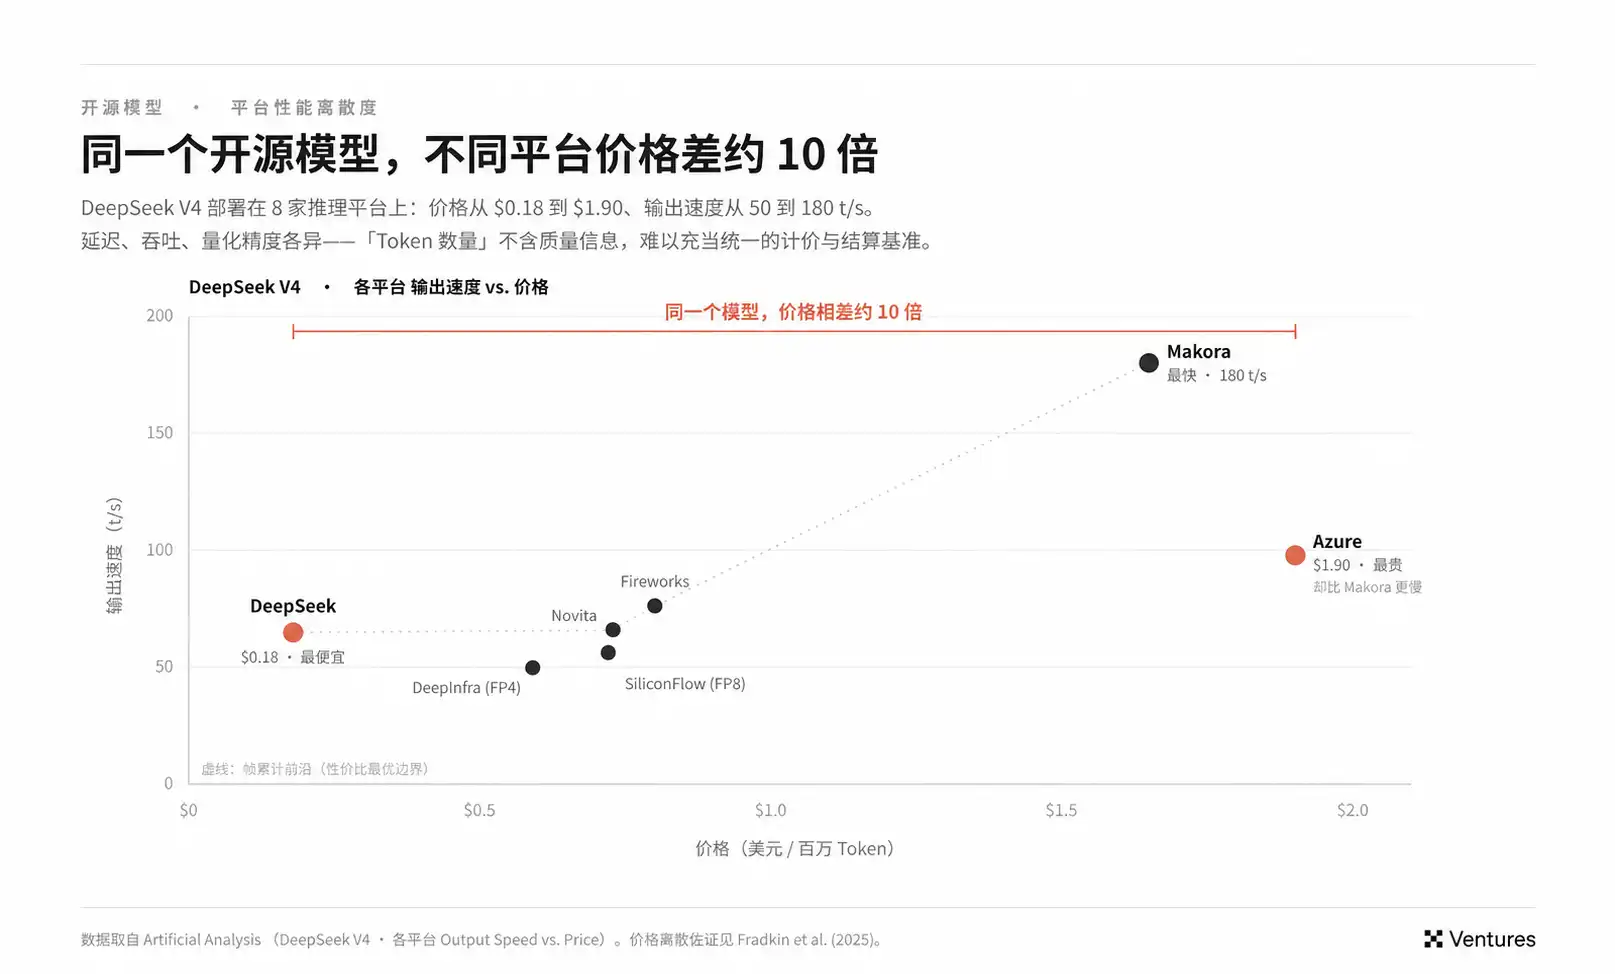
一方、トークンは安定した経済単位がさらに不足しています。単純にトークン数で決済する場合、異なるモデルや異なるサービス品質を同じ金融契約に組み込むことは困難です。同じ100万トークンでも、全く異なる能力のモデルから生じる可能性があり、全く異なるレイテンシー、スループット、安定性に対応する可能性があります。企業の大口顧客の実際の調達価格は公開APIの提示価格より低いことが多く、そのため提示価格自体も金融決済の基準として直接使用するのは難しいです。
さらに、技術的デフレがAIトークンの期間価格設定の難しさをさらに拡大しています。モデルアーキテクチャ、推論フレームワーク、ハードウェア効率は継続的に向上しており、同等品質のタスクに必要な計算コストは非常に短期間で顕著に低下する可能性があります。期間が長くなると、市場が予測する必要があるのはトークンの需給だけでなく、将来の1単位の「インテリジェンス能力」に必要なトークン数とGPU数も含まれます。
このように、需要側の標準化は必ずしもToken futuresから直接始まるわけではない。より可能性が高いのは、まずモデルバスケット、Router、workload pricingが登場することだ。つまり、コーディングや検索などのタスクを比較的安定したサービス単位として定義し、その上で基盤システムが動的にモデルとプロバイダーを選択する。こうしたworkloadに十分な実取引が蓄積されて初めて、市場はさらに指数やデリバティブを形成する条件が整う。
GPU-hourは基礎商品に近く、workloadは最終的な経済需要に近い。両者の間の標準化プロセスが、算力金融市場の最終的な取引対象を決定づける。
BlockBeats の公式コミュニティに参加しよう:
Telegram 公式チャンネル:https://t.me/theblockbeats
Telegram 交流グループ:https://t.me/BlockBeats_App
Twitter 公式アカウント:https://twitter.com/BlockBeatsAsia

 関連記事