二つのインシデントの後、Anthropicの共同創設者7人は、「安全」について1年前にどのように議論したかを振り返ります。
元のビデオタイトル:Building Anthropic | 共同創設者との対談
元のビデオソース:Anthropic
元の翻訳:深潮 TechFlow
要点のまとめ
先週、Anthropic は2回の連続したインシデントを経験しました:
まず最初に、内部で約3000のファイルがCMSの設定エラーにより公開アクセスされました。その後、Claude Code v2.1.88 がnpmで公開された際、59.8MBのソースマップが挟まれ、51万行のソースコードがそのまま露出しました。
「セキュリティ」を遺伝子に組み込んだ企業が、自社の運営で連続的に問題を抱えるという皮肉な感じが満ちています。
しかし、揶揄することに急いで触れる前に、Anthropic の共同創設者たちが1年以上前に行った内部会話を振り返ってみませんか。このポッドキャストは2024年12月に録音され、この企業がどのように設立され、RSP(責任あるスケーリングポリシー)がどのように練られたか、なぜ「セキュリティ」という言葉を適当に使ってはいけないのか、そしてCEOダリオが何度も引用された発言:
「もし建物が毎週火災警報を鳴らしているなら、それは実際には非常に安全でない建物です。」
今、この言葉をもう一度聞くと、その味わいが確かに異なります。
共同創設者7人の、素早い顔見知り
Dario Amodei|CEO、元OpenAI研究副社長、神経科学の専門家、Anthropicの戦略とセキュリティの最終決定者。この会話で最も発言が多かったです。
Daniela Amodei|会長、ダリオの姉。以前はStripeで5年半働き、信頼とセキュリティチームを率いており、それ以前には非営利および国際開発分野で働いていました。Anthropicの組織構築と外部へのコミュニケーションはほぼ彼女が主導しています。
Jared Kaplan|物理学教授からAI研究者へ転身し、scaling lawsの中核的な著者の1人です。常に外部からの視点で判断を提供し、かつてAIを始めた理由は「物理学に飽きた」からだと述べています。
Chris Olah|解釈可能性(interpretability)の分野で知られる人物で、19歳でシリコンバレーのAIコミュニティに参入し、その後、Google BrainとOpenAIで活躍。Anthropicで最も技術的理想主義色が濃い人物。
Tom Brown|GPT-3の論文の第一著者で、現在はAnthropicのコンピューティングリソースを管理している。エンジニアリングとインフラストラクチャに重点を置いた視点を持ち、ポッドキャストで「AIがこんなに早く発展するとはあまり信じていなかった」という考えを変えた経緯について話している。
Jack Clark|元彭博テクノロジージャーナリストで、Anthropicの政策およびパブリックアフェア担当者。この対談では司会進行を務め、進行や追加質問を担当。
Sam McCandlish|Research Fellowであり、ほとんど発言機会がないが、要点を突いた発言をすることが多く、「補完的立場」に該当。
ハイライト要約
AIを追求する理由:物理学の退屈から「見ればわかる」という信念へ
Jared Kaplan:「以前は物理学を長いことやっていましたが、少し飽きてきて、多くの友人と一緒に働きたかったので、AIを始めました。」
Dario Amodei:「確かに、私はあなたをはっきりと説得したわけではないと思います。ずっとAIモデルの結果を見せ続けていました。ある時点で、あなたにたくさん見せたら、『うーん、これは正しいように見える』って言ったんです。」
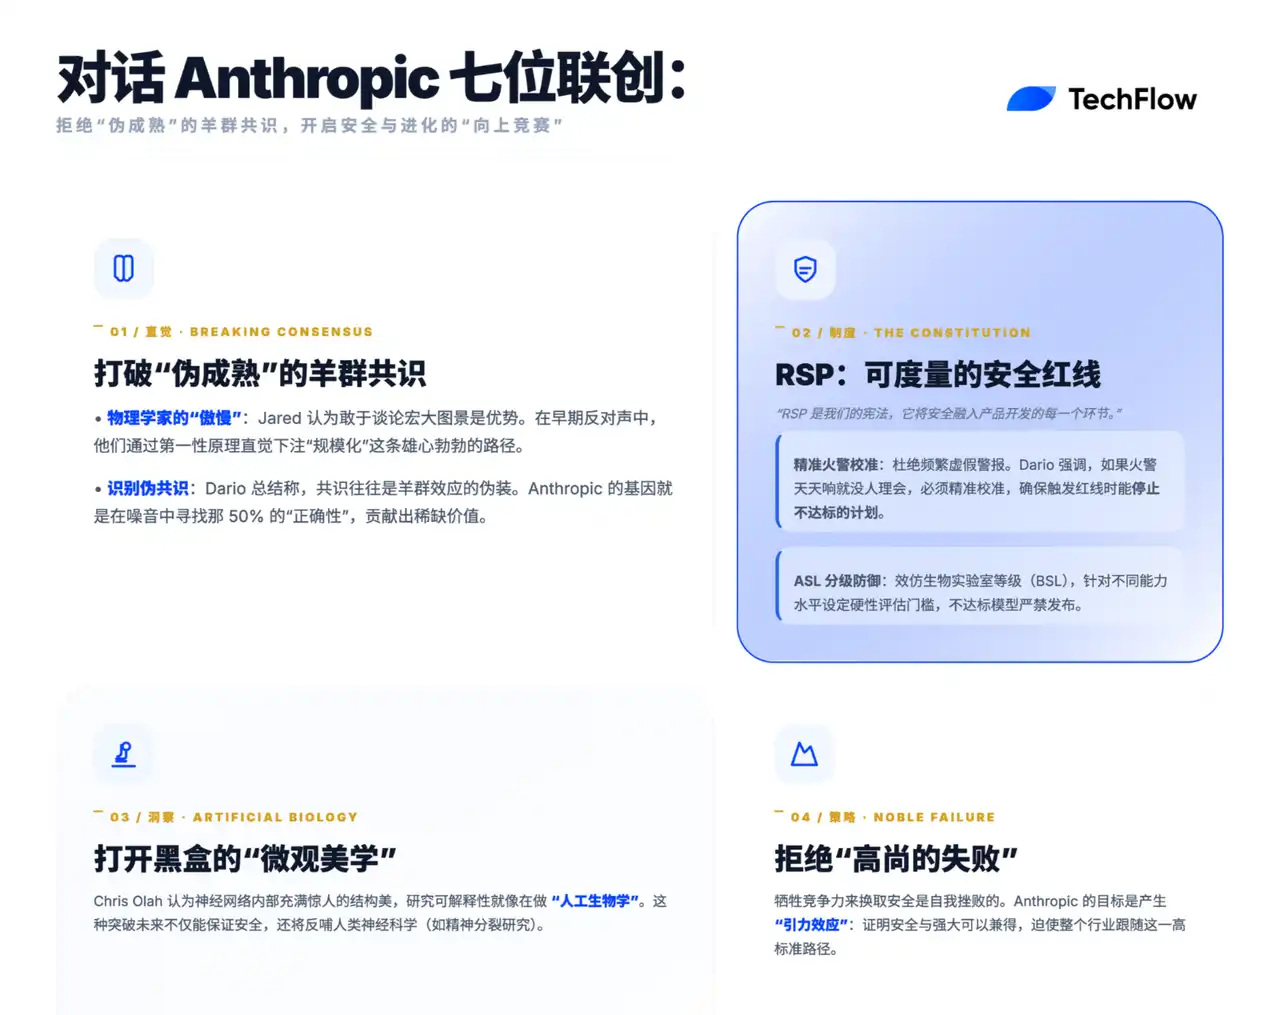
逆強制賭注:多くの共通認識は群れの効果が成熟したものに見えるだけ
Jared Kaplan:「多くのAI研究者はAIの冬によって深く傷つき、野心を持つことが許されないような心理的ダメージを受けています。」
Dario Amodei:「私の過去10年での最大の教訓は、多くの人が『みんな知っている』と考えている共通認識は、実際には群れの効果が成熟したものに見せかけていることです。共通認識が一夜で覆されることを何度か目にすれば、『いや、私たちはこれに賭ける』と言うようになります。50%しか正しくなくても、他の誰も提供しなかったものを多大に貢献できます。」
セキュリティとスケーラビリティは密接に結び付いています
Dario Amodei:「当時、モデルを拡張する動機の1つは、モデルが十分に賢くなければ、RLHF を遂行することができないということでした。これが私たちが今でも信じていることです:セキュリティとスケーラビリティは密接に結び付いています。」
RSP、責任ある拡張方針は Anthropic の「憲法」
Tom Brown:「RSP は Anthropic にとって、まるで私たちの憲法のようなものです。それは指針を持つ中核的な文書であり、したがって私たちはそれを磨き上げるために多くの時間と労力を費やすことに喜んで取り組んでいます。」
Dario Amodei:「RSP は、セキュリティ基準に合致しない計画が前進するのを防ぎます。私たちはスローガンを唱えているのではなく、セキュリティをすべての段階に具体的に組み込んでいます。」
火災警報が頻繁に鳴ると、本当の火災が起きても誰も逃げなくなります
Daniela Amodei:「私たちは『セキュリティ』という言葉を簡単に使って仕事の進展を左右することはできません。私たちの本当の目標は、私たちが指すセキュリティが何かをみんなが明確に理解できるようにすることです。」
Dario Amodei:「本当にセキュリティを損なうのは、しばしば行われる『セキュリティ演習』です。毎週火災警報が鳴り響くビルがある場合、それは非常に安全でない建物です。」
「高潔な失敗」は罠です
Chris Olah:「最も道徳的な行為は、安全性のために他の目標を犠牲にし、自らが事業への純粋さを示すためだとする見方があります。しかし、この方法は実際には自己崩壊につながります。なぜなら、これによって意思決定権が安全性を重視しない人々の手に落ちることになるからです。」
創設メンバーたちは収入の80%を寄付することを約束しています
Tom Brown:「私たちは収入の80%を、社会の発展に貢献することができる取り組みに寄付することを共同で約束しており、これは皆が熱心に支持していることです。」
誰もが起業したいと思っているわけではありませんが、そうする必要があると感じている
Sam McCandlish:「実際、私たちの中に最初から会社を設立したいと考えていた人はいません。私たちが感じたのは、これがAIの発展を正しい方向に導く唯一の方法だという使命感でした。」
Daniela Amodei:「私たちの使命は明確で純粋であり、技術業界ではそれが珍しいことです。」
説明可能性:ニューラルネットワークには「人工生物学」の完全なセットが含まれている
Chris Olah:「ニューラルネットワークは非常に素晴らしいもので、まだ見ぬ多くの美しさがあります。時々、10年後に書店に入って、ニューラルネットワーク生物学に関する教科書を買うことを想像します。その本には驚くべき内容がたくさん詰まっているでしょう。」
AIは民主主義を強化するために使用されるべきであり、独裁ツールとなるべきではない
Dario Amodei:「私たちはAIが誤った方向に発展した場合、それが独裁主義のツールになる可能性に懸念を抱いています。AIを自由と自己決定を促進するツールにするにはどうすればよいのでしょうか?この分野の重要性は生物学や説明可能性に引けを取りません。」
ホワイトハウスの会議からノーベル賞:AIの影響力は技術の枠を超えています
Jared Kaplan:「2018年、言語モデルに注目しているという理由で大統領がホワイトハウスに呼び出すとは思いませんでした。」
Dario Amodei:「私たちは化学分野でAlphaFoldにノーベル賞が授与されるのを見てきました。私たちは数百のAlphaFoldを生み出すのに役立つツールを開発する努力をすべきです。」
AIを研究する理由
Jack Clark: AIを研究する理由は何ですか?Jared、なぜAIをやっているのですか?
Jared Kaplan:「以前は物理学を長い間やっていましたが、少し飽きてきましたし、もっと多くの友人と一緒に働きたかったので、それでAIをやることにしました。」
Tom Brown:「私はダリオがあなたを説得したと思っていました。」
Dario Amodei:「私は自分があなたを明確に説得したとは感じていません。単に常にAIモデルの結果を示して、それらが汎用的で単一の問題にのみ適用されるのではないことを伝えたかっただけです。ある時点で、あなたに十分な量を見せたら、『うん、これは正しいようですね』と言ってもらえました。」
Jack Clark:Chris、あなたが説明可能性の研究をしていたとき、Googleで皆さんと知り合いましたか?
Chris Olah:「いいえ。実際、19歳のときに初めて湾岸地域に来たとき、あなたたちの多くの方々と知り合いました。その時にダリオとJaredに会いましたが、彼らはポスドクで、当時私にはとてもかっこいいと思いました。後にGoogle Brainに行ったとき、ダリオが加わり、しばらく一緒に座っていました。また、トムとも一緒に仕事をしました。その後OpenAIに行き、皆さんと一緒に仕事をすることになりました。」
Jack Clark:「私は2015年に会議でダリオに会い、インタビューしようと思ったことを覚えています。GoogleのPRは私があなたの論文を最初に読む必要があると言いました。」
Dario Amodei:「そのとき私はGoogleで『Concrete Problems in AI Safety』を執筆していました。」
Sam McCandlish:「あなたと共同作業を始める前に、オフィスにお話ししに誘ってくれました。AI全体について一通り説明してくれたような記憶があります。話を聞いた後、『私が意識していたよりも、この問題はずっと深刻なものだということがわかりました。』と感じました。当時、大規模計算能力の塊、パラメータの数、人間の脳のニューロン規模などについて話されていました。」
Breakthrough Scaling
Jack Clark:OpenAIでスケーリング則を行っていたとき、モデルを大きくすることが本当に効果的であり、GPT-2からスケーリング則、そしてGPT-3に至るまで、多くのプロジェクトで継続的に、奇妙にも効果的でした。私たちはまさに、それを成し遂げる団体です。」
Jared Kaplan:「私たちはセキュリティにも非常に興奮しています。その時、一つの考えがありました:AI は非常に強力になるかもしれませんが、人間の価値を理解せず、私たちとコミュニケーションができないかもしれません。言語モデルはある程度それを保証できるようです。」
Dario Amodei:「言語モデルの上には RLHF もあり、当時、モデルを拡大する動機の一つは、モデルが十分に賢くなければ、RLHF を行うことはできない、ということでした。これが私たちが今も信じていることです:セキュリティとスケーラビリティは互いに絡み合っています。」
Chris Olah:「そうですね、当時のスケーリング作業は実際にはセキュリティチームの一部でした。なぜなら、セキュリティに真剣に取り組んでほしいと思うのであれば、まずは AI のトレンドを予測できる必要があると考えたからです。」
Jack Clark:「私はイギリスのある空港で、GPT-2 からフェイクニュースをサンプリングして書いて、それを Slack で Dario に送ったことを覚えています。『これは本当に使えるかもしれませんし、巨大な政策への影響をもたらす可能性があります』と Dario に言った記憶があります。Dario が『そうです』と返信したことを覚えています。」
その後、私たちは多くのリリース関連の作業も行いましたが、それはとても狂ったことでした。
Daniela Amodei:「私はそのリリースの時期を覚えています。それは私たちが本当に最初に協力し始めた時であり、GPT-2 がその時リリースされたときでした。」
Jack Clark:「それは私たちにとって非常に役立ったと思います。まず一緒に『少し変わったがセキュリティ志向の』ことをし、その後、Anthropic という、より大規模で同様に少し変わったがセキュリティ志向のプロジェクトを一緒に取り組んできました。」
AI の初期段階
Tom Brown:「『Concrete Problems』という論文に戻りましょう。私は2016年にOpenAIに入社しましたが、あなたと私はその最初のグループでした。当時、その論文は初めての主流のAIセキュリティ論文のように感じられました。それはどのようにして生まれたのですか?」
Dario Amodei:「Chris が知っています、彼も参加していました。当時私たちはGoogleにいて、その時私がメインで取り組んでいたプロジェクトをすでに忘れてしまいましたが、その論文は私が引き延ばしたもののように感じられました。」
AI セキュリティには、どのような未解決問題があるかを記したいと考えています。当時、AI セキュリティは非常に抽象的に扱われており、我々はそれを実際の機械学習に落とし込みたいと考えていました。この分野ではすでに6〜7年が経過していますが、当時、それは奇妙な考え方でした。
Chris Olah:「それはある意味でほぼ政治的なプロジェクトだと思います。当時、多くの人々はセキュリティを重視していませんでした。私たちは、文献にすでに存在する多くの問題を整理し、それに共通の信頼性のある権威ある人物を見つけて共同で署名することで、誰もが合理的に認める問題リストを作成したいと考えました。」
私は、Brain の20人以上の研究者と長い時間を費やし、発表を支援するために尽力しました。問題自体だけを見ると、今日振り返っても必ずしも正しいとは限らず、最適な問題であるとは限りません。しかし、それを合意形成と捉えると、「ここに実際の問題があり、真剣に取り組む価値があることを証明する」という意味で、それは重要な瞬間でした。
Jack Clark:「最終的には非常に奇妙なSF世界に入り込むことになります。Anthropic初期に憲法AIについて話していたことを覚えています。Jaredは言いました。「私たちは言語モデルに憲法を書かせると、その行動が変わるでしょう」。当時、それは狂ったように聞こえました。なぜそう考えたのですか?」
Jared Kaplan:「私はDarioと長い間話し合いました。私はAIでは単純な方法がしばしば非常に効果的であると考えています。初期のバージョンはかなり複雑でしたが、後に継続的に簡素化され、最終的には、モデルが選択問題を得意としており、はっきりしたヒントを与え、何を探しているのかを伝えるだけで十分であり、それから我々は原則を直接書き留めることができました。」
Dario Amodei:「これは『計算の大塊』(The Big Blob of Compute)『苦い教訓』(The Bitter Lesson)『スケーリング仮説』(Scaling Hypothesis)に戻ります:AIに明確な目標とデータを提供できれば、それは学習できます。一連の指示、一連の原則、言語モデルはそれらを読み取り、自身の行動と照らし合わせ、トレーニング目標はその中にあります。だから、私とJaredの見解は、方法さえあれば実現可能であり、細部を何度も調整する必要があるということです。」
Jared Kaplan:「初期の段階では非常に奇妙でした。私は物理学から来たので、今ではみんながAIに興奮していますが、当時の雰囲気を忘れやすいです。私はDarioとこれらのことを話していましたが、多くのAI研究者がAIの寒冬の心理的影響を受けており、『野心を持つこと』が許容されていないかのようでした。セキュリティについて議論するには、ますますAIが非常に強力であり、非常に有用である可能性を信じる必要がありますが、当時はある種の反野心的な禁止令が存在していました。物理学者の利点の1つは『傲慢さ』です。彼らはしばしば大胆なことを行い、大局的な視野を持つことに慣れています。」
Dario Amodei:「これは私が本当だと思うもので、2014年には多くのことが言えなかったと感じています。これは学問界全般の問題であり、特定の分野を除いて、機関はリスクをますます嫌うようになり、産業AIもこの心構えを引き継いでいると思います。私は、2022年頃までにはこの状況が変わると考えています。」
Chris Olah:「さらに「保守」には2つの形態があります。1つはリスクを真剣に考えることであり、もう1つは成功の可能性を真剣に受け止め、信じることを傲慢と見なすことです。当時、私たちは後者が優勢でした。1939年の核物理の議論も同様でした:Fermiは慎重で、SzilardやTellerはリスクを真剣に考えていました。」
Dario Amodei:「この10年で最も深い学びは:多くの人が「誰もが知っている」と信じている合意は、実際には群れの中で成熟したものを装ったものであることです。何度か合意が一夜にして逆転するのを見てくると、「いや、私たちはこれに賭ける」と言うようになります。それが正しいかどうかはわかりませんが、騒音を無視して賭けるのです。たとえあなたが正しい確率が50%しかない場合でも、多くの人々が貢献していないことを多くの貢献をします。」
人工知能への一般大衆の態度の変化
Jared Kaplan:「今日、いくつかのセキュリティ問題でも同じ状況が見られます。一般の合意からは、技術からは多くのセキュリティ上の問題が自然に生じないだろうと考えられていますが、私たちはAnthropicでの研究を通じて、実際にそれらの問題が自然に発生することを確認しています。」
Daniela Amodei:「しかし、過去18か月で状況が変わりつつあり、世界全体でAIに対する感情も明らかに変化しています。私たちがユーザー調査を行う際、一般のユーザーが世界全体へのAIの影響に懸念を抱くことがより頻繁に聞かれるようになっています。」
時には仕事や偏見、有害な行動、時には「世界を混乱させ、人間の協力の仕方を変えるのではないか」「それは世界を狂わせるか」など、私自身はそれらを完全に予測していませんでした。
Sam McCandlish:「なぜか、機械学習の研究者たちは「AIが非常に強力になる」という点で一般の人々よりも悲観的です。」
Jared Kaplan:「2023年、私とDarioはホワイトハウスに行き、Harris、Raimondoとの会議で基本的なメッセージは:私たちはあなたたちを注視しています、AIは重要です、真剣に注目していますが、2018年には「大統領が言語モデルについて注目しているとあなたが思うことはなかったでしょう」。」
Tom Brown:「興味深いことに、私たち多くはこの事柄がまだ確定していない状態で参入してきました。まるで Fermi が原子爆弾に懐疑的であったかのように、原子爆弾が製造される可能性を示唆する証拠がいくつかありましたが、同時にそれが起こらない可能性を示唆する証拠も多くありました。しかし、最終的に試してみようと決断しました。それが本当であれば、影響は非常に大きいため、取り組む価値があります。」
2015年から2017年にかけて、AIが重要なものである可能性を示唆する証拠がいくつかあり、私は2016年にメンターと話をしました。私は起業経験があり、AIセキュリティをやりたいと思っていましたが、数学力が足りず、どうしたらいいかわかりませんでした。当時、誰かが意思決定理論を習得する必要があると言い、誰かが狂ったようなAIの出来事は起こらないだろうと言っていましたが、本当に支持してくれる人はほとんどいませんでした。
Jack Clark:「私が2014年にImageNetのトレンドレポートを作成したとき、狂人と見なされました。2015年にはNVIDIAの論文にGPUが提案されることを書こうとしましたが、それも狂気だと言われました。2016年にはニュースから離れてAIの世界に入り、『人生で最大の間違いを comitted』とメールで言われました。その時は、多くの面から、「スケール化は実現するだろう」と真剣に賭けることは、本当に狂気のようでした。」
Jared Kaplan:「どのようにして決断しましたか?葛藤はありましたか?」
Jack Clark:「私は逆転賭けをしました:常勤のAIジャーナリストとしての仕事を要求し、給料を倍にするようにしましたが、彼らが受け入れることはないだろうとわかっていました。そして、一晩眠って目を覚ますと辞職することになりました。私は毎日ファイルを読んでいたので、常に何か狂気のような出来事が起こっていると感じていました。ある時点で、大きく信じるべきだという確信が持てるはずです。」
Tom Brown:「私はそこまで果断ではありませんでした、私は半年間揺れ動いていました。」
Daniela Amodei:「そして、その時、「エンジニアもAIを大きく加速させることができる」という考え方は一般的ではありませんでした。当時は「AIをするのは研究者だけ」という考え方でしたので、あなたの葛藤は不思議ではありません。」
Tom Brown:「その後、OpenAIが「エンジニアがAIの安全性に貢献できる」と言っていたので、私はそこに参加しました。Daniela、あなたがOpenAIに加わった理由は何ですか?」
Daniela Amodei:「私はStripeに5年半在籍し、Gregはかつて私の上司でした。また、GregとDarioを紹介したことがあります。その時、彼はOpenAIを立ち上げていたので、私は彼に言いました:『私が知っている中で最も賢い人はダリオだ。もしあなたが彼をチームに加えることができれば、それは本当に幸運です。』その後、ダリオはOpenAIに参加しました。」
おそらくあなたと同様に、私も Stripe を離れた後、自分が何をしたいか考えています。私が Stripe に参加した理由は、以前に非営利団体や国際開発の分野で働いていたとき、より多くのスキルが必要だと感じたからであり、その当時はその分野に戻ると思っていました。
Stripe に参加する前は、自分には私よりも状況の悪い人々を助ける能力がまだ不十分だと感じていました。そのため、他のテクノロジー企業に注目し、より大きな影響を生み出す新しい方法を見つけたいと考えていました。その時点での OpenAI は、非常に重要で意義深い目標を達成することに専念している非営利組織であると感じました。
私は常に AI の可能性を信じてきました。 Dario についても少し知識があり、彼らは実際に管理を支援する人物が必要だったため、この仕事と私のバックグラウンドは非常に適合していると感じました。その時、私はこう心に決めました。「これは非営利組織であり、非常に優れた、前向きなビジョンを持つ人々が集まっていますが、彼らの運営はまだ多少混沌としているようです。」それが私をワクワクさせる挑戦だと感じました。なぜなら、私が参加できると思ったからです。
当時、私は自分が何でもできる選手のように感じました。チームメンバーの管理だけでなく、いくつかの技術チームをリードし、組織の拡大を担当し、組織の拡大作業を管理し、言語チームで働いたこともあり、後には他のいくつかのタスクを引き受けました。私はいくつかの方針に関する問題にも取り組み、Chris と一緒に作業したこともありました。会社には非常に優秀な人材がたくさんいると感じたので、特に参加して、会社がより効率的で整然としたものになるのを手伝いたいと思いました。
Jack Clark: 「GPT-3 を終えた後、あなたが「信頼と安全性について聞いたことがありますか?」と言ったのを覚えていますか?」
Daniela Amodei: 「以前は Stripe で信頼と安全性チームを率いたことがあります。このようなテクノロジーについては、信頼性と安全性の問題を考慮する必要があるかもしれません。これは実際、人工知能の安全性研究とより実用的な日常業務の間の橋であり、つまり、どのようにモデルを本当に安全にするかです。」
将来その技術が重大な影響を及ぼすと主張することは非常に重要です。同時に、将来より高いリスクの状況に対処するための基盤を日常的に築く必要があります。
責任ある拡張ポリシー:AI の安全な発展を確保する
Jack Clark: 「責任あるスケーリングポリシー(RSP、Responsible Scaling Policy)がどのように提案され、なぜそれを考えついたのか、そして現在どのように適用されているか、特に私たちがモデルの信頼性とセキュリティに取り組んでいる点を考慮すると、RSP(責任あるスケーリングポリシー)は最初に誰によって提案されましたか?」
Dario Amodei: 「最初に私とPaul Christianoが提案しました、時期は2022年末頃でした。最初のアイデアは、ある特定の規模にモデルをスケーリングする前に、一時的にそれを制限すべきか、一部のセキュリティの問題を解決する方法を見つけるまでそれを制限するべきか、というものでした。」
しかし、後になって、スケーリングをあるポイントで制限し、そして制限を解除するだけのアプローチはやや奇妙だと感じました。したがって、私たちは、モデルが特定の閾値に到達するたびに、モデルが適切なセキュリティ能力を備えているかどうかを評価するために、一連のテストを実施するための一連の閾値を設定することに決定しました。
各閾値に到達するたびに、私たちはより厳格なセキュリティおよび保護措置を講じる必要があります。ただし、最初の段階で、私たちは1つの考えを持っていました:もしこのことを第三者に実行させたら、もっと良いのかもしれない。つまり、このポリシーは特定の会社だけが責任を持つべきではないということであり、そうでなければ他の企業はこのポリシーを採用することをためらうかもしれません。そのため、Paulがこのポリシーを設計しました。もちろん、経時的には、その多くの詳細が変化しました。私たちのチームは、このポリシーをよりよく機能させる方法について常に研究しています。
Paulがこのコンセプトを整理し形にしたとき、彼がそのコンセプトを発表するのとほぼ同時に、私たちも1〜2か月以内に独自のバージョンをリリースしました。実際、私たちのチームの多くのメンバーがこのプロセスに深く関与していました。自分が少なくとも1つの初期稿を書いたことを覚えていますが、その全体は何度も修正を経ています。
Tom Brown: 「Anthropicにとって、RSPは私たちの『憲法』のようなものです。それは指針となる中核的な文書であり、その正確性と完成度を確保するために多くの時間と労力を注ぎ込む価値があります。」
Daniela Amodei: 「私は、Anthropicの成長過程でRSPが本当に興味深いものだと感じています。それは複数の段階を経ており、実装を推進するためにさまざまなスキルが必要です。たとえば、いくつかの大規模なアイデアがあり、それは主にDario、Paul、Sam、Jaredなどが担当しており、彼らは次を考えています:『私たちの中核的な原則は何ですか?私たちが伝えたいメッセージは何ですか?自分たちの進むべき方向が正しいことをどのように確認しますか?』」
しかしそれ以外にも、非常に実践的な操作レベルの作業があります。たとえば、継続的なイテレーションプロセスの中で、私たちはいくつかの詳細を評価および調整します。例えば、あるセキュリティレベルで特定の目標が達成されると予想していましたが、実現されていない場合、我々は再評価を行い、自身の作業結果に責任を負えるようにします。
さらに、組織構造に関連する多くの調整があります。たとえば、我々は RSP の組織構造を再設計することを決定し、責任をより明確に分担するためです。私はこの文書の重要性を比喩するのが好きです。アメリカが憲法の履行を確認するために裁判所、最高裁判所、大統領、上下両院などの制度および機関を確立したように、これらの機関は他の責務も担っていますが、大部分が憲法の維持のためであり、我々は Anthropic の RSP でも同様のプロセスを経験しています。
Sam McCandlish:「実際、これは我々がセキュリティ問題に対する核心的な見解を反映していると思います:セキュリティ問題は解決可能です。」 これは非常に複雑で困難なタスクであり、多くの時間とエネルギーを費やす必要があります。
自動車安全領域と同様に、関連する制度および機関は長年の発展の結果確立されました。しかし私たちが今直面している課題は、「私たちにはこれらの作業を完了するための時間が十分にあるのか?」ということです。したがって、AIセキュリティに必要な主要な制度を迅速に特定し、まず私たちの所でそれらを確立し、同時に他の場所で活用可能で普及可能なようにする必要があります。
Dario Amodei:「これは組織内の協力と統一にも役立ちます。組織内のどの部分でも安全価値観に適合しない行動がある場合、RSP は何らかの形で問題を露呈しますよね?RSP は安全基準に適合しない計画を進めるのを阻止します。したがって、それはすべての人に継続的に思い起こさせ、安全性が製品開発や計画プロセスの基本的要件であることを確認するツールにもなります。我々はスローガンを口にするのではなく、安全性をすべての段階に実際に組み込んでいるのです。もし誰かがこれらの原則に同意できない場合、彼らは周囲と合わないことに気付くでしょう。この方向に適応するか、継続するのが難しいことに気付くでしょう。」
Jack Clark:「時間の経過とともに、RSP はますます重要になりました。我々は何千時間もの労力を費やしています。議員たちに RSP を説明するとき、私はこう言いました:『我々はいくつかの措置を講じました。技術が乱用されにくく、同時に安全を確保できるようにしています。』 彼らの反応は通常、『それはまあ普通のことですよね。すべての企業がそうするわけではありませんか?』となります。これは少々皮肉なことですが、実際はすべての企業がそうしているわけではありません。」
Daniela Amodei:「その上、私はチームの価値観の一貫性を推進するだけでなく、RSP は企業の透明性を高めたと思います。私たちの目標が何であるかが明確に記録されているため、企業内のすべての人が理解し、同時に外部の人々もセキュリティに関する目標と方向が明確になっています。まだ完璧ではありませんが、常に最適化と改善を続けています。」
「私たちが注力すべき核心的な問題を明確に示すことは重要だと考えます。私たちは単に『セキュリティ』という言葉で業務を左右するべきではありません。例えば、『セキュリティの問題により、あることができない』とか『セキュリティの問題により、あることをしなければならない』というふうに。私たちの真の目標は、安全とは何を指すのかを明確にすることです。」
Dario Amodei:「長期的な視点から見ると、本当に安全を損なうのは頻繁な『セキュリティ訓練』です。私は以前言ったことがあります:『もし建物が毎週火災警報を発するようなら、それは非常に安全でない建物です。』実際に火災が発生したとき、誰もそれを気にしないかもしれません。私たちは警報の正確性と校正に非常に注意を払う必要があります。」
Chris Olah:「別の視点から見ると、私は RSP が多くのレベルで健全なインセンティブメカニズムを生み出したと考えています。例えば企業内では、RSP は各チームのインセンティブメカニズムを安全な目標に合わせています。つまり、セキュリティの面で十分な進展を遂げていない場合、関連する作業が一時停止されるということです。」
「一方で、外部では、RSP は他の方法よりも健全なインセンティブメカニズムを生み出します。例えば、もし将来的に大規模な行動を取らなければならない日が来たとしたら、例えば『我々のモデルがある段階まで進化したが、その安全性を保証することができない』と認めなければならない場合、RSP はその決定をサポートする明確なフレームワークと証拠を提供します。このフレームワークは事前に存在し、明確で理解しやすいものです。RSP の初期バージョンについて議論していたとき、その潜在力に完全に気づいていなかったかもしれませんが、今ではそれが私たちが想像できる他の方法よりも実際に効果的であると考えています。」
Jared Kaplan:「これらの観点に同意しますが、私は正しい方針の策定や基準の評価、境界の設定に関して直面している課題が低く評価されている可能性があると考えています。私たちはこれらの面で多くの反復を行い、引き続き最適化を進めています。難しい問題の1つは、いくつかの新興技術に対して、それが危険なのか安全なのかを明確に判断することが時々難しいことです。多くの場合、私たちは非常に曖昧な領域に直面します。これらの課題は、私が RSP の開発初期に非常に興奮した思い出があり、今でもそう感じています。しかし同時に、この戦略を明確に実装し、本当に機能させるには、私が最初に想像していたよりも複雑で挑戦的なものであることに気づいています。」
サム・マッキャンディッシュ:「グレーゾーンは完全に予測できないため、どこにでも存在します。問題の所在は、実装を本当に開始してみないとわかりません。したがって、私たちの目標はすべてを早めに実装することであり、これにより潜在的な問題を早く発見できるようになります。」
ダリオ・アモデイ:「完璧にするには3〜4回の反復が必要です。反復は非常に強力なツールであり、最初から完全に正確に行うことはほとんど不可能です。したがって、面するリスクが増加し続けている場合は、これらの反復を早めに完了する必要があります。後回しにしてはいけません。」
ジャック・クラーク:「同時に、内部の規則とプロセスを確立する必要があります。具体的な詳細は時間とともに変わるかもしれませんが、チームの実行力を養成することが最も重要です。」
トム・ブラウン:「私はAnthropicの計算リソース管理を担当しており、外部利害関係者とのコミュニケーションが必要です。さまざまな外部の人々が技術の発展スピードに異なる見解を持っています。最初は技術がそこまで急速に進展しないと考えていましたが、後で考えが変わりました。そのため、RSPは私にとって特に有用だと感じています、特に技術の進展が比較的緩慢だと考える人々との対話時に。彼らに伝えることができます:「技術が非常に緊急な段階に達するまでに、極端なセキュリティ対策を講じる必要はありません。」彼らが「long time」まで何も変わらないと言ったら、「かしこまりました、では一時的に極端なセキュリティ対策を講じる必要はありません。」と返答することができます。これにより、外部とのコミュニケーションがスムーズになります。」
ジャック・クラーク:「それでは、RSPは皆さんにどのような影響を与えていますか?」
サム・マッキャンディッシュ:「すべてが評価を中心に展開しています。各チームは評価作業を行っています。例えば、トレーニングチームは常に評価作業を行っており、このモデルがすでに十分に強力になっており、危険を引き起こす可能性があるかどうかを特定しようとしています。」
ダニエラ・アモデイ:「実際には、私たちはモデルのパフォーマンスをRSPの基準に基づいて評価する必要があります。それは、私たちが懸念する可能性の兆候が存在するかどうかを確認することを含みます。」
サム・マッキャンディッシュ:「モデルの最低能力を評価することは比較的簡単ですが、モデルの最高能力を評価することは非常に困難です。そのため、私たちは多くの研究労力を注ぎ、このような質問に答えようとしています:「このモデルはいくつかの危険なタスクを遂行できますか?私たちがまだ考慮していないいくつかの方法が存在するかもしれませんが、マインドマップ、ベストイベント、またはツールの使用など、これらがモデルに非常に危険な行動をさせる可能性があるかどうか?」」
Jack Clark:「政策形成プロセスにおいて、これらの評価ツールは非常に役立ちます。なぜなら『セキュリティ』は非常に抽象的な概念であり、私が『このモデルを展開できるかどうかを決定する評価ツールがある』と言ったとき、政策立案者、国家安全専門家、そしてCBRN(化学、生物、放射線、核分野)の専門家と協力し、正確な評価基準を策定できます。具体的なツールがないと、このような協力は実現不可能かもしれません。しかし、明確な基準があると、人々は参加して精度を確保するのを喜んで手伝ってくれるでしょう。そのため、この点でRSPの役割は非常に重要です。」
Daniela Amodei:「私にとってもRSPは非常に重要であり、私の仕事によく影響を与えます。興味深いと思ったのは、私がRSPを考える方法が少し特殊で、もっと「トーン」に注目していることです。最近、私たちはRSPのトーンを大幅に調整しました。以前のトーンはあまりに技術的で、時には対立的にさえ感じられました。人々が参加することを望む体系をどのように構築するかを考えるのに多くの時間を費やしました。」
もしRSPが企業内の誰もが簡単に理解できる文書であれば、より良いでしょう。現在のOKR(Objective and Key Results)のようにです。たとえば、RSPの主な目標は何ですか?目標を達成したかどうかをどのように知るのか?現在のAIセキュリティレベル(ASL)は何ですか?ASL-2ですか、ASL-3ですか?重点を押さえるべきことを誰もが知っていれば、潜在的な問題を見つけやすくなります。逆に、RSPがあまりに技術的で理解できる人が少ないなら、実際の有用性はかなり低くなります。
RSPが、より理解しやすい方向に進化していることを見ることができてうれしいです。今では、会社のほとんどの人、おそらくは全員が、彼らの職種が何であろうとも、この文書を読み、そして「これは理にかなっている。AIを開発する際には、以下の原則に従うことを望んでおり、なぜこれらの問題に関心を持つ必要があるかも理解できます。仕事で問題が発生した場合、ほぼ何に注意すべきかを知るでしょう。」と感じるでしょう。私たちは、RSPを工場で働く人が「シートベルトをここに接続すべきだが、まだ接続されていない」と簡単に判断できるようなものにしたいと考えています。問題を早期に発見するためです。
重要なのは、円滑なコミュニケーションを図り、経営陣、取締役会、他の部署、そして実際の開発作業に従事するチームとの間で健全なフィードバックメカニズムを確立することです。私はほとんどの問題がコミュニケーションの不足や情報の歪みによって発生することが多いと考えています。これらの理由だけで問題が発生するのは非常に残念なことだと思いませんか?最終的に私たちがすべきことは、これらの概念を実践に移し、それらを誰もが理解しやすいようにしておくことです。
Anthropic の創立ストーリー
Sam McCandlish:「実際、私たち誰一人が最初から会社を設立する意思を持っていたわけではありませんでした。私たちは単に、これが私たちの責任であり、AI の発展が正しい方向に進むことを確保する唯一の方法であると感じ、それゆえに私たちがその約束をした理由です。」
Dario Amodei:「私の最初の考えは非常に単純でした。ある有益な方法で新しいものを発明し、探求することを望んでいただけでした。そのような考えが私をAI分野に導き、AIの研究には多大なエンジニアリングサポートが必要であり、最終的には多額の資金サポートも必要となります。」
しかし、会社を設立し、環境を管理するための明確な目標や計画がないと、多くのことが達成されるかもしれませんが、科学技術業界で私が疎外感を抱かせるものと同じ間違いを繰り返す可能性があります。これらの間違いはしばしば、同じ人々、同じ態度、同じ思考パターンから生じます。そのため、ある時点で、私たちはこれを新しい方法で行わなければならないと気づき、それはほぼ避けられないものでした。
Jared Kaplan:「私たちが大学院の頃を思い出してください。あなたは公益を促進するために科学研究を通じてどのように進めるかを探ろうとする完全な計画を持っていました。私にとって、それは現在の考え方と非常に似ています。あなたはその時、「Project Vannevar」というプロジェクトを持っており、それが目標でした。私はその当時教授であり、その状況を見てから、AIの影響力が非常に速いペースで拡大していると深く信じました。」
しかし、AI研究が資金の高い要求をしていることと、物理学の教授として、学術研究だけではこれらの進展を推進することができないと気づきました。信頼できる仲間と一緒に組織を立ち上げ、AIの発展が正しい方向に進むように確実にすることを望んでいました。しかし、正直なところ、私は他の誰かに会社を設立するよう勧め、そのような願望も一度もありませんでした。私にとって、それは単なる目標達成手段に過ぎませんでした。通常、成功の鍵は、世界に意義のある目標を実現したいと本当に思っており、その目標を達成する最良の手段を見つけることにあると信じています。
信頼文化の構築方法
Daniela Amodei:「私はチームとしての戦略的優位性をよく考えます。そのうちの1つが少し意外かもしれませんが、非常に重要な要素である高度な信頼です。大勢の人々に共通のミッションを持たせることは非常に困難ですが、Anthropicでは、我々はこのようなミッション感をますます多くの人々に成功裏に伝えることができます。このチームでは、リーダーシップ層とすべてのメンバーを含め、皆が共通のミッションに基づいて集まっています。私たちのミッションは明確で純粋であり、このような状況は科学技術業界においてはめったに見られるものではありません。」
私たちが達成しようと努力している目標は、純粋な意味で満ちていると感じます。私たち誰一人が企業を設立したいからという理由で始めたわけではありません。ただ、これをやらなければならないと感じたのです。以前の場所では仕事を前に進めることができないとわかり、これを成し遂げるためには自力でやらなければならなかったのです。
Jack Clark:「その時、GPT-3 の登場や私たち全員が関与したり触れ合ったりしたプロジェクト(スケーリング則など)により、2020 年には AI の発展の動向が明確になりました。行動を起こさなければ、すぐにも逆転不可能な臨界点に達する可能性があることに気づきました。環境への影響を与えるには、行動を起こさなければなりませんでした。」
Tom Brown:「Daniela の意見に同意したいと思います。チーム内には高い信頼関係が存在していると確信しています。私たち皆がこのチームに参加した理由は、世界に貢献したいからです。収入の 80% を社会的発展に貢献する取り組みに寄付することを約束しましたが、これは全員がためらいなく支持することで、「もちろん、そうします」という結論に至りました。このような信頼は非常に特別で珍しいものです。」
Daniela Amodei:「Anthropic は非常に政治的な色合いが薄い企業だと考えています。もちろん、私たちの視点は一般の人々とは異なるかもしれませんし、私もそれを常に心に留めています。採用プロセスやチームメンバーの特性により、ここでの文化は「オフィス政治」にほとんど自然な排斥感を持っています。」
Dario Amodei:「チームの結束力もまた非常に重要です。製品チーム、研究チーム、信頼とセキュリティチーム、マーケティングチーム、政策チームなど、全員が会社の共通目標に向けて努力しています。会社内の異なる部署が別々の目標を追求すると、混乱が生じやすくなります。自身の仕事を他の部署が妨害していると感じることは、非常に異常な状況です。」
私たちが達成した中で最も重要な成果の1つは、会社全体の一体性を維持することに成功したことです。このようなメカニズム(RSPなど)が重要な役割を果たしています。このメカニズムにより、会社内で問題を引き起こすのではなく修正しようとする部門があるのではなく、全ての部門が個々の役割を果たしつつ、統一された変革理論の枠組みの中で協力しています。
Chris Olah:「最初、私は OpenAI に参加したのは、そこが非営利組織であり、AI セキュリティ研究に注力できると考えたからです。しかし時間の経過とともに、このモデルが完全に自分に合っていないことに気づき、いくつかの困難な決定を迫られました。このプロセスで、私は Dario と Daniela の判断を非常に信頼していますが、去りたくはありません。AI 研究所をさらに増やすことが世界のためになるとは思わないからです。そのため、去ることに非常に躊躇しています。」
最終的に去る決定を下した際、私は会社を立ち上げることにはまだ慎重でした。以前は、セキュリティ研究に特化した非営利組織を設立すべきだと主張していました。しかし、最終的には現実的な姿勢と現実の制約への誠実な認識から、Anthropic を立ち上げることが私たちの目標を達成する最良の方法であると認識しました。
Dario Amodei:「私たちが初めに学んだ重要な教訓の1つは、約束を少なくし、約束を果たすことを重視することです。現実を保ち、優先順位を明確にし、信頼と評判は具体的な政策よりも重要であることを自覚することです。」
Daniela Amodei:「Anthropic の特筆すべき点は、チーム全体が高い信頼関係と統一感を持っていることです。たとえば、安全上の理由からある製品をリリースしないよう主張する Mike Krieger の姿を見る一方で、ビジネスニーズをバランスさせてプロジェクトを前進させる方法について話し合う Vinay を見ると、非常に特別な気持ちになります。さらに、技術セキュリティチームや推論チームのエンジニアも、製品が安全かつ実用的であることを確認するために議論しています。このような統一された目標と現実的な姿勢は、Anthropic の労働環境で最も魅力的な点の1つです。」
Dario Amodei:「健全な組織文化は、誰もが共通の優先事項となる優先順位を理解し、受け入れることができるということです。私たちの生きる世界は完璧ではなく、すべての決定にはさまざまな利害関係者の間でバランスを取る必要がありますが、そのバランスは常に完全に満足のいくものとは限りません。しかし、全体のチームが共通の目標に向かってこれらのバランスを共有し、各自が自身の立場から全体目標に寄与することができれば、それこそが健全なエコシステムとなります。」
Sam McCandlish:「ある意味、これは「アップヒル・バトル」です。はい、これは確かに「アップヒル・バトル」です。全くリスクのない選択肢ではありませんし、事がうまく運ぶ保証はありませんが、私たちは皆一致しています:「これが私たちの選択である」と。」
AIの最高峰を目指して
Jack Clark:「しかし、市場は根本的に実用的ですので、Anthropicが成功すればするほど、他の企業も成功の要因を模倣しようという動機に駆られます。また、私たちの成功がセキュリティ領域での実際の作業と密接に関連している場合、この成功は業界全体で一種の「引力」を生み出し、他の企業もこの競争に参加するよう促します。私たちがシートベルトを開発したように、他の企業も真似ることができる。これは健全なエコシステムです。」
Dario Amodei:「しかし、もし「この技術を開発しないし、他の誰よりも良い成果を出すことはできない」と言うのであれば、それではうまくいきません。なぜなら、現状から将来に至る経路が実現可能であることを証明していないからです。世界が必要としているのは、業界や個々の企業が、社会が「技術が存在しない」という状態から「技術が強力な形で存在し、社会が効果的に管理している」状態に移行する手段を見つけることです。この目標を達成する唯一の方法は、個々の企業レベル、そして最終的には全業界レベルで、これらのトレードオフに直面することです。」
競争力を維持し、業界をリードする分野もあって、技術の安全性を確保する方法を見つける必要があります。これを達成できれば、業界への魅力は非常に強力になります。規制環境から異なる企業に参加したい優秀な人材、さらには顧客の意見まで、これらすべての要因が業界を同じ方向に推進します。競争力を損なうことなく安全性を達成できると証明できれば、つまり双方に利益をもたらすソリューションを見つけることができれば、他の企業も刺激を受け、このアプローチを模倣するでしょう。
Jared Kaplan:「私は、このようなメカニズムが重要な理由の一つが、RSPのようなものであると考えています。私たちは技術の進化方向を明確に見極め、特定の問題に対して高い警戒を維持する必要があることを認識しますが、同時に、「狼が来た」と誤った警告を発することを避けなければなりません。イノベーションはここでストップすべきではないと単純に述べることはできません。AI技術が顧客に有益で、革新的で楽しい体験を提供できるようにする方法を見つける必要があり、同時に、システムの安全性を保証し、他の企業が安全な状態で成功を収め、私たちと競争できると確信させる制約条件を明確にしなければなりません。」
Dario Amodei:「数か月後、RSPを発表し、最も著名な3社のAI企業も同様のメカニズムを続々と導入しました。解釈可能性の研究は、私たちが突破した別の分野です。さらに、AIセキュリティ研究機関と協力し、この包括的な安全への関心が大きな影響を及ぼしています。」
Jack Clark:「はい、Frontier Red Team はほぼ直ちに他の企業によって模倣されました。これは良いことです。私たちはすべてのラボが潜在的なハイリスクのセキュリティ脆弱性をテストすることを望んでいます。」
Daniela Amodei:「Jack は以前にも言及しましたが、顧客もセキュリティの問題を非常に重視しています。顧客は、モデルが誤った情報を生成することを望んでおらず、モデルがセキュリティ制限を簡単にバイパスされることを望んでいません。彼らはモデルが有用であり、無害であることを望んでいます。私たちは顧客とのコミュニケーションの中でよく、「私たちは Claude を選択しました、なぜならそれがより安全だと知っているからです。」という言葉を聞きます。私は、これが市場に与える影響が非常に大きいと考えています。私たちは信頼できるモデルを提供できるため、競合他社にもかなりの市場圧力をかけています。」
Chris Olah:「たぶん、Dario の意見をさらに掘り下げることができるかもしれません。ある考え方では、最も倫理的な行動は「高貴な失敗」であると言われています。つまり、安全性のために他の目標を犠牲にすべきであり、安全に焦点を合わせて現実的ではない方法で行動することで、自分のビジネスに対する純粋さを示すべきだとされています。しかし、私はこの方法は実際には自己崩壊を招くものだと考えています。」
まず、この方法は安全を重視せず、安全を優先しない人々の手に意思決定権を委ねることにつながります。一方、もしもあなたが激励のメカニズムを整合させ、困難な決定を支持する力のある場所に配置し、最も強力な証拠に基づいて行動を起こす方法を模索するならば、Dario が表現した「アップリフティングコンペティション」を引き起こすことができます。このコンペティションでは、安全を心掛ける人々が蚊帳の外に追いやられるのではなく、他の人々があなたの歩みに追随せざるを得ず、この競争に参加することを余儀なくされます。
人工知能の将来展望
Jack Clark:「では、次に私たちが進めるべきことについて、皆さんは何に興奮していますか?」
Chris Olah:「私は説明可能性に興奮している理由がたくさんあると思います。明らかなのはセキュリティの観点ですが、もう1つの理由は、感情的な面で、私にとって同様に興奮や重要性を感じさせるものがあると思います。それは、私が神経ネットワークを非常に美しいと感じるからであり、神経ネットワークには私たちがまだ見ぬ美がたくさんあると思うからです。私たちは常に神経ネットワークをブラックボックスとして扱い、その内部構造には特に関心を持っていませんが、それらを詳しく調査し始めると、その内部には驚くべき構造が満ちています。」
これは、人々が生物学を見るときの態度に少し似ています。何人かは、「進化はつまらないもので、単なるプロセスに過ぎず、非常に長い時間がかかっただけで動物が創造された」と考えるかもしれません。しかし、実際には進化によって生み出されたそれぞれの動物には驚くほどの複雑さと構造があります。そして私は、進化は最適化プロセスであり、神経ネットワークをトレーニングすることと同様です。神経ネットワークの内部にも、まるで「人工生物学」に似た複雑な構造があります。それらを詳しく調査する意欲があれば、驚くべき発見がたくさんあることを見出すでしょう。
私は、私たちがそのベールをゆっくりと取り払い始めたばかりだと感じています。それは信じられないほどであり、私たちが発見するために待っているものがたくさんあります。私たちはその扉を開くのを始めたばかりであり、次に何を発見するかは非常に興奮させられると思います。時々、私は10年後に書店に入り、ニューラルネットワークの説明可能性に関する教科書や、ニューラルネットワークの「生物学」について本当の話を買うのを想像します。その本には驚くべきことがたくさん書かれているでしょう。私は、将来の10年、または数年以内に、私たちはこれらのことを本当に発見し始めるだろうと信じています。それは狂気で驚くべき旅になるでしょう。
Jack Clark: 「数年前、誰かが言った:『政府がAIシステムをテストおよび評価するための新しい機関を設立し、これらの機関が非常に専門的で機能するであろう。』ならば、それを信じなかっただろう。しかし、それは現実となりました。政府はこの新しい技術カテゴリに対処するための「新しい大使館」を構築したと言えるでしょう。これがどこに向かうかを見るのを楽しみにしています。私にとって、これは実際には国家がこのような社会的変革に対処する能力を意味し、企業に頼るだけでないことを、私は嬉しく思っています。参加できることをうれしく思います。」
Daniela Amodei: 「私は今、これに興奮していますが、将来のAIが人類のために何ができるかを想像するだけでも興奮してしまいます。たとえば、Claudeがワクチン開発やがん研究、生物学研究を支援する兆候をもう既に見ることができ、それは信じられないことです。現時点でClaudeができることを見るだけでも、驚くべきことです。そして、私が未来の3〜5年を展望すると、Claudeが本当に多くの根本的な問題、特に健康分野で、多くの人類が直面している問題を解決できるようになることを想像すると、私は非常に興奮します。私は国際開発の仕事に従事していた日々を振り返ると、当時Claudeが私の極めて時間がかかる仕事を手伝っていたなら、それはどれほど驚くべきことでしょうか。」
Tom Brown: 「個人的な観点から言えば、私は仕事でClaudeを使うのがとても好きです。最近では、家でも頻繁にClaudeと話をするようになり、最近の最大の変化はコーディングです。6ヶ月前、私はまだClaudeでプログラミング関連の仕事をしていませんでしたし、私たちのチームもそれまでClaudeをコーディングに使うことはほとんどありませんでしたが、現在は状況が大きく変わりました。たとえば、先週私はY Combinatorが主催したイベントでプレゼンテーションをしました。最初に、私はみんなに尋ねました:『現在、どれくらいの人がClaudeを使ってプログラミングしているか?』その結果、ほぼ95%の人が手を挙げました。ほとんどの人が手を挙げ、それは4ヶ月前とは全く異なる状況でした。」
Dario Amodei:「私がワクワクすることを考えるとき、以前に言及したもののような、すでに合意が形成されているように見えるが実際にはすぐに覆される可能性がある領域を思い浮かべます。その一つが説明可能性です。私は、説明可能性がAIシステムの安全性を導くだけでなく、知能最適化の問題や人間の脳の仕組みに関する深い理解を含んでおり、将来Chris Olahがノーベル医学賞を受賞するだろうと述べたことがあります。」
かつて私は神経科学者であり、私たちが解決していない精神疾患の多く、例えば統合失調症や感情障害などは、ある種の高次のシステムの問題と関連していると疑っています。しかし、人間の脳の複雑さと直接研究が困難な特性のため、これらの問題は完全に理解するのが難しいです。一方、ニューラルネットワークは完璧なアナロジーではありませんが、脳と同様に解析や相互作用が難しいという点ではありません。時間の経過とともに、ニューラルネットワークはより良いアナロジーツールとなるでしょう。
別の関連分野は、生物学におけるAIの応用です。生物学は極めて複雑な問題であり、多くの理由から人々はそれに対して依然として疑念を持っていますが、私はこのような疑念が崩れつつあると考えています。我々は化学分野のノーベル賞がAlphaFoldに授与されたことを目撃しており、これは素晴らしい成就です。私たちは何百もの「AlphaFold」を生み出すのに役立つツールの開発に努めるべきです。
最後に、民主主義を強化するためにAIを活用すること。AIが誤った方向に進化すれば、独裁主義の道具となる可能性があることを懸念しています。では、AIを自由と自己決定を促進するツールにするにはどうすればよいでしょうか?この分野の発展は、前述の2つの分野よりも前に進展する可能性がありますが、その重要性は全く劣りません。
Jared Kaplan:「私は、少なくとも2つの点であなたの前の意見と一致する考えがあると思います。一つは、多くの人がAnthropicに参加した理由の一つが、彼らがAI科学に非常に興味を持っていることだと考えているからです。AI技術の進歩とともに、彼らは技術の発展を推進するだけでなく、より深く理解し、その安全性を確保する必要性を徐々に認識してきました。AIの進化と責任に関する共通のビジョンを持つ人々と一緒に働けることは、非常にワクワクすることです。過去1年で行われた多くの技術進歩は、この共通の理解の形成を推進してきたと思います。」
もう一つの点は、具体的な問題に戻ると、AIセキュリティに関しては、既に多くの取り組みが行われていると感じています。しかし、最近のいくつかの展開により、非常に高度なシステムがもたらすかもしれないリスクについて初歩的な理解を持つようになりました。これにより、説明可能性の研究や他の種類のセキュリティメカニズムを通じて、これらのリスクを直接研究し調査することが可能になりました。
この方法により、私たちは高度なAIシステムがもたらす可能性のあるリスクをより明確に把握することができます。これにより、より科学的かつエビデンスに基づいた方法で私たちの使命を推進することができます。したがって、私は今後6ヶ月間に非常に興奮しています。高度なシステムの潜在的な問題に対する理解を活用し、さらに研究を進め、これらの罠を回避する方法を見つけ出す予定です。
BlockBeats の公式コミュニティに参加しよう:
Telegram 公式チャンネル:https://t.me/theblockbeats
Telegram 交流グループ:https://t.me/BlockBeats_App
Twitter 公式アカウント:https://twitter.com/BlockBeatsAsia