

Vitalikの最新の長文:AIの時代、コードがどのようにより安全になるか?
原文タイトル:形式検証に浅く入る
原著者:Vitalik
翻訳:Peggy,BlockBeats
編集者注:AIのプログラミング能力が急速に向上する中、ソフトウェアセキュリティは新たな逆説に直面しています。AIはコードを効率的に生成するだけでなく、脆弱性も効率的に見つけ出すことができます。暗号通貨業界にとって、この問題は特に重要です。スマートコントラクト、ZKプルーフ、合意アルゴリズム、およびオンチェーン資産システムに欠陥があると、通常のソフトウェアのエラーではなく、不可逆的な資金損失と信頼の崩壊が起こります。
Vitalikがこの記事で議論しているのは、AI時代のコードセキュリティのもう一つの方法論である形式検証です。要するに、これは人間の監査者によるコードの行ごとのチェックに依存せず、プログラムが満たすべき性質を数学的な命題として書き、それらの性質が成立しているかどうかを機械が検証可能な証明で検証するものです。過去、形式検証は閾値が高く、プロセスが煩雑なため、比較的マイナーな研究およびエンジニアリング分野に留まっていました。しかし、AIがコードの作成および証明の支援を行うようになると、この手法は再び実用的な意味を持ち始めています。
この記事の中心的な判断は「形式検証がすべてのセキュリティ問題を解決できる」というものではありません。それどころか、Vitalikは繰り返し、「証明可能なセキュリティ」は絶対的な安全を意味するわけではないことを強調しています。証明には重要な仮定が抜け落ちる可能性があり、仕様自体が誤って記述されている可能性があり、検証されていないコード、ハードウェアの境界、およびサイドチャネル攻撃が新たなリスク源となる可能性があります。しかし、それでも、それはより信頼性の高いセキュリティパラダイムを提供しています:開発者の意図をさまざまな方法で表現し、システムにそれらの表現が互換性があるかどうかを自動的に確認させることです。
これはイーサリアムにとって非常に重要です。将来のイーサリアムは、STARK、ZK-EVM、量子耐性署名、合意アルゴリズム、および高パフォーマンスEVM実装を含む、より複雑なローエンドコンポーネントにますます依存するでしょう。これらのシステムの実装は非常に複雑ですが、そのコアセキュリティ目標は比較的明確に形式化されることが多いです。また、この種のシナリオでは、AIが形式検証を補助することで最大の価値を発揮できる可能性があります:AIに効率的なコードと証拠を記述させ、人間により、最終的に証明された命題が本当に自身が望んでいるセキュリティ目標に対応しているかどうかを確認させることです。
より広い視点から見ると、この記事はVitalikがAI時代のネットワークセキュリティに対する一つの回答であるとも言えます。より強力なAI攻撃者に直面しても、答えはオープンソースを放棄したり、スマートコントラクトを放棄したりすることではなく、重要なシステムをより小さく、より検証可能で、より信頼性の高い「セキュリティコア」に集約することです。AIは荒れたコードを大量に生み出すかもしれませんが、かつて以上に本当に重要なコードをより安全にします。
以下为原文:
特に Yoichi Hirai、Justin Drake、Nadim Kobeissi、Alex Hicks に、本文へのフィードバックとレビューを提供していただいたことに感謝します。
過去数ヶ月、新しいプログラミングパラダイムが急速にエフェリアムの研究開発コミュニティや他の多くの計算分野で台頭しています。開発者は、EVM バイトコード、アセンブリ言語などの非常に低レベルの言語を直接使用するか、Lean でコードを記述し、Lean で自動的に検証可能な数学的証明を行うことによって、コードを記述しています。
適切に活用すれば、この方法は非常に効率の良いコードを生成し、従来のソフトウェア開発方法よりも安全になる可能性があります。そして、これを Yoichi Hirai は「ソフトウェア開発の究極の形態」と呼んでいます。本文では、この手法の背後にある基本的な論理を説明しようとします。つまり、ソフトウェアの形式的検証が何を行うことができるのか、その欠点や境界は何か——それがエフェリアムの文脈でも、より広範なソフトウェア開発領域でも。
形式的検証とは何ですか?
形式的検証とは、機械が自動的に検証できる方法で、数学的な定理の証明を記述することを指します。
比較的単純でありながら興味深い例を挙げるために、フィボナッチ数列に関する基本定理を考えてみましょう:3 つの数のうち 1 つは偶数で、残りの 2 つは奇数である。
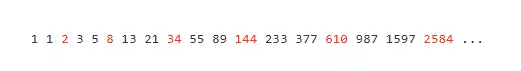
簡単な証明方法は、数学的帰納法を使用して、3 つの数を順番に進めることです。
まず基底ケースを見てみましょう。F1 = F2 = 1、F3 = 2 とします。直接観察すると、この主張——「i が 3 の倍数のとき、Fi は偶数であり、それ以外の場合、Fi は奇数である」—— は x = 3 まで成立しています。
次に帰納ステップです。この主張が 3k+3 の前まで成り立っていると仮定します。つまり、F3k+1、F3k+2、F3k+3 がそれぞれ奇数、奇数、偶数であることがわかっています。したがって、次の 3 つの数の奇偶性を計算できます:
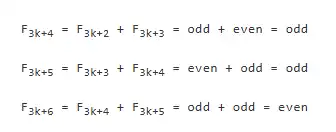
これにより、「3k+3 の前で主張が成り立っていることがわかる」という前提から、「3k+6 の前でも主張が成り立つことを確認する」推論が完成します。この推論を繰り返し行うことで、この法則がすべての整数について成立していることを確信できます。
この主張は人間にとって説得力があります。しかし、もしもあなたが証明したいことが100倍も複雑であり、そして自分が間違いを comfirm したくなるなら、どうすれば良いでしょうか?この場合、コンピューターも納得する証明を構築できます。
それは大まかに次のようなものです:
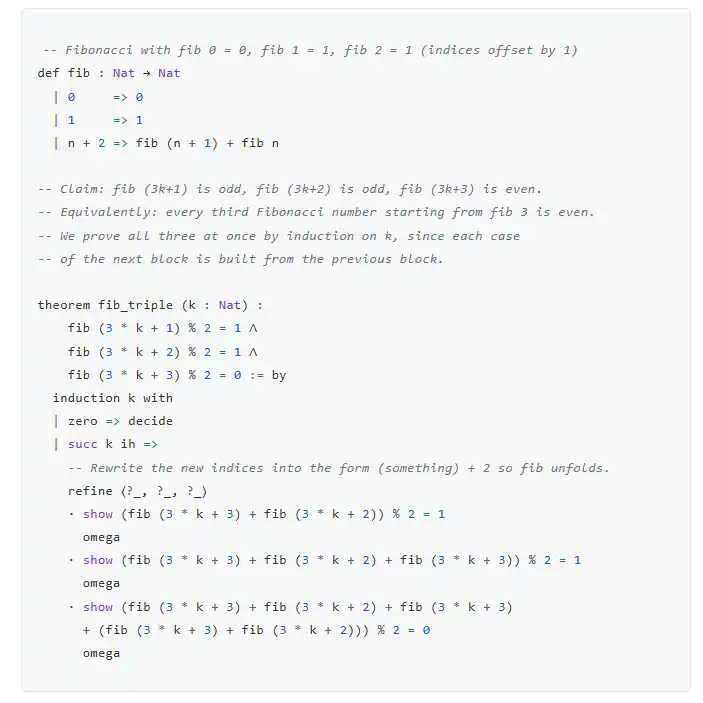
これは同じ論法ですが、Lean で表現されています。Lean は数学の証明を書くためによく使用されるプログラミング言語です。
これは先ほどの「人間版」証明とは非常に異なりますが、その背後には非常に重要な理由があります。コンピューターにとって直感的なものと、人間にとって直感的なものはまったく異なります。ここで言及しているコンピューターは、従来の「コンピューター」を指し、if/then ステートメントで構成される「決定論的」プログラムであり、大規模言語モデルではありません。
上記の証明では、fib(3k+4) = fib(3k+3) + fib(3k+2) という事実を強調していません。強調しているのは、fib(3k+3) + fib(3k+2) が奇数であることであり、Lean の大きな名前 omega tactic はこの点を自動的に fib(3k+4) への理解と組み合わせます。
より複雑な証明では、時々、どの数学的法則がこのステップを踏むことを許可しているのかを明確にし、これらの法則は時々 Prod.mk.inj などという難解な名前が付いています。ただし、一方で、巨大な多項式式を展開し、一行の omega や ring などといった式を書くだけで、証明を完成させることができます。
ここでの非直観性と煩雑さは、機械可読証明が約60年間存在しているにもかかわらず、マイナーな分野に留まっている重要な理由です。しかし、同時に、AI の急速な進歩によって、過去にはほとんど不可能だった多くのことが急速に実現しつつあります。
コンピュータープログラムの検証
ここまで来ると、あなたはおそらく考えるでしょう:つまり、数学の定理の証明をコンピューターに検証させることができるので、ついに私たちは、素数についてなどの狂気の新しい発見を、100ページ以上の PDF 論文に隠れている誤りと区別し、望月新一のABC予想に関する証明が正しいかどうかを明らかにできるかもしれません!しかし、好奇心を満たす以外に、これには実用的な意味があるのでしょうか?
答えはさまざまです。そして、私にとって非常に重要な答えの1つは、コンピュータープログラムの、特に暗号化やセキュリティに関連するプログラムの正確性を検証することです。結局、コンピュータープログラム自体が数学の対象です。したがって、コンピュータープログラムがある方法で実行されることを証明することは、本質的には数学定理を証明することです。
例を挙げると、Signal などの暗号化通信ソフトウェアが本当に安全かどうかを証明したいとします。ますます、数学的な方法で明確に書きとめ、この文脈において「安全」とは具体的に何を意味するのかを示すことができます。要するに、証明すべきことは次の通りです:特定の暗号学的仮定が成立する条件下、秘密鍵を持つ人だけがメッセージ内容に関する情報を知ることができます。現実には、真に重要なセキュリティ属性はさまざまあります。
そして実際に、この問題を解明しようとしているチームがすでに存在することが証明されています。彼らが提示したセキュリティ定理の1つは、おおよそ次のようなものです:
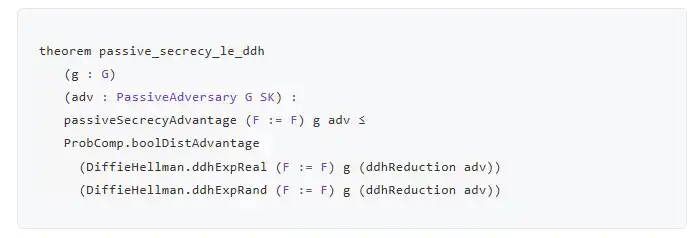
以下は Leanstral がこの定理の意味についてまとめたものです:
passive_secrecy_le_ddh 定理は、ランダムオラクルモデル (Random Oracle Model) の下で、X3DH の受動的なメッセージ機密性が、少なくとも DDH 仮定と同じくらい攻撃が困難であることを示す緻密還元(tight reduction)です。
言い換えれば、攻撃者が X3DH の受動的なメッセージ機密性を破ることができる場合、彼らは同様に DDH を破ることができます。DDH は通常、困難な問題と見なされるため、X3DH も受動的攻撃に耐えうると見なすことができます。
この定理は、もし攻撃者が Signal の鍵交換メッセージを受動的に観察するしかない場合、それらは最終的に生成されたセッション鍵をランダム鍵から区別する優位性を無視できる確率を超えて引き下げることができないことを示しています。
さらに AES 暗号が正しく実装されていることを証明することで、あなたは次のような証明を得ることができます:Signal プロトコルの暗号化メカニズムは受動攻撃者に対して耐性を持っている。
同様の検証プロジェクトはすでに存在し、TLS および他のブラウザ内の暗号コンポーネントの安全な実装を証明しています。
エンドツーエンドの形式化検証が可能であれば、検証されるのは単にプロトコルの理論的な安全性だけでなく、ユーザーが実際に実行する特定のコードが実践上安全であることです。ユーザーの観点からは、これにより「信頼が不要」のレベルが大幅に向上します:このコード全体を行単位で検査する必要はありません。すでに証明された主張だけを確認すればよいのです。
もちろん、ここには非常に重要な注釈がいくつかあります。特に、何を意味するかについての「セキュリティ」というキーワードに関してです。人々は、本当に重要な主張を証明することを忘れがちであり、証明する必要のある主張が、コードそのものよりも簡潔な説明方法が存在しない場合もあります。また、証明中に最終的に成立しない前提条件をこっそり導入してしまう可能性もあります。システム内の特定の部分だけが形式的に証明される必要があると判断することが容易ですが、最終的には他の部分、さらにはハードウェアレベルで致命的な脆弱性が発生する可能性があります。Lean の実装自体にもバグが存在する可能性があります。しかし、これらの頭痛の種の議論に入る前に、もう少し深く考えてみましょう:形式化検証が理想的かつ正しく行われた場合、どのようなほぼユートピア的な展望をもたらす可能性があるか。
セキュリティ志向の形式検証
コンピュータコード内のバグは元々心配事です。
暗号通貨を不変のブロックチェーンスマートコントラクトに入れると、コードのバグはさらに恐ろしいものになります。なぜなら、コードが誤っていると、北朝鮮のハッカーが自動的にあなたのお金をすべて奪ってしまう可能性があり、ほとんど追及手段がありません。
さらに、ゼロ知識証明でこれらすべてが包まれると、コードのバグはさらに恐ろしいものになります。なぜなら、誰かがゼロ知識証明システムを破った場合、彼らはすべての資金を引き出すことができ、どこが問題であるかを完全に把握していないかもしれないし、さらに悪いことには、問題が発生していること自体に気づいていない可能性さえあります。
強力なAIモデルを持つと、コードのバグはさらに恐ろしいものになります。たとえば、Claude Mythosのようなモデルは、2年の改善を経て、これらの脆弱性を自動的に発見できる可能性があります。
ある人々はこの現実に直面し、スマートコントラクトという基本的な概念を放棄し、さらには、ネットワーク空間が攻撃者に対して防御側が非対称の優位性を持つことは不可能だとさえ考えています。
以下はいくつかの引用です:
システムを強化するには、脆弱性を発見するために投入するトークン量が、その脆弱性を利用するために投入されるトークン量よりも多くである必要があります。
また、次のように述べられています:
私たちの業界は、決定論的コードを軸に構築されています。コードを書く、テストする、リリースする、それからそれが正常に動作することを知る——しかし私の経験から言えば、この契約は効力を失いつつあります。真のAIネイティブ企業のトップ運用者において、コードベースはある種の「それが動くと信じている」ものに変わりつつあり、その信頼に対応する確率はもはや正確には記述できなくなっています。
さらに悪いことに、唯一の解決策はオープンソースを放棄することだと考える人もいます。
これは、ネットワークセキュリティにとって暗い未来となります。特に、インターネットの分散化と自由を心配している人々にとって、非常に暗い未来となるでしょう。全体的なサイバーパンク精神は、本質的に、インターネットにおいて防御側が有利であるという考え方に基づいています。デジタル「城」を構築すること——暗号化、署名、または証明として具体化するかに関係なく——を破壊するよりも簡単です。この原則を失った場合、インターネットセキュリティは、経済規模から、潜在的な攻撃者を全世界で追跡することから、より一般的には、ある種の二者択一から来るでしょう:すべてを支配するか、破滅に向かうか。
私はこの判断に同意しません。ネットワークセキュリティの未来について、私はより楽観的なビジョンを持っています。
私は、強力な AI バグ検出能力がもたらす挑戦は確かに厳しいものですが、それは過渡的な挑戦です。埃が落ち着き、私たちが新しいバランスに入った後、私たちは過去よりも防御側に有利な状態に到達します。
Mozilla もこれを認めています。彼らの言葉を引用します:
おそらくは、このタスクに持続的で集中的な取り組み方をするために他のすべての事柄の優先順位を再配置する必要があるかもしれません。しかし、トンネルの先には光が射しています。私たちは、チームがこの挑戦に立ち向かう姿勢を誇りに思っており、他の人々もそうするでしょう。私たちの仕事はまだ完了していませんが、我々は転換点を迎え、ただ追いつくだけでない、より良い未来が見え始めています。防御側はついに決定的な勝利を収めるチャンスを得ました。
……
欠陥の数は有限であり、我々はそれらすべてを見つけられるようになりつつあります。
今、もしあなたが Mozilla のこの記事内で Ctrl+F で「formal」と「verification」を検索すると、どちらの単語も見つからないことに気づくでしょう。ネットワークセキュリティの前向きな未来は、厳密に形式化検証に依存するわけではなく、また他の任意の単一の技術にも依存しません。
それは何に依存しているのでしょうか?基本的に、以下の画像に示されているものです:
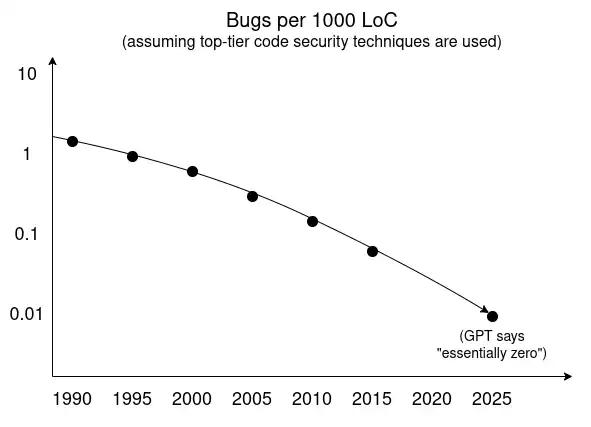
過去数十年間、多くの技術が「欠陥数の減少」という傾向を推進してきました:
タイプシステム;
メモリセーフな言語;
ソフトウェアアーキテクチャの改善、サンドボックス、権限メカニズム、および一般的に信頼できる計算基盤と他のコードを明確に区別すること;
より良いテスト手法;
セキュアコーディングパターンの知識蓄積;
事前に書かれ、監査されたソフトウェアライブラリの増加。
AI による形式化検証は、新しいパラダイムではなく、進行中の傾向とパラダイムを加速する強力な促進剤として見るべきです。
形式化検証は万能ではありません。しかし、特定のシナリオでは特に適しています:具体的な実装よりも目標が単純な場合です。これは、Ethereum の次の主要アップデートで展開する必要があるいくつかの最も困難な技術に関して特に顕著であり、量子耐性署名、STARK、コンセンサスアルゴリズム、ZK-EVM などです。
STARK は非常に複雑なソフトウェアです。しかし、その実装する核心セキュリティプロパティは非常に理解しやすく、形式化しやすいです。証明がプログラム P、入力 x、および出力 y のハッシュ H を指す場合、それは STARK が使用するハッシュアルゴリズムが破られたことを意味するか、P(x) = y であることを意味します。そのため、Arklib プロジェクトが生まれ、形式検証された STARK 実装を作成しようとしています。別の関連プロジェクトに VCV-io があり、さまざまな暗号プロトコルに形式検証が適用できる基盤的なオラクル計算インフラストラクチャを提供し、その多くはプロトコル自体も STARK の依存コンポーネントです。
さらに野 ambizioni なプロジェクトは evm-asm です。これは完全な EVM 実装を構築し、その形式検証を試みるプロジェクトです。安全特性はここではそんなに明確ではありません。要するに、その目標は、この実装が Lean で記述された別の EVM 実装と等価であることを証明することです。そして後者は、具体的な実行効率を考慮しないで、直感的で読みやすい性質をできるだけ追求します。
もちろん、理論上ではまだ、次のような状況が起こり得ます:私たちの EVM 実装が 10 個あり、それらが互いに等しいことが証明されていますが、それらがすべて同じ致命的欠陥を共有しており、その欠陥は攻撃者が許可されていないアドレスからすべての ETH を引き出すことができるようにするものです。ただし、特定の EVM 実装のみがこのような欠陥を持っている場合と比較して、この事態が発生する可能性ははるかに低いです。また、より広範な実験を経て、その重要性に本当に気づくのは、DoS 耐性というもうひとつの特性です。そのような特性は比較的簡単に明確に定義できます。
さらに、2 つの重要な方向性があります:
ビザンチンフォールトトレランス。この方向では、すべての期待されるセキュリティプロパティを形式的に定義することも簡単ではありません。しかし、関連するバグが非常に一般的であったため、形式検証の試みはまだ価値があります。したがって、現在、Lean による合意実装とその証明に関するいくつかの作業が進行中です。
スマートコントラクトプログラミング言語。関連する例には、Vyper および Verity での形式検証作業が含まれます。
これらすべてのケースで、形式検証によってもたらされる巨大な付加価値の 1 つは、これらの証明が真にエンドツーエンドであることです。最も困難なバグの多くは、しばしば相互作用するバグであり、それらは分割して考慮された 2 つのサブシステムの境界で発生します。人間にとっては、システム全体をエンドツーエンドで推論するのは非常に困難ですが、自動化された規則チェックシステムはそれを実珵することができます。
効率を考慮した形式検証
次に evm-asm を見てみましょう。これは EVM 実装です。
しかし、これは RISC-V アセンブリ言語で直接書かれた EVM 実装です。
文字通りアセンブリ言語です。
以下は ADD オペコードです:
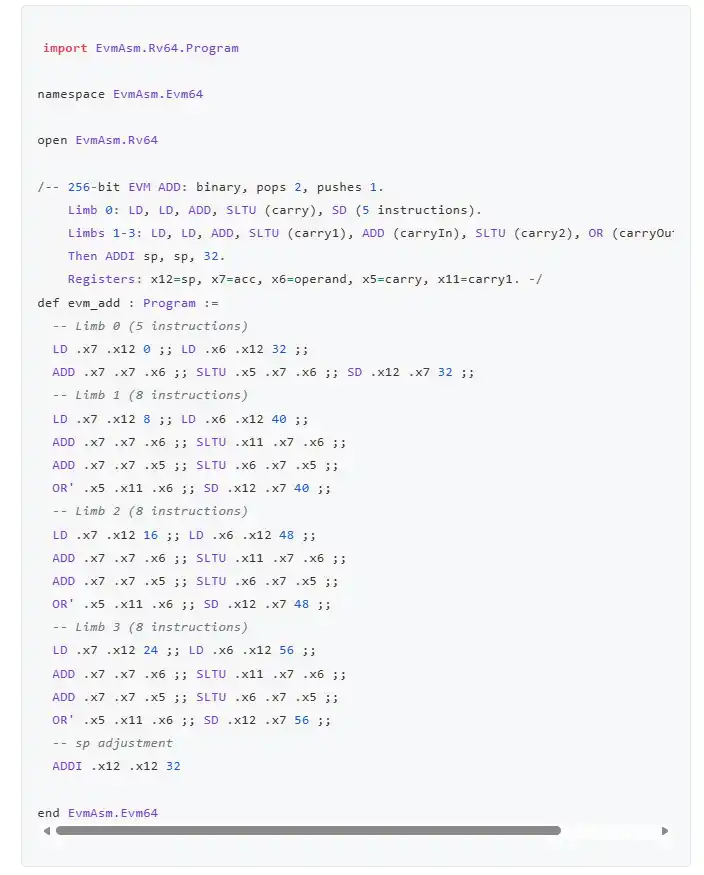
RISC-V を選択した理由は、現在構築中の ZK-EVM プルーバーが通常 RISC-V をプルーフし、Ethereum クライアントを RISC-V にコンパイルして動作することです。そのため、RISC-V を使用して EVM 実装を直接行うと、理論上、得られる最速の実装になるはずです。RISC-V は通常のコンピュータ上で非常に効率的にシミュレート実行できるほか、RISC-V ノートパソコンもすでに存在しています。もちろん、真にエンドツーエンドを達成するには、RISC-V 実装自体またはプルーバーの算術表現を形式化検証する必要があります。しかし、心配することはありません。そのような作業はすでに存在しています。
コードを直接アセンブリ言語で書くことは、50 年前によく行われていたことです。その後、段階的に高水準言語でコードを書くようになりました。高水準言語はある程度の効率を犠牲にしますが、その代わりにコードの記述速度がはるかに速くなり、さらに重要なのは他者のコードを理解する速度がはるかに速くなることです。そして、これはセキュリティにとって必須の条件です。
形式化検証と AI の組み合わせにより、「未来に戻る」機会が得られます。具体的には、AI にアセンブリコードを書かせ、その後、形式的なプルーフを書いて、これらのアセンブリコードが望ましいプロパティを持っていることを検証します。少なくとも、この目標プロパティは、可読性を重視し、ある種の人間にとって分かりやすい高水準言語で最適化された実装と完全に等価であることです。
このようにすると、1 つのコードオブジェクトが可読性と効率のバランスをとる必要がなくなります。2 つの明確に異なるオブジェクトを持つことになります。1 つは効率向上のために最適化され、特定の実行環境の要件に基づいて調整されたアセンブリ実装であり、もう1 つはセキュリティ主張または高水準言語の実装であり、可読性を重視しています。そして、その 2 つの間の同等性を数学的に証明します。ユーザーは最初にその証明を自動的に検証し、その後は高速バージョンを実行するだけで済みます。
これは非常にパワフルです。Yoichi Hirai はこれを「ソフトウェア開発の究極の形態」と表現しましたが、その理由があります。
形式化検証は万能ではありません
暗号学やコンピュータサイエンスでは、形式化手法自体とほぼ同じくらい古い伝統があります:形式化手法を批判すること、またはもっと広く、「証明」への依存を批判すること。関連文献には、多くの実践例があります。最初に取り上げるのは、暗号学の初期の手書きの証明です。Menezes と Koblitz は 2004 年にこれを批判しました。
1979 年、Rabin は、暗号化関数を提案し、「証明可能な」安全性を持つとされ、つまり、一種の帰着的安全性を持つとされた。
帰着的安全性とは、暗号文 y からメッセージ m を見つけ出すことができる者は、n も分解できなければならない、と主張するものである。
Rabin がその暗号化方式を提案して間もなく、Rivest は、皮肉なことに、その追加のセキュリティ機能をもたらす要素が、別の種類の攻撃者に対しては、システムを完全に破壊する可能性があることを指摘した。「選択暗号文」攻撃者と呼ばれるこの攻撃者を考える。具体的には、攻撃者がある方法で Alice に攻撃者が選択した暗号文を復号させるよう誘導できる場合、攻撃者は上記の Sam が使用した手順に従って n を分解できる。
Menezes と Koblitz がその後いくつかの例を挙げた。それらは共通のパターンを示し、つまり、暗号プロトコルを「証明しやすくする」ためにデザインすることは、プロトコルを「自然でない」ものにし、設計者が考慮していないシナリオで崩壊しやすくする可能性が高まる。
さて、機械可読プルーフとコードに戻りましょう。以下は 2011 年の論文からの例で、著者が形式的に検証された C コンパイラでバグを発見した内容です:
我々が発見した CompCert の2番目の問題は、2つのバグに現れます。これら2つのバグは次のようなコードを生成します:stwu r1, -44432(r1)
ここで、非常に大きな PowerPC スタックフレームが割り当てられています。問題は、16ビットのオフセットフィールドがオーバーフローしている点にあります。CompCert の PPC セマンティクスは、この即値の幅に対する制約を規定していません。それは、アセンブラが範囲外の値を検出することを前提としています。
2022 年の論文を見てみましょう:
CompCert-KVX において、commit e2618b31 が1つのバグを修正しました:「nand」命令が「and」と表示されてしまう問題。そして、「nand」は、稀な ~(a & b) パターンでのみ選択されるべきです。このバグは、コンパイル時にランダムなプログラムで発見されました。
本日、つまり2026 年に、Nadim Kobeissi は、Cryspen でソフトウェアの形式検証の欠陥を説明する際に次のように述べました:
2025 年 11 月、Filippo Valsorda は、libcrux-ml-dsa v0.0.3 が同じ決定論的入力で異なるプラットフォームで異なる公開鍵と署名を生成することを独立して報告しました。このバグは、SHA-3 の Keccak-f 置換に使用される XAR 操作を実装した _vxarq_u64 組み込み関数ラッパーにあります。フォールバックパスは、シフト操作に誤ったパラメーターを渡すため、ハードウェア SHA-3 サポートがない ARM64 プラットフォームで、SHA-3 ハッシュが破壊されます。これは型 I エラーです:この組み込み関数は検証済みとしてマークされていましたが、NEON バックエンド全体はランタイムセキュリティまたは正当性のプルーフを完了していません。
また:
libcrux-psq クレートは、後量子鍵共有鍵協定を実装しています。decrypt_out メソッド内では、AES-GCM 128 復号化パスが復号化結果に .unwrap() を適用し、エラーを透過させずに処理します。異常な暗号文がプロセスをクラッシュさせる可能性があります。
上記の4つの問題は、2つのカテゴリに分類されます:
1つ目は、一部のコードのみが検証されているために、他の部分の検証が困難であるというものです。結果として、検証されていないコードが、著者が想定していたよりもバグが出やすく、またこれらのバグはより致命的であることがよくあります。
2つ目は、著者が重要な属性を明示的に規定することを忘れた場合であり、本来検証される必要があった属性を忘れたというものです。
Nadim の記事では、形式検証の失敗モデルが分類されており、他の失敗タイプも挙げられています。例えば、別の主要なタイプとしては、形式化された仕様自体が間違っているか、証明に誤った主張が含まれているが、それが構築されたシステムによって静かに受け入れられている場合があります。
最後に、ソフトウェアとハードウェアの境界で起こる形式検証の失敗を見てみましょう。ここでの一般的な問題の1つは、検証システムがサイドチャネル攻撃に耐えられるかどうかです。メッセージを理論上完全に安全な暗号方式で保護しても、数メートル先の人が電気的な揺らぎをキャプチャし、何十万回もの暗号化の後にあなたの秘密鍵を取り出すことができるなら、あなたはまだ安全ではありません。
「差分パワー分析」(differential power analysis)は、この種の技術の中で、今では十分に理解されている例です。
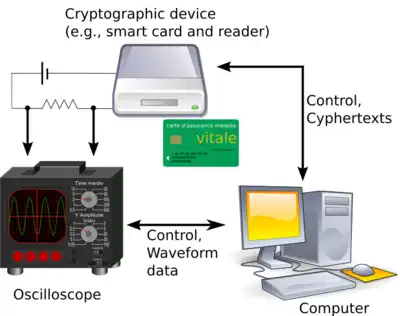
差分パワー分析は一般的なサイドチャネル攻撃の1つです。出典:Wikipedia
過去にも、このような攻撃に耐えられることを証明しようとする試みがありました。しかし、そのような証明は攻撃者に関する数学モデルを必要とし、そのモデルの下で安全性を証明する必要があります。時には、「d-プロービングモデル」が使用されることがあります。つまり、攻撃者が探査できる回路内の位置に上限があると仮定するものです。しかしながら、このようなモデルではいくつかの漏洩形式が捉えられないことがあります。
本記事で触れられている一般的な問題の1つは、「推移的な漏洩」(transitional leakage)です。もし観測される信号が特定の位置の値に依存するのではなく、その値の変化に依存する場合、多くの場合、2つの値(古い値と新しい値)から必要な情報を回復することができます。記事では、他の漏洩形式も分類されています。
数十年にわたり、形式検証に対するこれらの批判は、形式検証をさらに向上させるのに役立ちました。過去と比べて、私たちはこの種の問題に対してより警戒心を持つようになりました。しかし、今日においてもその完璧さには至っていません。
広い視野で見ると、ここには実は1つの共通点があります:形式検証は非常に強力です。しかし、市場がそれを「証明可能な正確性」をもたらすものとしてどのように宣伝しようとも、そのような「証明可能な正確性」は基本的にソフトウェアやハードウェアが真に「正確である」と証明することはできません。
ほとんどの人にとって、「正確」とはおおむね次のような意味です:そのものの振る舞いがユーザーから開発者への意図に合致していること。
そして、「安全」とはおおむね次のような意味です:そのものの振る舞いがユーザーの利益を損なう方法でなく、ユーザーの予想から逸脱していないこと。
これらの両方のケースにおいて、正確性と安全性は最終的に比較に帰着します:一方は数学的オブジェクトであり、もう一方は人間の意図や予想です。厳密に言えば、人間の意図や予想自体も数学的オブジェクトです。なぜなら、人間の脳も宇宙の一部であり、宇宙は物理法則に従います。十分な計算リソースがあれば、基本的にはこれらをシミュレートできます。しかし、これらは非常に複雑な数学的オブジェクトであり、コンピュータであれ私たち自身であれ、真に理解することさえ、読み取ることさえできません。実際の目的では、これらをブラックボックスと見なすことができます。自分自身の意図や予想をいくらか理解できるのは、それぞれが数年にわたり自分の考えを観察し、他人の考えを推論してきた経験があるからです。
私たちが元々の人間の意図を直接コンピュータに詰め込むことができないために、形式検証はシステムと人間の意図の比較を証明する方法がありません。したがって、「証明可能な正確性」と「証明可能な安全性」は、実際には人間が理解する「正確性」と「安全性」を証明していないのです。人間の脳をシミュレートできるようになる前に、これを実現する方法は何もありません。
では、形式検証が実際に有用なのはどこですか?
私は、テストスイート、型システム、および形式検証を、同じ基礎となるプログラミング言語セキュリティ手法の異なる実装形態と見なす傾向があります。これが唯一の本当に妥当な方法かもしれません。それらの共通点は、我々の意図を異なる方法で冗長に説明し、その後、それら異なる説明が互換性があるかどうかを自動的にチェックすることです。
例えば、以下のPythonコードをご覧ください:
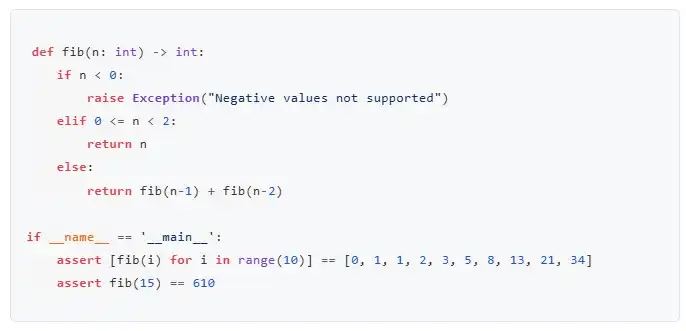
ここでは、自分の意図を3つの異なる方法で表現しています:
第一に、直接的な表現:フィボナッチ数の計算をコードで実装しています。
第二は、間接的な表現です:型システムを通じて、入出力および再帰プロセス中の中間ステップがすべて整数であることを示します。
第三は、「ケースパッケージ」アプローチを採用することです:つまり、テストケースです。
このファイルを実行すると、システムはこれらの例を使用して式が成立するかどうかをチェックします。型検査器は、互換性のある型が存在することを検証できます:2つの整数を加算することは有効な操作であり、別の整数が得られます。型システムは物理計算でもよく使用されます:加速度を計算している場合、結果の単位が m/s² ではなく m/s である場合、手違いがあることがわかります。また、「ケースパッケージ」形式の定義では、テストケースはその1つであり、通常、直接的で明示的な定義よりも人間が概念を処理する方法により適しています。
自分の意図を表現するためにできるだけ多くの異なる方法を使用できるほど良いです。理想的には、これらの方法が互いに大きく異なるため、同じ問題に対処するためにさまざまな考え方を使用するように強制されます。そのようにして、すべてのこれらの表現が最終的に互換性がある場合、自分の意図を最もよく表現する確率も高くなります。
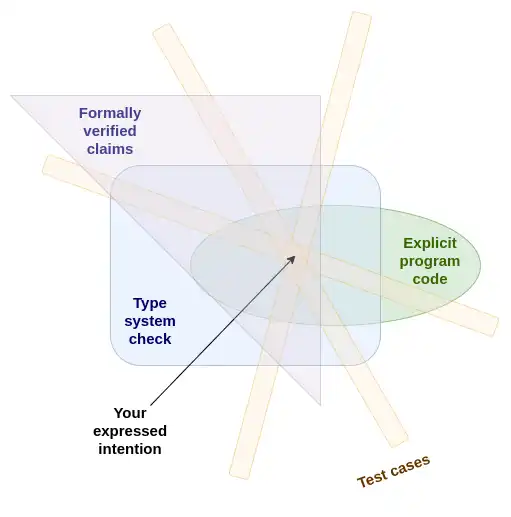
セキュアプログラミングの核心は、自分の意図をさまざまな方法で表現し、それらの表現が互いに互換性があるかどうかを自動的に検証することです。
形式検証はこのアプローチをさらに推進できます。形式検証を使用すると、自分の意図を記述するためにほぼ無限の冗長な方法を使用できます。これらの記述が互いに互換性がある場合のみ、プログラムは検証に合格します。
最適化された実装と、効率は低いが人間が読みやすい実装を同時に書いて、それらが一致するかどうかを検証できます。また、このプログラムが満たすべき数学的属性を10人の友人にそれぞれリストアップしてもらい、すべてのプロパティが満たされているかどうかを確認できます。検証に合格しない場合、プログラムが間違っているか、数学的な属性自体に問題があるかをさらに検討できます。AIはすべてのこれらの作業を非常に効率的に行えるようにします。
では、どう始めればよいでしょうか?
現実的には、あなたが証明を書くことはほとんどないかもしれません。形式的手法が広まっていない根本的な理由は、ほとんどの人がこれらの厄介な証明をどのように書けばよいのかを理解するのが難しいからです。
以下のコード断片が何を意味するのか教えていただけますか?
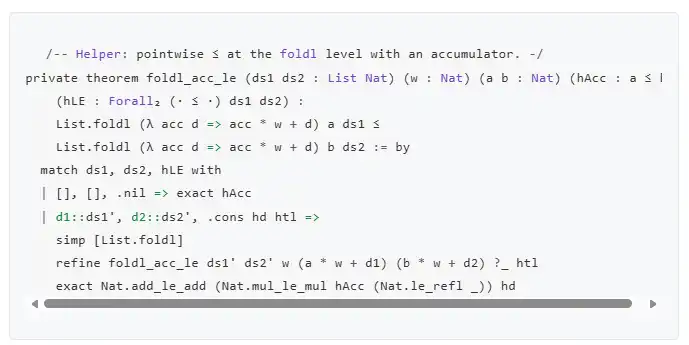
(知りたい場合は、これはある証明の多くのサブ補題の1つです。この証明は、特定のセキュリティ主張に対する SPHINCS 署名のある変種を対象としています:すなわち、ハッシュ衝突が発生しない限り、他のメッセージに比べてあるメッセージの署名を生成するには、あるハッシュチェーンでより高い位置の値を使用する必要があります。したがって、別の署名からその情報を計算することはできません。)
証明を書き出す必要はありませんが、代わりに AI にプログラムを書かせることができます。たとえば Lean を使用することもできます。もし速度を求めるのであれば、アセンブリ言語で書くこともでき、その過程で証明したいプロパティを示すことができます。
このタスクの利点の1つは、それが本質的に自己検証的であるということです。そのため、常に見ている必要はありません。AI が数時間連続で実行されるのをそのままにしておくことが完全に可能です。最悪の場合は、AI が行き詰まったり進展が見られないだけであり、私の Leanstral が一度行ったように、自分の作業を容易にするために証明すべき主張を直接置き換えるだけです。
最終的に確認する必要があるのは、証明された主張が本当に証明したいものであるかどうかです。
この SPHINCS 署名の変種では、次の最終主張がなされます:
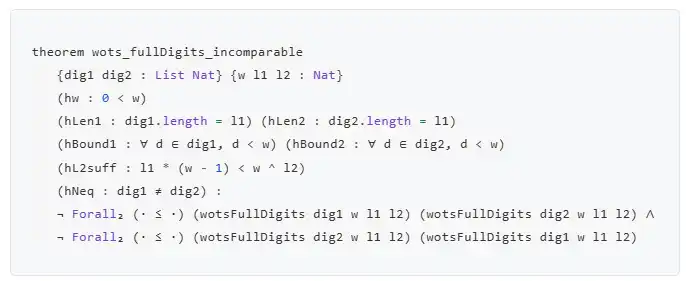
これは実際には「読みやすい」という境界に近づいています:
ハッシュダイジェストによって生成された数字(dig1)が別のハッシュダイジェストによって生成された数字(dig2)と等しくない場合、次の主張は成立しません:
すべての数字について、dig1 の各桁が dig2 の対応する桁以下である;
すべての数字について、dig2 の各桁が dig1 の対応する桁以下である。
ここで比較されているのは、「拡張数字」(wotsFullDigits)にチェックサム(checksum)を追加して生成された数字です。つまり、ある位置では、dig1 の拡張数字がより高くなりますし、他の位置では dig2 の拡張数字がより高くなります。
言語モデルを使用して証明を記述する際、私は Claude が十分に使いやすいと感じ、DeepSeek 4 Pro も十分な能力を持っていると考えています。一方、Leanstral は有望な代替案です。これは Lean の執筆に特化した規模の小さいオープンソースのウェイト調整モデルです。モデルのパラメーター数は 1190 億ですが、各トークンごとに 60 億のパラメーターしかアクティブにならないため、ローカルで実行できます。ただし、速度はやや遅くなります。私のノートパソコンでは、約15トークン/秒です。
ベンチマークによると、Leanstral は多くの一般的な大規模モデルを上回っています:
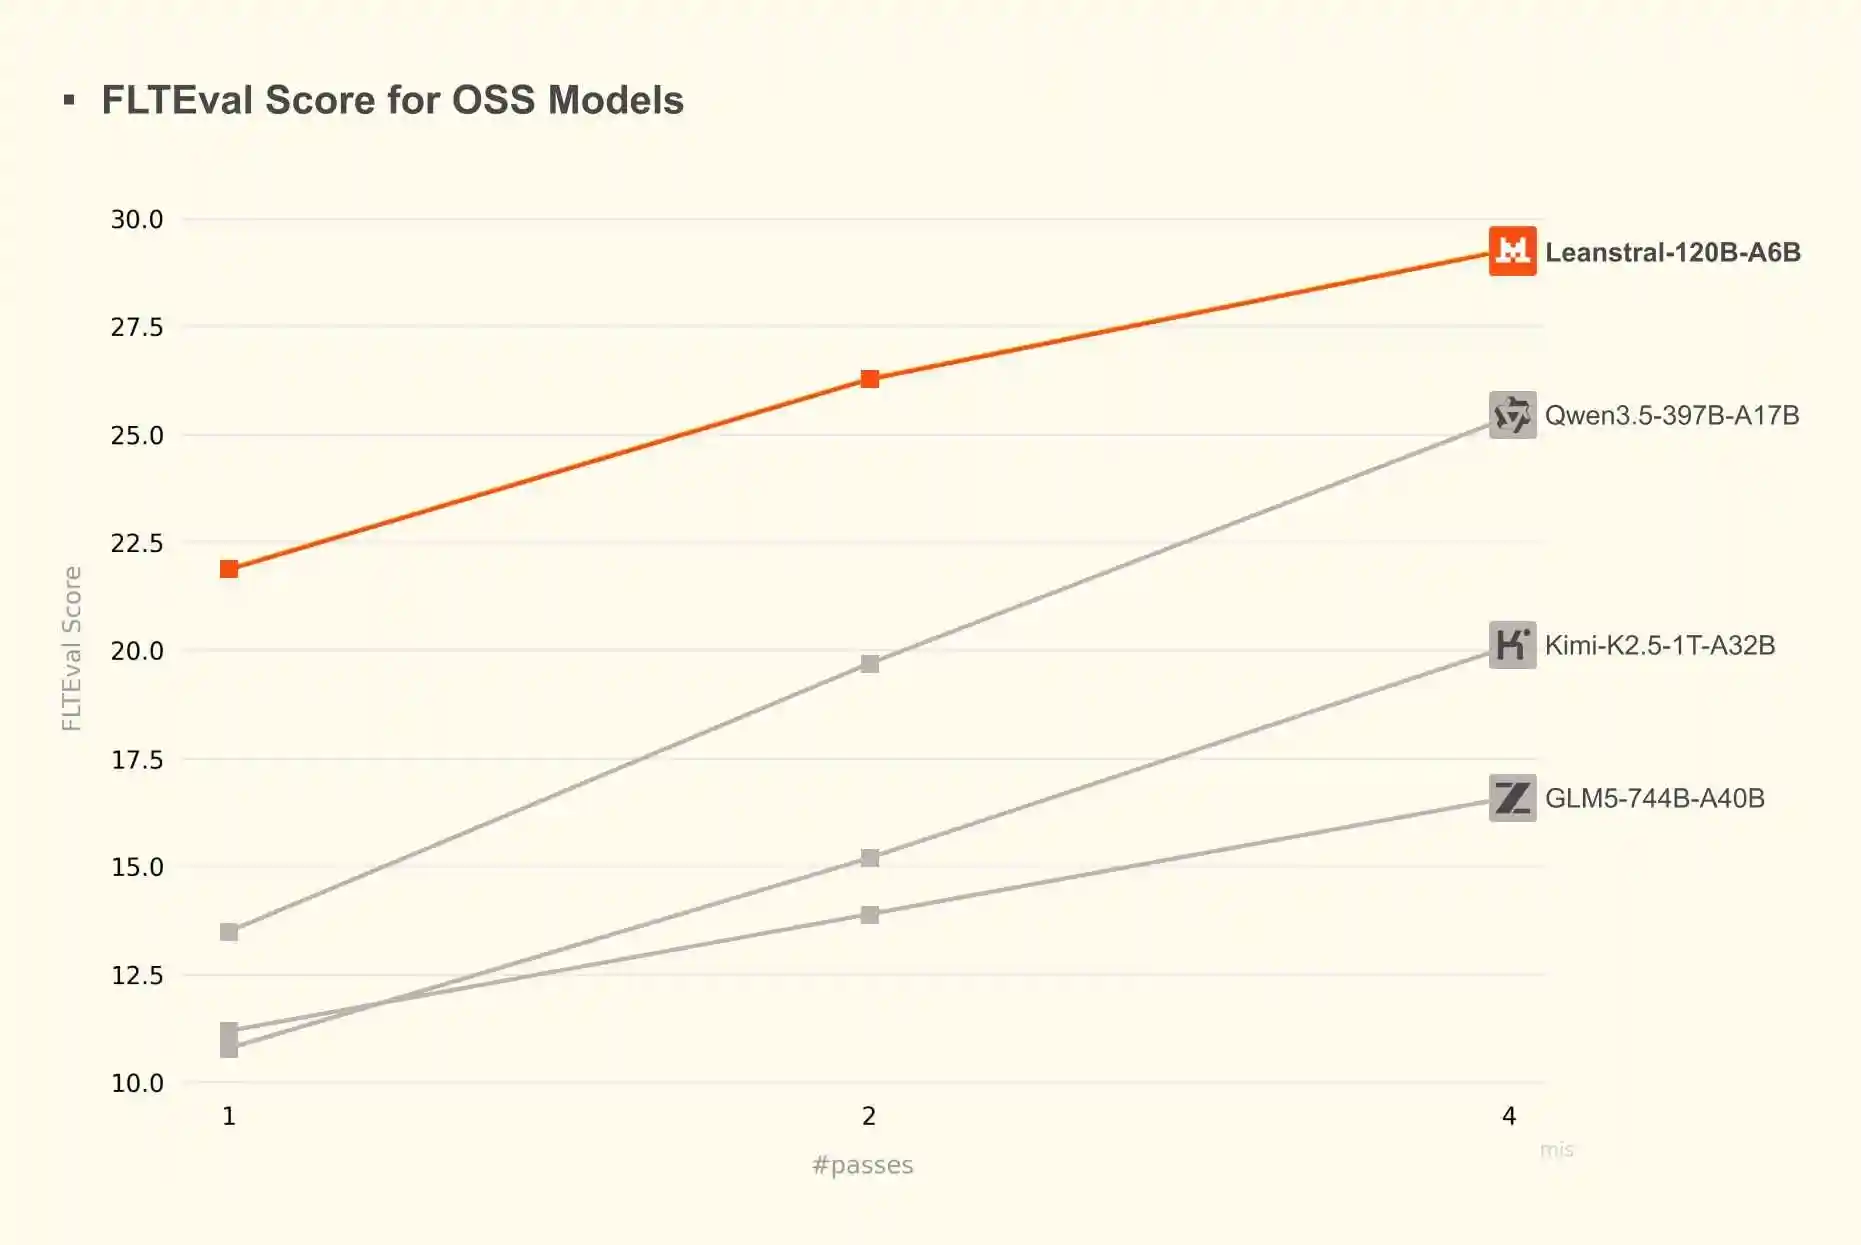
現時点での私の個人的な経験に基づくと、DeepSeek 4 Pro よりもやや劣るものの、それでも有効です。
形式検証はすべての問題を解決するわけではありません。しかし、インターネットセキュリティモデルを構築し、すべての人にではなく少数の強力な組織を信頼させるのではなく、コードを信頼する必要がある場合、強力なAI相手にもコードを信頼できるようにする必要があります。AI支援形式検証は、この方向に進む重要な一歩を踏み出すことができます。
ブロックチェーンとZK-SNARKsのように、AIと形式検証も非常に補完的な技術です。
ブロックチェーンはプライバシーとスケーラビリティを犠牲にする代わりに、オープンで検証可能で検閲耐性のある状態をもたらします;ZK-SNARKsはプライバシーとスケーラビリティを取り戻しますが、実際には元の状態よりも強力にします。
AIにより、大規模なコードの記述が可能になりますが、精度が低下するという代償があります;一方、形式検証は精度を取り戻しますが、実際には以前よりも強化されます。
デフォルトでは、AIは多くの荒削りなコードを生み出し、バグの数も増加します。確かに、一部のシナリオでは、バグの増加は適切なバランスでさえあります:これらのバグが軽微な影響しかない場合は、欠陥のあるソフトウェアでも、そのようなソフトウェアより優れています。ただし、ここでは、ネットワークセキュリティには依然として楽観的な未来が存在します:ソフトウェアは引き続き、「安全なコア」に囲まれた「安全でないエッジコンポーネント」を中心に分岐していきます。
これらの安全でないエッジコンポーネントはサンドボックス内で実行され、それぞれが必要な最小限の権限だけを付与されます。安全なコアはすべてを管理します。安全なコアがクラッシュすると、すべてがクラッシュします — 個人データ、財布、およびその他の多くの項目が影響を受けます。ただし、安全でないエッジコンポーネントに問題が発生した場合、安全なコアはまだあなたを保護できます。
安全コアに関連する場合、バグのあるコードが蔓延するのを放置しません。安全コアのスケールを積極的に制御し、十分に小さく保ち、さらに縮小させます。その代わりに、AIによってもたらされる追加のすべての機能を、安全コアそのもののセキュリティ向上に投入し、極めてデジタル化された社会での非常に高い信頼負荷を担うようにします。
あなたのオペレーティングシステムカーネル、または少なくともその一部は、そのようなセキュリティコアの1つです。 Ethereumは別の例です。理想的には、ハイパフォーマンスな計算を除くすべてのシナリオで使用するハードウェアも、第3のセキュリティコアとなります。 IoTに関連する一部のシステムは、第4のセキュリティコアです。
少なくともこれらのセキュリティコアの中では、「バグは避けられない、攻撃者よりもそれらを見つける努力を重ねるしかない」という言葉がもはや成立しなくなります。それは、より希望に満ちた世界に取って代わられます:そこでは、真のセキュリティを実現できるようになります。
もちろん、あなたが自分の資産やデータを、ひどく書かれたソフトウェアに、それどころかそれらをすべてアクシデントでブラックホールに送ってしまう可能性さえある人々に託すことを望むのであれば、それはまだその自由を持っているでしょう。
BlockBeats の公式コミュニティに参加しよう:
Telegram 公式チャンネル:https://t.me/theblockbeats
Telegram 交流グループ:https://t.me/BlockBeats_App
Twitter 公式アカウント:https://twitter.com/BlockBeatsAsia






