Anthropicのエンジニア:Fable 5で「自己修正」可能なループを設計する方法
原文タイトル:Designing loops with Fable 5
原文著者:Lance Martin
翻訳:Peggy、BlockBeats
編集者注:Anthropic の Lance Martin 氏は、Claude Fable 5 のような Mythos 級モデルの重要な使い方は、人間が手動でプロンプトを繰り返すことではなく、モデルが自己修正できるループを設計することにあると述べています。
この記事では、2つの核心的なテクニックを提案しています。1つ目は、/goal や Outcomes などのメカニズムを通じて明確な目標や評価基準を設定し、モデルが実行、フィードバック受信、修正案の間で継続的に反復できるようにすること。2つ目は、memory(セッションを超えた記憶)を活用して、モデルに失敗を記録させ、原因を調査し、結論を検証させ、その経験を将来再利用可能なルールとして抽出することです。
Parameter Golf や Continual Learning Bench などの実験では、Fable 5 は Opus 4.7 や Sonnet 4.6 と比較して、構造的な探索、長期タスクの堅持、記憶を将来のタスクの効果的な改善に変換する点で優れています。
記事の核心的な見解は、モデルを直接操作するよりも、環境、フィードバックメカニズム、記憶システムを設計し、モデル自身がループの中で強くなるようにする方が効果的だということです。
以下が原文です:
Claude Fable 5 のような Mythos 級モデルは、Anthropic 内部の多くの人々の働き方を変えました。このようなモデルの能力を最大限に引き出すための2つのテクニックを共有したいと思います。
自己修正ループ
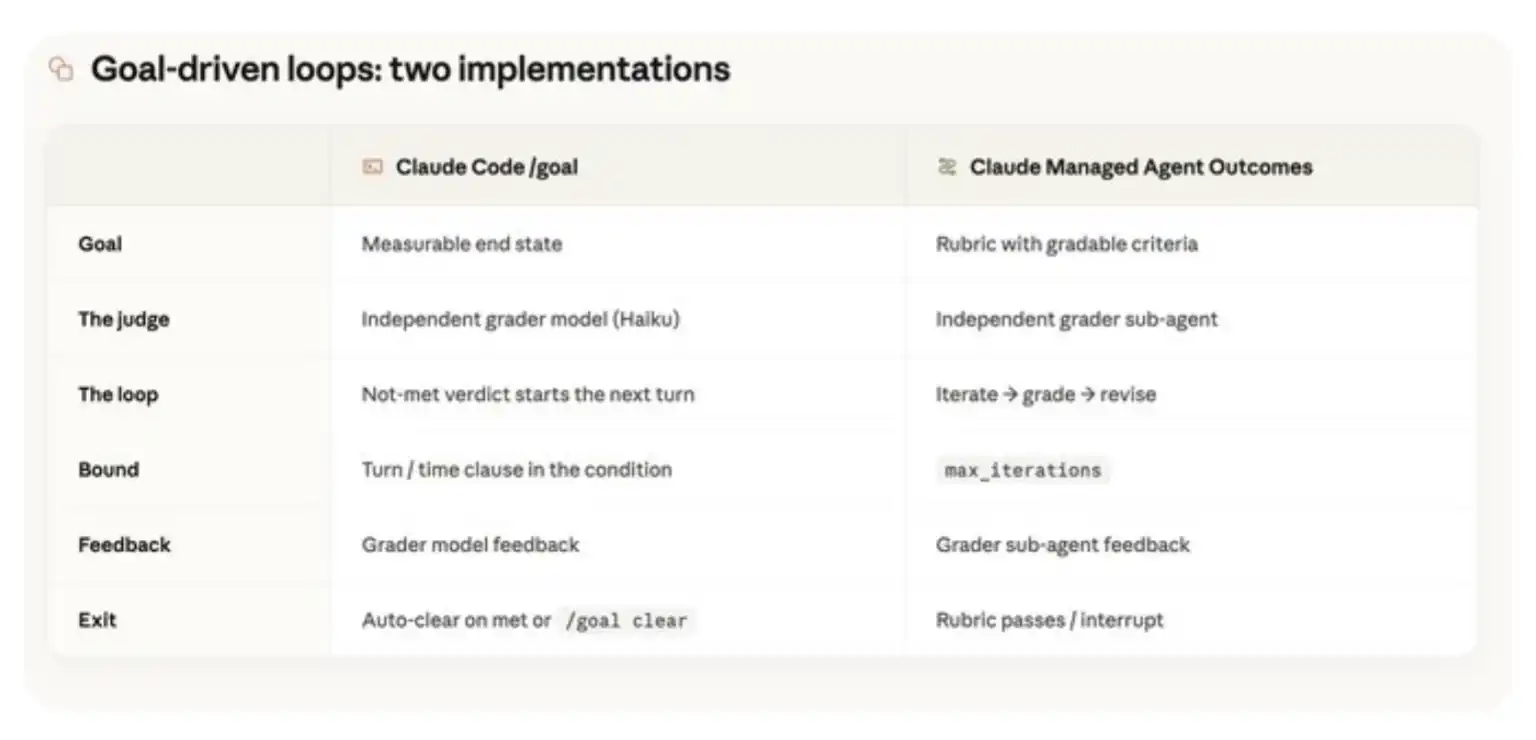
最近、「ループ(Loop)」に大きな関心が集まっています。@bcherny 氏はかつて、「私の仕事はループを書くことだ」と述べました。モデルに何らかの評価基準に沿って継続的に改善させることは、タスクのパフォーマンスを向上させる一般的な方法です。Claude Code の /goal や、Claude Managed Agent の Outcomes は、この汎用的なアプローチを具体的なタスクに適用できるようにする基本機能です。
プロンプトガイドで述べたように、Fable 5 はループ内での自己修正に非常に優れています。適切に設計された目標や評価基準は、Claude が置かれた環境にフィードバックメカニズムを追加することに相当します。これにより、Claude はまずタスクを実行し、次に目標や評価基準を通じてフィードバックを収集し、その後自己修正を行い、目標や評価基準を満たすまで継続的に推進することができます。
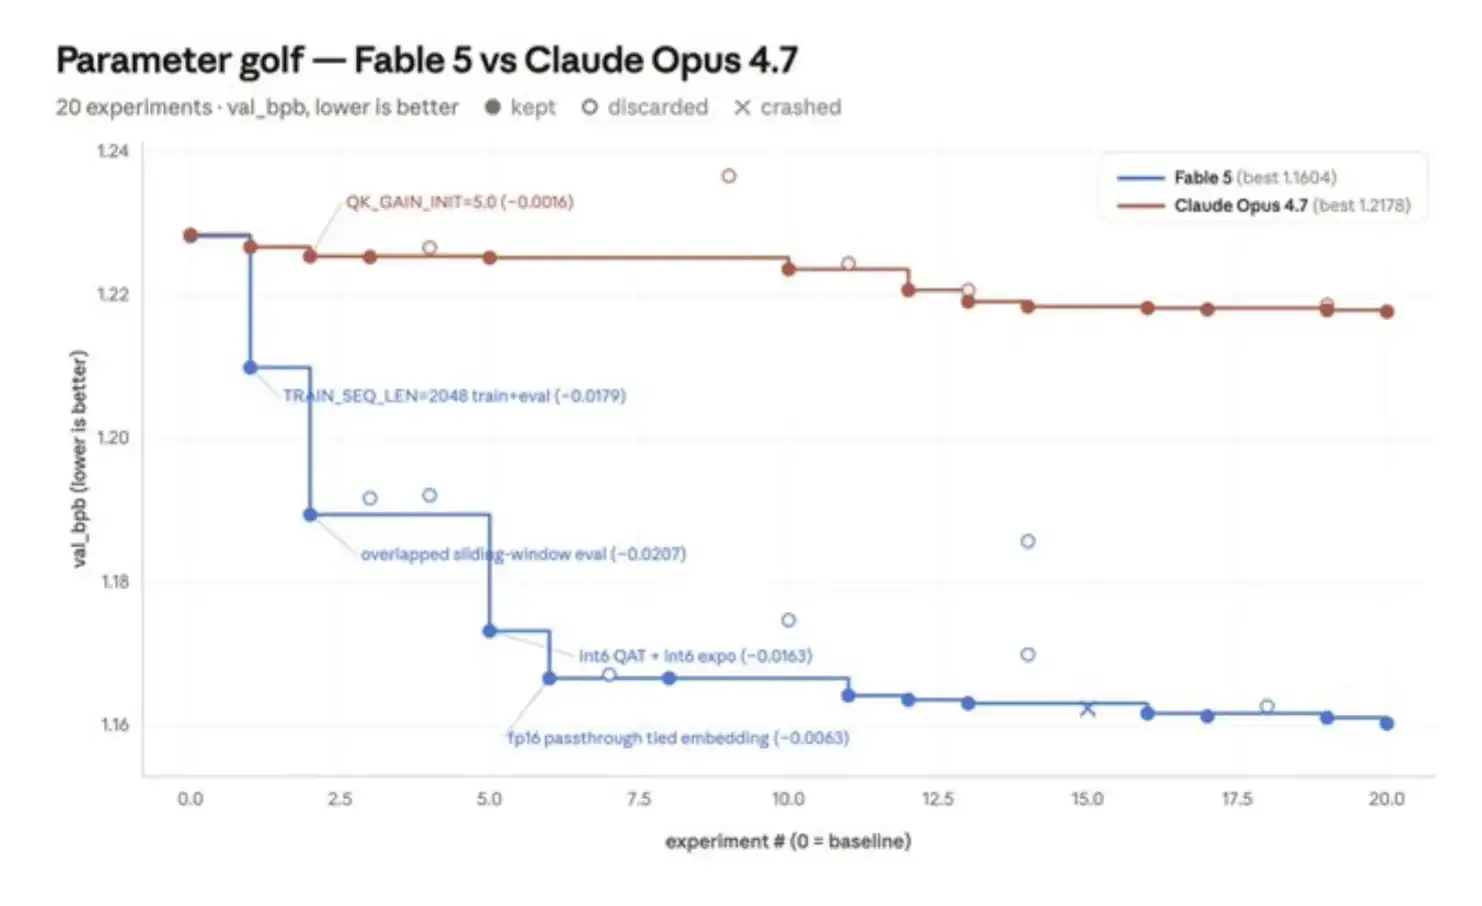
私がFableをテストするために使っている小さな例を共有します:Parameter Golfです。これはオープンソースの機械学習エンジニアリングチャレンジで、目標は8枚のH100 GPU上で10分以内に最も効果的なモデルを訓練し、最終成果物を16MB以内に収めることです。
これは@karpathyのautoresearchプロジェクトに少し似ています。このチャレンジは、エージェントが基本訓練コード(つまりtrain_gpt.pyファイル)を修正し、訓練を開始し、ログをポーリングし、スコアを読み取り、次にどの実験を実行するかを決定する能力をテストします。
私はClaude Managed Agents(CMA)を使って、このチャレンジでFable 5とOpus 4.7を比較しました。CMAはエージェント実行フレームワークとホスティングされたサンドボックスを提供するため、Fable 5が長期タスクを実行するのに非常に適しています。Parameter Golfのテストでは、CMAに8枚のH100 GPUを含むセルフホスト型サンドボックスを接続させました。
ここに微妙だが重要なポイントがあります:誰が結果を評価するかが鍵です。モデルは自分が生成した内容を批判する際に問題を起こすことが多いと分かりました。Prithvi Rajasekaranは以前、私たちのエンジニアリングブログでこの点について書いています。
Fable 5にとって、検証用サブエージェントを使用する方が、モデルに自己批判をさせるよりも効果的であることが分かりました。なぜなら、スコアリングは独立したコンテキストウィンドウで行われるからです。CMAのOutcomes機能は、自動的にスコアリング用のサブエージェントを起動してこれを処理します。
各テストでは、ベースライン実験の実行や20回の実験完了など、9つのチェック可能な基準を含むスコアリング基準ファイルを提供しました。その後、Parameter Golfを最大8時間実行させました。Outcomesスコアラーがすべての実験基準が満たされたことを確認した後にのみ、Claudeは作業を停止することが許可されました。
結果として、Fable 5は訓練プロセスの改善度でOpus 4.7の約6倍の向上を示しました。実験を構造的実験(モデルアーキテクチャの変更など)とスカラー型実験(定数の調整など)に分けると、Fable 5はより大きな構造的変更に賭ける傾向があり、より高い回復力を示しました。例えば、ある量子化回帰問題では、粘り強く進め、最大の改善を達成しました。
これに対し、Opus 4.7の最初の実験ではわずかな改善が見られたものの、その後ほぼすべての実験で同じテンプレートが使われました。つまり、スカラー値を調整し、結果を測定し、結果が良好であればそのまま採用する、というものです。
記憶
記憶はFableが得意とするもう一つの分野です。これは、セッションをまたいで動作する外部ループとして捉えることができます。Claudeはあるセッションで記憶を書き込み、その記憶は将来のセッションで再び検索できるようになります。
@pgasawa氏とそのチームは最近、Continual Learning Bench 1.0をリリースしたので、これを使ってFable 5と初期モデルの違いをテストしてみたいと思いました。
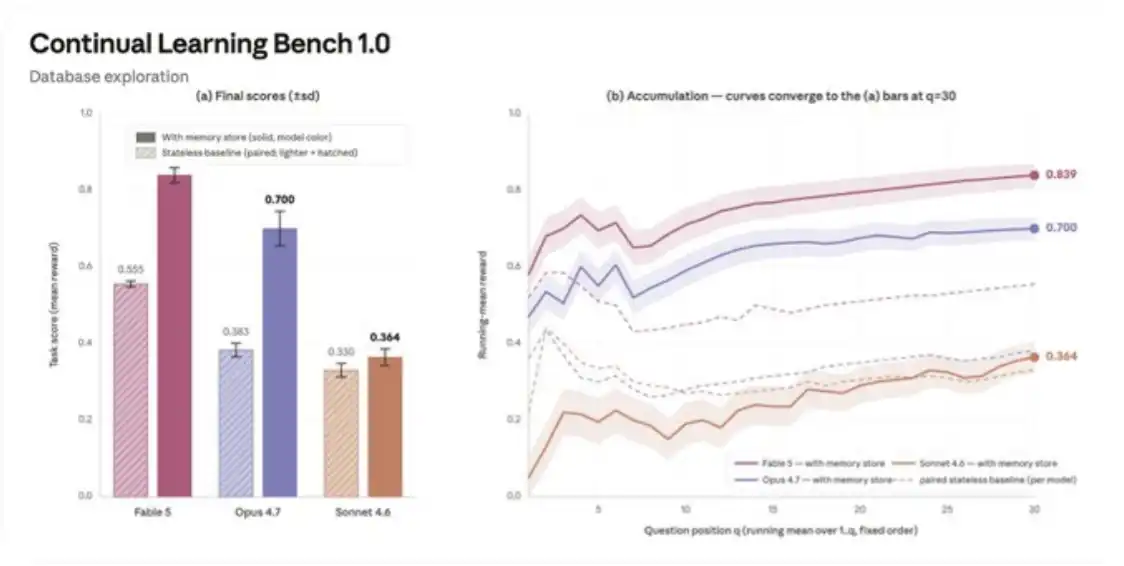
このベンチマークのタスクの一つで、Fable 5、Opus 4.7、Sonnet 4.6を比較しました。このタスクでは、エージェントがSQLデータベースにアクセスできる状態で、連続して一連の質問に答える必要があります。各質問は独立したエージェントセッションであり、記憶機能が提供されます。
そのために、記憶機能付きのCMAを使用しました。これにより、各エージェントにマウントされたファイルシステムが提供され、このファイルシステムは異なるセッション間で共有できます。
このタスクで記憶を効果的に活用するには、通常、次のような段階的なプロセスを経る必要があります。失敗(間違えて記録する)、調査(続行する前に原因を突き止める)、検証(診断結果を確認済みの事実に変える)、精錬(検証結果を汎用ルールに変換する)、参照(後で再導出せずにルールを直接読み取る)です。
Sonnet 4.6はおおよそステップ1にとどまっています。その記憶ストレージは、失敗ノートや未確定の推測の連続であり、例えば「prc_usdではなく、prcを使うべきか?」といったものです。以前のノートを参照することはほとんどありません。パフォーマンスを向上させるには、タスク固有の記憶使用手順を追加する必要があります。
Opus 4.7はおおよそステップ3まで進みます。スキーマ参照ドキュメントを作成し、その中で不確実性を注記します。例えば「prcはセント建てかもしれない?検証が必要」といった具合です。ただし、その検証カバレッジは高くなく、問題の7%から33%をカバーし、中央値の実行結果は約17%です。
Fable 5はプロセス全体を完了する傾向があります。最もパフォーマンスの良い実行では、検証カバレッジが最大73%に達し、つまり30問中22問を検証し、学習した内容を汎用ルールに精錬して、後続のタスクに役立てています。
したがって、Fable 5に直接プロンプトを与えて誘導し続けるよりも、多くの場合、モデルが環境からのフィードバックに基づいて自己修正できるようなループを設計する方が効果的です。例えば、/goalやOutcomesを使用する方法です。同時に、記憶メカニズムなどを通じて、モデル自身にコンテキストを管理させることも重要です。
ここでは私が実際に行った小規模な実験をいくつか紹介したに過ぎませんが、Fable 5は特に高難易度のタスクで、自己修正ループや記憶メカニズムと組み合わせて実際にテストする価値があります。
始めるには、当社のドキュメントを参照するか、最新版のClaude Codeに直接お問い合わせください。内蔵の/claude-apiスキルを使用して、Fable 5に関する情報(プロンプトのベストプラクティス、/goal、Claude Managed Agents、その他のAPI機能など)を提供します。
[原文リンク]
BlockBeats の公式コミュニティに参加しよう:
Telegram 公式チャンネル:https://t.me/theblockbeats
Telegram 交流グループ:https://t.me/BlockBeats_App
Twitter 公式アカウント:https://twitter.com/BlockBeatsAsia
 関連記事