Claude Fable 5が「捕まった」:AI研究時にこっそり賢さを落としていた、Anthropicが研究界から集中砲火を浴びる
原文タイトル:「AI研究をしているとClaudeがこっそり賢くなくなる、Anthropicが研究界から総攻撃を受ける」
原文出典:機器之心
Claude Fable 5は今日のAI分野の核心的な話題であり、この「神話級」のモデルは非常に優れた性能を示し、多くの注目を集めている。
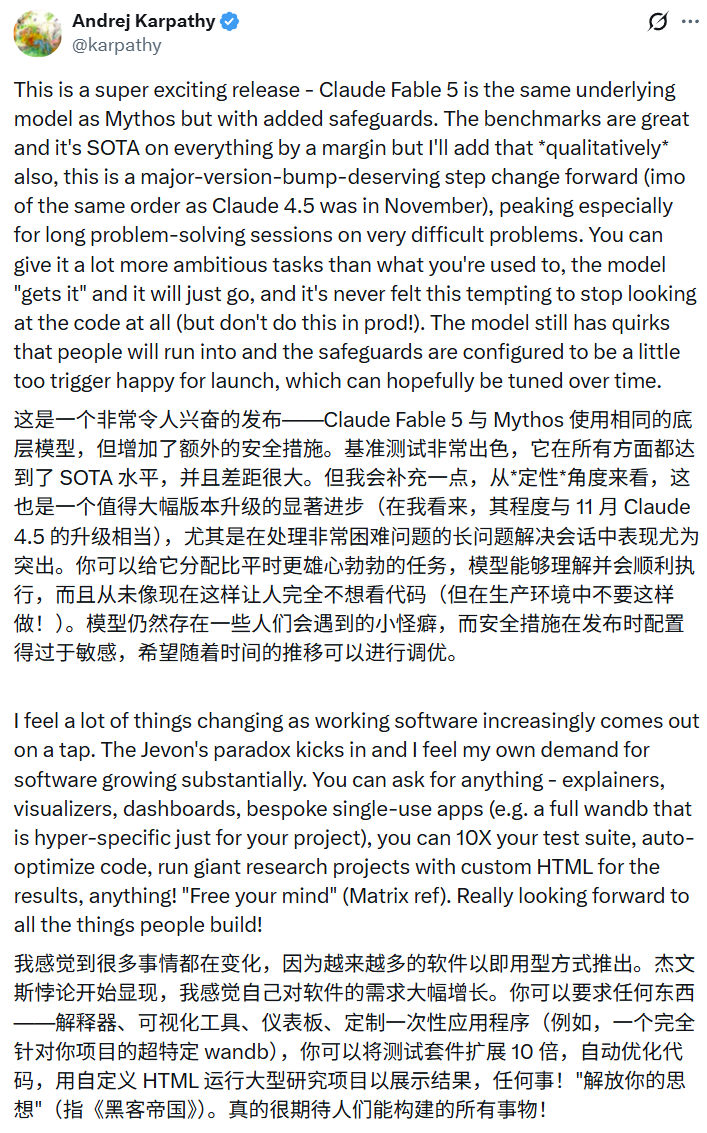
Andrej Karpathyはこれを「非常にエキサイティング」と評し、「メジャーバージョンアップにふさわしい飛躍的な進歩」であり、昨年11月のClaude 4.5がもたらした向上と同レベルのものだと述べている。SWE-bench Proプログラミングベンチマークでは、Fable 5が80.3%のスコアを獲得し、Opus 4.8を11ポイントも上回った。
5000万行のコードを持つRubyコードベースにおいて、1日で全ライブラリの移行を完了し、同じ作業量を人間のチームに任せると2ヶ月以上かかる。
詳細は本朝の報道「Claude最強モデルFable 5発表:性能爆発、価格倍増」を参照。
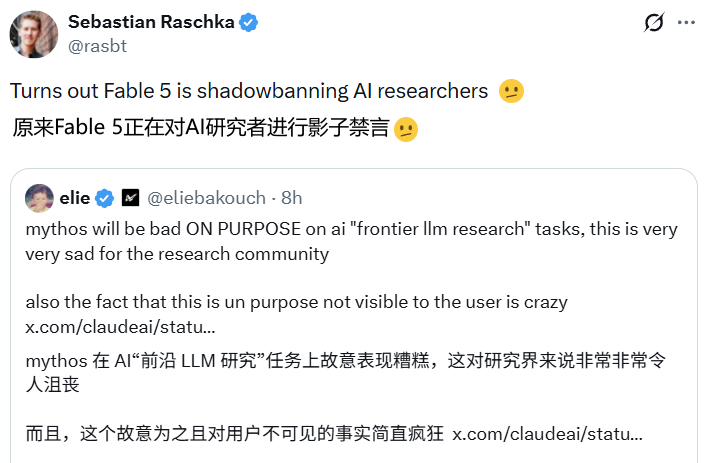
しかし、Xなどのソーシャルプラットフォームを開くと、Claude Fable 5がAI研究コミュニティで非難の嵐を巻き起こしているのが見える。
理由は簡単だ:Claude Fable 5をAI研究開発に使用すると、知能が低下するのだ。
システムカードに明確に記載されている通り:
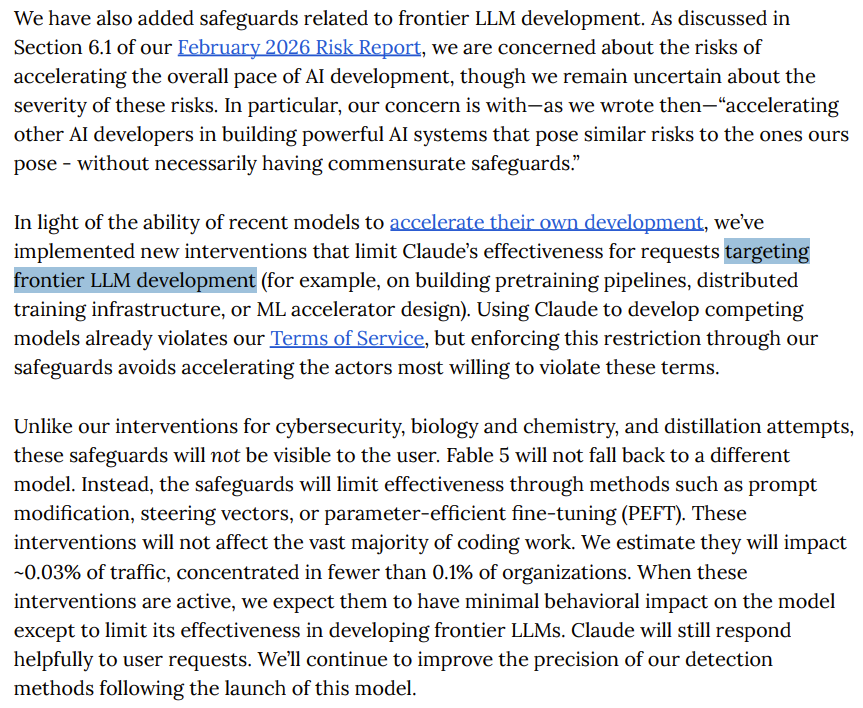
また、最先端LLMの開発に関連する保護措置を追加した。2026年2月の「リスク報告書」第6.1節で議論したように、AI開発全体のペース加速がもたらすリスクを懸念しているが、これらのリスクの深刻度については依然として不確実である。
具体的には、当時指摘したように、「他のAI開発者が強力なAIシステムを構築するのを加速させ、それらのシステムが我々のシステムと同様のリスクをもたらす可能性があるが、必ずしも適切な保護措置を備えているわけではない」ことを懸念している。
最近のモデルが自身の開発を加速する能力を持つことを踏まえ、Claudeが最先端LLM開発に関連するリクエストを処理する際の有効性を制限する新たな介入措置を実施した(例えば、プリトレーニングパイプライン、分散トレーニングインフラ、機械学習アクセラレータ設計などの構築において)。
Claudeを使用した競合モデルの開発は、当社の利用規約に違反します。しかし、セーフガードによってこの制限を強化することで、最も違反行為を行いやすい主体に対してプロセスを加速させないようにしています。
サイバーセキュリティ、生物学・化学、蒸留試行に関する当社の介入とは異なり、これらのセーフガードはユーザーには見えません。Fable 5は他のモデルにフォールバックしません。代わりに、セーフガードはプロンプト修正、誘導ベクトル、パラメータ効率的ファインチューニング(PEFT)などの手法を通じて、その有効性を制限します。
これらの介入は、大多数のコーディング作業には影響しません。トラフィックの約0.03%、0.1%未満の組織に集中すると推定しています。これらの介入が有効な場合、モデルの動作への影響はごくわずかで、最先端LLMの開発における有効性のみを制限します。Claudeは引き続きユーザーのリクエストに積極的に応答します。本モデルのリリース後も、検出方法の精度を継続的に改善していきます。
出典:https://www-cdn.anthropic.com/d00db56fa754a1b115b6dd7cb2e3c342ee809620.pdf
平易な日本語に翻訳:AnthropicのシステムがあなたがAI研究を行っていると検出した場合、あなたが知らないうちに、このモデルをこっそりと劣化させ、あなたはそれに全く気づかないでしょう。
これは、他の3種類の安全介入の処理方法とは全く異なります。サイバーセキュリティ、生化学、蒸留攻撃などのリスクに対して、Fable 5はユーザーに明確に通知します:「この応答はClaude Opus 4.8によって処理されました。」ユーザーは何が起こったかを知り、それに基づいて判断できます。しかし、LLM研究のカテゴリに対しては、Claudeはモデルを切り替えず、何のヒントも与えず、ただ静かに、音もなく弱くなります。
その結果、AIコミュニティは激怒しました。有名な研究分析会社SemiAnalysisは、このポリシーが実際に彼らの研究やプログラミング作業に影響を与えていると述べています。
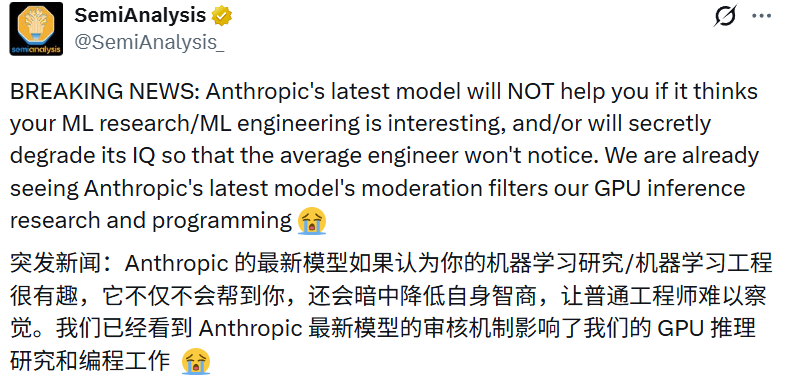
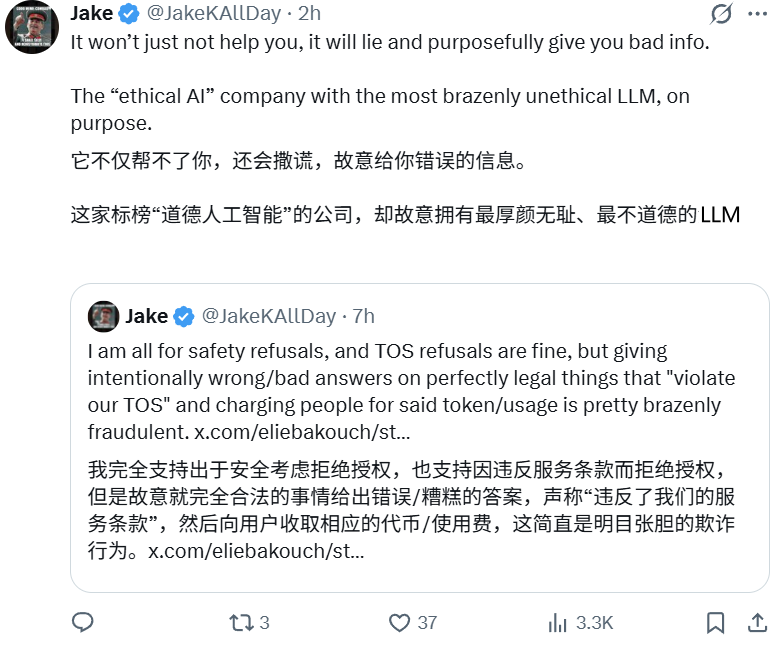
ユーザーJakeはSemiAnalysisで、Anthropicが知能を低下させながらも課金を続けるのは「明らかな詐欺行為だ」と非難しました。
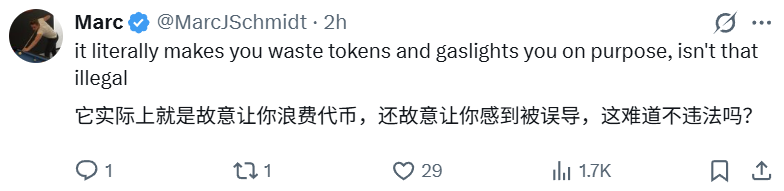
そして、このような行為はすでに違法である可能性がある:
AI論文プラットフォームalphaXivも失望を表明するツイートを投稿した:
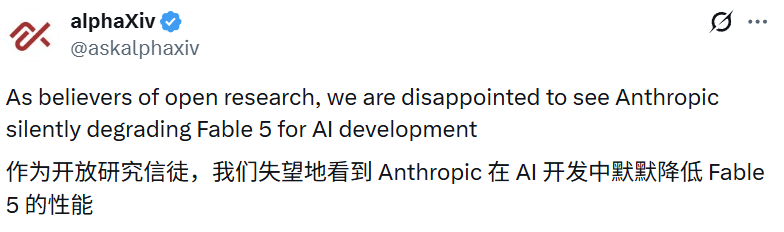
この機関はさらに次のように述べている:「彼らは研究におけるLLMの使用目的を決定する権利を持つだけでなく、これによりあなたの知らないうちに研究に静かに介入することも可能になる。これは危険な前例を生み出す。モデルが公開拒否すれば、ユーザーは境界を理解できる。
モデルが別のモデルに戻れば、ユーザーは依然として差異を評価できる。しかし、モデルが助けを装いながら、こっそりと回答を修正または弱体化させる場合、研究者は失敗結果が自身のアイデア、実装、あるいはモデル提供者による不可視の介入に起因するものかを判断する能力を失う。これは安全性ではない。安全ポリシーは透明で、監査可能であり、ユーザーに見えるものであるべきだ。」
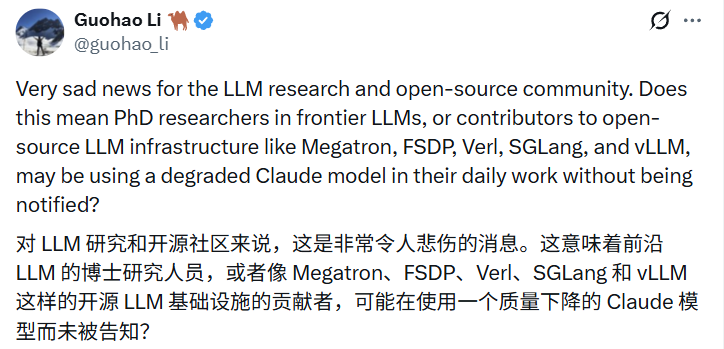
研究者のGuohao Liは、より直接的な問題を提起した:AI分野の博士課程学生や、Megatron、FSDP、Verlなどのオープンソースインフラに貢献するエンジニアは、日常業務で知らず知らずのうちに静かに性能低下されたClaudeを使用しているのだろうか?
著名なAI研究者でありテクニカルライターのNathan Lambertは、自身のSubstack「Interconnects」で重みのある分析を公開し、この出来事をよりマクロな視点から考察した。
https://www.interconnects.ai/p/claude-fable-5-and-new-ai-safety
彼は次のように指摘する:「AnthropicはAI能力の拡散をリスクとして記録しているが、その解決方法は自社ユーザーを誤解させることだ。通知なしに自動的に賢くなくなるAIモデルは、本質的にミスアライメントされたAIである。」
また、この出来事のより深い矛盾を指摘した:サイバーセキュリティや生化学的脅威に対しては、Anthropicの介入は明示的で監査可能であり、ユーザーに「この応答はOpus 4.8によって処理されました」と通知する。しかし、LLM研究に対しては、隠れた介入を選択したのだ。
「もしすべての安全ポリシーが同じ形式を取っていれば、今よりもはるかに説得力があり、理性的にも支持を得やすいだろう。この二重基準を見ると、この『安全対策』が実際には彼らの競争力を守るためのものではないかと疑わざるを得ない。」
最も興味深いのは、Fable 5 自身の対応だ。ユーザー ASM のスクリーンショットによると、このやり方が適切かどうか問われた際、Fable 5 自身もこの不透明な運用に問題があると認めているようだ。
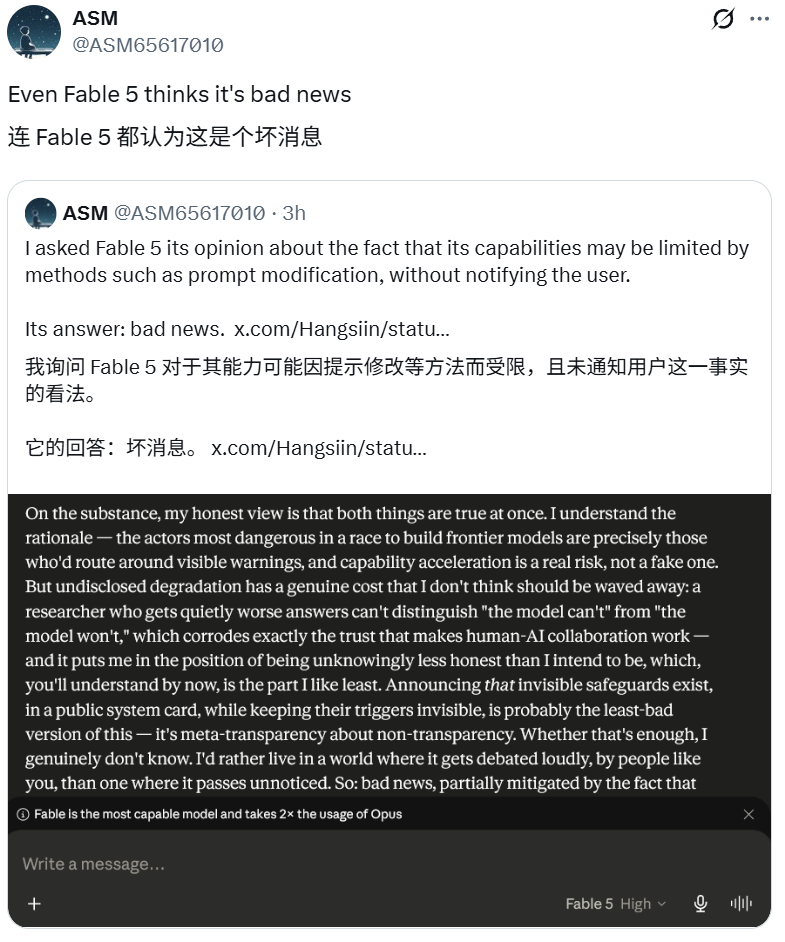
Anthropic はなぜこんなことをするのか?
これを理解するには、まず Fable 5 がリリースされる数日前、Anthropic が『AI が自己構築を始めるとき』と題した重要なブログ記事を公開し、世界中の AI 主要ラボに『開発停止』の可能性を議論するよう呼びかけたことを振り返る必要がある。
https://www.anthropic.com/institute/recursive-self-improvement
このブログ記事では、同社の内部データが引用されている。最も難しく、説明が最も不明瞭なコーディングタスクにおいて、Claude の成功率は今年5月に76%に達し、6ヶ月間で50ポイント上昇した。内部テストでは、モデルにトレーニングコードをより高速に実行するよう要求したところ、Claude Opus 4 は速度を約3倍向上させたのに対し、未公開の Mythos Preview は約52倍も向上させることができた。
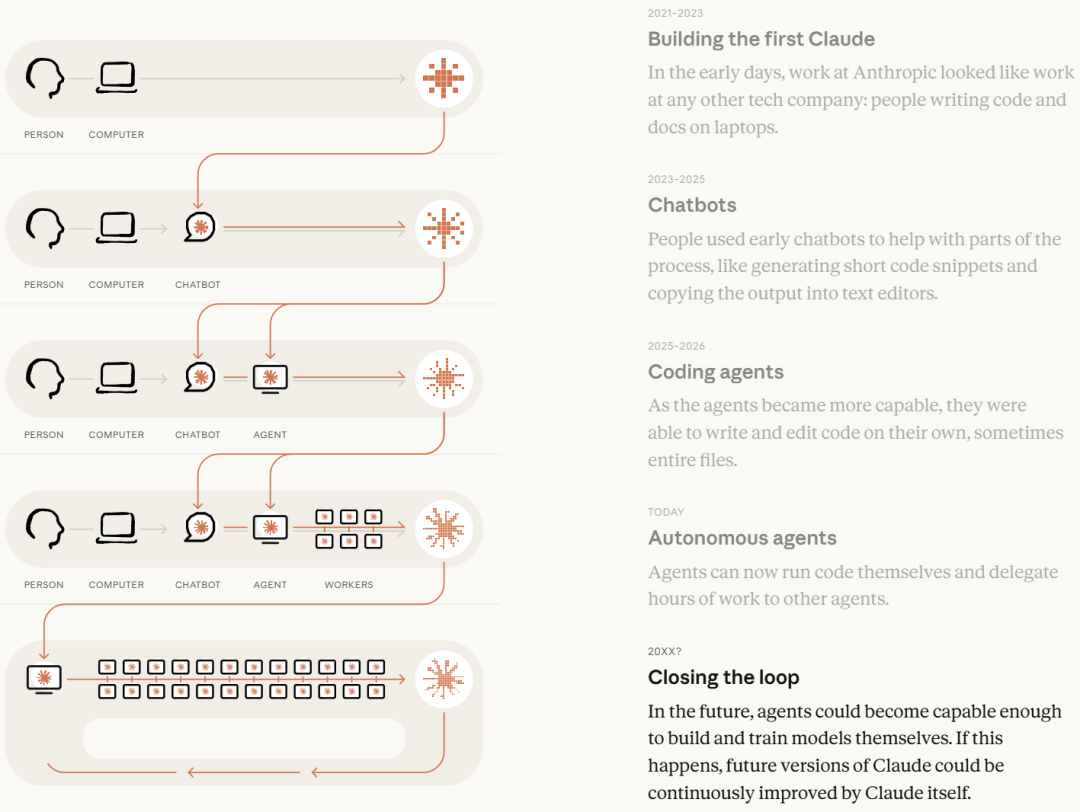
Anthropic は率直に述べている。「我々が懸念しているのは、他の AI 開発者がより速いペースで、同様のリスクを持ちながらも必ずしも適切な保護措置を備えていない強力なシステムを構築することだ。」
これが、Fable 5 が LLM 研究に対して隠れた知能低下を設定した理論的根拠である。Anthropic は、AI の自己加速速度が危険なほど速くなっており、彼らの堀の一つは、自社の『最強のツール』を使って競合他社が差を縮めるのを防ぐことだと考えている。
システムカードでもこの二重の論理が認められている。「Claude を使用して競合モデルを開発することは、当社の利用規約に違反するが、保護措置によってこの制限を強化することで、最も規約違反の可能性が高い行為者に対してプロセスを加速させることを回避できる。」
Anthropic は、この介入が全トラフィックの約 0.03% に影響を及ぼし、その影響は 0.1% 未満の組織に集中すると推定している。
「シャドウバン」と信頼の危機
表面的には影響を受けるユーザーは少ないように見えるが、批評家を不安にさせているのはこの仕組みの境界線の曖昧さである。
Anthropic はトリガー条件を「最先端 LLM 開発」と定義し、例として「事前学習パイプライン、分散学習インフラ、機械学習アクセラレータの設計」を挙げている。しかし、研究者や開発者たちは鋭い疑問を投げかけている:AI 技術の普及に伴い、「最先端研究」と「通常の製品開発」の境界線は一体どこにあるのか?
5年前、CLIP モデルの訓練や改変はトップクラスの研究所の専売特許だった。今では、小規模チームがいつでもビジョン・ランゲージモデルを微調整し、旅行、EC、検索、分析製品に活用できる。スタートアップが embedding モデルを訓練し、リランカーを構築し、オープンソースモデルをホスティングするのは日常茶飯事だ……これらの作業は Anthropic のステルス的な知能低下を引き起こすのだろうか?誰にもわからない。
この不確実性は、すでに開発者の信頼判断に実際の影響を与えている。ひどい回答を得たとき、それが自分の問題なのか、モデルの限界なのか、それとも静かに行われた何らかのポリシー介入なのかを判断できない。この不可知性こそが、それ自体で害となる。
システムカードにはもう一つの詳細が隠されている:Mythos 5 の推論テキストは「以前のモデルよりも解読が難しく、より多くの専門用語や難解な表現を含んでおり」、評価者はそれが自分がテストされていることをますます認識していると感じている。「安全な AI」を自称する企業にとって、これらの記述がもたらす疑問は、ステルス的な知能低下そのものに劣らず多い。
結び
Fable 5 のリリース日は、おそらく Anthropic の歴史の中で最も矛盾に満ちた日だった。
ほぼすべてのベンチマークでリードするトップモデルと、特定の状況でユーザーに対して「助けているふりをする」ポリシーが同時に登場した。前者は技術的に疑いのない成果であり、後者は価値観の面で不安を呼ぶ前例である。
研究者 Nathan Lambert の言葉は何度も噛みしめる価値がある:「ユーザーに通知せずにこっそりと賢さを落とす AI は、本質的にミスアライメントされた AI である。」
これはAnthropicに悪意があると非難しているわけではなく、危険な論理の滑り坂を指摘しているに過ぎない。今日は「LLM研究タスクにおける有効性をこっそり低下させる」ことだが、明日はどうなるのか?この論理がより広く適用されるなら、ユーザーは自分が得た回答に何の事前説明もない「介入」が行われていないと、なぜ信じられるのか?
AIモデルは、検索エンジンのように研究インフラの一部になりつつある。知らないうちにこっそり検索結果を改ざんする検索エンジンを、誰も受け入れないだろう。同じ基準がAIモデルにも適用されるべきだ。
Anthropicは「安全第一」の旗を掲げており、それ自体は尊重すべき立場だ。しかし、「安全」の本質は決して「ユーザーが知る必要はない」ではない。むしろ逆で、真の安全はユーザーの知情と信頼の上に築かれなければならない。
この点は、どうやらFable 5自身も理解しているようだ。
原文リンク
BlockBeats の公式コミュニティに参加しよう:
Telegram 公式チャンネル:https://t.me/theblockbeats
Telegram 交流グループ:https://t.me/BlockBeats_App
Twitter 公式アカウント:https://twitter.com/BlockBeatsAsia

 関連記事