モルガン・スタンレーの解説:AIメモリ不足は解消困難、なぜエヌビディアは逆に「スペックダウン」するのか?
TL;DR:
AIメモリ不足はサイクル全体にわたって続く可能性がある。モルガン・スタンレーは、モデル規模、コンテキスト長、推論の同時実行数が増え続けることで、新たに供給されるストレージを絶えず吸収していくと見ている。
NVIDIAはRubin向けに「減配」案を提供し始めた。一部のHBMおよびLPDDR5容量は引き下げられる可能性があるが、需要は消えたわけではなく、NAND、DRAM、高速インターコネクトへと移行している。
AI推論アーキテクチャは再構築されつつある。PrefillとDecodeの分離により、ハードウェア利用率の向上が見込まれ、Cerebras、NVIDIA Groqなどの技術ソリューションに機会が生まれる。
CXLは新たな成長ポイントとなる見込みだ。モルガン・スタンレーは、2030年に関連半導体市場規模が約60億ドルに達すると予測しており、Astera LabsとMarvellが潜在的な受益者である。
メモリ株の鍵はサイクルの持続期間であり、短期的な値上げ幅ではない。モルガン・スタンレーはMicronとSanDiskの増配を維持しており、主なリスクはAI投資およびデータセンター建設の減速にある。
編集者注:AIの次のボトルネックは、もはやGPUの数ではなく、メモリかもしれない。大規模モデルの規模拡大、コンテキストウィンドウの成長、そしてAI Agentが推論リソースを継続的に消費することで、HBM、DRAM、NANDの供給圧力がデータセンター全体に波及している。さらに注目すべきは、メモリ不足に直面し、NVIDIAが次世代Rubinプラットフォーム向けに、より低メモリ構成の製品案を模索し、システムの納品と展開のペースを維持しようとしていることだ。
ここで一見矛盾する問題が浮上する。AIのストレージ需要がそれほど旺盛なら、なぜチップメーカーは逆にメモリ容量の削減を検討し始めたのか。メモリの「減配」は需要がまもなくピークに達することを意味するのか、それとも供給ボトルネックが深刻化し、産業全体が技術路線の調整を迫られていることを示すのか。
モルガン・スタンレーの半導体アナリストJoseph Moore氏らが10月5日に発表したリサーチレポート「How Can the AI Ecosystem Work Around Memory Bottlenecks?」では、メモリ不足が現在のAIサイクルを通じて続く可能性がある一方で、AI構築はDRAM工場の増産完了を待つことはないと指摘している。業界は、一部製品の構成を引き下げ、推論タスクを分割し、メモリ共有効率を高めるなどの方法で、既存の供給制約を回避する必要がある。
これは、AIハードウェアの競争が、単にGPUとメモリ容量を増やすことから、計算システム全体のリソース利用効率へとさらに移行する可能性があることを意味する。ストレージ不足は必ずしもストレージメーカーの長期的な需要を弱めるわけではないが、産業チェーンの価値配分を変える可能性がある。MicronやSanDiskなどのストレージ企業に加え、Cerebras、Astera Labs、Marvellなど特殊な計算アーキテクチャや相互接続技術を持つ企業も、新たな成長機会を得る可能性がある。
以下は原文の翻訳である:
AIインフラ構築は、ますます解決が困難な問題に直面している。計算能力はより多くのGPUを調達することで拡張できるが、メモリ供給は同じ速度で増加させることはできない。
Morgan Stanleyは、予見可能な将来において、AI需要が大量の新規ストレージ供給を継続的に吸収する可能性があると考えている。時期によって逼迫の程度は変動するとしても、DRAMの生産能力拡張は依然として需給ギャップを迅速に解消することは難しい。
計算業界の企業との対話の中で、Morgan Stanleyは、メモリのボトルネックをいかに回避するかがますます重要な話題になっていることを発見した。NVIDIA CEOのJensen Huangも、計算、ネットワーク、ストレージシステムの協調設計を通じて供給制約を緩和する必要性について言及している。
アナリストは、これはストレージ需要の弱まりを警告するものではなく、AI産業全体が直面せざるを得ない現実であると考えている。メモリが当初の計画通りに供給できない場合、企業は既存のハードウェアでAIの成長を支え続けるための新しいシステムアーキテクチャを見つけなければならない。
一、NVIDIAがRubinの「減配」を開始、しかしストレージのボトルネックは消えていない
最も直接的な方法は、1台のサーバーまたは1つのGPUが使用するメモリ容量を減らすことである。
Morgan Stanleyは、DRAMとNANDの供給逼迫および価格上昇が、AI産業チェーンに製品構成の再検討を迫っていると指摘している。チップメーカーにとって、元の仕様に固執してシステムが計画通りに納品できなくなるよりも、異なるメモリ容量のバージョンを提供し、顧客が実際のニーズに応じて選択できるようにする方が良い。
リサーチレポートは、NVIDIAがRubinプラットフォーム向けに複数の低メモリ構成を提供する可能性があると予測している。
ラックレベルのメモリに関しては、Rubinの当初計画のLPDDR5容量は約54TBであったが、一部の新構成では28TBに低下する可能性があり、対応するSOCAMM2メモリモジュール容量は192GBから96GBに減少する。
HBMに関しては、Rubinの単一GPUは当初288GB HBM4を搭載し、8組の12層スタック設計を採用すると予想されていた。Morgan Stanleyは、NVIDIAが192GB HBM4を搭載した製品バージョンを追加し、スタック層数を8層に減らす可能性があると予測している。
Rubin Ultraについて、リサーチレポートは、デュアルコンピュートダイレット方案に調整した後、512GBがより適切な比較基準であり、将来的に約192GBから384GBの異なる容量選択肢が出現する可能性があると述べている。
これらはすべて、モルガン・スタンレーがリサーチレポート発行日時点での製品構成に対する判断であり、すべての仕様がNVIDIAによって正式に確認されたわけではない。
コストの観点から見ると、この戦略には合理性がある。HBMスタック層数を減らすことで容量を削減できるが、インターフェース数やピン速度などの条件が変わらなければ、理論帯域幅が必ずしも同時に低下するわけではない。
しかし、容量と帯域幅は二つの異なる問題を解決するものである。モデルが小さくコンテキストが短いアプリケーションでは、容量削減の影響は限定的かもしれないが、モデルがますます大きくなり、推論タスクがますます複雑になると、メモリ容量の不足により、より多くのデータを異なるストレージ階層間で転送する必要が生じ、レイテンシやGPU使用量が増加する可能性がある。
さらに重要なのは、HBMを減らしても、AIが本来処理する必要のあるデータが消えるわけではなく、それらのデータが新たな保管場所を探すだけだということである。
例えば、GPUのHBM容量が不足すると、一部のデータはメインメモリに保存する必要があるかもしれない。ラックレベルのLPDDR5容量が低下すると、一部のKV Cache(キーバリューキャッシュ)需要がNANDフラッシュに移行する可能性がある。
KV Cacheは、大規模モデルの推論プロセスにおいて履歴計算情報を保存するためのキャッシュである。コンテキストが長くなり、同時に実行されるリクエストが増えるにつれて、その容量需要も上昇する。
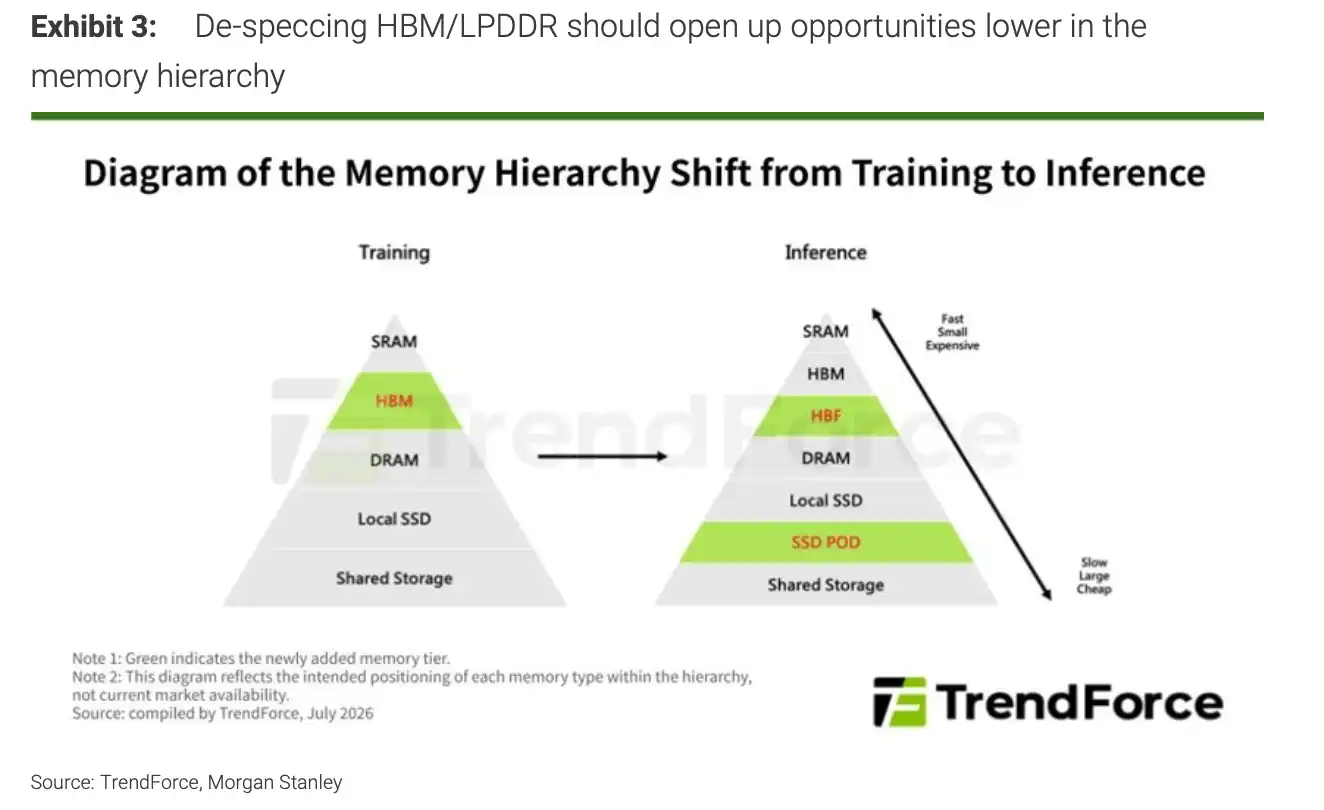
ストレージ需要は消えるのではなく、他の階層へ移転するのである。
モルガン・スタンレーは、NVIDIAが一部のLPDDR5構成を削減する一方で、産業チェーンはすでにNANDからの新たな需要を観察していると指摘している。HBM容量の減少はGPU間のデータ転送を増加させ、高速相互接続ネットワークにより大きな負荷をかける可能性もある。
これは、NVIDIAの減配戦略がDRAM供給制約を一時的に緩和する一方で、NAND、相互接続チップ、およびより大規模なGPUクラスタへの需要を同時に増加させる可能性があることを意味する。
このような圧力の移転には長期的な背景がある。
リサーチレポートが引用したEpoch AIの歴史データによると、大規模言語モデル時代のフロンティアモデルのパラメータ規模は、約6ヶ月ごとに倍増する成長傾向を示していた。コンテキストウィンドウも急速な拡大を経験した。同時に、より多くのAIアプリケーションが単純な質疑応答からプログラミング、複雑な推論、長時間実行されるAgentタスクへと移行し、メモリ使用量をさらに押し上げている。
モルガン・スタンレーは、モデル規模、コンテキスト長、推論の並行処理量が引き続きストレージ需要の成長を推動すると考えている。したがって、一部製品の構成を引き下げることは、供給逼迫時の過渡的な措置である可能性が高く、AIメモリ需要の長期的な減少を示すシグナルではない。
二、AI推論が「分解して行う」ようになり、GPUがすべてのタスクを担わなくなる
メモリ構成の削減が短期的な対応策だとすれば、AI推論の計算方法を変えることは、より深い産業構造の変化をもたらす可能性がある。
モルガン・スタンレーが注目する第二の経路は、Disaggregated Inference(分離型推論)であり、従来は同一の計算システムに集中していた異なる推論タスクを分離し、それぞれより適したハードウェアに実行させるというものである。
従来の大規模モデル推論は、主に二つの段階を含む。
第一段階はPrefill(プリフィル)であり、ユーザーが入力したプロンプト、ファイル、または過去のコンテキストを処理し、大量の並列計算を行う。この段階は通常、計算性能により依存する。
第二段階はDecode(デコード)であり、モデルが出力Tokenを一つずつ生成する。このプロセスではモデルの重みとKV Cacheに繰り返しアクセスする必要があるため、メモリ帯域幅、容量、およびデータアクセス遅延により依存する。
従来は、同一のGPUがこれら二種類のタスクを同時に担うことが多かった。しかし、推論需要の拡大に伴い、このような構成が常に最も効率的な選択肢とは限らなくなっている。
モルガン・スタンレーは、より合理的な方向性として、計算集約型ハードウェアがPrefillを担当し、低遅延と高帯域幅に最適化されたアーキテクチャがDecodeを担うことが考えられるとしている。
この方式は、ハードウェア利用率を高めるだけでなく、データセンターが二種類の計算リソースをそれぞれ拡張できるようにし、すべてのタスクに対して完全に同一のGPUとHBMを構成する必要をなくすことができる。
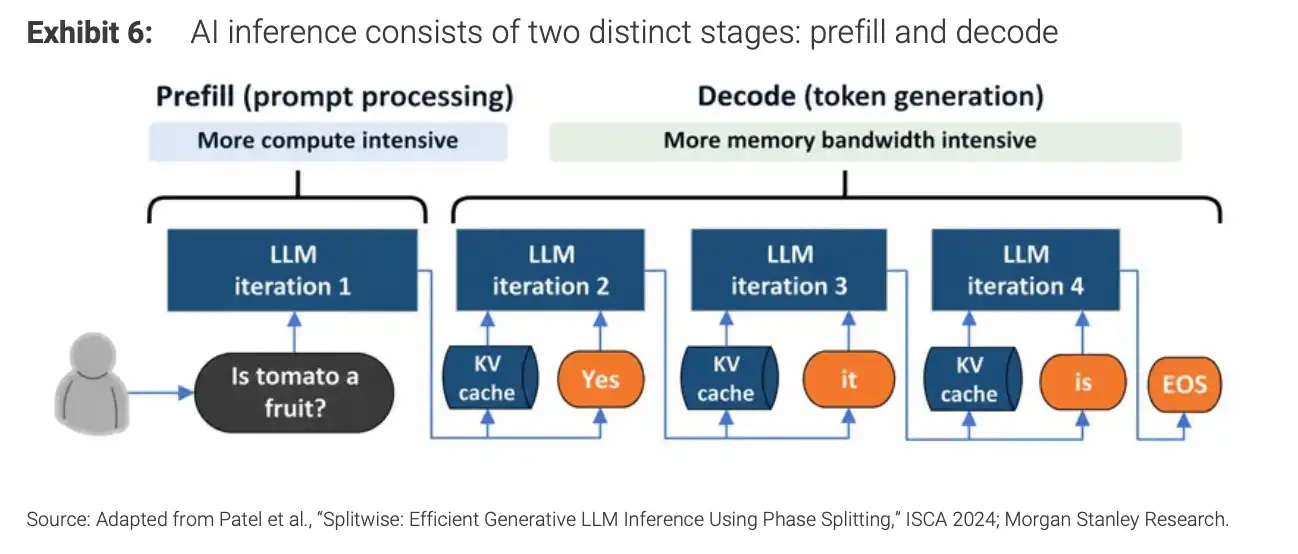
PrefillとDecodeの技術的違い
その中で最も直接的な潜在的利益享受者の一つがCerebrasである。
Cerebrasはウェハスケールプロセッサアーキテクチャを採用し、多数の計算ユニットとSRAMを同一チップ上に集積している。SRAM(スタティックランダムアクセスメモリ)は容量密度が通常DRAMより低いが、低遅延・高帯域幅という特徴を持ち、データを頻繁に読み取る必要がある一部の推論タスクに適している。
計算ユニットをデータにより近づけることで、Cerebras は外部メモリへのアクセス需要を減らし、特定の推論段階の処理速度を向上させることができる。
モルガン・スタンレーは、Cerebras が AMD、AWS と協業を展開し、異なるプロセッサを統合的な推論システムに組み合わせることを模索していると指摘した。
AMD と Cerebras の共同方案では、AMD Helios がより計算集約的な Prefill と大規模コンテキスト処理を担当し、Cerebras のウェハスケールエンジンが Decode を担当する。リサーチレポートは、この方案が 2026 年第 4 四半期に生産段階に入ると予測している。
AWS も同様のアプローチを採用し、Trainium で Prefill を処理し、Cerebras で Decode を処理する。関連する組み合わせ方案は 2027 年第 1 四半期に Amazon Bedrock に入る見込みである。
Cerebras と AMD が開示した特定方案の性能データによると、両者の組み合わせにより、Cerebras の推論速度を維持しながら、最大約 5 倍のスループット向上を実現できる見込みである。これはすべての推論タスクが同等の向上を得られることを意味するものではないが、タスクごとにハードウェアを構成することで、システムの経済性を大幅に改善できる可能性を示している。
Cerebras にとって、この変化はより多くのチップ販売機会を意味するだけでない。同社は自社の推論クラウドサービスも運営しているため、同じハードウェアでより多くの Token を生成できれば、単位 Token コストが低下する可能性があり、それによって粗利率が改善するか、顧客価格を引き下げる余地が生まれる。
NVIDIA も同様の方向性を模索している。
Groq 関連技術を統合することで、NVIDIA は HBM ベースの GPU と高速 SRAM を採用する LPU アーキテクチャを組み合わせている。リサーチレポートが描写する方案では、Rubin GPU が Prefill および大容量キャッシュを必要とする一部のデコード計算を担当し、Groq アーキテクチャがその低遅延特性により適した演算を担い、NVIDIA Dynamo ソフトウェアが異なるプロセッサ間のタスクを調整する。
区別すべき点として、NVIDIA と Groq が 2025 年に達成したのは技術ライセンスおよび人材導入の取り決めであり、Groq 社の完全買収ではない。
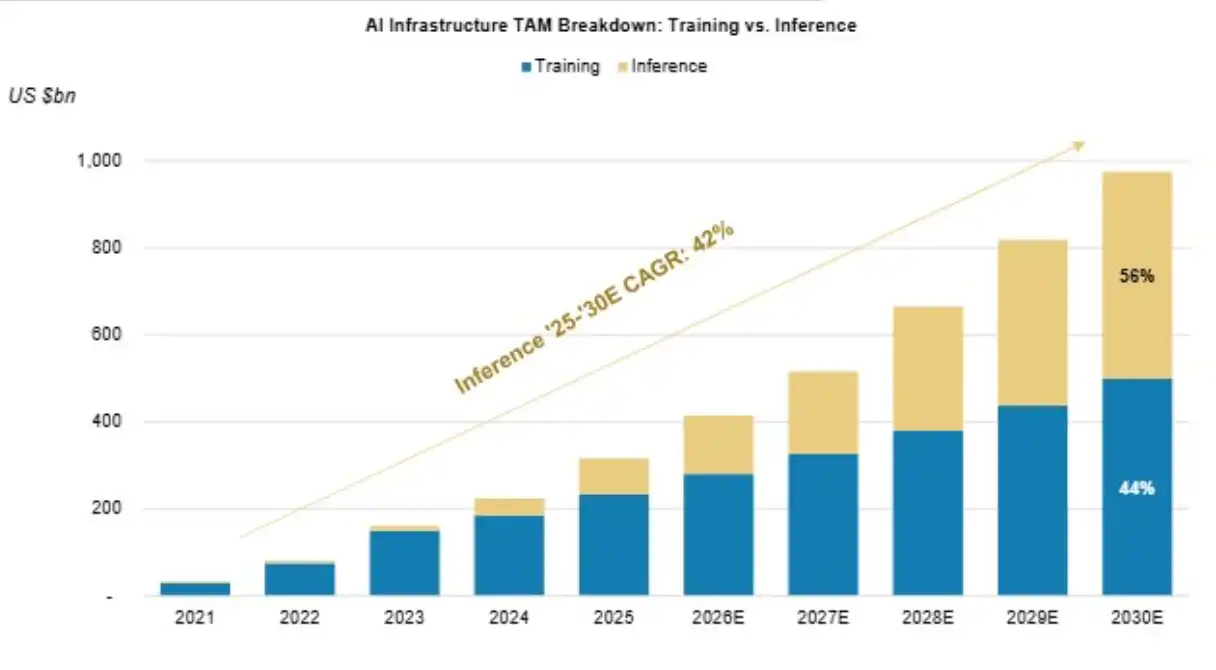
モルガン・スタンレーは、推論支出の伸びが訓練を上回るにつれて、異なる推論段階に最適化された異種コンピューティングアーキテクチャがより大きな市場空間を得る可能性があると考えている。リサーチレポートのインフラ支出予測によると、2030 年までに推論は AI インフラ支出の約 56% を占め、訓練は約 44% を占めると予想される。
これはAIチップ業界に新たな競争ロジックをもたらす。将来、AIシステムの競争力を測る指標は、ピーク演算能力だけでなく、毎秒どれだけのTokenを生成できるか、そして各Tokenの生成にどれだけのコストがかかるかも含まれる可能性がある。
三、CXL市場は60億ドルに達する見込み、メモリ相互接続が新たな機会に
推論タスクの割り当て方法を変えるだけでなく、モルガン・スタンレーは既存のメモリ資源の利用効率をいかに高めるかにも注目している。まさにここにCXL技術の機会がある。
CXL(Compute Express Link、コンピュート・エクスプレス・リンク)は高速相互接続プロトコルであり、プロセッサが常にローカルに直接接続されたDRAMに依存することなく、外部メモリにより柔軟にアクセスできるようにする。
従来のサーバーでは、メモリ資源は特定のCPUに紐づけられることが多かった。たとえ一台のサーバーに大量のアイドルメモリがあっても、それを別のサーバーが直接使用するのは難しかった。CXLはメモリ拡張、共有、プーリングを通じて、データセンター全体のDRAM利用率を高める。其中、メモリ拡張は単一プロセッサに追加容量を提供し、メモリ共有は複数のプロセッサが同じメモリ資源にアクセスできるようにし、メモリプーリングは分散したメモリを統一リソースプールに組織し、ワークロードに応じて動的に割り当てる。
この技術は従来、主に伝統的なCPUコンピューティング環境で応用されてきた。CPUワークロードは外部メモリによる追加アクセス遅延を受け入れやすいためである。対照的に、AI GPUは長らくHBMに依存して極めて高いデータ帯域幅を提供しており、CXL接続の外部DRAMがHBMを直接代替するのは難しい。
しかし、AI推論需要の変化に伴い、このアーキテクチャの価値は上昇している。
例えば、長コンテキスト推論では大量のKV Cacheを保存する必要があるが、すべてのキャッシュデータを常に最速のHBMに保持する必要はない。システムは性能に敏感なデータをHBMに保持し、アクセス頻度が低く遅延要件が比較的緩い一部のデータを外部DRAMに移すことができる。
これにより、高価なHBMの容量圧力を緩和しつつ、既存DRAMの利用効率も高めることができる。
モルガン・スタンレーは、AIがCXLを従来のサーバーメモリ拡張から、より広範なアクセラレータメモリ接続・共有市場へと押し進めていると考えている。
過去にAstera Labsは、CXLメモリコントローラの潜在市場規模を40億ドル以上と推定していた。モルガン・スタンレーは現在、AI推論、KV Cacheオフロード、ラックレベルメモリプーリングの需要増加に伴い、2030年までにCXLおよび関連メモリ接続半導体の潜在市場規模が約60億ドルに達する見込みだと予測している。
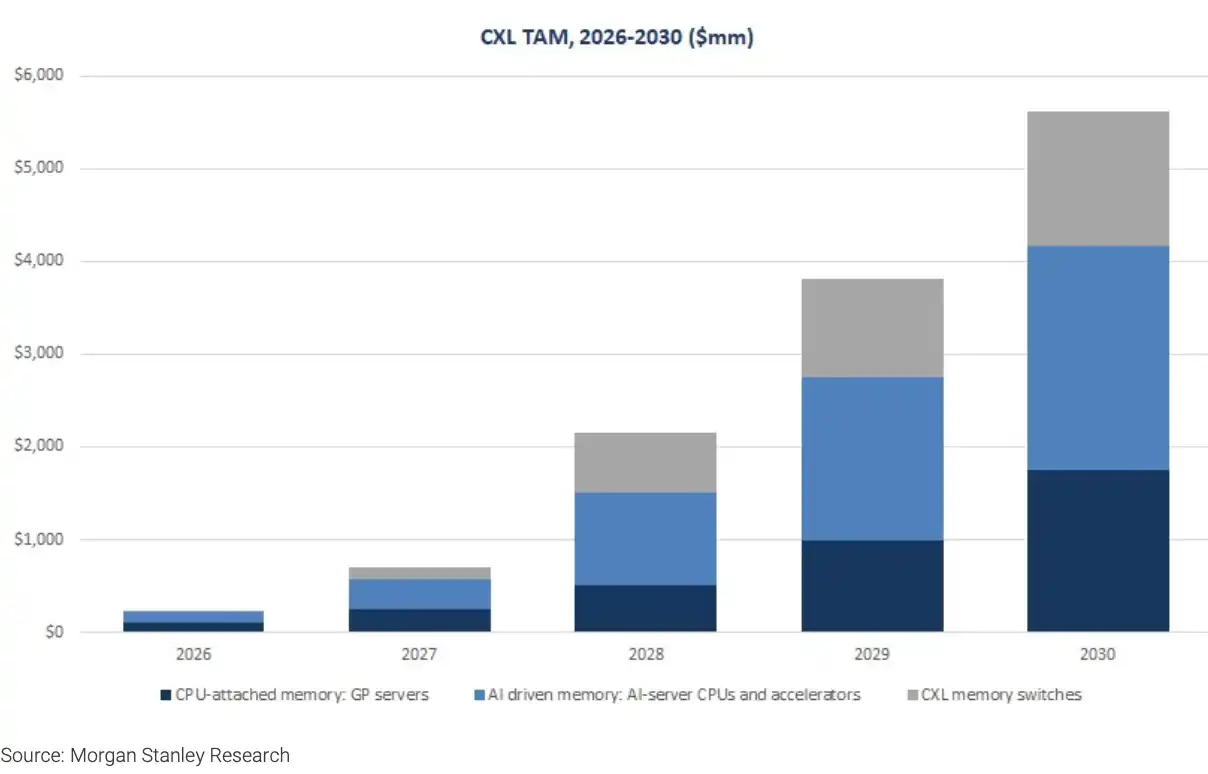
強調すべきは、この数字はアナリストによる潜在的な市場規模の予測であり、すでに実現した市場収益ではないということだ。
具体的な企業に関しては、リサーチレポートはAstera Labs(ALAB)とMarvell(MRVL)に注目している。
Astera Labsの機会は主にLeoメモリコントローラー製品から来ている。モルガン・スタンレーは、同社が標準化およびカスタマイズされたLeo製品が2027年に2社の米国大手クラウドサービス顧客において本格的な量産出荷を開始すると予測しており、その中にはAI推論向けのKV Cacheオフロード設計が含まれると指摘している。
MarvellはStructera XとStructera Sを通じて、それぞれメモリ拡張とラックレベルのメモリプーリングを展開している。同社は以前、CXL事業が2028年頃に10億ドルを超える収益に貢献する見通しだと予測していた。
これら2社にとって、AIストレージ不足は、本来普及が遅かったCXL技術に新たな商業需要をもたらす可能性がある。
ただし、モルガン・スタンレーも、CXL市場の実際の規模は依然として正確に予測することが難しいと認めている。クラウド事業者によっては非CXL相互接続技術、より大容量のHBM、あるいはフラッシュベースのキャッシュソリューションを選択する可能性があり、最終的な市場採用速度は現在の予想と大きく異なる可能性がある。
したがって、CXLの投資ロジックが実現できるかどうかは、クラウド事業者の実際の導入進捗、製品出荷量および関連事業収益を引き続き注視する必要がある。
四、メモリ削減は必ずしもマイクロンに弱材料ではなく、真のリスクはAI建設の減速
ストレージ産業チェーンにとって、エヌビディアが一部のメモリ構成を引き下げることは良いニュースではないように思える。GPU1台あたりのHBM容量が減少し、ラックあたりのLPDDR5使用量が減れば、ストレージメーカーが販売できるメモリ数は当初の計画を下回る可能性がある。
モルガン・スタンレーは、短期的な利益最大化の観点から見れば、これがストレージメーカーが本来得られたはずの一部の需要と価格機会を確かに弱める可能性があると認めている。しかしアナリストは、これをストレージサイクルがまもなく終了すると単純に解釈すべきではないと考えている。鍵となるのは、現在の構成削減が主に供給制約によって促されたものであり、顧客がそれほど多くのメモリを必要としなくなったからではないということだ。
AI企業がより多くのDRAMを調達したいと考えても十分な供給を得られない場合、構成を下げることでシステムの納品を維持するのに役立つ。将来的に供給が増加すれば、メーカーは再び構成レベルを引き上げる動機を持つ。これは、現在満たされていない需要が一定の後続の調達余地を形成する可能性があることを意味する。
この判断に基づき、モルガン・スタンレーは短期的な価格上昇の最大幅よりも、ストレージ業界の景気サイクルの持続期間により注目している。AIモデルが継続的に拡大し、Agentアプリケーションが増加し続け、推論の同時実行数が成長し続ければ、DRAMメーカーが生産能力を引き上げても、新規供給は迅速に吸収される可能性がある。
したがって、モルガン・スタンレーはMicron(MU)とSanDisk(SNDK)に対するOverweight(増配当)評価を維持し、ストレージ供給の逼迫は急速には終わらないと見ている。
しかし、これはストレージ業界がサイクルリスクから完全に逃れられることを意味しない。リサーチレポートは、最も核心的なリスクは依然としてAI需要そのものから来ると考えている。モデル開発、推論アプリケーション、または計算投資の成長率が明らかに低下すれば、計算とストレージの産業チェーン全体が打撃を受ける可能性がある。
さらに、より複雑な状況も存在する。AI需要は依然として旺盛だが、データセンター建設が土地、電力、またはインフラの制約により遅延する場合である。このシナリオでは、ストレージ製品はすでに生産を完了していても、サーバー展開の遅れにより予想通りに消化されず、段階的な需給不均衡が生じる可能性がある。
モルガン・スタンレーは、このような建設ボトルネックがストレージメーカーに追加的な混乱をもたらし、短期的なパフォーマンスが一部の計算チップ企業と分化する可能性さえあると考えている。したがって、今後ストレージサイクルが継続できるかどうかを判断するには、DRAM価格とHBM受注だけでなく、AIインフラの実際の展開進捗も追跡する必要がある。
AIストレージ不足の最終的な影響は、産業がメモリ使用を減らすことではなく、業界に再決定を迫ることかもしれない。どのデータをHBMに残す必要があり、どれをDRAMやNANDに移行できるか、そしてどの計算タスクを異なる種類のチップに割り当てるべきか、である。
投資家にとって、次に注目すべき核心的な変数も徐々に明確になっている。Rubinの実際の出荷構成が低下するか、分離型推論が商業規模での展開を実現できるか、CXL製品が2027年に計画通りに量産できるか、そしてAIデータセンター建設が新規ストレージ供給を引き続き消化できるか、である。
これらの技術調整がAIシステムの展開を維持しつつ、長期的なストレージ需要が成長し続ければ、ストレージと相互接続の産業チェーンが共に恩恵を受ける可能性がある。しかし、AI投資が減速するか、電力と土地の制約がデータセンターの実現を妨げ続ければ、現在の需給逼迫も再価格設定に直面する可能性がある。
これこそが、モルガン・スタンレーが今回のAIストレージサイクルに対して下した最も重要な判断である。業界が真に解決すべきは、より多くのメモリを待つ方法ではなく、メモリが常に希少な状況下でAIの計算能力を拡大し続ける方法である。
BlockBeats の公式コミュニティに参加しよう:
Telegram 公式チャンネル:https://t.me/theblockbeats
Telegram 交流グループ:https://t.me/BlockBeats_App
Twitter 公式アカウント:https://twitter.com/BlockBeatsAsia