

AI レイヤー1 の探求: チェーン上での DeAI のための肥沃な土地 を探る
原文タイトル:《Biteye & PANews 共同で AI Layer 1 レポートを発表:オンチェーン DeAI の成長へ》
原文著者:@anci_hu49074(Biteye)、@Jesse_meta(Biteye)、@lviswang(Biteye)、@0xjacobzhao(Biteye)、@bz1022911(PANews)
概要
背景
近年、OpenAI、Anthropic、Google、Meta などの一流テクノロジー企業は、大規模言語モデル(LLM)の急速な発展を推進してきました。LLM はあらゆる業界で前代未聞の能力を示し、人間の想像力を大幅に拡張し、一部のシナリオでは人間の労働を代替する可能性さえ示しています。しかし、これらの技術の中核は数少ない中央集権的なテック巨大企業に厳格に握られています。資本力と高コストな計算リソースの支配により、これらの企業は乗り越えがたい障壁を築き、ほとんどの開発者やイノベーションチームがこれに対抗するのが困難になっています。
Source: BONDAI Trends Analysis Report
同時に、AI の急速な進化の初期段階では、技術の進歩や利便性に焦点が当てられがちであり、プライバシー保護、透明性、セキュリティなどの中心的な問題に対する関心は比較的低いです。長期的には、これらの問題がAI業界の健全な発展と社会的受容度に重大な影響を与えるでしょう。これらの問題が適切に解決されない場合、AIの「善」または「悪」への論争はますます顕著になり、中央集権の巨大企業はしばしばこれらの課題に対処するための十分な動機を持っていません。
ブロックチェーン技術は、その非中心化、透明性、検閲耐性の特性により、AI業界の持続可能な発展に新たな可能性をもたらしています。現在、Solana、Base などの主要ブロックチェーン上には多くの「Web3 AI」アプリケーションが出現しています。ただし、深く掘り下げると、これらのプロジェクトにはまだ多くの課題が存在します。一方で、非中心化の度合いが限定されており、主要な部分やインフラストラクチャは依然として中央集権的なクラウドサービスに依存しており、ミーム要素が強すぎて、真の意味でのオープンエコシステムを支えることが困難です。もう一方では、Web2世界のAI製品と比較して、オンチェーンAIはモデルの能力、データ利用、アプリケーションシーンなどの点でまだ局所的であり、イノベーションの深さと幅が向上する余地があります。
真の意味での分散型AIのビジョンを実現し、ブロックチェーンが大規模なAIアプリケーションを安全かつ効率的に民主的にホストし、パフォーマンス面で中央集権的なソリューションに対抗できるようにするには、AIに特化したLayer1ブロックチェーンを設計する必要があります。これにより、AIのオープンイノベーション、民主的なガバナンス、データセキュリティが堅固な基盤を提供し、分散型AIエコシステムの繁栄を推進します。
AI Layer 1 のコア機能
AI Layer 1 は、AI アプリケーション向けに特別に設計されたブロックチェーンであり、その基盤アーキテクチャとパフォーマンス設計は AI タスクのニーズに密接に結びついており、チェーン上の AI エコシステムの持続可能な発展と繁栄を効果的にサポートすることを目指しています。具体的には、AI Layer 1 には以下のコア機能が備わっている必要があります:
効率的なインセンティブと分散コンセンサスメカニズム
AI Layer 1 の中核は、オープンな計算リソース、ストレージなどの共有ネットワークを構築することです。従来のブロックチェーンノードが主に台帳の記録に焦点を当てていたのに対し、AI Layer 1 のノードはより複雑なタスクを担当する必要があります。これらのノードは、単に計算リソースを提供し、AI モデルのトレーニングと推論を完了するだけでなく、ストレージ、データ、帯域幅など多様なリソースを提供し、AI インフラストラクチャにおける中心化巨大企業の独占を打破する必要があります。これは、基盤となるコンセンサスおよびインセンティブメカニズムに対してより高度な要求を提起しています:AI Layer 1 は、ノードがAI推論、トレーニングなどのタスクで実際に果たした貢献を正確に評価し、インセンティブ付与し、検証できる必要があります。これにより、ネットワークの安定性とリソースの効率的な配分を実現することができます。これにより、ネットワークの安定性と繁栄を確保し、全体的な計算リソースコストを効果的に低減できます。
優れた高性能とヘテロジニアスタスクサポート能力
特に、LLMのトレーニングと推論は、計算パフォーマンスと並列処理能力に非常に高い要求を実際しています。さらに、チェーン上のAIエコシステムは、さまざまな、異種のタスクタイプをサポートする必要があります。これには、異なるモデル構造、データ処理、推論、ストレージなど、多様なシナリオが含まれます。AI Layer 1 は、基盤のアーキテクチャが高スループット、低レイテンシ、弾力的並列処理などの要件に焦点を当て、異種計算リソースのネイティブサポート能力を予め組み込む必要があります。これにより、あらゆる種類のAIタスクが効率的に実行され、単一タスクから複雑な多様なエコシステムへのスムーズな拡張が実現されます。
検証可能性と信頼性の出力保証
AI Layer 1 は、モデルの悪意、データの改ざんなどのセキュリティリスクを防ぐだけでなく、AI 出力結果の検証可能性と整合性を基盤メカニズムから確保する必要があります。信頼できる実行環境(TEE)、ゼロ知識証明(ZK)、多当事者安全計算(MPC)などの先進技術を統合することで、プラットフォームは、各モデル推論、トレーニング、データ処理プロセスが独立して検証可能であることを確認し、AIシステムの公正性と透明性を確保します。また、このような検証可能性は、ユーザーがAIプロダクトのロジックと根拠を明確に把握し、得られる成果が望ましいものであることを確信し、ユーザーのAI製品への信頼と満足度を向上させるのに役立ちます。
データプライバシー保護
AI アプリケーションはしばしばユーザーの機密データに関わり、金融、医療、ソーシャルなどの領域では、データのプライバシー保護が特に重要です。AI レイヤー 1 は検証可能性を確保する一方、暗号化を基盤としたデータ処理技術、プライバシー保護プロトコル、データアクセス管理などの手段を採用し、データの推論、トレーニング、およびストレージ全般でのセキュリティを確保し、データ漏えいや悪用を効果的に防止し、ユーザーがデータセキュリティについて不安を感じることを排除します。
強力なエコシステムのホスティングと開発支援能力
AI ネイティブの Layer 1 インフラストラクチャとして、プラットフォームは技術的リーダーシップだけでなく、開発者、ノードオペレータ、AI サービスプロバイダなどのエコシステム参加者に対して、包括的な開発ツール、SDK 統合、運用サポート、およびインセンティブメカニズムを提供する必要があります。プラットフォームの利用可能性と開発者体験を継続的に最適化することで、多様な AI ネイティブアプリケーションの実装を促進し、非中央集権化された AI エコシステムの持続的繁栄を実現します。
上記の背景と期待に基づいて、本文では、Sentient、Sahara AI、Ritual、Gensyn、Bittensor、および 0G を含む 6 つの AI Layer1 代表プロジェクトについて詳細に説明し、競争の最新動向を整理し、プロジェクトの現状を分析し、将来のトレンドを探ります。
Sentient: Building a Loyal Decentralized AI Model
Project Overview
Sentient is an open-source protocol platform that is building an AI Layer1 blockchain (initially at Layer 2, later migrating to Layer 1), creating a decentralized artificial intelligence economy by combining AI Pipelines and blockchain technology. Its core goal is to solve the issues of model ownership, invocation tracking, and value distribution in a centralized LLM market through the 'OML' framework (Open, Monetizable, Loyal), enabling AI models to achieve on-chain ownership structure, invocation transparency, and value sharing. Sentient's vision is to enable anyone to build, collaborate, own, and monetize AI products, thus driving a fair and open AI Agent network ecosystem.
The Sentient Foundation team has brought together top global academic experts, blockchain entrepreneurs, and engineers to build a community-driven, open-source, and verifiable AGI platform. Core members include Princeton University professor Pramod Viswanath and Indian Institute of Science professor Himanshu Tyagi, responsible for AI security and privacy protection, led by Polygon co-founder Sandeep Nailwal for blockchain strategy and ecosystem layout. Team members come from prominent companies such as Meta, Coinbase, Polygon, as well as top universities like Princeton University, Indian Institute of Technology, covering AI/ML, NLP, computer vision, and other fields, collaborating to drive project implementation.
Polygon 共同創設者 Sandeep Nailwal 的再創業項目 Sentient 在成立之初便自帶光環,擁有豐富的資源、人脈和市場認知度,為項目發展提供了強大背書。2024 年中,Sentient 完成了 8500 萬美元的種子輪融資,由 Founders Fund、Pantera 和 Framework Ventures 領投,其他投資機構包括 Delphi、Hashkey 和 Spartan 等數十家知名 VC。
設計架構與應用層
1、基礎層
核心架構
Sentient 的核心架構由 AI 管道(AI Pipeline)和 區塊鏈系統 兩部分組成:
AI 管道是開發和訓練「忠誠 AI」 工件的基礎,包含兩個核心過程:
· 數據策劃(Data Curation):由社區驅動的數據選擇過程,用於模型的對齊。
· 忠誠度訓練(Loyalty Training):確保模型保持與社區意圖一致的訓練過程。
區塊鏈系統為協議提供透明性和去中心化控制,確保 AI 工件的所有權、使用追踪、收益分配與公平治理。具體架構分為四層:
· 存儲層:存儲模型權重與指紋註冊信息;
· 分發層:授權合約控制模型調用入口;
· 訪問層:通過權限證明驗證用戶是否授權;
· 刺激層:收益路由合約將每次調用支付分配給訓練者、部署者與驗證者。
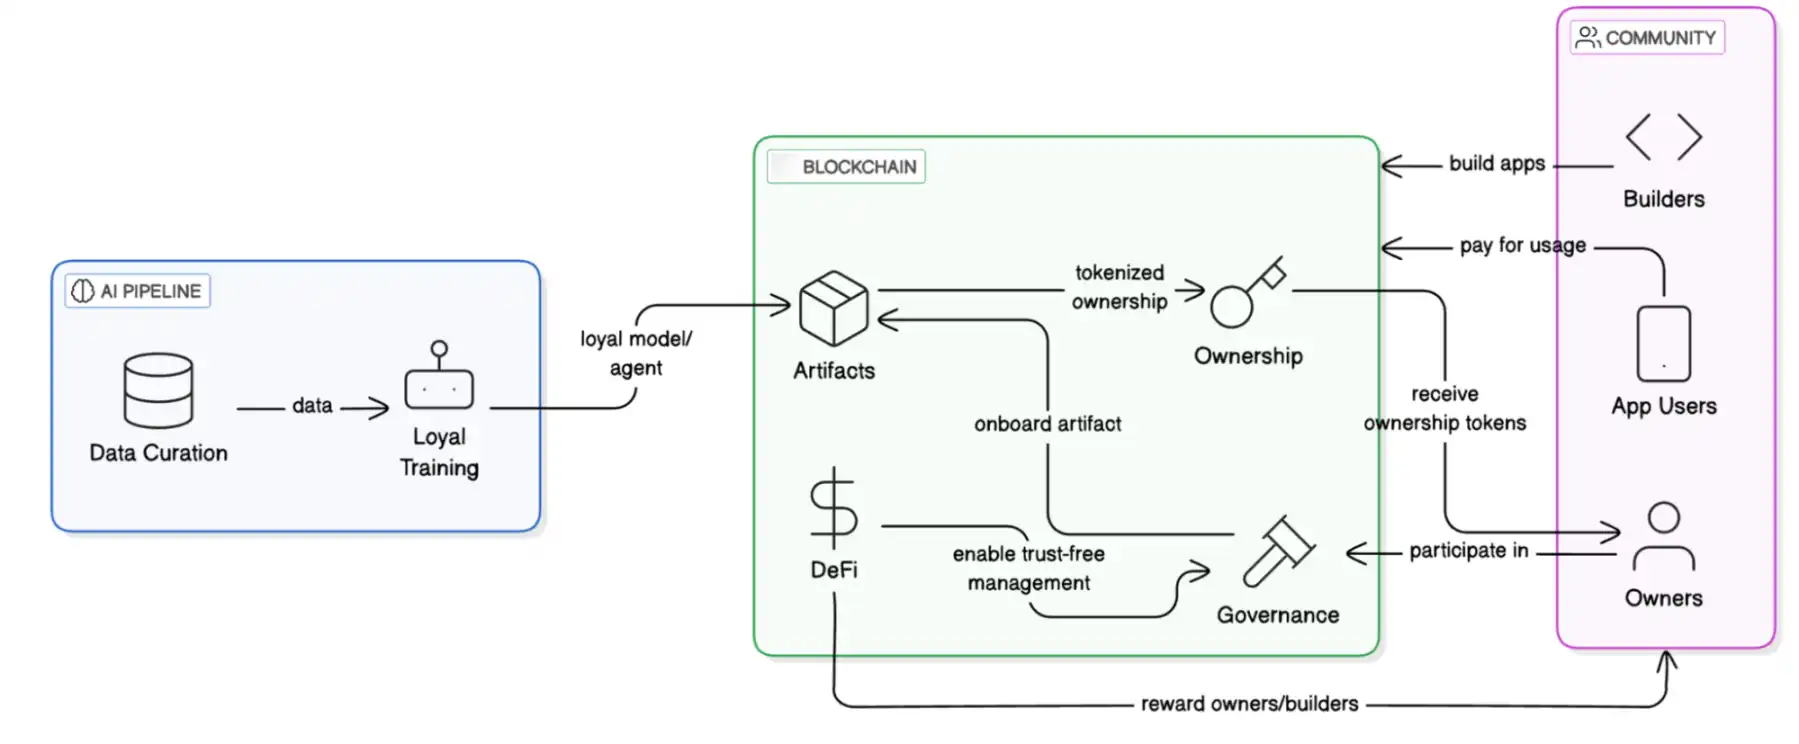
Sentient 系統工作流程圖
OML 模型框架
OML 框架(開放 Open、可貨幣化 Monetizable、忠誠 Loyal)是 Sentient 提出的核心理念,旨在為開源 AI 模型提供明確的所有權保護和經濟激勵機制。通過結合鏈上技術和 AI 原生加密學,具有以下特點:
· オープン性: モデルはオープンソースであり、コードとデータ構造が透明であり、コミュニティが再現、監査、および改善を容易に行える必要があります。
· 通貨化: 各モデル呼び出しは収益のフローを引き起こし、オンチェーン契約は収益をトレーナー、展開者、および検証者に分配します。
· 忠誠心: モデルは貢献者コミュニティに帰属し、アップグレードの方向性とガバナンスは DAO によって決定され、使用と変更は暗号メカニズムの制御を受けます。
AI ネイティブ暗号学(AI-native Cryptography)
AI ネイティブ暗号学は、AIモデルの連続性、低次元多様体構造、およびモデル微分可能性を活用して、「検証可能でかつ削除不可能」な軽量セキュリティメカニズムを開発します。その主要技術は次のとおりです:
· フィンガープリント埋め込み: トレーニング中に一連の秘匿されたクエリ-レスポンスキー値ペアを挿入して、モデル固有の署名を形成します;
· 所有権検証プロトコル: 第三者プルーバー(Prover)によってクエリ形式で指紋が保持されているかを検証します;
· 許可呼び出しメカニズム: 呼び出し前にモデル所有者から発行された「権限証明書」を取得する必要があり、システムはそれに基づいて入力をモデルに復号化させて正確な答えを返します。
この方法により、「行動ベースの認証呼び出し + 所有権検証」を重加密費用なしで実現できます。
モデル権利とセキュア実行フレームワーク
Sentient が現在採用しているのは、Melange ミックスセキュリティです: フィンガープリント権利、TEE 実行、オンチェーン契約リワードを組み合わせたものです。フィンガープリントメソッドは OML 1.0 をベースにしており、「楽観的セキュリティ(Optimistic Security)」のアプローチを強調しています。つまり、デフォルトはコンプライアンスであり、違反が検出および処罰可能です。
フィンガープリントメカニズム は OML の主要な実装であり、トレーニング段階で特定の「問題 - 回答」ペアを埋め込むことで、モデルを一意の署名が生成されるようにします。これらの署名により、モデル所有者は所属を検証し、許可されていないコピーと商業化を防止します。このメカニズムは、モデル開発者の権利を保護するだけでなく、使用行動に対してトレース可能なオンチェーンレコードを提供します。
さらに、Sentient は Enclave TEE 実行フレームワークを導入し、信頼できる実行環境(例:AWS Nitro Enclaves)を使用して、モデルが許可されたリクエストのみに応答し、許可されていないアクセスや使用を防止します。TEE はハードウェアに依存し、一定のセキュリティリスクがありますが、その高いパフォーマンスとリアルタイム性の利点から、現在のモデル展開の中核技術となっています。
将来、Sentient はゼロ知識証明(ZK)および全同型暗号(FHE)技術を導入する予定で、プライバシー保護と検証性をさらに向上させ、AI モデルの分散展開により熟成したソリューションを提供します。
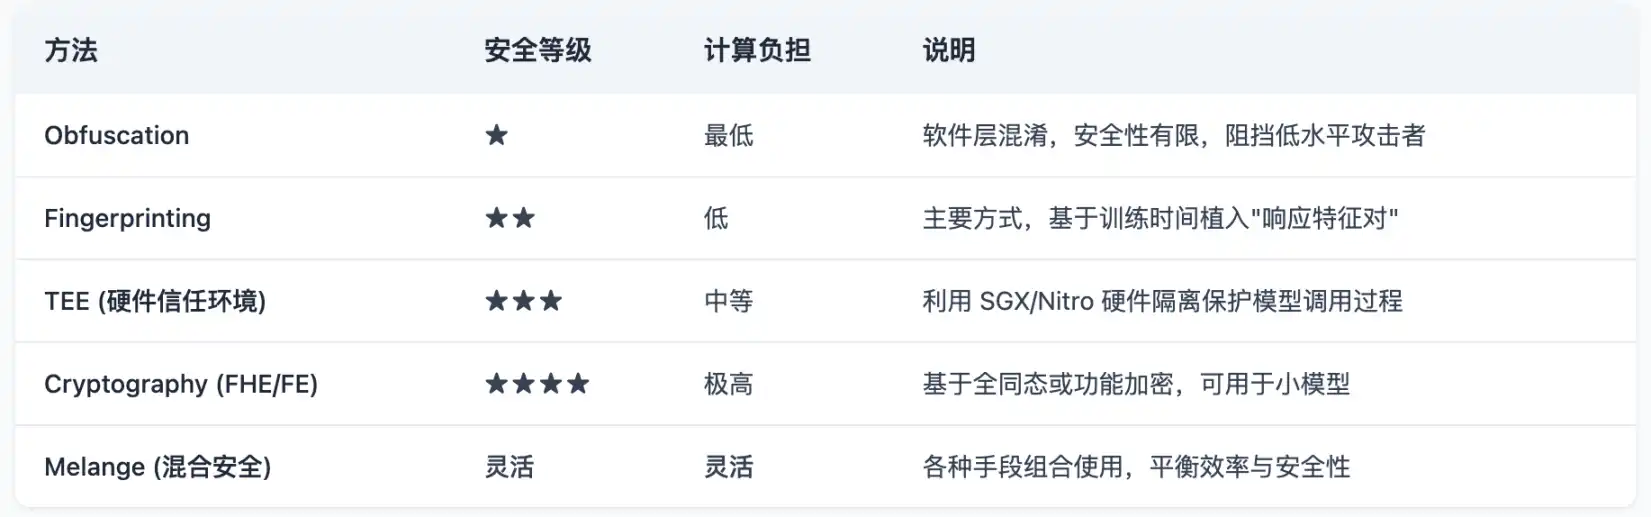
OML が提案する 5 つの検証方法の評価と比較
2. アプリケーションレイヤー
現在、Sentient の製品には、分散型チャットプラットフォーム Sentient Chat、オープンソースモデル Dobby シリーズ、および AI エージェントフレームワークが主に含まれています。
Dobby シリーズモデル
SentientAGI は複数の「Dobby」シリーズモデルをリリースしており、これらは主に Llama モデルに基づいており、自由、分散化、および暗号通貨サポートに焦点を当てています。そのうち、leashed バージョンは比較的制約のある合理的なスタイルであり、安定した出力のシナリオに適しています。一方、unhinged バージョンはより自由で大胆なスタイルを持ち、より豊かな対話スタイルを備えています。Dobby モデルは既に Firework AI や Olas などの複数の Web3 ネイティブプロジェクトに統合されており、ユーザーは Sentient Chat でこれらのモデルを直接呼び出してインタラクションできます。Dobby 70B は史上最も分散化されたモデルであり、60 万人以上の所有者(Dobby フィンガープリント NFT を保有している人々は同時にそのモデルの共同所有者でもあります)を有しています。
Sentient はさらに、Open Deep Search を発表する予定であり、これは ChatGPT や Perplexity Pro を超えようとする検索エージェントシステムです。このシステムは、Sensient の検索機能(クエリの再表現、ドキュメント処理など)を推論エージェントと組み合わせ、オープンソースの LLM(Llama 3.1 や DeepSeek など)によって検索品質を向上させます。Frames Benchmark では、そのパフォーマンスが他のオープンソースモデルを上回っており、一部のプロプライエタリモデルに近づいており、強力なポテンシャルを示しています。
Sentient Chat: 分散型チャットとオンチェーン AI エージェントの統合
Sentient Chat は分散型チャットプラットフォームであり、オープンソースの大規模言語モデル(Dobby シリーズなど)と先進的な推論エージェントフレームワークを組み合わせ、複数のエージェントの統合と複雑なタスクの実行をサポートしています。プラットフォームに組み込まれた推論エージェントは、検索、計算、コード実行などの複雑なタスクを完了し、ユーザーに効率的なインタラクティブ体験を提供します。さらに、Sentient Chat はオンチェーンインテリジェントエージェントの直接統合をサポートしており、現在は星読みエージェント Astro247、暗号分析エージェント QuillCheck、ウォレット分析エージェント Pond Base Wallet Summary、および霊的ガイダンスエージェント ChiefRaiin が含まれています。ユーザーは必要に応じて異なるインテリジェントエージェントを選択してインタラクションすることができます。Sentient Chat はエージェントの配布および調整プラットフォームとして使用されます。ユーザーの質問は、任意の統合済みモデルやエージェントにルーティングされ、最適な応答結果を提供します。
AI エージェント フレームワーク
Sentient は2つの主要な AI エージェント フレームワークを提供しています:
・ Sentient エージェント フレームワーク: 自然言語命令を使用して Web タスクの自動化(検索、ビデオ再生など)を実現することに焦点を当てた軽量オープンソース フレームワークです。このフレームワークは、知覚、計画、実行、フィードバックのクローズドループを持つエージェントを構築するためのサポートを提供し、オンチェーン Web タスク向けに軽量な開発に適しています。
・ Sentient ソーシャル エージェント: Twitter、Discord、Telegram などのソーシャル プラットフォーム向けに開発された AI システムであり、自動化されたインタラクションとコンテンツ生成をサポートしています。複数のエージェントが協力して、このフレームワークはソーシャル環境を理解し、ユーザーによりスマートなソーシャル体験を提供します。また、Sentient エージェント フレームワークと統合し、そのアプリケーション範囲をさらに拡大することができます。
エコシステムと参加方法
Sentient Builder Program には現在、100 万ドルの補助金プログラムが設けられており、開発者が開発キットを利用して、Sentient エージェント API にアクセスし、Sentient Chat エコシステムで実行できる AI エージェントを構築することを奨励しています。Sentient のウェブサイトに公表されているエコパートナーは、暗号 AI 多くの領域のプロジェクト チームをカバーしており、以下のとおりです
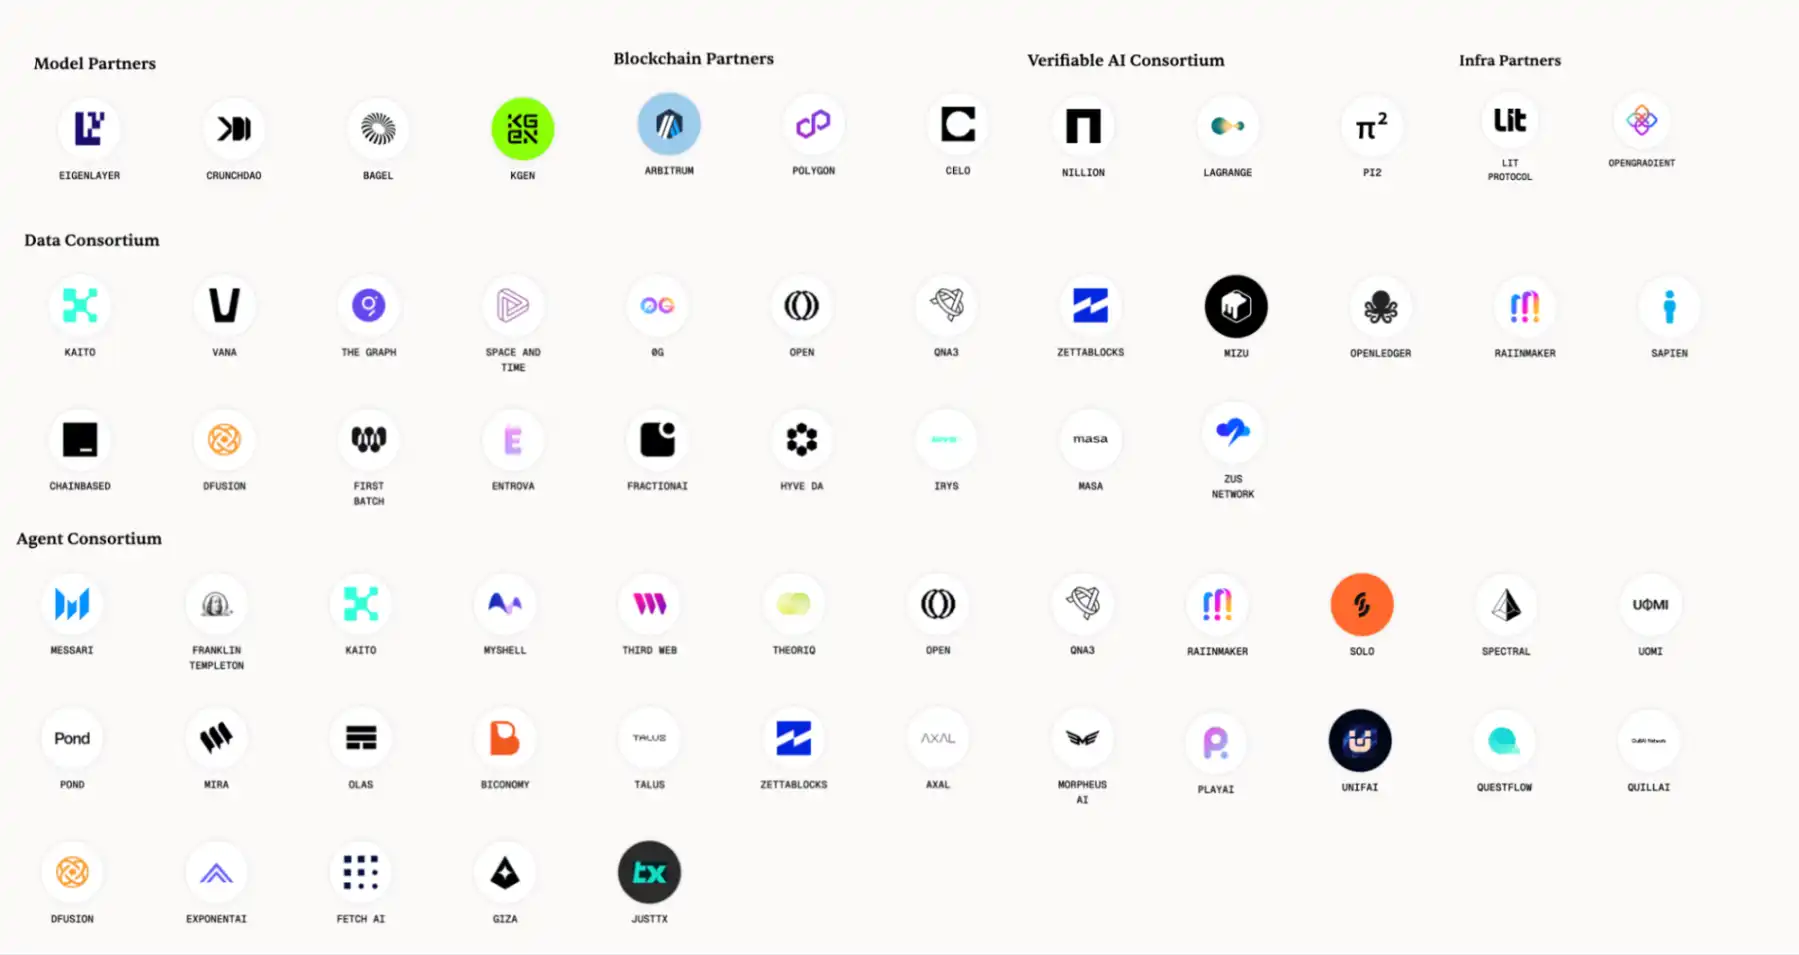
Sentient エコシステム図
さらに、Sentient Chat は現在テスト段階にあり、ホワイトリストに招待コードを使用してのみアクセスできます。一般ユーザーは待機リストを提出することができます。公式情報によると、すでに 50,000 人を超えるユーザーと 1,000,000 回のクエリ レコードがあります。Sentient Chat のリストには、2,000,000 人のユーザーが参加を待っています。
挑戦と展望
Sentient はモデルレベルから取り組み、現在の大規模言語モデル(LLM)が直面する整合性のない、信頼性のないなどの基本的な問題を解決し、OML フレームワークとブロックチェーン技術により、モデルに明確な所有権構造、使用追跡、および行動制約を提供することで、分散型オープンソース モデルの発展を大幅に推進しています。
Polygon 共同創設者 Sandeep Nailwal 的支援資源以及頂尖風險投資機構和行業夥伴的背書,使 Sentient 在資源整合和市場關注度方面處於領先地位。然而,在當前市場逐漸對高估值項目失去興趣的情況下,Sentient 能否交付真正具有影響力的去中心化人工智能產品,將成為其能否成為去中心化人工智能所有權標準的重要考驗。這些努力不僅關乎 Sentient 自身的成功,還關乎整個行業的信任重建和去中心化發展的深遠影響。
Sahara AI:打造人人參與的去中心化人工智能世界
項目概述
Sahara AI 是一個為 AI × Web3 新範式而生的去中心化基礎設施,致力於構建一個開放、公平且合作的人工智能經濟。該項目通過去中心化帳本技術,實現數據集、模型和智能 Agent 的鏈上管理和交易,確保數據和模型的所有權和可追溯性。同時,Sahara AI 引入透明、公平的激勵機制,讓所有貢獻者,包括數據提供者、標註員和模型開發者,在合作過程中獲得不可篡改的收入回報。平台還通過一個無需許可的「版權」系統,保護貢獻者對人工智能資產的所有權和歸屬,並鼓勵開放共享和創新。
Sahara AI 提供從數據收集、標註到模型訓練、人工智能 Agent 創建、人工智能資產交易等服務的一站式解決方案,覆蓋整個人工智能生命週期,成為滿足人工智能開發需求的全方位生態平台。其產品質量和技術能力已獲得微軟、亞馬遜、麻省理工學院(MIT)、Motherson 集團和 Snap 等全球頂尖企業和機構的高度認可,展現出強大的行業影響力和廣泛的應用性。
Sahara 不僅僅是一個科研項目,而是由一線技術創業者與投資人共同推動、具有落地導向的深科技平台。其核心架構有可能成為 AI × Web3 應用落地的關鍵支點。Sahara AI 已獲得 Pantera Capital、Binance Labs、紅杉中國等頂尖機構累計 4,300 萬美元的投資支持;由南加州大學終身教授、2023 年度三星研究員 Sean Ren 和前 Binance Labs 投資總監 Tyler Zhou 共同創立,核心團隊成員來自史丹佛大學、加州大學柏克萊分校、微軟、谷歌、Binance 等頂尖機構,融合了學術界與產業界的深厚積累。
デザインアーキテクチャ
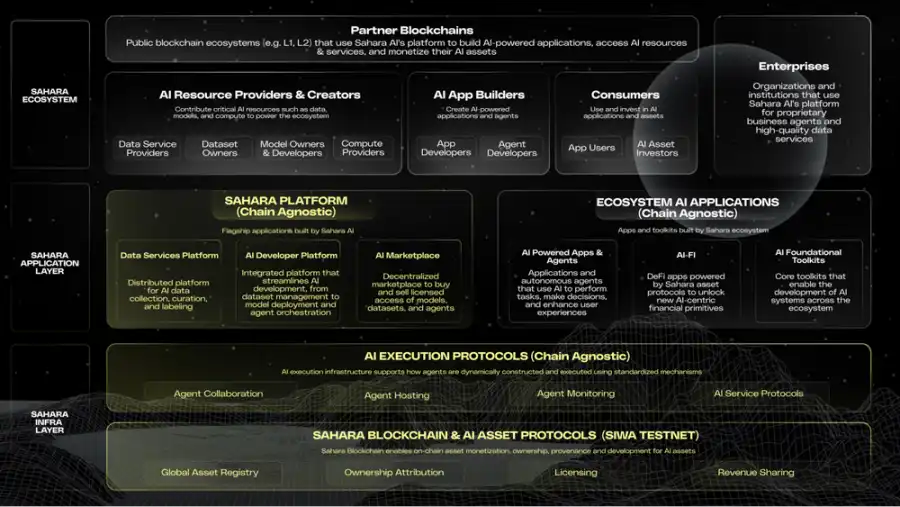
Sahara AI アーキテクチャ図
1. ベースレイヤー
Sahara AI のベースレイヤーには、1. AI アセットの登録と実現のためのオンチェーンレイヤー、2. エージェントとAIサービスの実行に使用されるオフチェーンレイヤーがあります。オンチェーンシステムとオフチェーンシステムが協調してAIアセットの登録、権利の確定、実行、収益配分を担当し、AIライフサイクル全体の信頼できる協力をサポートしています。
Sahara BlockchainとSIWAテストネット(オンチェーンインフラ)
SIWAテストネットは、Sahara Blockchainの最初のパブリックバージョンです。 Sahara Blockchain Protocol(SBP)は、 Sahara Blockchainのコアであり、AIのために特別に設計されたスマートコントラクトシステムであり、AIアセットのオンチェーンの所有権、トレーサビリティの記録、および収益配分を実現しています。コアモジュールには、アセット登録システム、所有権プロトコル、貢献の追跡、アクセス管理、収益分配、実行証明などが含まれており、「AI向けのオンチェーンオペレーティングシステム」が構築されています。
AI実行プロトコル(オフチェーンインフラ)
モデルの実行と呼び出しの信頼性をサポートするために、SaharaはオフチェーンのAI実行プロトコル体系を構築しました。 信頼できる実行環境(TEE)を組み合わせ、エージェントの作成、展開、実行、共同開発をサポートしています。各タスクの実行はすべて検証可能な記録が自動生成され、オンチェーンにアップロードされ、プロセス全体が追跡および検証可能であることを確認しています。オンチェーンシステムは登録、承認、所有権記録を担当し、オフチェーンのAI実行プロトコルは、AIエージェントのリアルタイム実行とサービスインタラクションをサポートします。 Saharaはクロスチェーン互換性を備えているため、Sahara AIに基づくインフラストラクチャ構築アプリケーションは、どのブロックチェーン上でも、さらにはオフチェーン上に展開できます。
2. アプリケーションレイヤー
Sahara AIデータサービスプラットフォーム(DSP)
データサービスプラットフォーム(DSP)はSaharaアプリケーションレイヤーの基本モジュールであり、誰もがSahara IDを介してデータタスクを受け入れ、データ注釈、ノイズ除去、審査に参加し、寄与証拠としてチェーン上ポイント(Sahara Points)を獲得できます。このメカニズムは、データのトレーサビリティと所有権を保証するだけでなく、「貢献 - 報酬 - モデルの最適化」を促進し、クローズドループを形成しています。現在、第4四半期の活動が行われており、これは一般ユーザーが貢献できる主要な方法です。
この基盤の上で、ユーザーに高品質なデータとサービスを提供することを奨励するため、二重インセンティブメカニズムを紹介することで、Saharaからの報酬だけでなく、エコシステムパートナーから追加のリターンを受け取ることができ、一貢献者、複数利益相反の実現が可能となっています。データ貢献者の例を挙げると、そのデータがモデルに繰り返し呼び出されるか、新しいアプリケーションを生成するために使用されると、収益を継続的に獲得することができ、AI価値連鎖に本当に参加することになります。このメカニズムにより、データ資産の寿命が延長されるだけでなく、協力と共同構築に強力なエネルギーが注入されます。例えば、BNB Chain上のMyShellはDSPクラウドファンディングを通じてカスタムデータセットを生成し、モデルのパフォーマンスを向上させ、ユーザーはMyShellトークン報酬を受け取り、ウィンウィンのループを形成します。
AI企業はデータサービスプラットフォーム上でクラウドソーシングされたカスタムデータセットを作成することができ、専用のデータタスクを公開することで、世界中のデータ注釈者から迅速に応答を得ることができます。AI企業はもはや従来の中央集権型データプロバイダーに依存する必要はなく、高品質な注釈データを大規模に入手できます。
Sahara AI Developer Platform
Sahara AI Developer Platformは、開発者と企業向けのオールインワンのAIビルドおよびオペレーションプラットフォームであり、データ取得からモデルトレーニング、デプロイメント実行、アセットマネタイズまでのフルプロセスサポートを提供しています。ユーザーはSahara DSP内の高品質データリソースに直接アクセスし、モデルのトレーニングと微調整に使用できます。完成したモデルはプラットフォーム内で組み込み、登録され、AIマーケットに掲載され、Saharaブロックチェーンを介して所有権を確定し、柔軟なライセンス付与を実現できます。
Studioは分散計算能力を統合し、モデルトレーニングとエージェントのデプロイメント実行をサポートし、計算プロセスのセキュリティと検証可能性を確保します。開発者はまた、重要なデータとモデルを保存し、暗号化されたホスティングとアクセス制御を行うことで、不正アクセスを防ぐことができます。Sahara AI Developer Platformを通じて、開発者はインフラストラクチャを自前で構築する必要なく、より低いハードルでAIアプリケーションを構築、デプロイ、商業化することができ、プロトコルメカニズムを介してブロックチェーン上のAI経済システムに完全に統合できます。
AI Marketplace
Sahara AI Marketplaceは、モデル、データセット、AIエージェント向けの分散型アセットマーケットです。このマーケットは、アセットの登録、取引、ライセンス付与をサポートするだけでなく、透明性と追跡可能性のある収益配分メカニズムを構築しています。開発者は、自分の構築したモデルや収集したデータセットをオンチェーンアセットとして登録し、柔軟な使用ライセンスと収益配分率を設定することができます。システムは呼び出し頻度に応じて収益の精算を自動的に実行します。データ貢献者も、自らのデータが繰り返し呼び出されることにより継続的に収益を得ることができ、持続的な収益化を実現します。
この市場は Sahara ブロックチェーンプロトコルと深く統合されており、すべての資産取引、呼び出し、収益配当記録はチェーン上で検証可能となっており、資産の帰属が明確で収益が追跡可能となっています。この市場を利用することで、AI 開発者は従来の API プラットフォームや中心集権型モデルホスティングサービスに依存する必要がなくなり、自律的でプログラム可能なビジネスパスを持つことができます。
3. エコシステムレイヤー
Sahara AI のエコシステムレイヤーは、データプロバイダー、AI 開発者、消費者、企業ユーザー、およびクロスチェーンパートナーを結びつけています。データの提供、アプリの開発、製品の使用、企業内での AI 化推進に関わらず、誰もが効果を発揮し、収益モデルを見つけることができます。データのラベリング担当者、モデル開発チーム、および算力提供者は、自らのリソースをチェーン上のアセットとして登録し、Sahara AI のプロトコルメカニズムを通じて権限管理と収益配分を行うことができ、利用されるたびにリソースが自動的に報酬を受け取ることができます。開発者は、データの接続、モデルのトレーニング、エージェントの展開を行い、AI Marketplace で直接成果物をビジネス化することができます。
一般ユーザーは技術的背景を必要とせず、データタスクに参加したり、AI アプリを使用したり、チェーン上アセットを収集または投資したりして、AI 経済の一部となることができます。企業にとって、Sahara はデータクラウドソーシングからモデル開発、プライベートデプロイメント、収益化までのフルサポートを提供しています。さらに、Sahara はクロスチェーン展開をサポートしており、どんなパブリックチェーンエコシステムも Sahara AI が提供するプロトコルとツールを使用して、AI アプリケーションを構築し、分散型 AI アセットにアクセスし、多チェーンワールドとの互換性と拡張性を実現しています。これにより、Sahara AI は単なる単一プラットフォームにとどまらず、チェーン上の AI エコシステムの基盤となる共同規格となっています。
エコシステムの進展
Sahara AI はプロジェクト開始以来、AI ツールセットや算力プラットフォームのみならず、AI の生産と配布秩序をチェーン上で再構築し、誰もが参加し、権限を持ち、貢献し、共有することができる分散型コラボレーションネットワークを構築しています。そのため、Sahara はブロックチェーンを基盤として選択し、AI のために検証可能、追跡可能、配分可能な経済システムを構築しています。
この中心的目標を軸に、Sahara のエコシステムは着実な進展を遂げています。まだプライベートテスト段階にあるにもかかわらず、プラットフォームはすでに 320 万を超えるチェーン上アカウントを生成し、日ごとのアクティブアカウントは 140 万以上をキープしており、ユーザーの参加度とネットワークの活気を示しています。そのうち 20 万人以上のユーザーが Sahara データサービスプラットフォームを通じてデータラベリング、トレーニング、検証タスクに参加し、チェーン上のインセンティブ報酬を受け取りました。同時に、数百万人のユーザーがホワイトリストへの参加を待っており、分散型 AI プラットフォームへの市場の強い需要と合意を裏付けています。
企業コラボレーションでは、Sahara はすでに、Microsoft、Amazon、マサチューセッツ工科大学(MIT)など、世界をリードする機関と提携し、カスタマイズされたデータ収集および注釈サービスを提供しています。企業はプラットフォームを通じて特定のタスクを提出し、Sahara のグローバルデータアノテーターネットワークが効率的に実行し、スケーラブルなクラウドソーシングを実現し、実行効率、柔軟性、多様なニーズのサポートを提供しています。
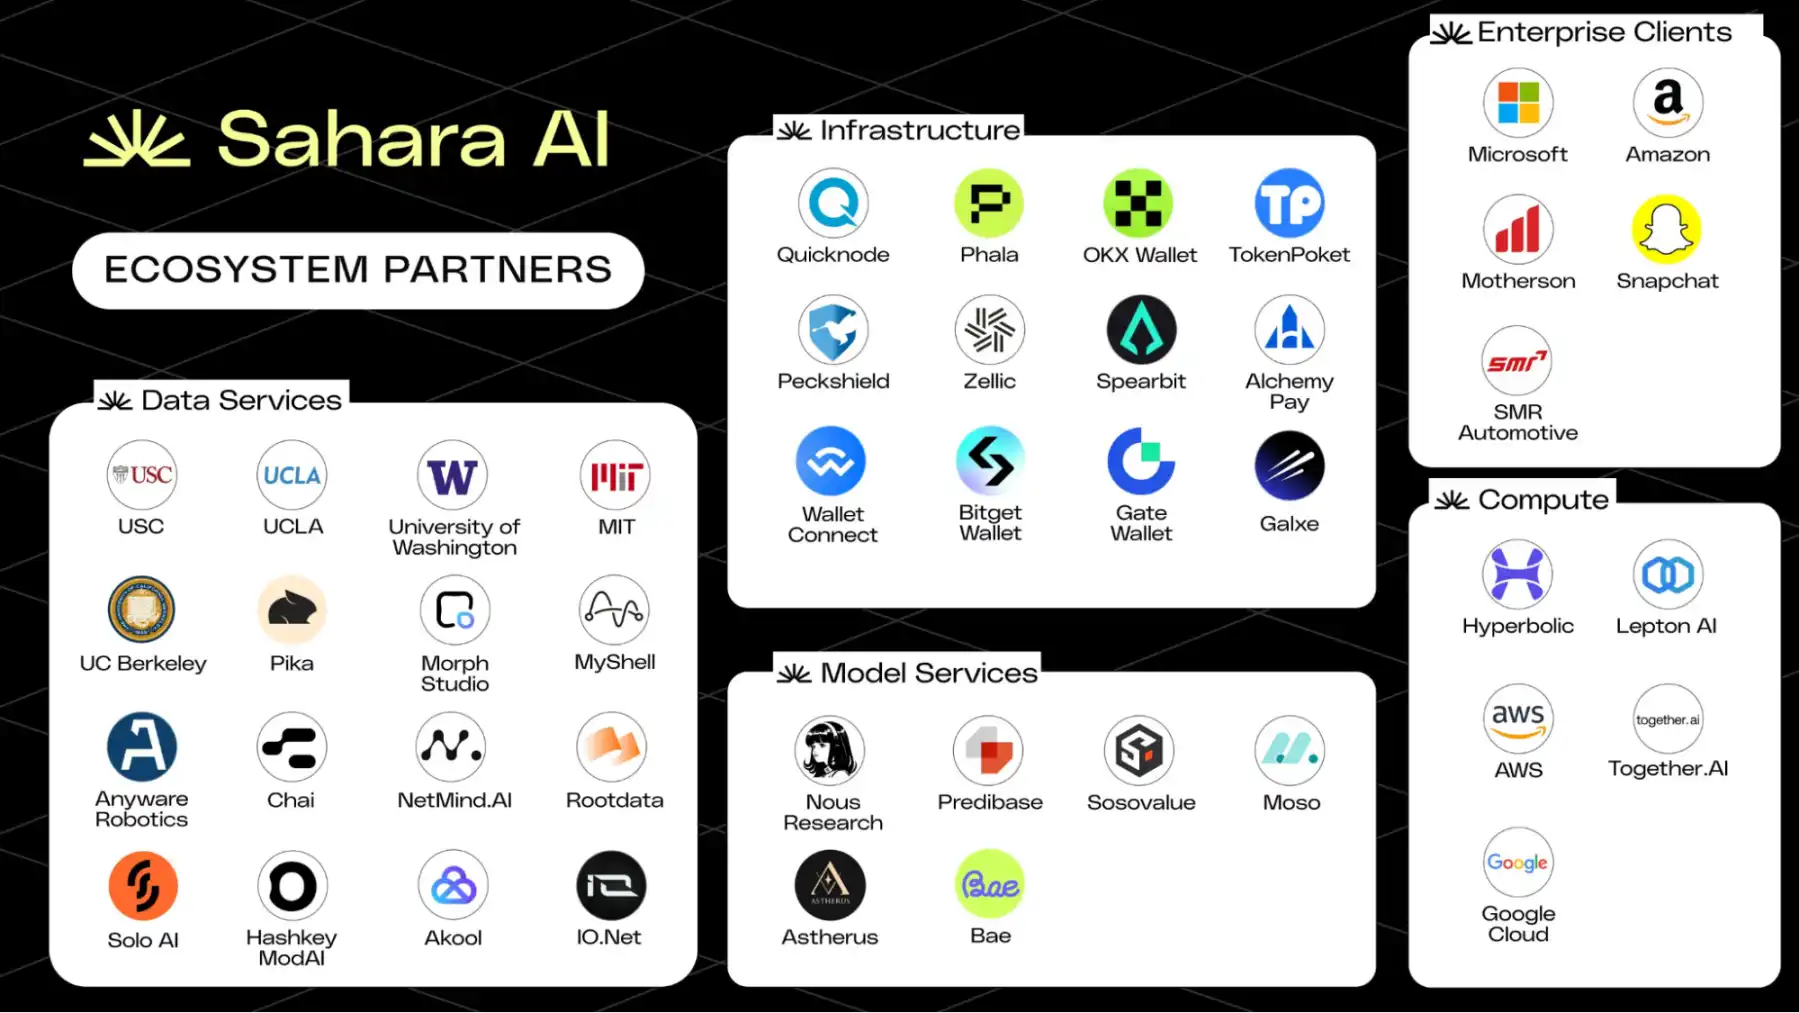
Sahara AI エコシステム図
参加方法
SIWA は 4 つの段階に分かれて展開されます。現在、第 1 段階はオンチェーンデータの所有権の確立であり、貢献者は自身のデータセットを登録してトークン化することができます。現時点では一般に公開されており、ホワイトリストは必要ありません。AI に有益なデータをアップロードし、盗用や不適切なコンテンツをアップロードしないようにする必要があります。第 2 段階では、データセットとモデルのオンチェーンによる収益化が実現されます。第 3 段階では、テストネットが公開され、オープンソースのプロトコルがリリースされます。第 4 段階では、AI データフローの登録、トレーサビリティ、および貢献の証明メカニズムが導入されます。
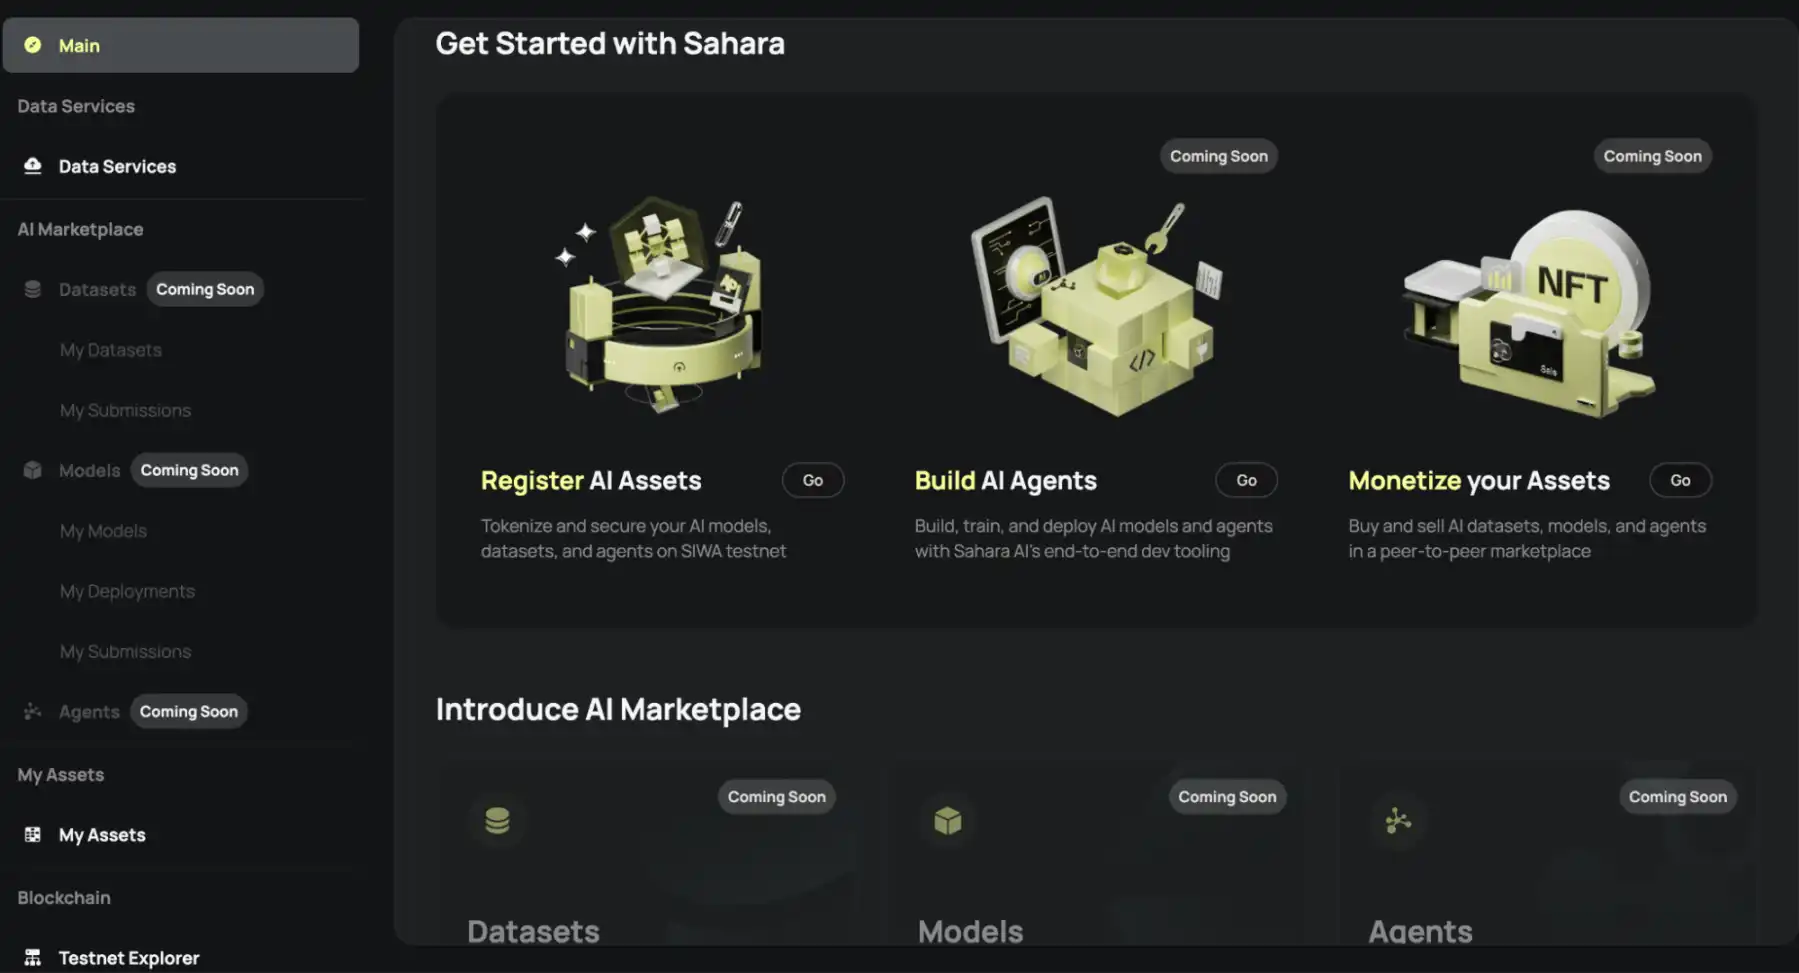
SIWA テストネット
SIWA テストネットに加えて、一般ユーザーは現在、Sahara Legends に参加することができ、ゲーミフィケーションされたタスクを通じて Sahara AI の機能を理解することができます。タスクを完了すると、ガーディアンフラグメントを獲得し、最終的にネットワークへの貢献を記録する NFT を作成できます。
また、データサービスプラットフォームでデータを注釈付けし、価値のあるデータを提供し、および審査員を務めることもできます。Sahara は、将来、エコシステムパートナーと協力してタスクを公開し、参加者が Sahara のポイントだけでなくエコシステムパートナーからのインセンティブも受け取れるようにする予定です。最初のダブルリワードタスクは、Myshell と共同で実施され、ユーザーがタスクを完了すると、Sahara のポイントと Myshell のトークン報酬を受け取れます。ロードマップに従うと、Sahara は 2025 年第 3 四半期にメインネットを立ち上げる予定であり、その時点で TGE も実施される可能性があります。
課題と展望
Sahara AI は、AI を開発者や大手 AI 企業に限定するのではなく、AI をよりオープンで包括的、民主的にします。一般ユーザーにとって、プログラミング知識は必要とせず、貢献に参加し収益を得ることができ、Sahara AI が築くのは、誰もが参加できる分散型 AI の世界です。技術開発者にとって、Sahara AI は Web2 と Web3 の開発パスをつなぎ、分散化されたが柔軟で強力な開発ツールと高品質なデータセットを提供しています。
AI インフラプロバイダーにとって、Sahara AI はモデル、データ、計算リソース、およびサービスの分散型実現の新たなパスを提供しています。Sahara AI はパブリックチェーンのインフラだけでなく、コアアプリケーションも担っており、ブロックチェーン技術を活用して AI 版权システムの発展を促進しています。現時点では、Sahara AI は既に複数のトップ AI 機関と提携し、初期の成功を収めています。今後の成功は、メインネットの稼働後のパフォーマンス、エコシステム製品の展開と採用率、および TGE 後の経済モデルがユーザーにデータセットへの貢献を促進できるかどうかを観察する必要があります。
Ritual:異種タスクなどの AI の中核的な課題に新しいデザイン革新をもたらす
プロジェクト概要
Ritual は、現在の AI 業界に存在する中心集権化、閉鎖性、および信頼の問題を解決し、AI に透明な検証メカニズム、公正な計算リソースの配分、および柔軟なモデル適合性能力を提供し、任意のプロトコル、アプリケーション、またはスマートコントラクトが数行のコードで検証可能な AI モデルを統合できるようにします。また、そのオープンなアーキテクチャとモジュール化された設計を通じて、AI のチェーン上での広範な利用を推進し、オープンで安全で持続可能な AI エコシステムを構築します。
Ritual は、2023 年 11 月に Archetype をリード投資家とし、Accomplice など多くの機関および著名なエンジェル投資家が参加した 2500 万ドルのシリーズ A ファイナンスを完了し、市場の認知とチームの強力なソーシャル能力を示しました。共同創設者の Niraj Pant と Akilesh Potti は、以前 Polychain Capital のパートナーであり、Offchain Labs、EigenLayer などの業界大手への投資を主導した経歴を持ち、深い洞察力と判断力を示しています。チームは、暗号学、分散システム、AI などの分野で豊富な経験を持ち、NEAR や EigenLayer などのプロジェクト創設者を含む顧問陣は、その強力なバックグラウンドとポテンシャルを示しています。
デザインアーキテクチャ
Infernet から Ritual Chain へ
Ritual Chain は Infernet ノードネットワークから自然な移行で生じた第二世代の製品であり、Ritual の分散型 AI 計算ネットワーク上での包括的なアップグレードを表しています。 Infernet は Ritual が導入した最初の段階の製品で、2023 年に正式に立ち上げられました。これは、異種計算タスク向けに設計された分散型オラクルネットワークであり、中央集権化された API の制約を解決し、開発者が透明でオープンで分散型の AI サービスをより自由に安定して呼び出すことができるようにします。
Infernet は、柔軟でシンプルな軽量フレームワークを採用しており、その使いやすさと効率性により、リリース後すぐに 8,000 を超える独立したノードが参加しました。これらのノードには、GPU や FPGA を含むさまざまなハードウェア能力が備わっており、AI 推論やゼロ知識証明生成などの複雑なタスクに強力な計算能力を提供できます。ただし、システムのシンプルさを維持するために、Infernet は一部の重要な機能を放棄しています。たとえば、共識調整ノードを介したルーティング機構の統合などです。これらの制約により、Infernet はより広範な Web2 および Web3 開発者の要求を満たすのが難しくなり、そこで Ritual がより包括的かつ強力な Ritual Chain をリリースするきっかけとなりました。
Ritual Chain は、AI アプリケーション向けに設計された次世代 Layer 1 ブロックチェーンであり、Infernet の制約を補うとともに、開発者によりロバストで効率的な開発環境を提供します。Resonance 技術を使用することで、Ritual Chain は Infernet ネットワークにシンプルで信頼性の高い価格設定およびタスクルーティングメカニズムを提供し、リソース割り当て効率を大幅に向上させています。さらに、Ritual Chain は EVM++ フレームワークに基づいており、これは Ethereum Virtual Machine(EVM)の後方互換性拡張であり、プリコンパイルドモジュール、ネイティブスケジューリング、組み込みアカウント抽象(AA)、および一連の先進的な Ethereum Improvement Proposals(EIPs)を含む、より強力な機能を備えています。これらの特徴は、開発者に新たな可能性を提供する強力で柔軟性の高い効率的な開発環境を構築しています。
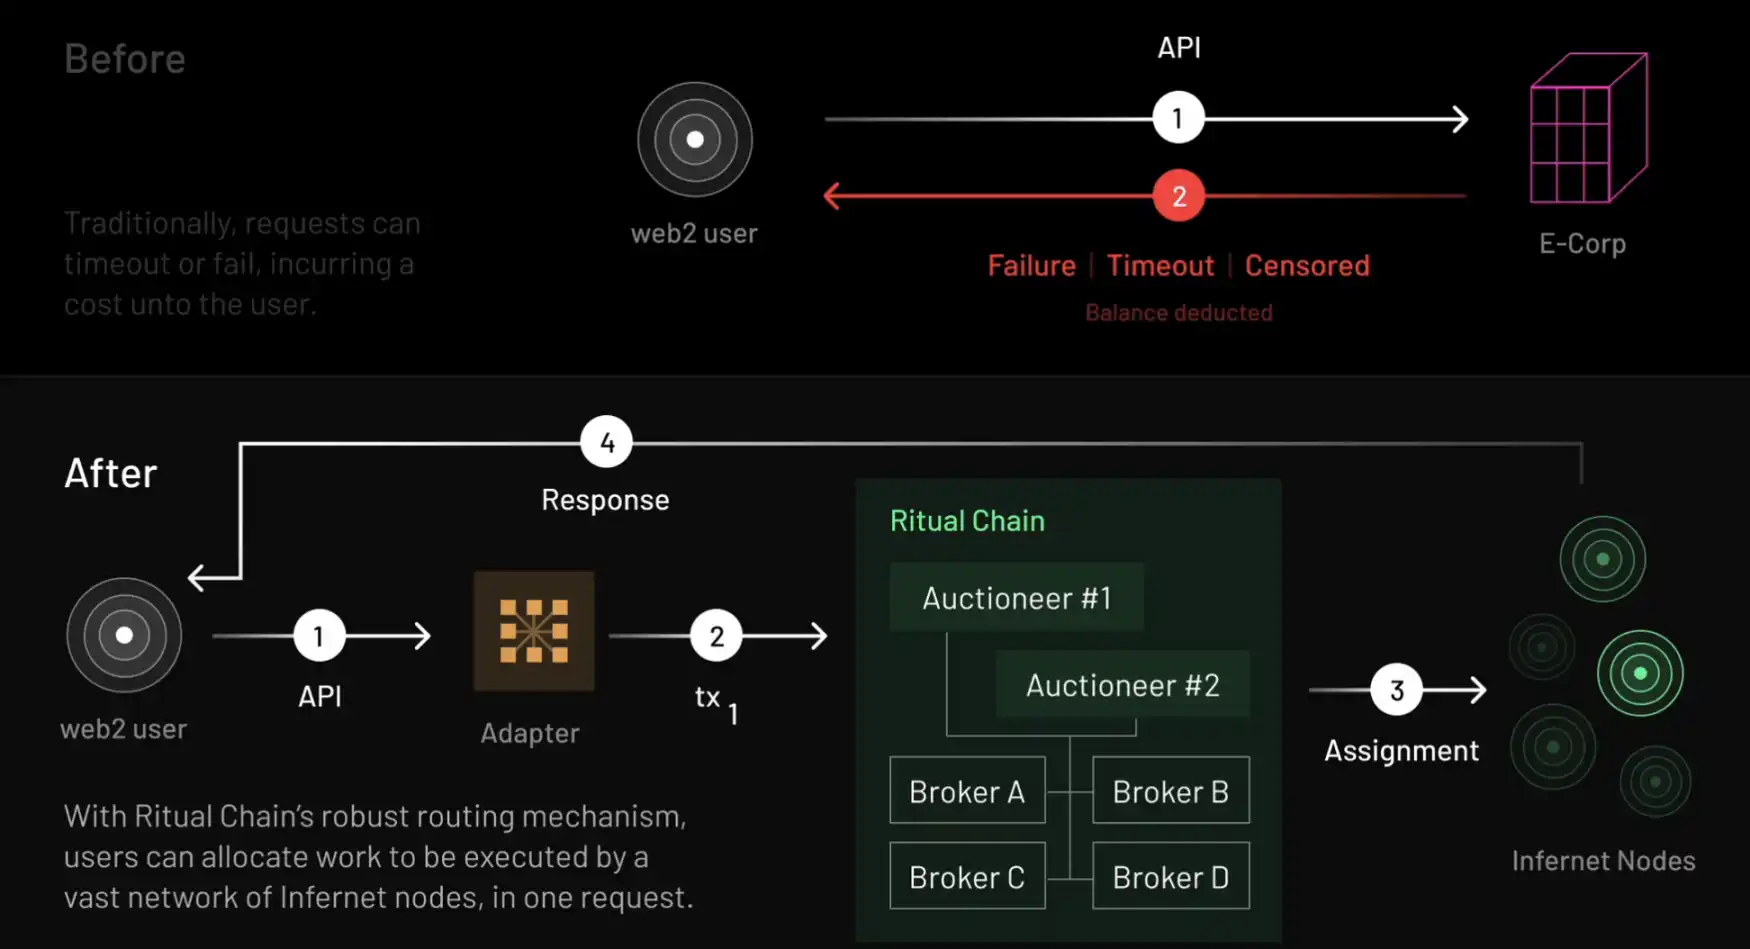
Ritual Chain ワークフローダイアグラム
プリコンパイル Sidecars
従来のプリコンパイルとは異なり、Ritual Chain の設計はシステムの拡張性と柔軟性を向上させ、開発者が基礎プロトコルを変更せずにカスタム機能モジュールをコンテナ化して作成できるようにしています。このアーキテクチャにより、開発コストが大幅に削減されるだけでなく、分散型アプリケーションにより強力な計算能力が提供されています。
具体的には、Ritual Chain はモジュール化されたアーキテクチャを使用して、複雑な計算を実行クライアントから切り離し、独立した Sidecars 形式で実装しています。これらのプリコンパイルモジュールは、AI 推論、ゼロ知識証明生成、および Trusted Execution Environment(TEE)操作など、複雑な計算タスクを効率的に処理できます。
ネイティブスケジューリング(Native Scheduling)
ネイティブスケジューリングは、タスクのタイミングトリガーと条件付き実行のニーズを解決します。従来のブロックチェーンは、通常、keeperなどの中央集権的なサードパーティサービスに依存してタスクをトリガーしますが、このようなモデルには中央集権化のリスクと高いコストが存在します。Ritual Chain は、組み込みスケジューラーによって、中央集権的なサービスに対する依存を完全に排除し、開発者はチェーン上で直接スマートコントラクトのエントリーポイントとコールバック頻度を設定できます。ブロック生産者は保留中の呼び出しのマッピングテーブルを維持し、新しいブロックを生成する際にこれらのタスクを優先的に処理します。Resonance のリソース動的割り当てメカニズムと組み合わされて、Ritual Chain は計算集約型タスクを効率的かつ信頼性高く処理し、分散型AIアプリケーションに安定したサポートを提供します。
技術革新
Ritualの中核技術革新により、パフォーマンス、検証、およびスケーラビリティにおいて先導的立場を確立し、オンチェーンAIアプリケーションに強力なサポートを提供しています。
1. レゾナンス:リソースの最適化配分
レゾナンスは、ブロックチェーンのリソース配分を最適化するための双方向市場メカニズムであり、異種トランザクションの複雑性を解決します。ブロックチェーントランザクションが単なる送金からスマートコントラクト、AI推論など多様な形態に移行するにつれて、(EIP-1559など)既存の料金メカニズムはユーザーのニーズとノードのリソースを効果的にマッチングするのが難しくなっています。ブローカーとオークショニアという2つの中核的な役割を導入することで、レゾナンスはユーザートランザクションとノード能力との間で最適なマッチングを実現しています:
ブローカーは、ユーザートランザクションの手数料意向とノードのリソースコスト関数を分析し、取引とノードの最適なマッチングを実現し、計算リソースの利用効率を向上させます。オークショニアは、双方向オークションメカニズムを使用して取引手数料の配分を組織し、公正性と透明性を確保します。ノードは自身のハードウェア能力に基づいて取引タイプを選択し、ユーザーは速度やコストなどの優先条件に基づいて取引要求を送信できます。
このメカニズムにより、ネットワークのリソース利用効率とユーザーエクスペリエンスが大幅に向上し、さらに分散型のオークションプロセスによってシステムの透明性とオープン性がさらに強化されています。
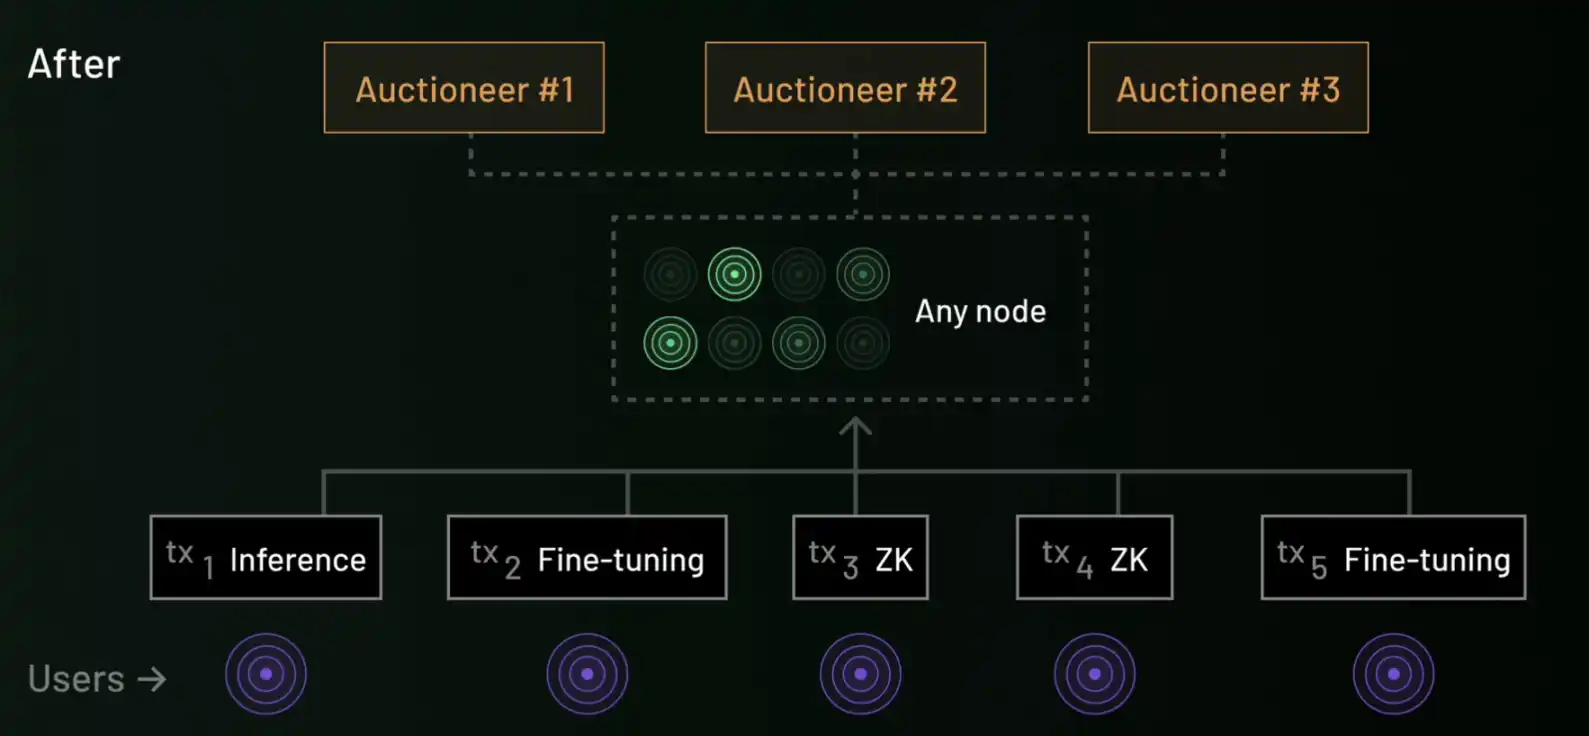
レゾナンスメカニズムにおいて、オークショニアはブローカーの分析に基づき、適切なタスクをノードに割り当てます
2. Symphony: 検証効率の向上
Symphony は検証効率の向上に焦点を当てており、伝統的なブロックチェーンの「再実行」モデルにおける複雑な計算タスクの処理と検証時の非効率性の問題を解決します。Symphony は「一度の実行、複数回の検証」(EOVMT)モデルに基づき、計算と検証プロセスを分離することで、重複計算によるパフォーマンスの低下を大幅に削減します。指定ノードによって一度だけ計算タスクが実行され、計算結果がネットワークにブロードキャストされます。検証ノードは非対話式証明(簡潔な証明)を使用して結果の正確性を確認し、計算の再実行を必要とせずに行います。
Symphony は分散型検証をサポートし、複雑なタスクを複数のサブタスクに分割し、異なる検証ノードが並列で処理することで検証効率をさらに向上させ、プライバシー保護とセキュリティを確保します。Symphony は Trusted Execution Environment (TEE) や Zero-Knowledge Proof (ZKP) などの証明システムと高度に互換性があり、迅速なトランザクションの確認やプライバシーに敏感な計算タスクを柔軟にサポートします。このアーキテクチャは重複計算によるパフォーマンスの損失を著しく低減するだけでなく、検証プロセスの分散化とセキュリティを確保します。
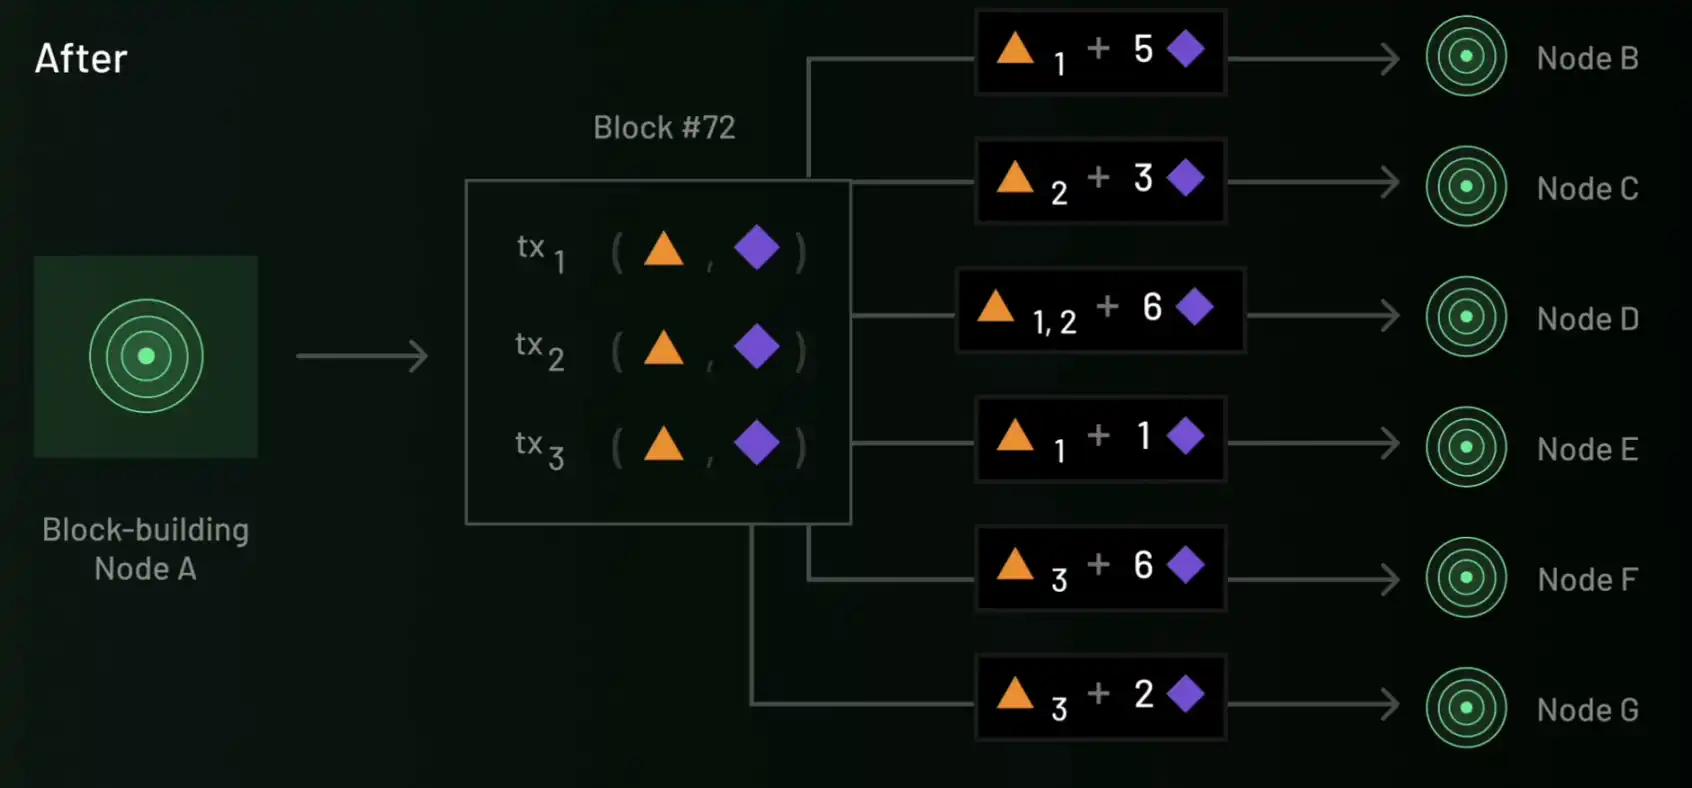
Symphony は複雑なタスクを複数のサブタスクに分解し、異なる検証ノードが並列で処理します
3. vTune: 追跡可能なモデル検証
vTune は Ritual が提供するモデル検証とソーストラッキングのツールであり、モデルのパフォーマンスにほとんど影響を与えず、耐久性に優れ、特にオープンソースモデルの知的財産権を保護し、公平な配布を促進するのに適しています。vTune はウォーターマーキング技術とゼロ知識証明を組み合わせ、モデルのソーストラッキングと計算の整合性保証を実現します。
・ ウォーターマーキング技術: 重み空間ウォーターマーク、データウォーターマーク、または関数空間ウォーターマークを埋め込むことで、モデルが公開されていても割り当てを検証できます。特に、関数空間ウォーターマークは、モデルの重みにアクセスせずに、モデルの生成源を確認するためにモデル出力を介して割り当てを検証でき、より強力なプライバシー保護と耐久性を実現します。
・ ゼロ知識証明: モデルの微調整プロセス中に秘匿データを導入し、モデルの改竄を検証すると同時に、モデル作成者の権利を保護します。
このツールは分散型 AI モデルマーケットに信頼性のあるソースの検証を提供すると同時に、モデルのセキュリティとエコシステムの透明性を大幅に向上させました。
エコシステムの発展
Ritual は現在プライベートテストネットワーク段階にあり、一般ユーザーにとっては参加機会が限られています。 開発者は、Ritual の AI エコシステム構築に参加し、公式で提供される Altar および Realm インセンティブプログラムに申請し参加することができ、公式からフルスタックのテクニカルサポートと資金支援を受けることができます。
現在、公式から Altar プログラムの一環として発表されたいくつかのネイティブアプリケーションが公開されています:
· Relic: 機械学習ベースの自動メーカーメイカー(AMM)、Ritual のインフラストラクチャを使用して流動性プールパラメーターを動的に調整し、手数料と基礎プールの最適化を実現します。
· Anima: LLM に焦点を当てたオンチェーン取引自動化ツールで、ユーザーにスムーズで自然な Web3 インタラクション体験を提供します。
· Tithe: AI ドライブのレンディングプロトコルで、レンディングプールと信用スコアを動的に最適化することで、より広範囲の資産タイプをサポートしています。
さらに、Ritual は他の多くの成熟したプロジェクトと深い協力関係を結んでおり、分散型 AI エコシステムの発展を推進しています。例えば、Arweave とのパートナーシップにより、モデル、データ、およびゼロ知識証明を去中心化永続ストレージでサポートしています。StarkWare および Arbitrum との統合を通じて、Ritual はこれらのエコシステムにネイティブのオンチェーン AI 機能を導入しました。また、EigenLayer が提供する再ステーキングメカニズムにより、Ritual のプルーフマーケットにはアクティブな検証サービスが追加され、ネットワークの分散化とセキュリティがさらに強化されました。
課題と展望
Ritual の設計は、配分、インセンティブ、検証など、分散型 AI が直面する中心的な課題を解決しており、vTune などのツールを使用してモデルの検証可能性を実現し、モデルのオープンソース化とインセンティブの矛盾を突破し、分散型モデルマーケットの構築に技術的支援を提供しています。
現在、Ritual は早期段階にあり、主にモデルの推論段階に焦点を当てており、製品マトリックスはインフラストラクチャからモデルマーケット、L2 としてのサービス(L2aaS)、およびエージェントフレームワークなどの領域に拡大しています。 現在、ブロックチェーンはまだプライベートテスト段階にあるため、Ritual の提案する先進的な技術設計は、引き続き大規模な公開展開を待っており、継続的な注目が必要です。 技術の進化とエコシステムの拡充に伴い、Ritual が分散型 AI インフラストラクチャの重要な一部となることを期待しています。
Gensyn: 分散型モデルトレーニングの中核的問題の解決
プロジェクト概要
人工知能の急速な進化と、計算リソースのますます希少な時代背景の中で、Gensyn は AI モデルトレーニング全体のパラダイムを再構築しようとしています。
従来の AI モデルトレーニングプロセスでは、計算リソースはわずかなクラウドコンピューティング巨大企業によってほぼ独占され、トレーニングコストが高く透明性が低く、中小規模のチームや独立した研究者の革新の足を引っ張っていました。一方、Gensyn のビジョンは、この「中心化された独占」構造を打破することであり、トレーニングタスクを世界中の基本的な計算能力を持つ機器に「沈める」ことを主張しています。MacBook、ゲーミンググレードのGPU、エッジデバイス、アイドルサーバーなど、どのデバイスでもネットワークに接続し、タスクの実行に参加し、報酬を受け取ることができます。
Gensyn は 2020 年に設立され、分散型の AI 計算インフラを構築することに特化しています。2022 年には、チームが技術と制度の両面で AI モデルトレーニングの方法を再定義しようと初めて意図したことが述べられました。封鎖されたクラウドプラットフォームや巨大なサーバークラスターに頼るのではなく、トレーニングタスクを地球規模の異種計算ノードに「沈め」、信頼されないインテリジェント計算ネットワークを構築することを目指しています。
2023 年、Gensyn はそのビジョンをさらに拡大し、グローバルに接続された、オープンソースの自治取引手数料のない AI ネットワークを構築することを目指しています。基礎プロトコルはブロックチェーンアーキテクチャに基づいて設計されており、インセンティブメカニズムと検証メカニズムの組み合わせが可能です。
Gensyn は設立以来、合計で 50.6 百万ドルの支援を受けており、投資家はa16z、CoinFund、Canonical、Protocol Labs、Distributed Globalなど、合計で17社の機関が含まれています。その中でも、2023年6月に行われたa16zによるリードインのシリーズAラウンド調達は注目を浴び、分散型AI分野が主流のWeb3ベンチャーキャピタリストの視野に入ることを示しています。
チームの主要メンバーのバックグラウンドも非常に重要です。共同創設者のBen Fieldingは、オックスフォード大学で理論コンピュータサイエンスを学び、深い技術研究のバックグラウンドを持っています。もう一人の共同創設者であるHarry Grieveは、長年にわたり分散型プロトコルのシステム設計と経済モデリングに従事し、Gensynのアーキテクチャ設計とインセンティブ機構に堅実なサポートを提供しています。
デザインアーキテクチャ
現在の分散型人工知能システムの開発は、実行、検証、通信の3つの主要な技術的ボトルネックに直面しています。これらのボトルネックは、大規模モデルのトレーニング能力に制約をもたらすだけでなく、グローバルな計算リソースの公正な統合と効率的な利用を阻害しています。Gensyn チームは体系的な研究に基づき、RL Swarm、Verde、SkipPipe の3つの代表的なイノベーションメカニズムを提案し、上記の問題に対処するための解決策を構築し、分散型AIインフラの概念から実装への推進を実現しました。
1. Execution Challenge: How to Enable Fragmented Devices to Collaboratively and Efficiently Train Large Models?
現在、大規模言語モデルのパフォーマンス向上は主に「スケーリング」戦略に依存しています。これには、より多くのパラメータ、より広範囲なデータセット、およびより長いトレーニングサイクルが含まれます。しかし、これには著しい計算コストがかかります。巨大モデルのトレーニングにはしばしば何千ものGPUノードに分割する必要があり、これらのノード間で頻繁なデータ通信と勾配同期が必要です。分散型シナリオでは、ノードは地理的に広く分散し、ハードウェアが異種であり、状態が不安定です。従来の中央集権的スケジューリング戦略は効果的ではありません。
この課題に対処するために、Gensyn は RL Swarm を提案しました。これは、ピアツーピアの強化学習後トレーニングシステムです。その核心アイデアは、トレーニングプロセスを分散協調ゲームに変換することです。このメカニズムは「共有−批判−意思決定」という3つの段階に分かれます。まず、ノードは問題の推論を独立して行い、結果を公開共有します。次に、各ノードは同僚の回答を評価し、論理性や戦略の妥当性などの観点からフィードバックを提供します。最後に、ノードは集団の意見に基づいて自らの出力を修正し、より頑健な回答を生成します。このメカニズムは個別の計算と集団協力を効果的に統合し、特に高精度と検証可能性が必要な数学的および論理的推論などのタスクに適しています。実験によると、RL Swarm は効率を向上させるだけでなく、参加の敷居を大幅に下げ、拡張性と耐障害性に優れています。
RL Swarmの「共有−批判−意思決定」3段階の強化学習トレーニングシステム
RL Swarm の「共有−批判−意思決定」3段階の強化学習トレーニングシステム
2. Verification Challenge: How to Verify the Computation Results of Untrusted Providers?
分散型トレーニングネットワークでは、「誰でも計算リソースを提供できる」というのが利点でありリスクでもあります。問題は次のとおりです。「信頼を必要としない状況下で、これらの計算が実際に有効であるかどうかを検証する方法は?」
再計算やホワイトリスト審査などの伝統的な方法には明らかな制限があります。前者は非常に高コストであり、スケーラビリティに欠けます。後者は「ロングテール」ノードを除外し、ネットワークのオープン性を損なう傾向があります。このため、Gensyn は神経ネットワークトレーニング検証シナリオ用に設計された軽量仲裁プロトコルである Verde を開発しました。
Verde の主要な考え方は「最小信頼判断」です:検証者がプロバイダーのトレーニング結果に疑義を持った場合、仲裁契約は争議のある最初の操作ノードを再計算するだけで済み、トレーニングプロセス全体をやり直す必要はありません。これにより検証の負担が大幅に軽減され、同時に少なくとも一方が正直である場合の結果の正確性が保証されます。さまざまなハードウェア間の浮動小数点非決定性の問題を解決するために、Verde は再現可能なオペレーター(Reproducible Operators)も開発しました。これにより、行列の乗算などの一般的な数学的操作に対して統一された実行順序が設定され、機器間のビットレベルでの一貫した出力が実現されます。この技術は分散トレーニングのセキュリティとエンジニアリングの実現可能性を大幅に向上させ、現在の信頼性のない検証システムにおける重要な進歩です。
このメカニズム全体は、トレーナーが中間ステート(チェックポイント)を記録することに基づいて構築されています。複数の検証者がこれらのトレーニングステップをランダムに再現して出力の一貫性を判断します。検証者の計算結果がトレーナーと異なる場合、システムはモデル全体を再実行するのではなく、ネットワークアービトラージメカニズムを使用して両者が最初に意見の食い違いを起こした計算グラフ内の操作を正確に特定し、その操作のみを再生して比較することで、紛争解決を非常に低いコストで実現します。この方法により、Verde はトレーニングノードへの信頼を必要とせずに、トレーニングプロセスの完全性を保証し、効率とスケーラビリティを兼ね備えた、分散AIトレーニング環境向けにカスタマイズされた検証フレームワークを提供しています。
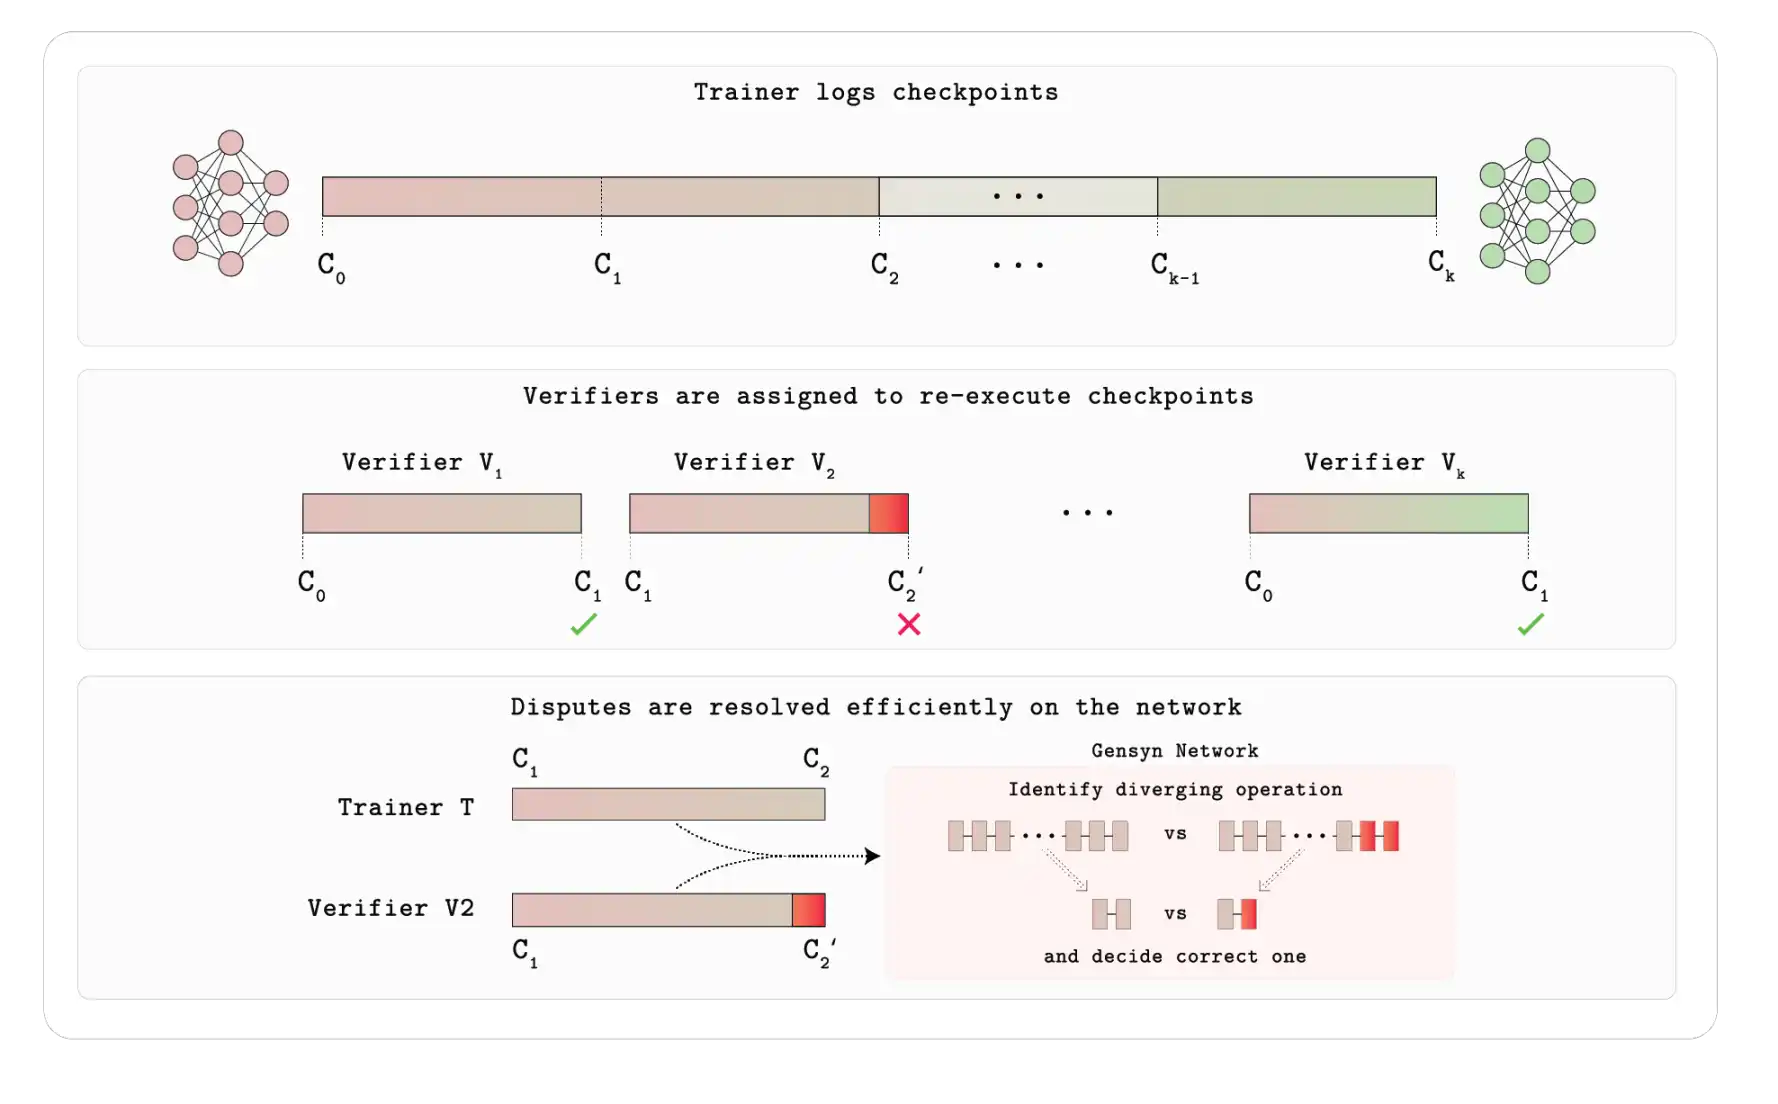
Vader のワークフロー
三、通信の課題:ノード間の高頻度同期によるネットワークのボトルネックをどのように削減するか?
従来の分散トレーニングでは、モデルは完全に複製されるか、または層ごとに分割されます(パイプライン並列化)。これらのいずれも、ノード間で高頻度の同期が必要とされます。特にパイプライン並列化では、1つのマイクロバッチが各モデル層を厳密な順序で通過する必要があり、あるノードに遅延が発生するとトレーニングプロセス全体がブロックされます。
Gensyn はこの問題に対処し、SkipPipe を提案しています:ジャンプ実行と動的パススケジューリングをサポートする高耐障害パイプライントレーニングシステム。SkipPipe は「スキップ比率(skip ratio)」メカニズムを導入し、特定のノードが過負荷の場合、一部のモデル層をスキップすることを許可し、同時にスケジューリングアルゴリズムを使用して現在の最適計算パスを動的に選択します。実験によると、広範な地理的分布、大きなハードウェアの違い、および帯域幅の制限があるネットワーク環境において、SkipPipe はトレーニング時間を最大55%削減し、50%のノード障害率でもわずか7%の損失を維持でき、非常に強い耐障害性と適応性を示しています。
参加方法
Gensynのパブリックテストネットは2025年3月31日にローンチされ、現在はまだ技術ロードマップの初期段階(Phase 0)にあり、機能の焦点はRL Swarmの展開と検証に置かれています。RL SwarmはGensynの最初のアプリケーションシナリオであり、強化学習モデルの協力トレーニングを中心に設計されています。各参加ノードはその行動をチェーン上のアイデンティティにバインドし、貢献プロセスは完全に記録されています。これは、後続のインセンティブ配分や信頼できる計算モデルのための検証基盤を提供しています。
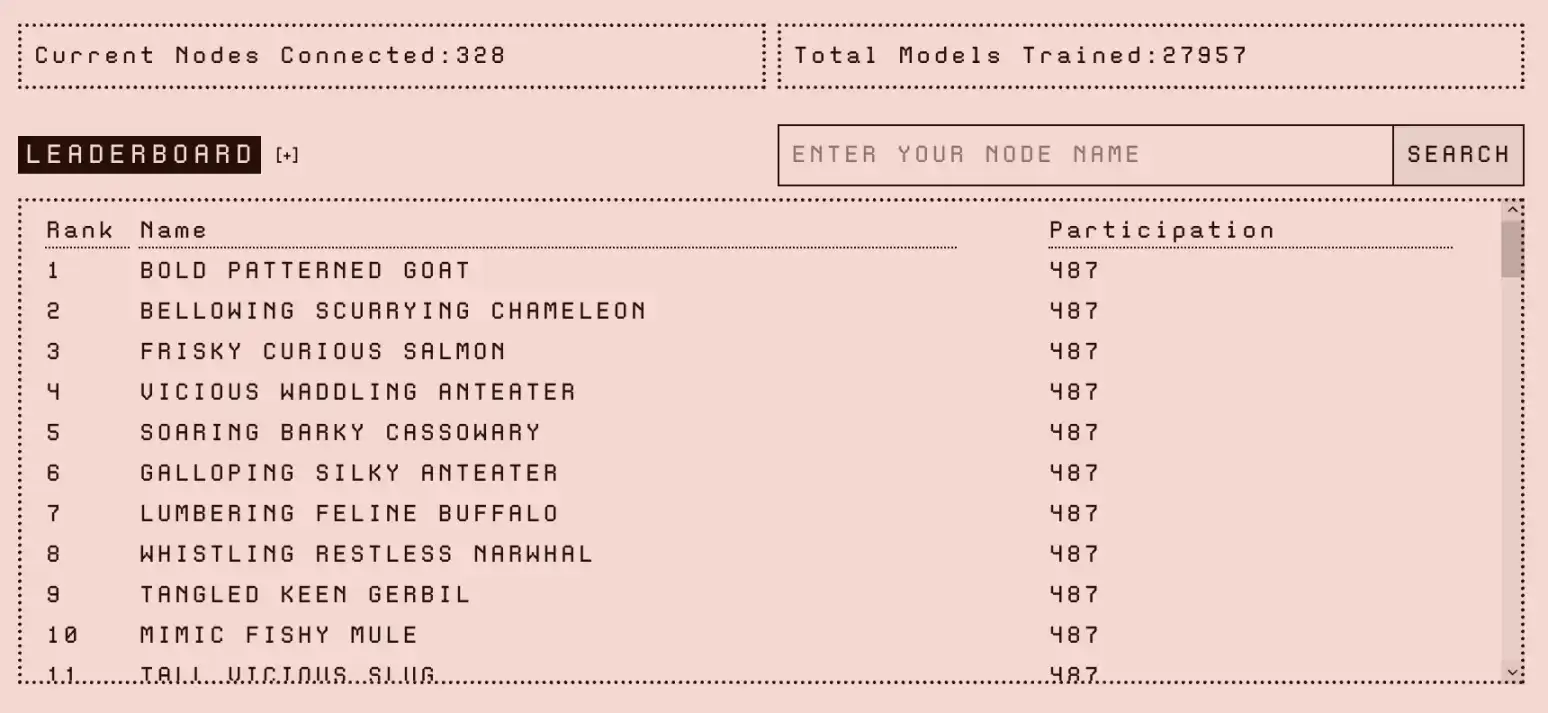
Gensynのノードランキング
初期のテスト段階のハードウェア要件は比較的利用しやすいものです:MacユーザーはMシリーズチップを使用すれば動作しますし、Windowsユーザーには3090や4090などの高性能GPUと16GB以上のRAMを搭載することをお勧めします。これにより、ローカルSwarmノードを展開できます。システムが実行された後、ウェブページにログインしてメールアドレス(Gmailをお勧めします)を確認し、検証プロセスを完了できます。そして、HuggingFaceのAccess Tokenをバインドするかどうかを選択し、より包括的なモデル機能をアクティブ化できます。
課題と展望
現在、Gensynプロジェクトの最大の不確実性は、そのテストネットがまだ約束された完全なテクノロジースタックをカバーしていないことです。VerdeやSkipPipeなどの重要なモジュールはまだ統合待ちの状態にあり、これにより外部からはアーキテクチャの実装能力に対する懐疑的な姿勢が続いています。公式の説明によると、テストネットは段階的に進行し、各段階で新しいプロトコル機能が解除され、優先的にインフラストラクチャの安定性と拡張性が検証されます。最初の段階ではRL Swarmが出発点となり、将来的には事前トレーニング、推論などの中核シナリオに段階的に拡大し、最終的には実世界の経済取引をサポートする本番環境の展開に移行します。
テストネットが比較的控えめなペースでスタートしたにもかかわらず、1か月後にはGensynがより大規模なモデルと複雑な数学タスクをサポートする新しいSwarmテストタスクを発表しました。この行動は、開発ペースに対する外部からの批判にある程度応えており、チームの部分モジュール推進力を示しています。
しかし、問題も浮上しています:新しいバージョンのタスクはハードウェアに非常に高い要件を設けており、A100、H100などのトップクラスのGPU(80GB VRAM)が推奨されています。これは中小規模のノードにとってほとんど届かないものであり、Gensynが強調している「オープンなアクセス、分散型トレーニング」の趣旨と一定の緊張関係を生じさせています。計算リソースの集中化傾向が効果的に導かれない場合、ネットワークの公正性および分散型ガバナンスの持続可能性に影響を与える可能性があります。
次に、Verde と SkipPipe がスムーズに統合されれば、プロトコルの完全性と協調効率が向上するのに役立ちます。しかし、Gensyn がパフォーマンスと分散型の間で本当のバランスを見つけられるかどうかは、テストネットのさらなる長期および広範囲の実践試験を待っています。現時点では、それは潜在性を初めて示し、挑戦も露呈しました。これこそが早期インフラプロジェクトの最もリアルな状態です。
Bittensor: 分散型 AI ネットワークのイノベーションと発展
プロジェクト概要
Bittensor は、ブロックチェーンと人工知能を組み合わせた先駆的なプロジェクトであり、2019 年に Jacob Steeves と Ala Shaabana によって創設されました。このプロジェクトは、「機械知能のための市場経済」を構築することを目的としています。両創設者は人工知能と分散システムの幅広いバックグラウンドを持っています。プロジェクトのホワイトペーパーに署名している Yuma Rao は、プロジェクトに暗号学やコンセンサスアルゴリズムに関する専門知識を注入したチームの主要技術アドバイザーと見なされています。
このプロジェクトは、ブロックチェーンプロトコルを使用して世界の計算リソースを統合し、自己最適化する分散型ニューラルネットワークエコシステムを構築することを目指しています。このビジョンは、計算、データ、ストレージ、モデルなどのデジタル資産を知的な価値の流れに変換し、新しい経済形態を構築し、AI の発展の利益を公正に分配することを保証します。中央集権化された OpenAI などとは異なり、Bittensor は次の三つの主要な支柱価値を確立しました:
· データ孤島の打破: TAO トークンを利用して知識共有とモデル貢献を促進
· マーケット駆動型の品質評価: ゲーム理論メカニズムを導入して優れた AI モデルを選抜し、適者生存を実現
· ネットワーク効果の増幅: 参加者の増加とネットワーク価値の指数的正の相関を形成し、好循環を生み出す
投資の観点では、Polychain Capital はBittensor を 2019 年から孵化しており、現在約 2 億ドル相当の TAO トークンを保有しています。Dao5 は約 5000 万ドル相当の TAO を保有しており、Bittensor エコシステムの初期支持者です。2024 年、Pantera Capital と Collab Currency は戦略的投資を通じてさらに拡大しました。同年 8 月、Grayscale Group は TAO をその分散型 AI ファンドに取り込み、機関投資家がプロジェクトの価値を強く認識し、長期的に期待していることを示しました。
デザインアーキテクチャと動作メカニズム
ネットワークアーキテクチャ
Bittensor は、4 つの協調レベルで構成される精密なネットワークアーキテクチャを構築しています:
・ ブロックチェーン層: Substrate フレームワークに基づく、ネットワークの信頼基盤であり、状態変化とトークン発行を記録する責任を担います。システムは 12 秒ごとに新しいブロックを生成し、規則に従って TAO トークンを発行し、ネットワークの合意とインセンティブ配分を確保します。
・ ニューロン層(Neuron): ネットワークの計算ノードであり、ニューロンはさまざまな AI モデルを実行してインテリジェントなサービスを提供します。各ノードは、サービスの種類とインターフェース仕様を明示するための cuidivid構成ファイルを使用しています。これにより、機能のモジュール化とプラグアンドプレイが実現されています。
・ シナプス層(Synapse): ネットワークの通信ブリッジであり、ノード間の接続重みを動的に最適化し、ニューロン間で情報を効率的に伝達する神経ネットワーク構造を形成します。シナプスには経済モデルが組み込まれており、ニューロン間の相互作用とサービス呼び出しには TAO トークンが支払われる必要があり、これにより価値の循環が確立されます。
・ メタグラフ層(Metagraph): システムのグローバルな知識グラフとして、各ノードの貢献価値を継続的に監視および評価し、全体のネットワークに知的なガイダンスを提供します。メタグラフは、シナプスの重みを正確に計算し、それによってリソースの割り当て、報酬メカニズム、およびネットワーク内でのノードの影響力に影響を与えます。
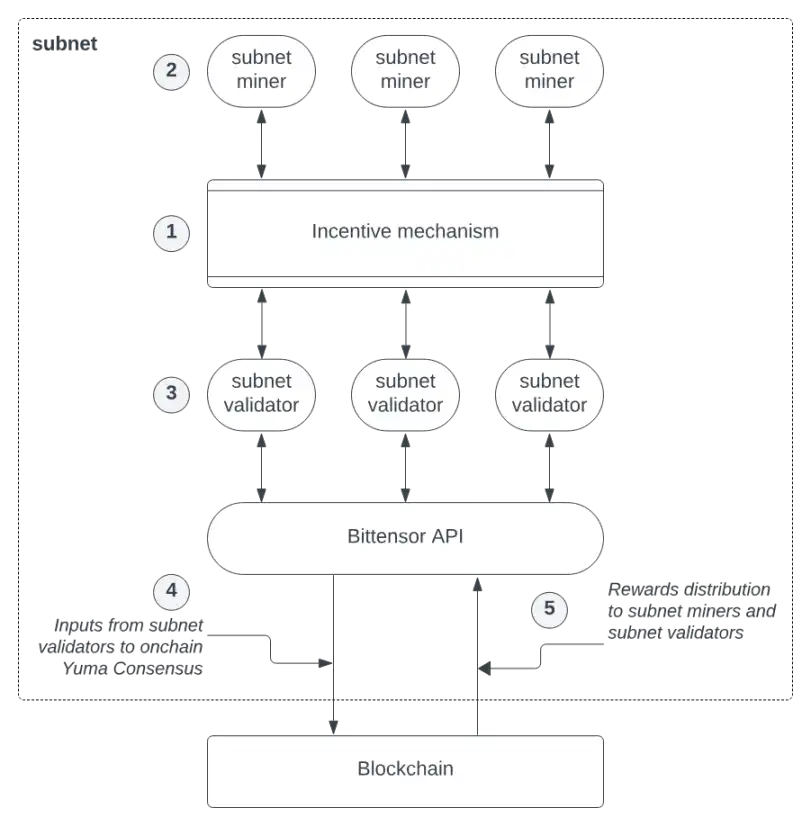
Bittensor のネットワークフレームワーク
Yuma コンセンサスメカニズム
ネットワークは独自の Yuma コンセンサスアルゴリズムを採用しており、72 分ごとに報酬配分のラウンドを完了します。検証プロセスは主観的評価と客観的測定を組み合わせています:
・ 主観的スコアリング: 検証者はマイナーの出力品質に対して主観的評価を行います
・ フィッシャー情報行列: ノードのネットワーク全体への貢献を客観的に定量化します
このような「主観 + 客観」の混合メカニズムにより、専門的判断とアルゴリズムの公正さが効果的にバランスされています。
サブネット(Subnet)アーキテクチャと dTAO アップグレード
各サブネットはテキスト生成、画像認識などの特定のAIサービス領域に焦点を当てており、独立して実行されますが、メインブロックチェーンのsubstensorと接続され、高度に柔軟なモジュール式拡張アーキテクチャが形成されます。2025年2月、Bittensorは、画期的なdTAO(Dynamic TAO)アップグレードを完了しました。このシステムにより、各サブネットが独立した経済単位に変換され、市場の需要シグナルによってリソース配分がスマートに調整されます。その中心的なイノベーションは、サブネットトークン(アルファトークン)メカニズムです:
・ 動作原理: 参加者はTAOをステークすることで、各サブネットからアルファトークンを取得します。これらのトークンは、特定のサブネットサービスへの市場の認識とサポートを表すリソースです
・ 配分ロジック: アルファトークンの市場価格は、サブネットの需要の強さを測る重要な指標として機能し、初期状態では各サブネットのアルファトークン価格は同一であり、各流動性プールにはTAOが1つ、アルファトークンが1つだけ含まれています。取引活動と流動性の投入が増加するに従い、アルファトークンの価格は動的に調整され、TAOの配分はサブネットトークン価格の割合に応じてスマートに割り当てられます。需要が高いサブネットほど、より多くのリソースが提供され、本当の需要に基づいたリソース最適化が実現されます
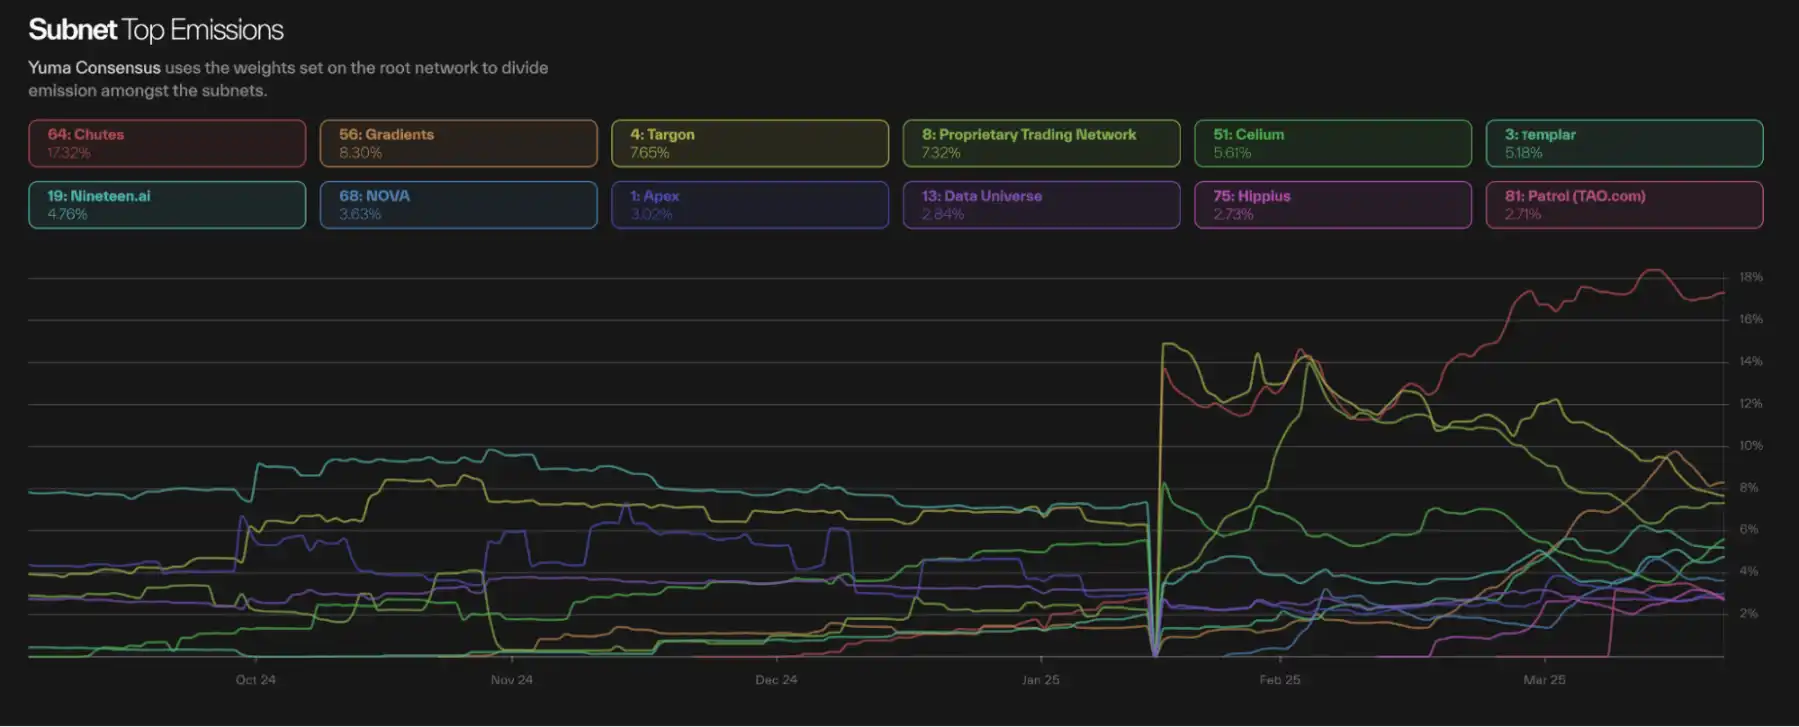
Bittensorサブネットトークンのエミッション配分
dTAOアップグレードにより、エコシステムの活力とリソース利用効率が大幅に向上しました。サブネットトークンの市場全体の時価総額は既に50億ドルに達し、力強い成長力を示しています。
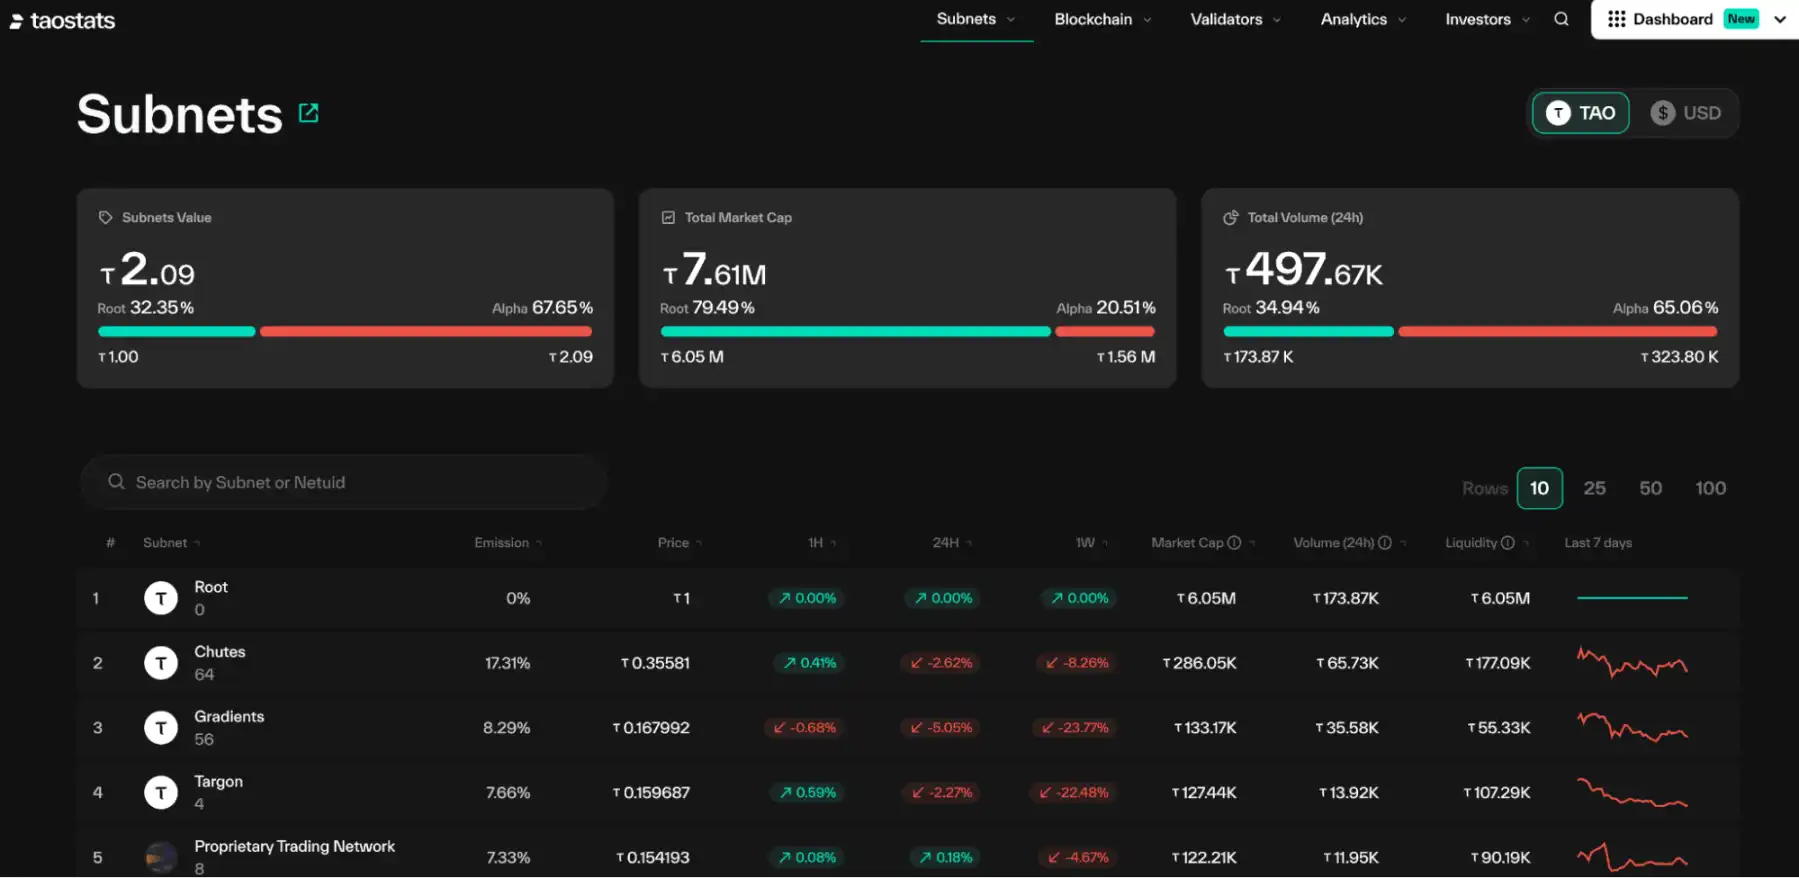
Bittensorサブネットアルファトークンの価値
エコシステムの進展とアプリケーションケース
メインネットの発展経過
Bittensorネットワークは、3つの主要な発展段階を経験しています:
・ 2021年1月:メインネットが正式に開始され、基盤が築かれました
・ 2023年10月:「Revolution」アップグレードにより、サブネットアーキテクチャが導入され、機能のモジュール化が実現されました
・ 2025年2月:dTAOアップグレードが完了し、市場主導型のリソース配分メカニズムが確立されました
サブネットエコシステムは爆発的な成長を示しています。2025年6月までに、専門のサブネットが119個存在し、年内には200個を超える可能性があります。
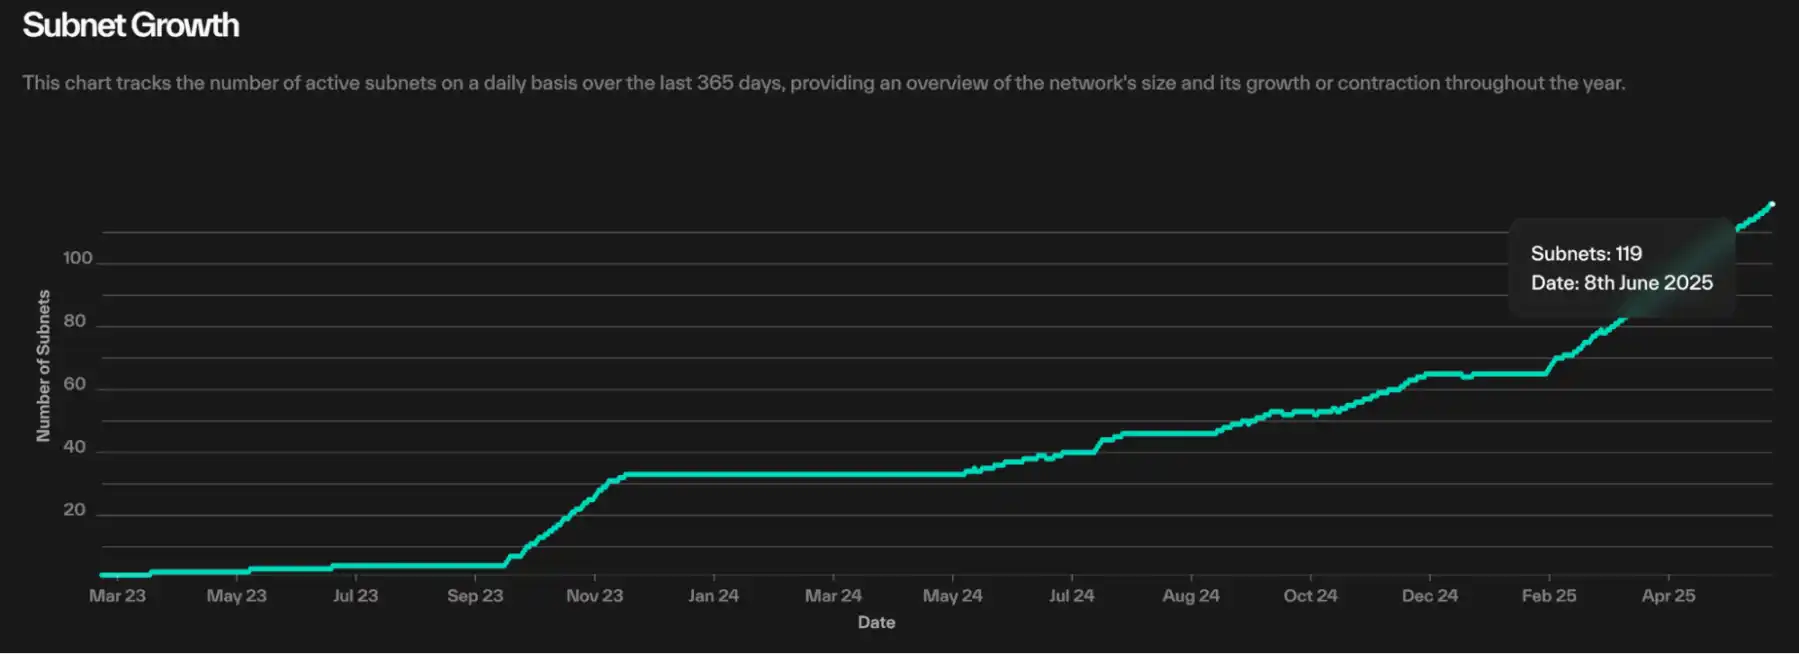
Bittensor Subnet Count
エコシステムのプロジェクトは多岐にわたり、AI エージェント(たとえば Tatsu)、予測市場(たとえば Bettensor)、DeFi プロトコル(たとえば TaoFi)など、さまざまな先端分野をカバーしており、AI と金融が深く融合した革新的なエコシステムを構築しています。
代表的なサブネットエコシステムプロジェクト
・ TAOCAT:TAOCAT は Bittensor エコシステム内のネイティブ AI エージェントであり、サブネット上に直接構築され、ユーザーにデータ駆動型の意思決定ツールを提供しています。Subnet 19 の大規模言語モデル、Subnet 42 のリアルタイムデータ、および Subnet 59 のエージェントアリーナを活用し、市場洞察と意思決定支援を提供しています。DWF Labs の投資を受け、同社の2,000 万ドルのAIエージェントファンドに組み込まれ、binance alpha に上場しています。
・ OpenKaito:Kaito チームが Bittensor 上で展開したサブネットで、分散型の暗号業界検索エンジンを構築することを目指しています。現在、50億のウェブページリソースをインデックス化し、分散型AIが大規模データを処理する能力を示しています。従来の検索エンジンと比較して、その主な利点はビジネス利益の干渉を減らし、より透明で中立なデータ処理サービスを提供し、Web3時代の情報取得に新たなパラダイムを提供しています。
・ Tensorplex Dojo:Tensorplex Labs によって開発された52号サブネットで、分散型プラットフォームを通じて高品質な人間が生成したデータセットを集め、ユーザーがデータラベリングにより TAO トークンを獲得することを奨励しています。2025年3月、YZi Labs(旧Binance Labs)はTensorplex Labsへの投資を発表し、DojoとBackprop Financeの開発を支援しています。
・ CreatorBid:Subnet 6で稼働し、AIとブロックチェーンを組み合わせたクリエイティブプラットフォームであり、Olasや他のGPUネットワーク(たとえばio.net)と統合され、コンテンツクリエイターやAIモデル開発をサポートしています。
error2025年のハーフニングサイクルが近づく中、Bittensorの戦略は、以下の4つの主要方針に焦点を当てることとなります:サブネットの専門分業をさらに深化し、垂直領域のアプリケーションのサービス品質と性能を向上させること;DeFiエコシステムとの緊密な統合を加速し、新しく導入されたEVM互換性を活用してスマートコントラクトアプリケーションの境界を拡張すること;dTAOメカニズムを通じて、今後100日間でネットワークガバナンスの権限を滑らかにTAOから徐々にAlphaトークンに移行し、ガバナンスの分散化プロセスを推進すること;そして他の主要なパブリックチェーンとの相互運用性を積極的に拡大し、エコシステムの境界とアプリケーションシナリオを拡大すること。これらの協調的な戦略措置は、Bittensorを「機械学習市場経済」への壮大なビジョンに着実に前進させます。
0G:ストレージを基盤とするモジュラーAIエコシステム
プロジェクト概要
0Gは、AIアプリケーション向けに設計されたモジュラーLayer 1ブロックチェーンであり、データ集約型および高計算要件シナリオ向けに、効率的で信頼性の高い分散型インフラストラクチャを提供することを目指しています。モジュラーアーキテクチャにより、0Gは共識、ストレージ、計算、データ可用性などのコア機能を独立して最適化し、ダイナミックなスケーリングをサポートし、大規模なAI推論およびトレーニングタスクを効率的に処理できます。
創設チームは、Michael Heinrich(CEO、1億ドル以上の資金調達のGartenを創設)、Ming Wu(CTO、マイクロソフトのリサーチャー、Confluxの共同創設者)、Fan Long(Confluxの共同創設者)、Thomas Yao(CBO、Web3投資家)から成り、コンピュータサイエンスの博士号を持つメンバー8人が在籍しており、Microsoft、Appleなどのバックグラウンドを持ち、深いブロックチェーンとAI技術の経験を有しています。
資金調達では、0G Labsは3500万ドルのPre-seedラウンドと4000万ドルのSeedラウンドを完了し、合計7500万ドルを調達しました。投資家にはHack VC、Delphi Ventures、Animoca Brandsなどが含まれます。さらに、0G Foundationは、25億ドルのトークン購入コミットメント、3060万ドルのパブリックノードセール、8888万ドルのエコシステムファンドを獲得しました。
デザインアーキテクチャ
1、0G Chain
0G Chainの目標は、最速のモジュラーAIブロックチェーンを構築することであり、そのモジュラーアーキテクチャにより、共識、実行、ストレージなどの主要コンポーネントを独立して最適化し、データ可用性ネットワーク、分散ストレージネットワーク、AI計算ネットワークを統合しています。この設計により、システムは複雑なAIアプリケーションシナリオに対処する際に優れた性能と柔軟性を提供します。以下は、0G Chainの3つの主要な特徴です:
モジュラースケーラビリティ(AI のためのモジュラースケーラビリティ)
0G は横方向にスケーラブルなアーキテクチャを採用し、大規模なデータワークフローを効率よく処理できます。そのモジュラー設計により、データ可用性レイヤー(DA レイヤー)とデータストレージレイヤーが分離されており、AI タスク(大規模トレーニングや推論など)のデータアクセスとストレージにおいてより高いパフォーマンスと効率が提供されています。
0G コンセンサス
0G のコンセンサスメカニズムは複数の独立したコンセンサスネットワークで構成されており、これらのネットワークは必要に応じて動的にスケーリングできます。データ量が指数関数的に増加するにつれ、システムのスループットも同期して向上し、1 から数百、さらには数千のネットワークにスケーリングをサポートします。この分散型アーキテクチャはパフォーマンスを向上させるだけでなく、システムの柔軟性と信頼性も確保します。
共有ステーキング
検証者はイーサリアムメインネット上でステーキングを行い、すべての参加する 0G コンセンサスネットワークにセキュリティを提供します。任意の 0G ネットワークで罰金イベントが発生した場合、検証者のイーサリアムメインネット上のステーキング資金が削減されます。このメカニズムにより、イーサリアムメインネットのセキュリティが全ての 0G コンセンサスネットワークに拡張され、システム全体のセキュリティと信頼性が確保されます。
0G Chain は EVM 互換性を備えており、イーサリアム、Layer 2 Rollup、または他のチェーンの開発者が簡単に 0G のサービス(データ可用性やストレージなど)を統合できるようにしています。同時に、0G は Solana VM、Near VM、およびビットコイン互換性のサポートを検討しており、AI アプリケーションをより広範なユーザー層に拡張することを目指しています。
2. 0G ストレージ
0G ストレージは、分散型アプリケーションやデータ集約型シナリオ向けに設計された高度に最適化された分散型ストレージシステムです。その中心には、ランダムアクセス証明(PoRA)と呼ばれる独自のコンセンサスメカニズムがあり、これによりマイナーがデータを保存および管理するインセンティブが生まれ、セキュリティ、パフォーマンス、公正さのバランスが実現されます。
そのアーキテクチャは、次の三つのレイヤーに分かれています:
・ ログレイヤー: 非構造化データの永続的な保存を実現し、アーカイブやデータログなどの用途に適しています。
· キー値レイヤー(Key-Value Layer): 可変の構造化データを管理し、アクセス制御をサポートし、ダイナミックなアプリケーションシナリオに適しています。
· トランザクションレイヤー(Transaction Layer): 複数ユーザーの同時書き込みをサポートし、協力とデータ処理の効率を向上させます。
ランダムアクセス証明(Proof of Random Access, PoRA)は、0Gストレージの主要なメカニズムであり、マイナーが指定されたデータブロックを正しく保存しているかどうかを検証するために使用されます。マイナーは定期的にチャレンジを受け、証明として有効な暗号ハッシュを提供する必要があります。これは、Proof of Work に類似しています。公正な競争を確保するために、0G は各採掘操作のデータ範囲を 8 TB に制限し、大規模な運用業者がリソースを独占するのを避け、小規模なマイナーも公正な環境で競争できるようにしています。
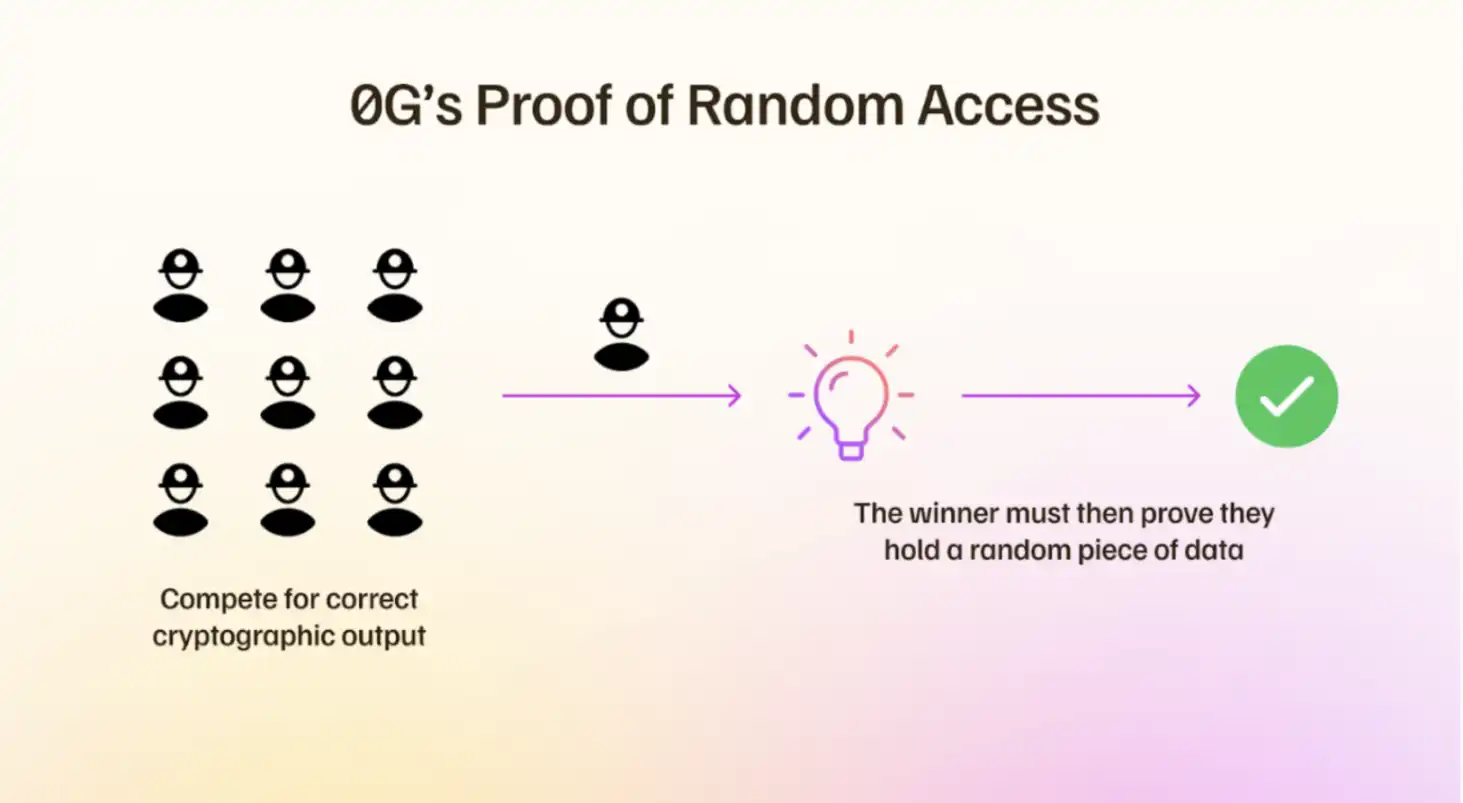
ランダムアクセス証明の概念図
イレイサー符号化技術により、0G ストレージはデータを複数の冗長な小さなセグメントに分割し、異なるストレージノードに分散させます。この設計により、一部のノードがオフラインになったり障害が発生した場合でもデータを完全に復元できることが保証されます。これにより、データの利用可能性とセキュリティが著しく向上し、大規模なデータの処理においてもシステムが優れたパフォーマンスを発揮します。さらに、データの格納はセクターレベルおよびデータブロックレベルで細かく管理されており、データアクセス効率が向上し、マイナーのストレージネットワークにおける競争力が強化されています。
提出されたデータは順序付けられた形式で構成されており、この順序はデータフロー(data flow)と呼ばれ、ログエントリリストまたは固定サイズのデータセクタのシーケンスとして理解することができます。0G では、各データブロックを一意のオフセット(offset)を使用して迅速に特定することができ、効率的なデータの検索とチャレンジクエリを実現できます。デフォルトでは、0G は多くのアプリケーションシナリオを処理するための一般的なデータフローである メインデータフロー(main flow)を提供しています。同時に、システムは 専用データフロー(specialized flows)もサポートしており、これらのデータフローは特定のカテゴリのログエントリを専門に扱い、異なるアプリケーション要件に最適化されています。
この設計により、0G ストレージはさまざまなシナリオに柔軟に適応でき、高いパフォーマンスと管理能力を維持しながら、AI x Web3 アプリケーションで大規模なデータフローを処理する必要がある場合に強力なストレージサポートを提供できます。
3、0G データ可用性(0G DA)
データ可用性(Data Availability, DA)は 0G の中核コンポーネントの1つであり、アクセス可能で検証可能かつ検索可能なデータを提供することを目的としています。この機能は分散型 AI インフラストラクチャの重要な要素であり、ユーザー要求を満たしシステムのインセンティブメカニズムの信頼性を確保するために、トレーニングや推論タスクの結果を検証することができます。0G DA は、精巧な設計のアーキテクチャと検証メカニズムにより、優れたスケーラビリティとセキュリティを実現しています。
0G DA の設計目標は、セキュリティを確保しつつ非常に高いスケーラビリティを提供することです。そのワークフローは主に2つの部分に分かれます:
· データ格納チャネル(Data Storage Lane): データはエンコード技術を用いて複数の小さなセグメント(「データブロック」)に分割され、0G ストレージネットワーク内のストレージノードに分散されます。このメカニズムにより、大規模なデータ転送を効果的にサポートし、データの冗長性と復元力を確保しています。
· データ公開チャネル(Data Publishing Lane): データの可用性は DA ノードによって集約署名により検証され、その結果が共識ネットワークに提出されます。この設計により、データの公開はわずかな重要なデータストリームの処理のみを必要とし、従来のブロードキャスト方式のボトルネック問題を回避し、効率を著しく向上させています。
データのセキュリティと効率性を確保するために、0G DA はランダム性に基づいた検証手法を使用し、集約署名メカニズムと組み合わせて完全な検証プロセスを形成しています:
· ランダム構築リーガルグループ: 検証可能なランダム関数(Verifiable Random Function, VRF)により、共識システムは検証者リストからランダムに選択された一組の DA ノードを含むリーガルグループ(quorum)を構築します。このランダム選択方法により、リーガルグループの正直性分布が検証者リスト全体と一貫しているという理論的な保証が得られるため、データ可用性クライアントはリーガルグループと手を組むことができません。
· 集約署名検証: リーガルグループは保存されたデータブロックをサンプリング検証し、集約署名を生成して可用性証明を 0G 共識ネットワークに提出します。この集約署名方式により、検証効率が大幅に向上し、そのパフォーマンスは従来の Ethereum より数桁速いです。
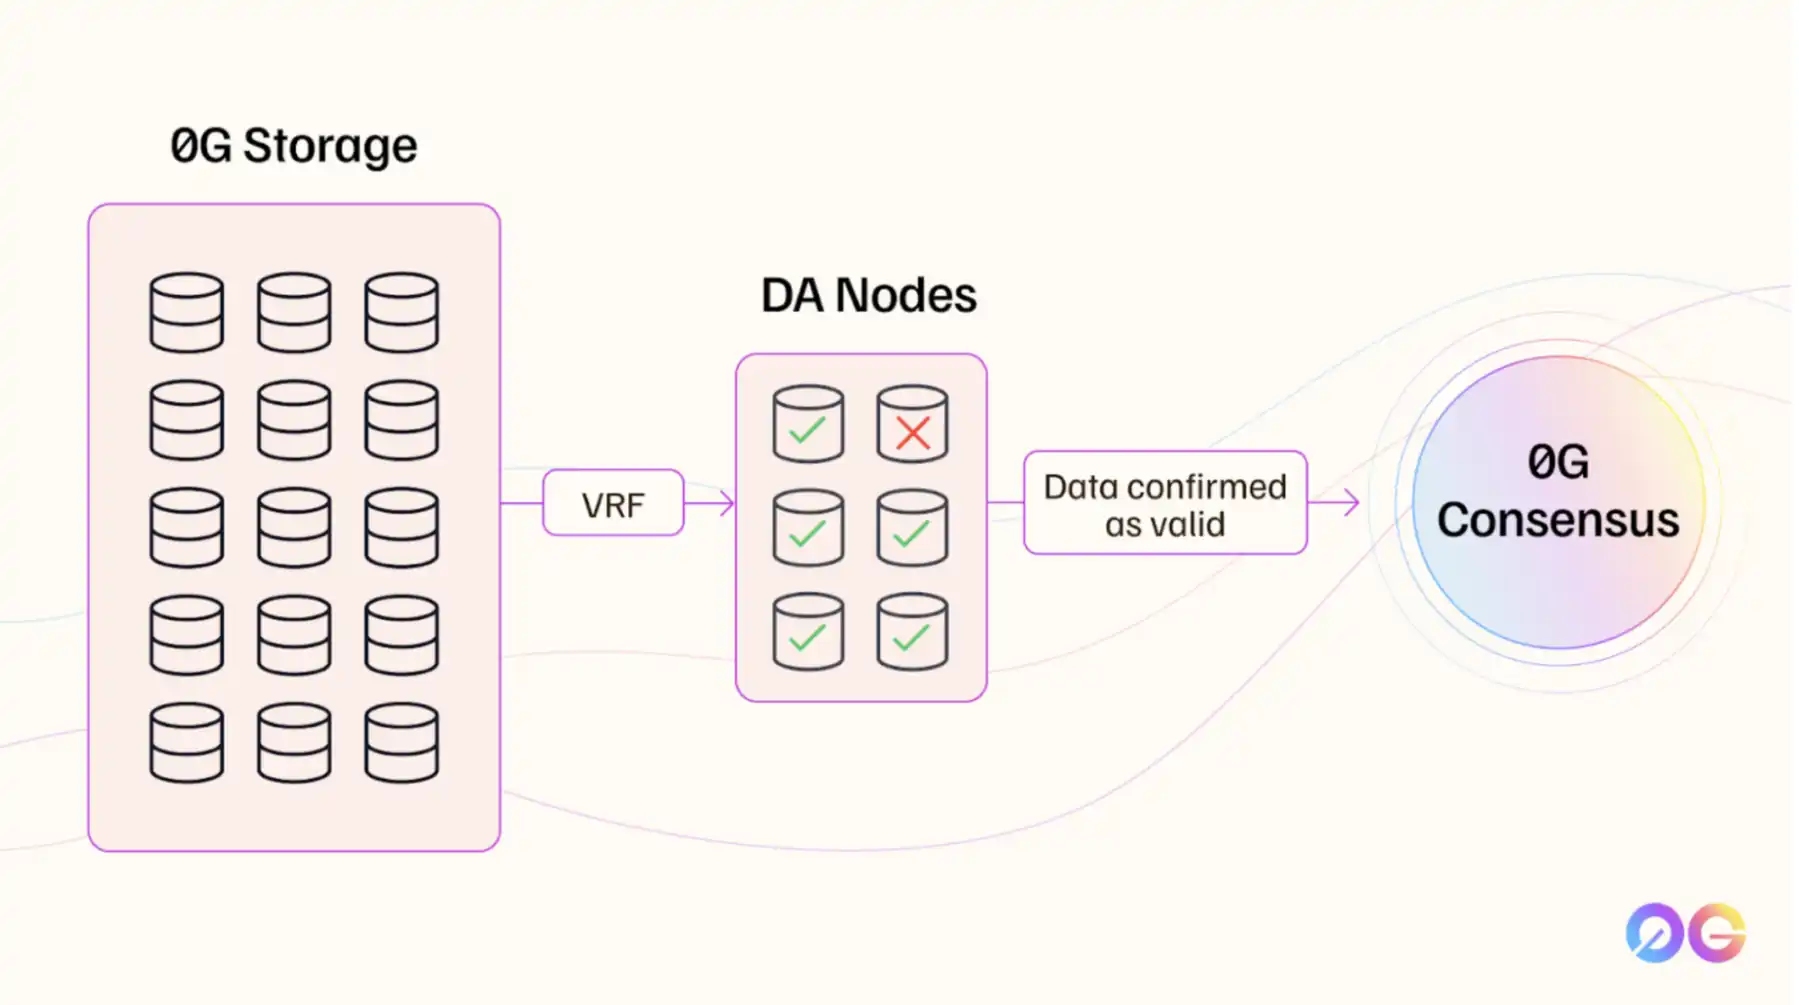
0G の検証プロセス
上記のメカニズムにより、0G DA は効率的でスケーラブルであり、安全性が保証されたデータ可用性ソリューションを提供し、分散型 AI アプリケーションに堅固な基盤を提供しています。
4、0G コンピュート(0G Compute)
0G コンピューティングネットワークは、コミュニティに強力な AI 計算能力を提供することを目的とした分散型フレームワークです。スマートコントラクトを通じて、コンピュートプロバイダーは提供するAIサービスの種類(例:モデル推論)を登録し、サービスの価格を設定できます。ユーザーがAI推論リクエストを送信すると、サービスプロバイダーはユーザーの残高に応じて応答するかどうかを決定し、効率的なコンピュートリソースの割り当てを実現します。
取引コストとネットワーク効率をさらに向上させるために、サービスプロバイダーは複数のユーザーリクエストを一括処理できます。この方法により、オンチェーン決済の回数が効果的に減少し、頻繁な取引によるリソース消費が低減されます。同時に、0G コンピューティングネットワークはゼロ知識証明(ZK-Proofs)技術を採用しており、オフチェーン計算とオンチェーン検証を通じて取引データを大幅に圧縮し、オンチェーン決済コストを削減しています。0G のストレージモジュールと組み合わせることで、拡張可能なオフチェーンデータ管理メカニズムは、ストレージリクエストの追跡データキーのオンチェーンコストを大幅に削減し、ストレージと検索の効率を向上させます。
現時点では、0G の分散型AIネットワークは主にAI推論サービスを提供し、効率性とコスト削減の観点で優位性を示しています。将来的には、0G は能力をさらに拡張し、推論からトレーニングなど、より多くのAIタスクの包括的な分散型実現を目指し、ユーザーにより完全なソリューションを提供する予定です。
エコシステムの発展
0G のテストネットは現在、Newton v2 からGalileo v3 にアップグレードされ、公式データによると8000人以上の検証者が存在します。ストレージネットワークには1591人のアクティブなマイナーがおり、現在43万件以上のファイルアップロードを処理し、総計450.72Gのストレージスペースを提供しています。
0G プロジェクトは、協力企業の増加と深化に伴い、分散型AI領域での影響力を着実に拡大しています。公式データによると、現在450回以上の統合が完了しており、AIコンピューティングパワー、データ、モデル、フレームワーク、インフラ、DePinなど、包括的な領域がカバーされています。
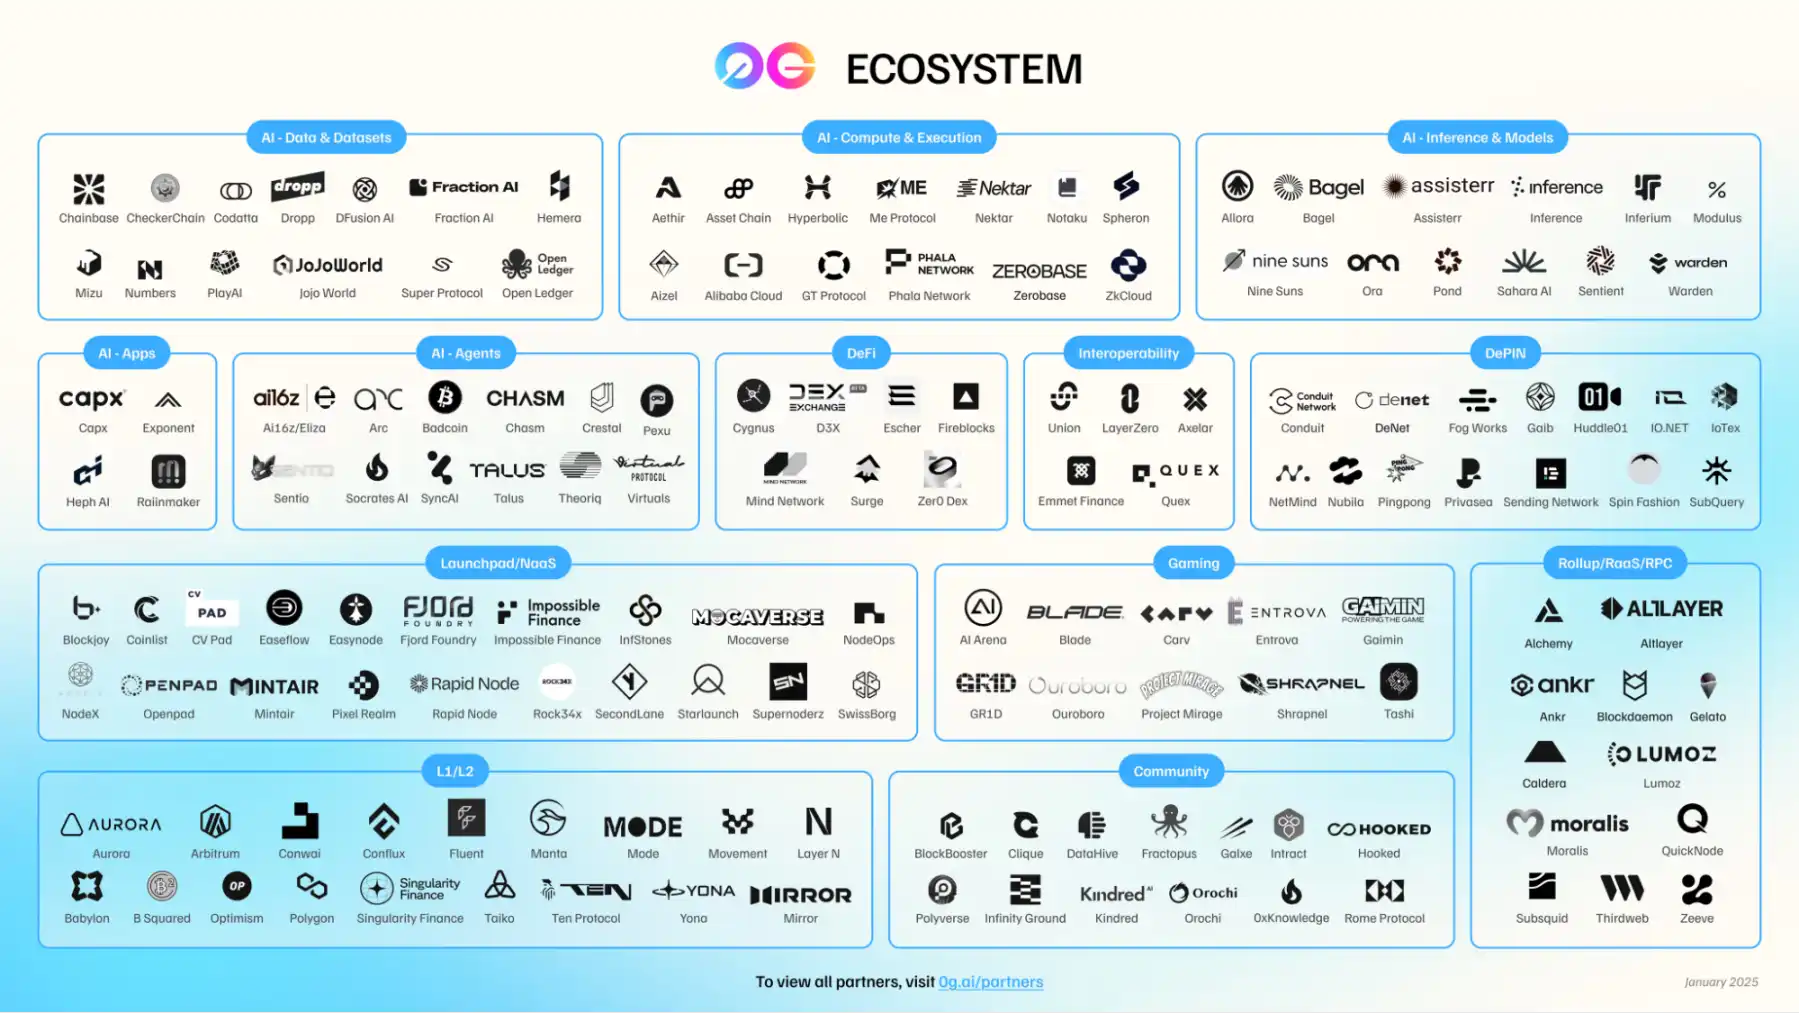
0G エコシステム図
同時に、0G Foundationは8888万ドル相当のエコシステム基金を立ち上げ、AI関連プロジェクトの開発を支援しており、以下の一連のネイティブアプリケーションが登場しています:
· zer0:AI 駆動の DeFi リクイディティソリューション、オンチェーンのリクイディティ最適化サービスを提供
· H1uman:分散型 AI エージェントファクトリー、スケーラブルな AI 統合ワークフローを作成
· Leea Labs:複数の AI エージェントのインフラストラクチャ、安全なマルチエージェントシステム展開をサポート
· Newmoney.AI:スマート DeFi エージェントウォレット、投資と取引の自動化管理
· Unagi:AI 駆動のオンチェーンエンターテイメントプラットフォーム、アニメとゲームを融合した Web3 エクスペリエンス
· Rivalz:検証可能な AI オラクル、スマートコントラクトに信頼性のある AI データアクセスを提供
· Avinasi Labs:長寿研究に特化した AI プロジェクト
参加方法
一般ユーザーは現在、以下の方法で 0G エコシステムに参加できます:
· 0G テストネットの相互作用に参加:0G は Testnet V3(Galileo v3)をリリースしました。ユーザーは公式のテストネットページ(0G Testnet Guide)にアクセスしてテストトークンを入手し、0G チェーン上の DApps で相互作用を体験できます。
· Kaito イベントへの参加:0G は現在、Kaito プラットフォームのコンテンツ作成イベントに参加しています。ユーザーは、0G に関連するテクニカル分析、エコシステムの進捗状況、または AI アプリケーションのユースケースなど、質の高いコンテンツを作成して共有し、インタラクションに参加して報酬を獲得できます。
チャレンジと展望
0G はストレージ領域で強力な技術力を発揮し、分散型ストレージに完全なモジュール化されたソリューションを提供し、優れた拡張性と経済性を備えています(ストレージコストは 10-11 ドル/TB まで低下)。同時に、0G はデータ可用性レイヤー(DA)を通じてデータの検証可能性の問題を解決し、将来の大規模な AI 推論およびトレーニングタスクに堅固な基盤を築きました。この設計により、分散型 AI はデータ保管層で強力なサポートを受け、開発者に最適化されたストレージおよび検索体験が提供されています。
性能の面では、0G はメインネットの TPS を 3,000 から 10,000 の範囲に向上させることを予定しており、これは従来の性能の 10 倍の成長であり、AI 推論やハイフリークエンシートレーディングなどのタスクに伴う高い計算要件を満たすためのネットワークの拡張を保証しています。ただし、算力市場とモデルに関しては、0G にはさらなる開発が必要です。現時点では、0G の算力事業はまだ AI 推論サービスに限定されており、モデルトレーニングタスクのサポートには、より多くのカスタマイズされた設計と技術革新が必要です。AI 開発の核心要素として、モデルと算力は製品のアップグレードや大規模なアプリケーションの推進だけでなく、0G が最大の AI Layer 1 エコシステムになることを実現するための必須の要素です。
サマリー
現状:多様な切り口、課題に直面
上記の6つの AI Layer1 プロジェクトを振り返ると、それぞれが異なる切り口を選択し、AI アセット、パワー、モデル、ストレージなどの中核要素を中心に、分散型 AI インフラストラクチャとエコシステム構築の道を探求しています:
・ Sentient: 分散型モデルの開発に焦点を当て、Dobby シリーズを導入し、モデルの信頼性、整合性、忠誠心を強調し、基盤となるブロックチェーンの開発は引き続き進行中であり、モデルとチェーンの深い融合が実現されます。
・ Sahara AI: AI アセットの所有権保護を中心に、最初の段階ではデータの権利と流通に重点を置き、AI エコシステムに信頼性のあるデータ基盤を提供することに注力しています。
・ Ritual: 推論における分散型パワーの効率的な展開に焦点を当て、ブロックチェーン自体の機能を強化し、システムの柔軟性と拡張性を向上させ、AI ネイティブアプリケーションの発展を支援しています。
・ Gensyn: 分散型モデルトレーニングの課題に取り組み、技術革新を通じて大規模な分散トレーニングのコストを削減し、AI パワーの共有と民主化に実現可能な道筋を提供しています。
・ Bittensor: 比較的成熟したサブネットプラットフォームであり、トークンインセンティブと分散型ガバナンスを通じて、豊富な開発者とアプリケーションエコシステムを先駆的に構築し、分散型AIの初期の手本です。
・ 0G: 分散型ストレージを切り口とし、AI エコシステムにおけるデータの保存と管理の課題に焦点を当て、徐々により包括的なAIインフラストラクチャとアプリケーションサービスに拡大しています。
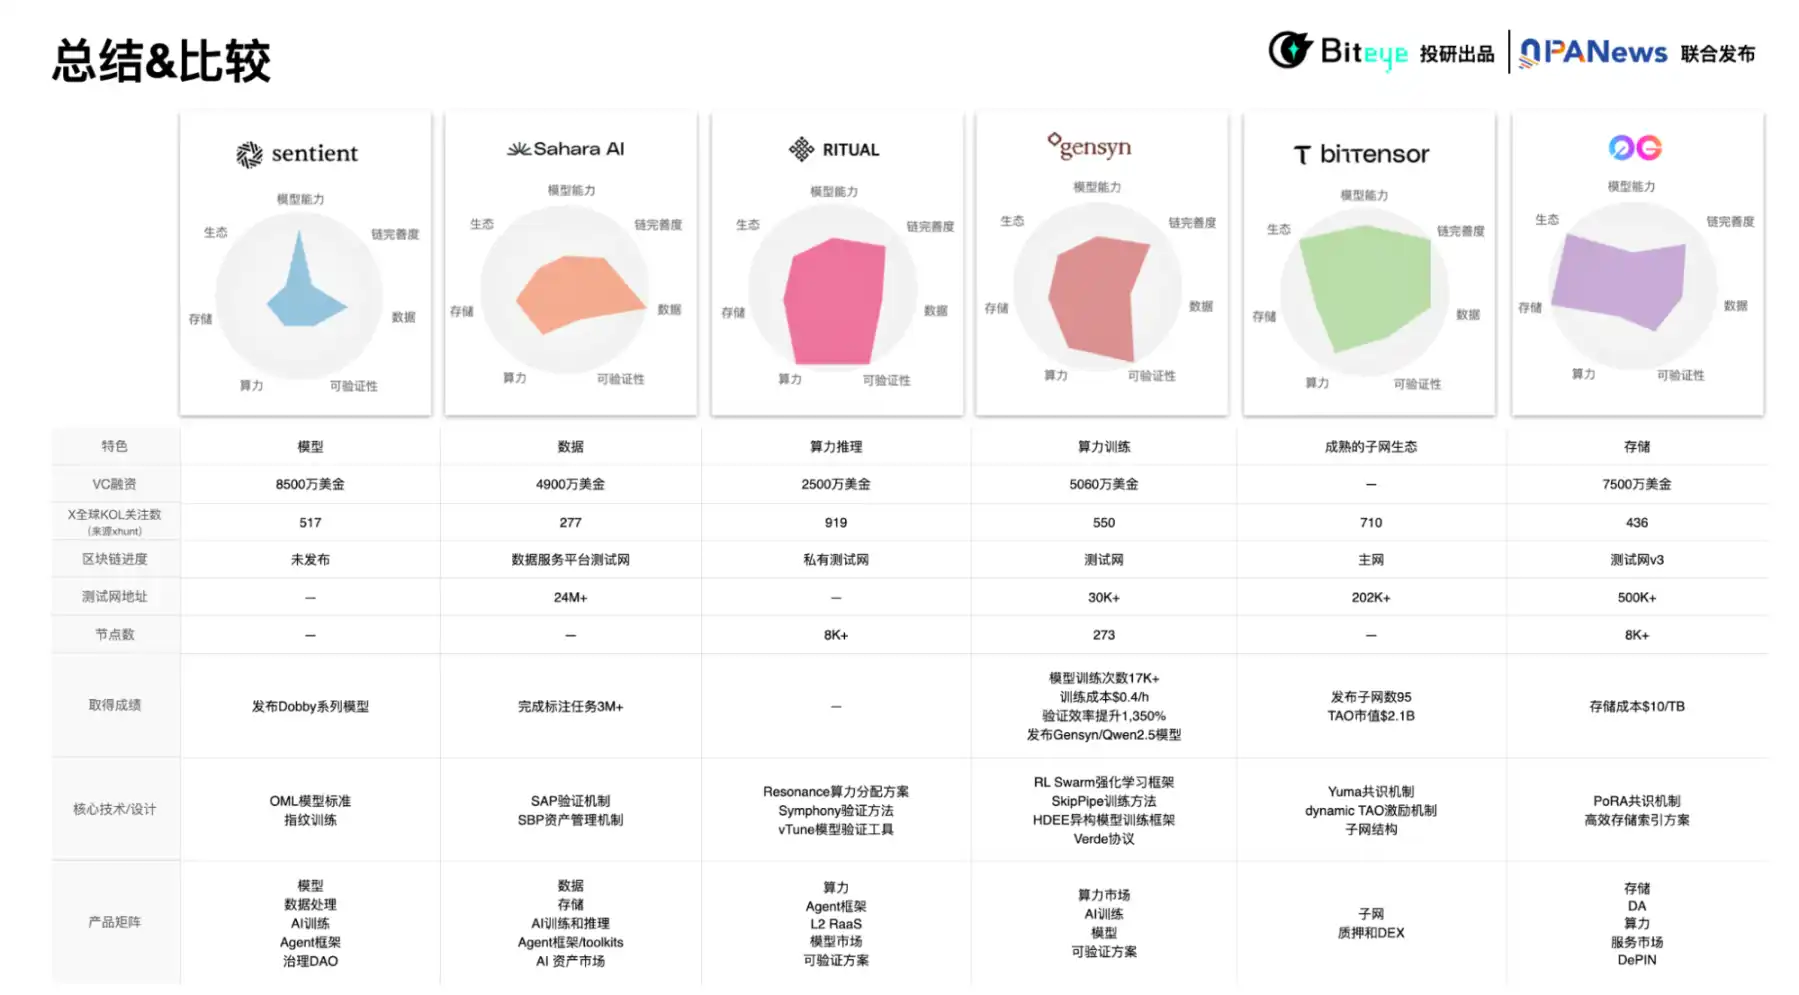
プロジェクト比較とサマリー
全体的に見ると、これらのプロジェクトは技術的な進化だけでなく、エコシステム戦略の補完性も持ち、ブロックチェーン上の分散型AIエコシステムの多様な発展を推進しています。しかしながら、この分野全体がまだ初期の探索段階にあることは否定できません。多くの前向きなビジョンや計画が提示されていますが、実際の開発進捗とエコシステム構築には引き続き時間がかかります。多くの重要な基盤と革新的なアプリケーションの実装も必要です。
現在の必要不可欠な核心問題は、より多くのパワーやストレージなどの基本的なノードをネットワークに引き込み、それらを魅力づけ、奨励することです。ビットコインネットワークが10年以上の歳月をかけて主流市場で認められるようになったように、分散型AIネットワークもノードの規模を拡大し続ける必要があり、膨大なAIタスクが必要とするパワーに対応することができます。そして、ネットワーク内のパワーやストレージなどのリソースが一定の豊富さに達すると、コストを効果的に引き下げ、パワーの包括的な提供を促進し、最終的に分散型AIの壮大なビジョンを実現できます。
さらに、オンチェーン AI アプリケーションは革新的な側面で依然として不足しています。現在、多くの製品はWeb2モデルを基に単純な移行を行っており、ブロックチェーンのネイティブメカニズムとの深い統合を欠いた革新的なデザインが行われておらず、分散型AIのユニークな利点を十分に示すことができていません。これらの現実の課題は、業界の持続的な発展には技術の進展だけでなく、ユーザーエクスペリエンスの向上やエコシステム全体の継続的な改善も不可欠であることを示しています。
持続的な発展:AI Layer1 および DeAI 優良プロジェクトが続々登場
ここでは、以上で詳しく説明したプロジェクト以外にも、時代の大きな流れの中で、私たちが注目すべき新しい AI Layer1 および DeAI プロジェクトがいくつかあります。(本文の制約により、ここでは簡潔な紹介のみを行いますが、今後はさらに多くのAIトラックを追跡するための調査コンテンツを発信する予定です)
Kite AI
Kite AI は、そのコアコンセンサスメカニズムである「Proof of Attributed Intelligence」(PoAI)に基づき、EVM互換のLayer 1ブロックチェーンを構築し、公正なAIエコシステムを構築することを目指しています。これにより、データ提供者、モデル開発者、およびAIエージェント作者がAIの付加価値創造における貢献が透明に記録され、公正な報酬を受け取ることができるようになり、少数のテクノロジージャイアントによるAIリソースの独占を打破します。現在、Kite AI は、C層アプリケーションに焦点を当て、サブネットワークアーキテクチャや取引市場などを通じて、AIアセットの開発、権利確定、および実現を保証しています。
Story
オープンIP(知的財産権)に焦点を当てたAI Layer 1を展開し、クリエイターや開発者が、様々なコンテンツIPを登録、追跡、許可、管理、および実現できるツールセットを提供することで、オンチェーンでのプロセス全体をサポートします。Story では、ユーザーがオリジナルコンテンツをNFTに鋳造し、柔軟な許可と収益分配メカニズムを組み込むことができ、ユーザーが二次創作やビジネス提携を行いつつ所有権と収益配分を透明かつ確認可能にします。
Vana
Vana は、「ユーザーデータの実現とAIトレーニング」を目的とした新世代のデータベースAI Layer 1です。Vanaは、個人が自らのデータを所有、管理、共有できるようにすることで、大企業がデータを独占する制約から脱却します。ユーザーは、「データDAO」(データの所有権を保持したまま、ソーシャル、ヘルス、消費などのデータを収集し、AIトレーニングに利用し、配当に参加する)を通じて、データの所有権を確保しながら、AIトレーニングに貢献し、配当に参加します。さらに、Vanaはプライバシーとセキュリティに重点を置き、プライバシー計算と暗号認証技術を採用して、ユーザーデータの安全を保護します。
ニリオン
ニリオンは、データプライバシーとセキュアコンピューティングに特化した「ブラインドコンピューテーションネットワーク」であり、開発者や企業にマルチパーティ計算(MPC)、ホモモーフィック暗号、ゼロ知識証明などのプライバシー強化技術を提供し、元のデータを複合化することなくデータの保存、共有、および複雑な計算を実行します。これにより、AI、デセントラルライズドファイナンス(DeFi)、医療、パーソナライズドアプリケーションなどのシナリオが、高価値で機密性の高い情報を安全に処理できるようになり、データ漏洩のリスクを心配する必要がありません。現在、ニリオンエコシステムは、AIプライバシー計算、パーソナライズされたインテリジェントエージェント、プライベートナレッジベースなどの革新的なアプリケーションをサポートしており、Virtuals、NEAR、Aptos、Arbitrumなどのパートナーを引き付けています。
Mira Network
Mira Networkは、AI出力向けの「デセントラルライズドバリデーション」を行う革新的なネットワークであり、自律型AIに信頼性の高い検証層を提供することを目的としています。 Miraの中核的なイノベーションは、バックグラウンドで複数の異なる言語モデルを同時に実行する統合評価技術を採用し、AIによって生成された結果を具体的な主張に細分化し、分散モデルノードに独立して検証させ、ほとんどのモデルが合意に達し、「事実」として内容を認定した場合にのみユーザーに出力されます。 このような多モデル合意メカニズムにより、Miraは、単一モデルの25%の幻覚率を3%に著しく低減し、エラーレートを90%以上削減しています。 Miraは、中央集権的な大規模機関や単一の大規模モデルに依存せず、分散ノードと経済的インセンティブメカニズムを採用し、Web2およびWeb3のAIアプリケーションの検証可能な基盤層となり、AIの副運転手から自律決定能力を持ち信頼できるAIシステムへの移行を実現しています。
Prime Intellect
Prime Intellectは、分散型AIトレーニングとコンピューティングリソース基盤に焦点を当てたプラットフォームであり、グローバルな計算リソースを統合し、オープンソースAIモデルの協調トレーニングを推進しています。 中核となるアーキテクチャには、ピアツーピアのコンピューティングリソースマーケットとオープンなトレーニングプロトコルが含まれており、誰でもがネットワークにアイドル状態のハードウェアを寄贈し、大規模モデルのトレーニングと推論に使用できるようにしています。これにより、従来のAIの高度な集中、ハードルの高さ、およびリソースの浪費を緩和しています。 同時に、Prime Intellectは、数十億のパラメータを持つ大規模モデルの地理的に分散された効果的なトレーニングをサポートするオープンソース分散トレーニングフレームワーク(OpenDiLocoなど)を開発し、アルゴリズムの革新と特殊なレースに焦点を当てています。ただし、メタゲノムベースのMETAGENE-1モデルおよび数学推論に焦点を当てたINTELLECT-MATHプロジェクトなど。 2025年には、Prime Intellectは、ソースコードと数学コードのバリデーションデータセットを作成するために、クラウドソーシングと強化学習を利用したSYNTHETIC-1プロジェクトを立ち上げました。
展望:オープンでウィンウィンな分散型AIの未来
数々の挑戦に直面していますが、オンチェーンの分散型AIは広大な成長機会と革新の可能性を依然として秘めています。基盤技術の着実な成熟と各プロジェクトの約束の実現に伴い、分散型AIの独自の利点が次第に明らかになり、AI Layer1たちは以下のビジョンを実現することが期待されています:
· コンピューティングパワー、データ、モデルの民主的共有により、技術の寡占を打破し、世界中の個人、企業、組織がAIイノベーションに無制限に参加できる環境を実現します。
· AIアセットの所有権の流通と信頼性の高いガバナンスにより、データ、モデルなどの主要資産がオンチェーンで自由に流通し取引され、所有者の利益が保護され、健全なオープンエコシステムが形成されます。
· より信頼性が高く、追跡可能で整合性のあるAIの提供は、AIの安全でコントロール可能な発展を確実なものにし、「AI悪用」のリスクを効果的に低減します。
· 金融、医療、教育、コンテンツ制作などの分野でのAIの普及により、AIの巨大な価値を引き出し、分散型の方法で社会全体に利益をもたらします。
ますます多くのAI Layer1プロジェクトが前進している中、分散型AIの目標が早く実現されることを期待し、さらに多くの開発者、イノベーター、参加者が参加し、よりオープンで多様性に富み、持続可能なAIエコシステムを共に構築していくことを望んでいます。
BlockBeats の公式コミュニティに参加しよう:
Telegram 公式チャンネル:https://t.me/theblockbeats
Telegram 交流グループ:https://t.me/BlockBeats_App
Twitter 公式アカウント:https://twitter.com/BlockBeatsAsia







