AIはメモリの欠如と過剰の両方を引き起こしました。

3 月 29 日、華強北とアメリカの小売市場は、メモリ価格の絶壁の下落を経験しました。Corsair 32GB DDR5-6400 デュアルチャンネルキットは、490 ドルから380 ドルに急落し、1 日で 22% 下落しました。国内の 32GB DDR5 ハイファンクションキットは、1 週間で 800 元急落し、チャネルパートナーはパニック売りを行い、「1 日で 100 ドル以上下がった」と報告しています。
しかし、この数字をより長期の時間軸で見ると、完全に異なる状況が現れます:急落後も、現在のDDR5の価格は2025年7 月の 4 倍になります。これは、AI産業チェーンにおける正確なサプライとデマンドの不一致であり、同じ力がまず不足を作り出し、そして過剰恐慌を作り出しました。
ローラーコースター:8 か月で 540% 上昇、1 か月で 22% 下落
2025年7 月、主要な 32GB DDR5-6000 デュアルチャンネルキットは、アメリカの小売市場でわずか77ドルでした。そして、2026 年1月までに、同じキットの価格は490ドルに急騰しました。8か月で540% の上昇。
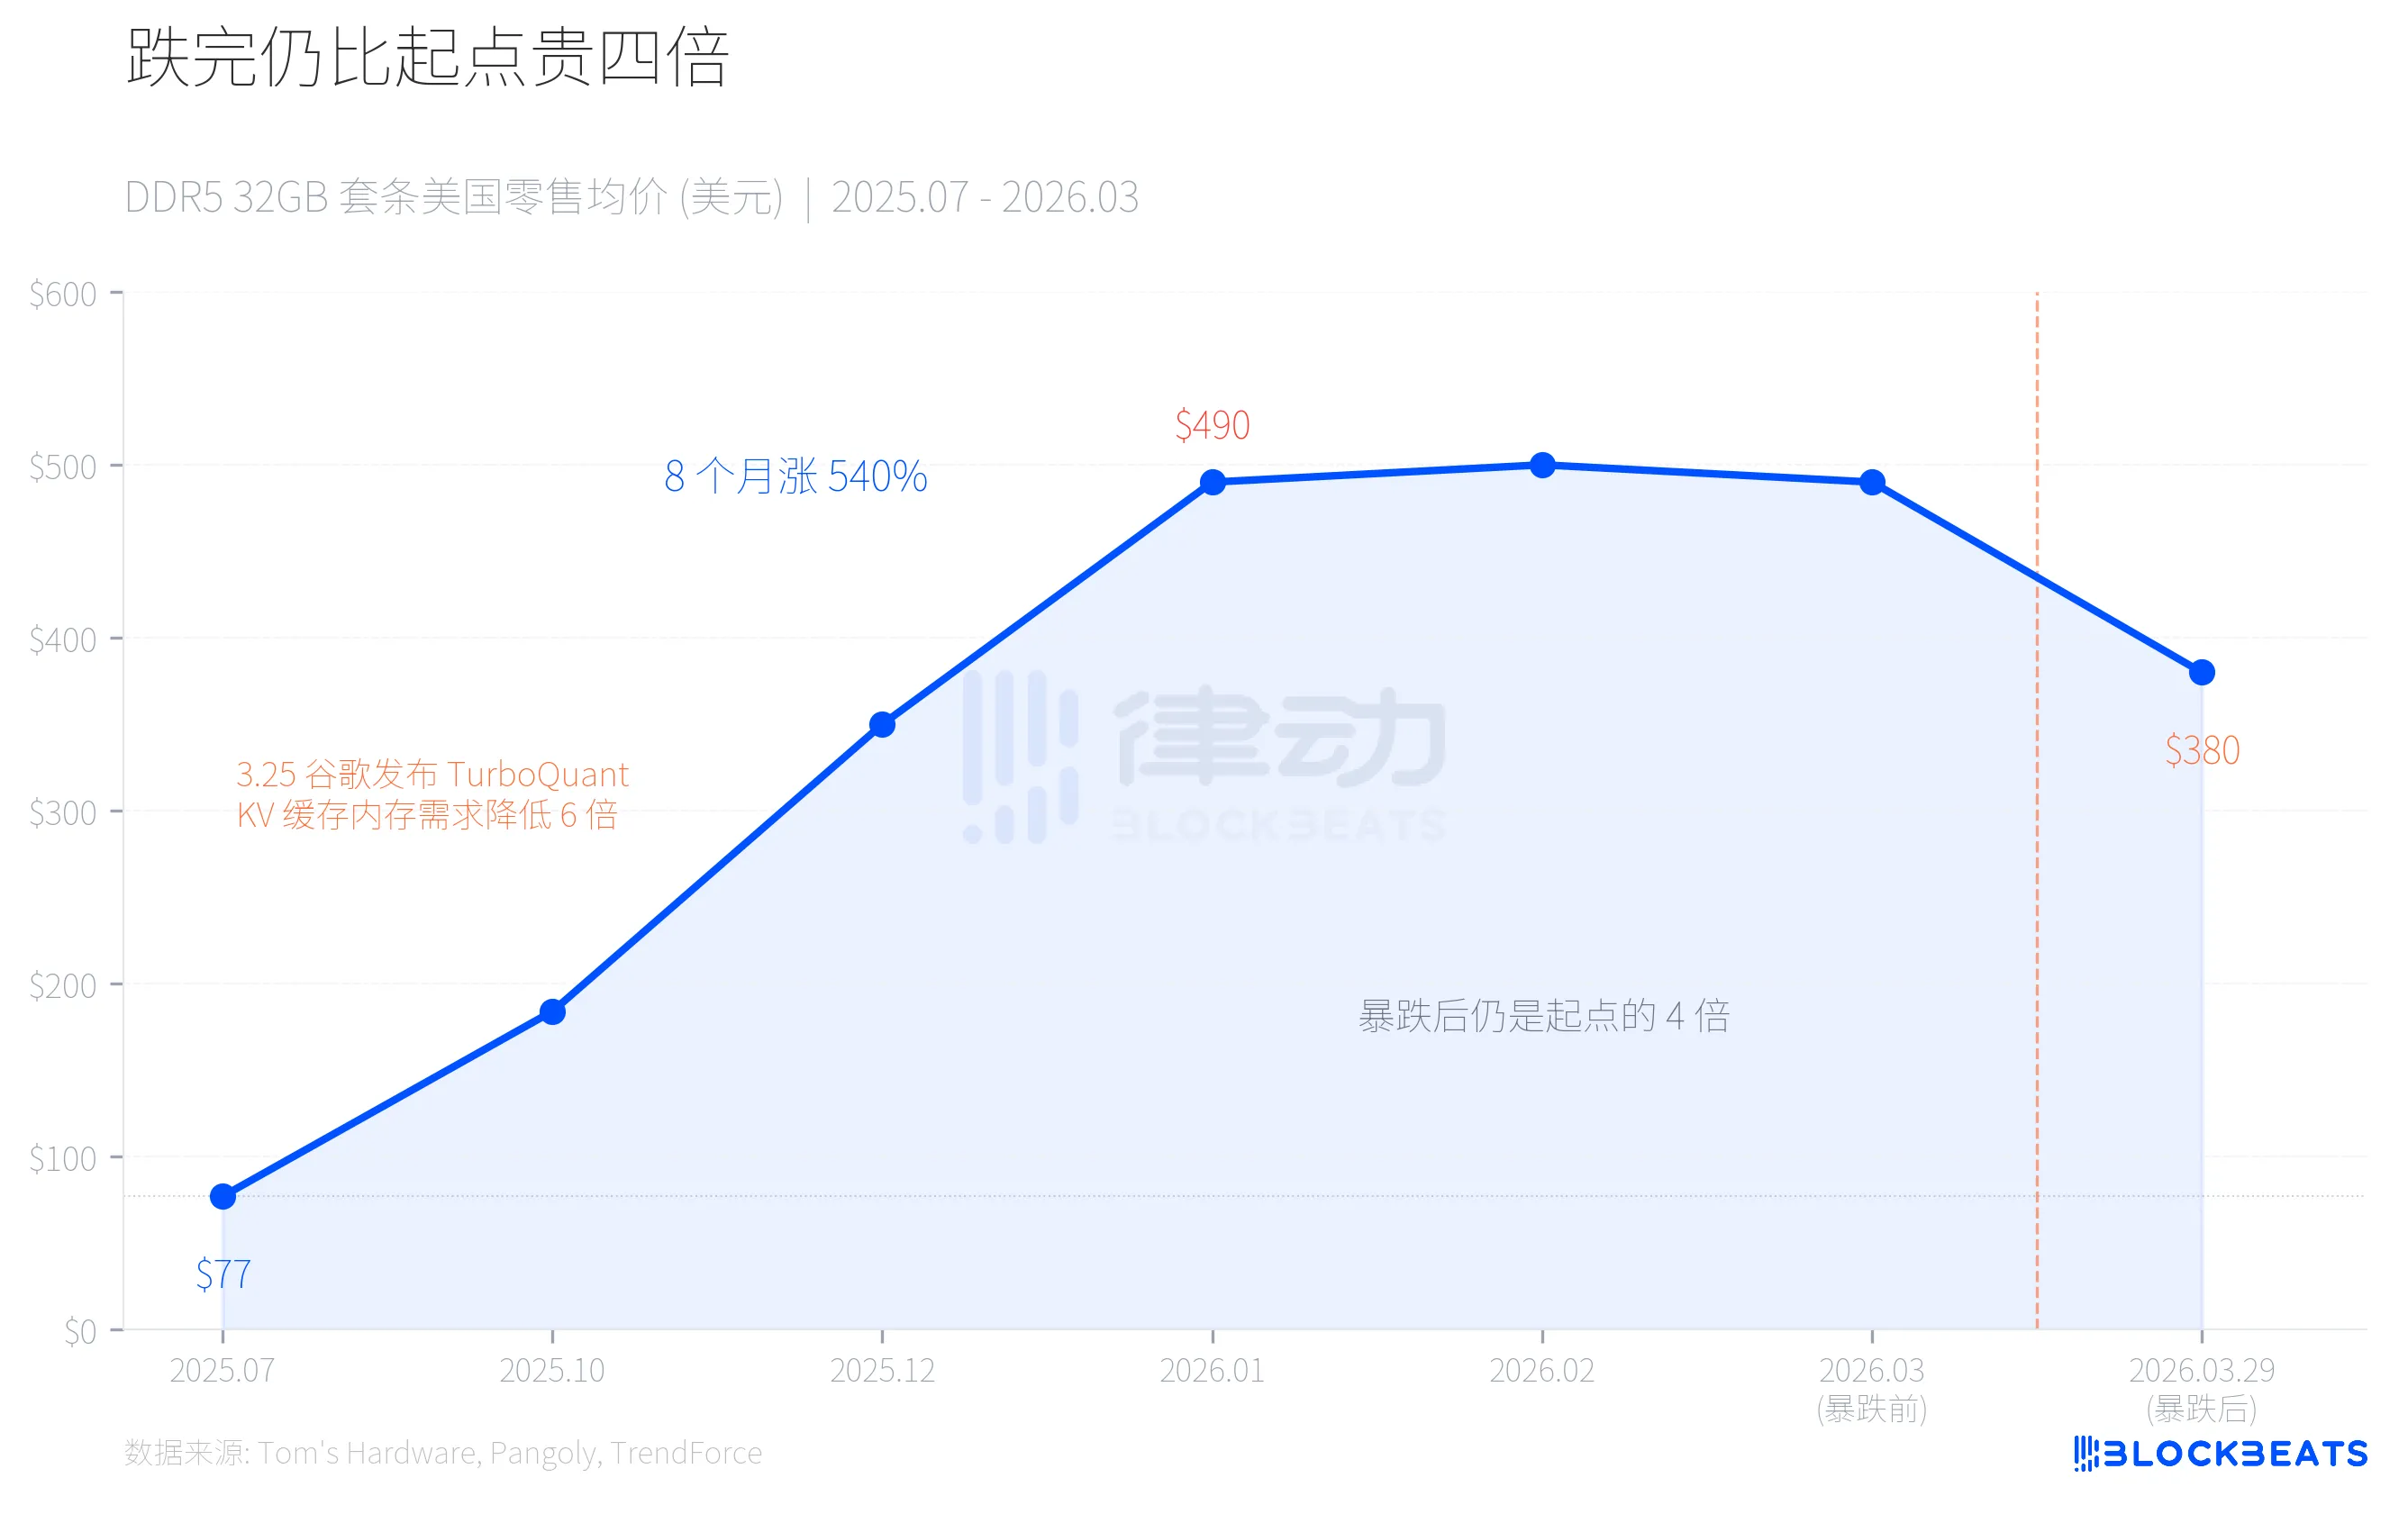
価格上昇の原因は、消費者が突然コンピュータをアップグレードし始めたためではありません。 TrendForceのデータによれば、2026年第1四半期のDRAM契約価格は前四半期比で90%-95% 上昇し、そのうちPC DRAMの値上がり率は100%を超え、これまでの記録を塗り替えました。すべてを推進しているのは、AIインフラストラクチャの一部が特定のメモリに対する渇望の需要です。
そして、3 月 25 日、Google が TurboQuant という圧縮アルゴリズムを発表しました。4日後、メモリ価格が暴落しました。
生産能力はどこに行ったのか?HBM があなたのメモリを食べた
この値上がりサイクルを理解するには、まず鍵となる技術的パラメータを理解する必要があります。HBM(High Bandwidth Memory、NVIDIAのAIチップ向けの専用メモリ)は、通常のDDR5の1GBあたりのウェハ面積の3倍を消費します。Tom's Hardwareによる報告によると、これは同じウェハでも、HBMを作るとDDR5の容量の3分の1しか生産できないことを意味します。
サムスン、SK Hynix、およびMicronの3大メモリメーカーは、HBMの高い利益率に対応して、最大40%の先進製造プロセスのウェハ生産能力をHBM製造に転換しました。 TrendForceのデータによると、2026年第1四半期までに、DDR5の利益率がHBM3eを初めて超え、消費者向けメモリの供給がどれほど圧迫されているかが反映されると予想されています。
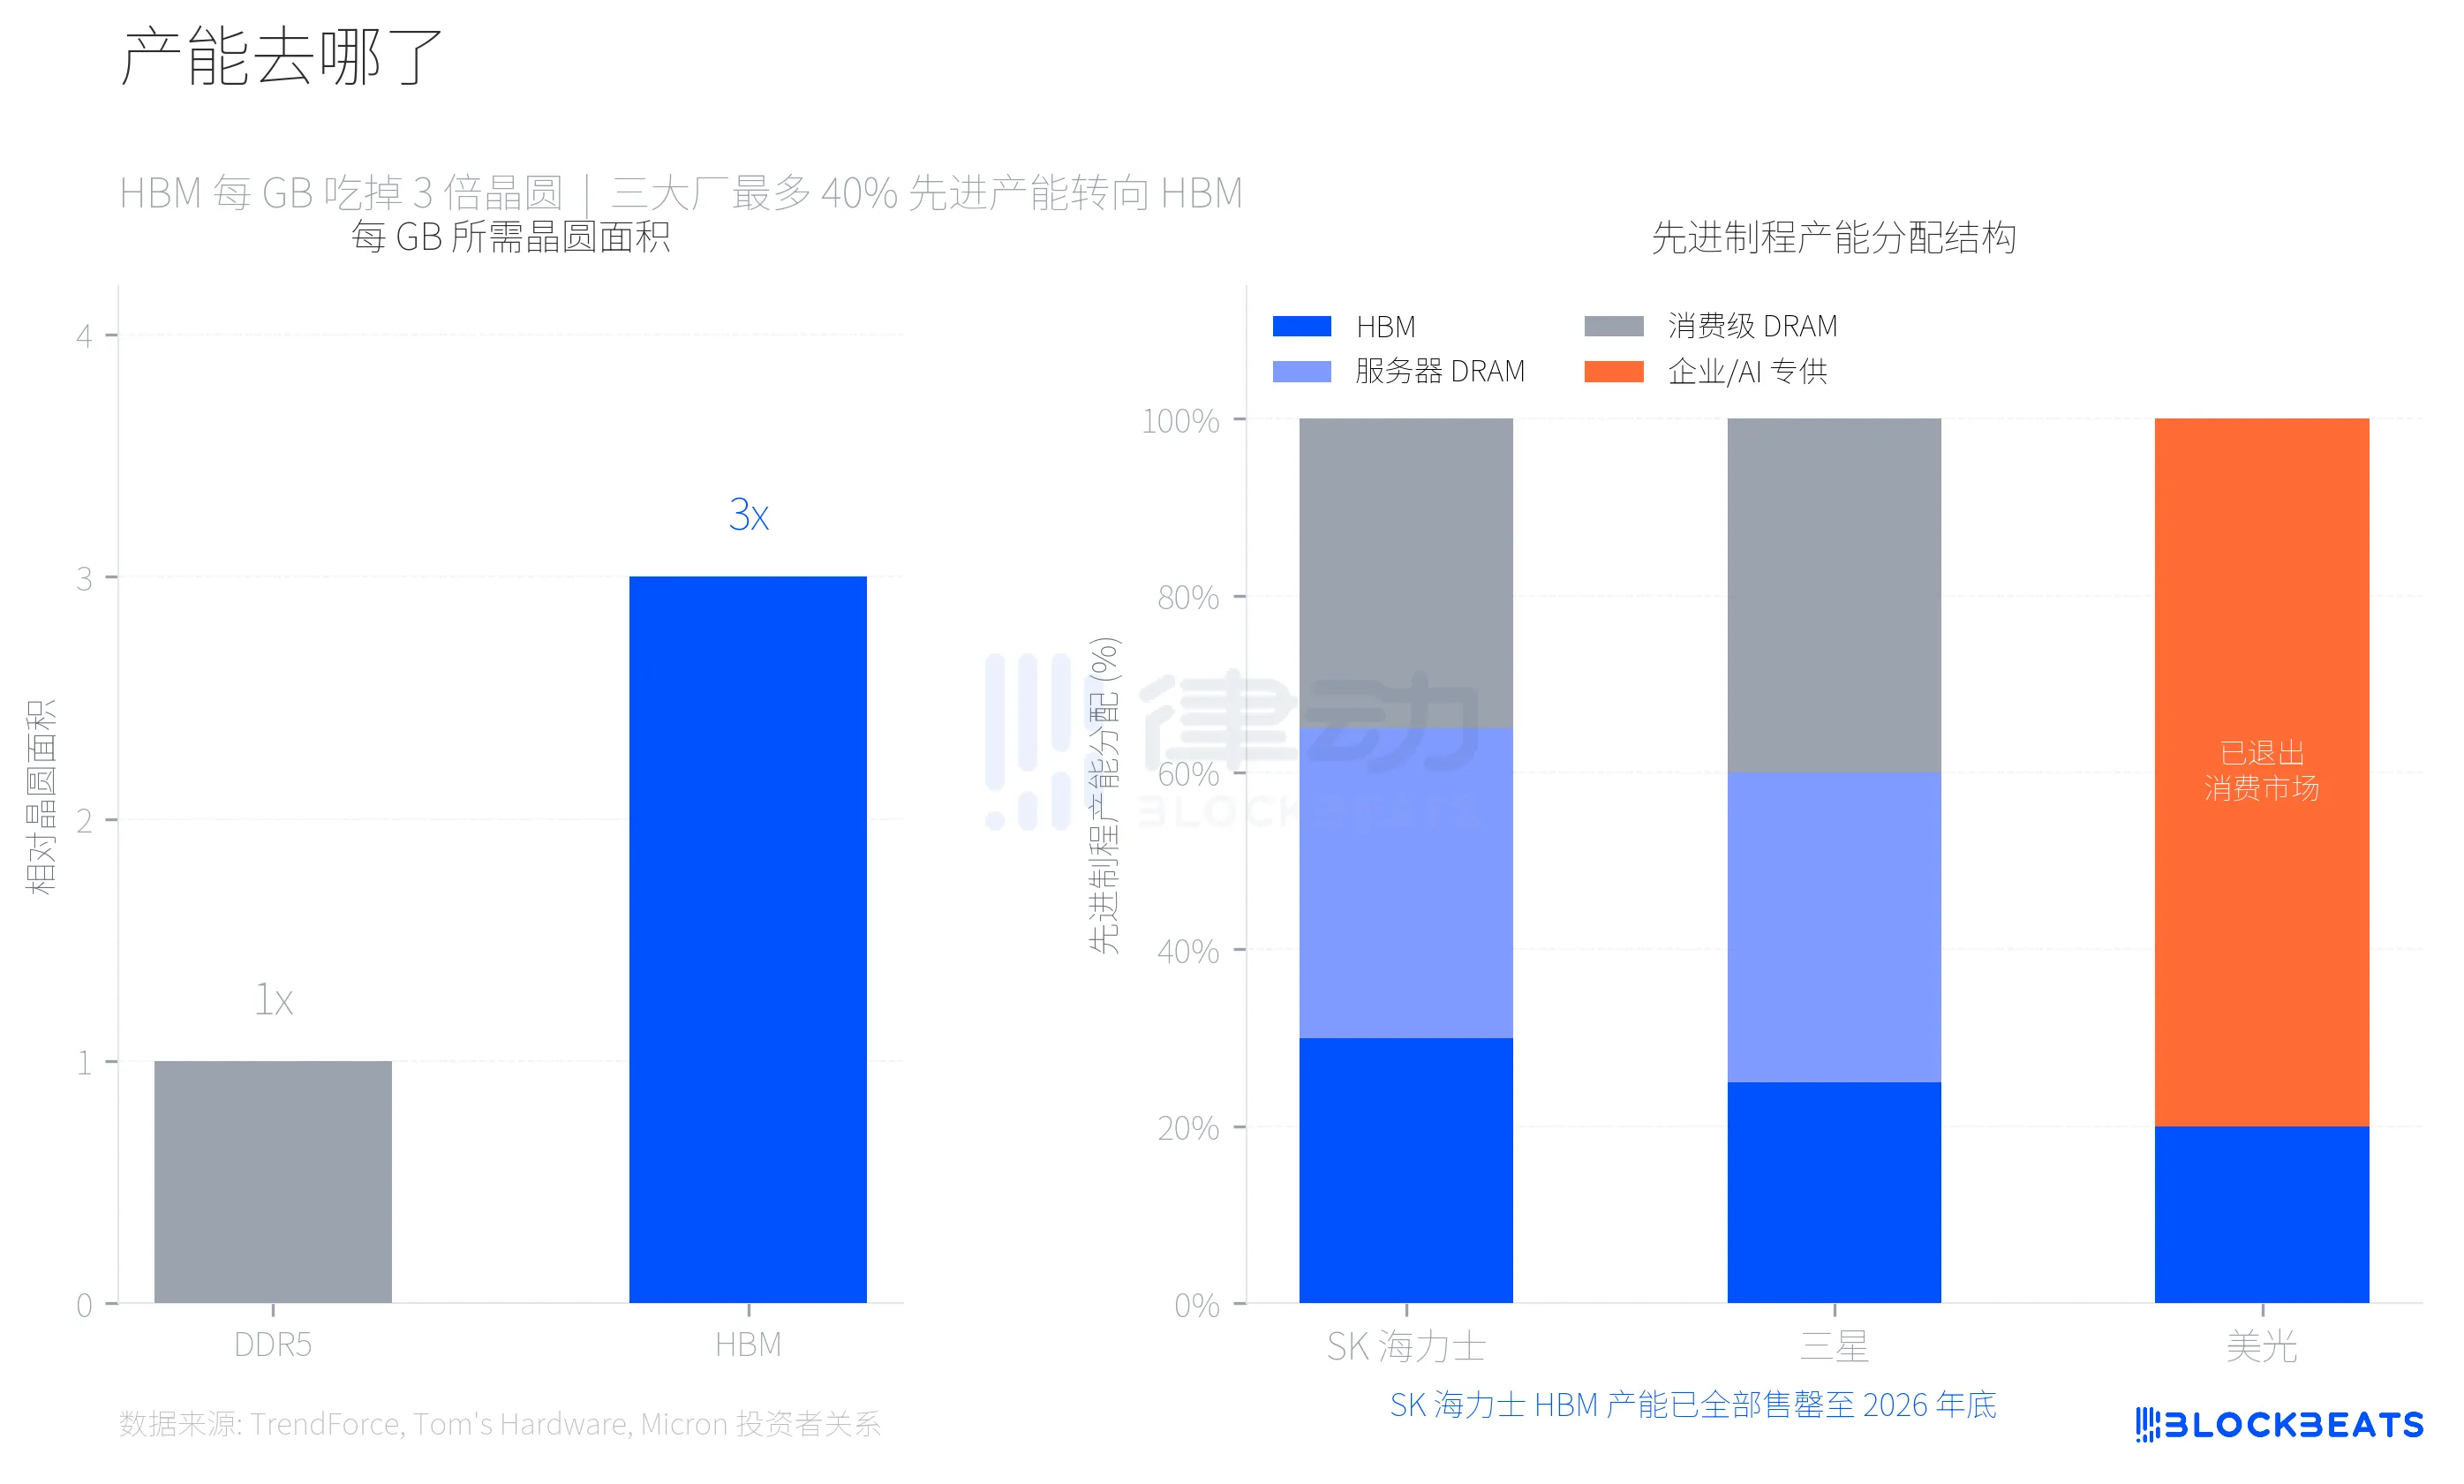
美光の選択は最も過激だった。2025年12月、同社は29年間運営してきた消費者ブランド Crucial を閉鎖し、完全に消費者向けメモリとストレージ市場から撤退し、エンタープライズおよびAI顧客に完全に転換すると発表した。美光の投資家関係公告によると、2025会計年度の総収入は3738億ドルであり、データセンターやAIアプリケーションは総収入の56%を占めていた。消費市場はもはややる価値がない。
SKハイニックスのHBM供給能力はすでに2026年末まで完売している。サムスンは2026年末までにHBMの月産能力を17万枚から25万枚に引き上げる予定だ。新しいウェハ工場(サムスン P4L と SKハイニックス M15X)は最も早くて2027年から2028年までに量産化される見込みだ。言い換えれば、消費者向けDRAMの供給不足は構造的なものであり、1〜2四半期ですぐに緩和されるものではない。
転換する構図、SKハイニックスがサムスン 40年の覇者を打破
この供給能力の転送はメモリ業界の権力図を書き換えた。TrendForceのデータによると、2025年第2四半期、SKハイニックスはNVIDIAとの緊密な連携により、HBM市場で62%のシェアを獲得し、サムスンは17%、美光は21%だった。
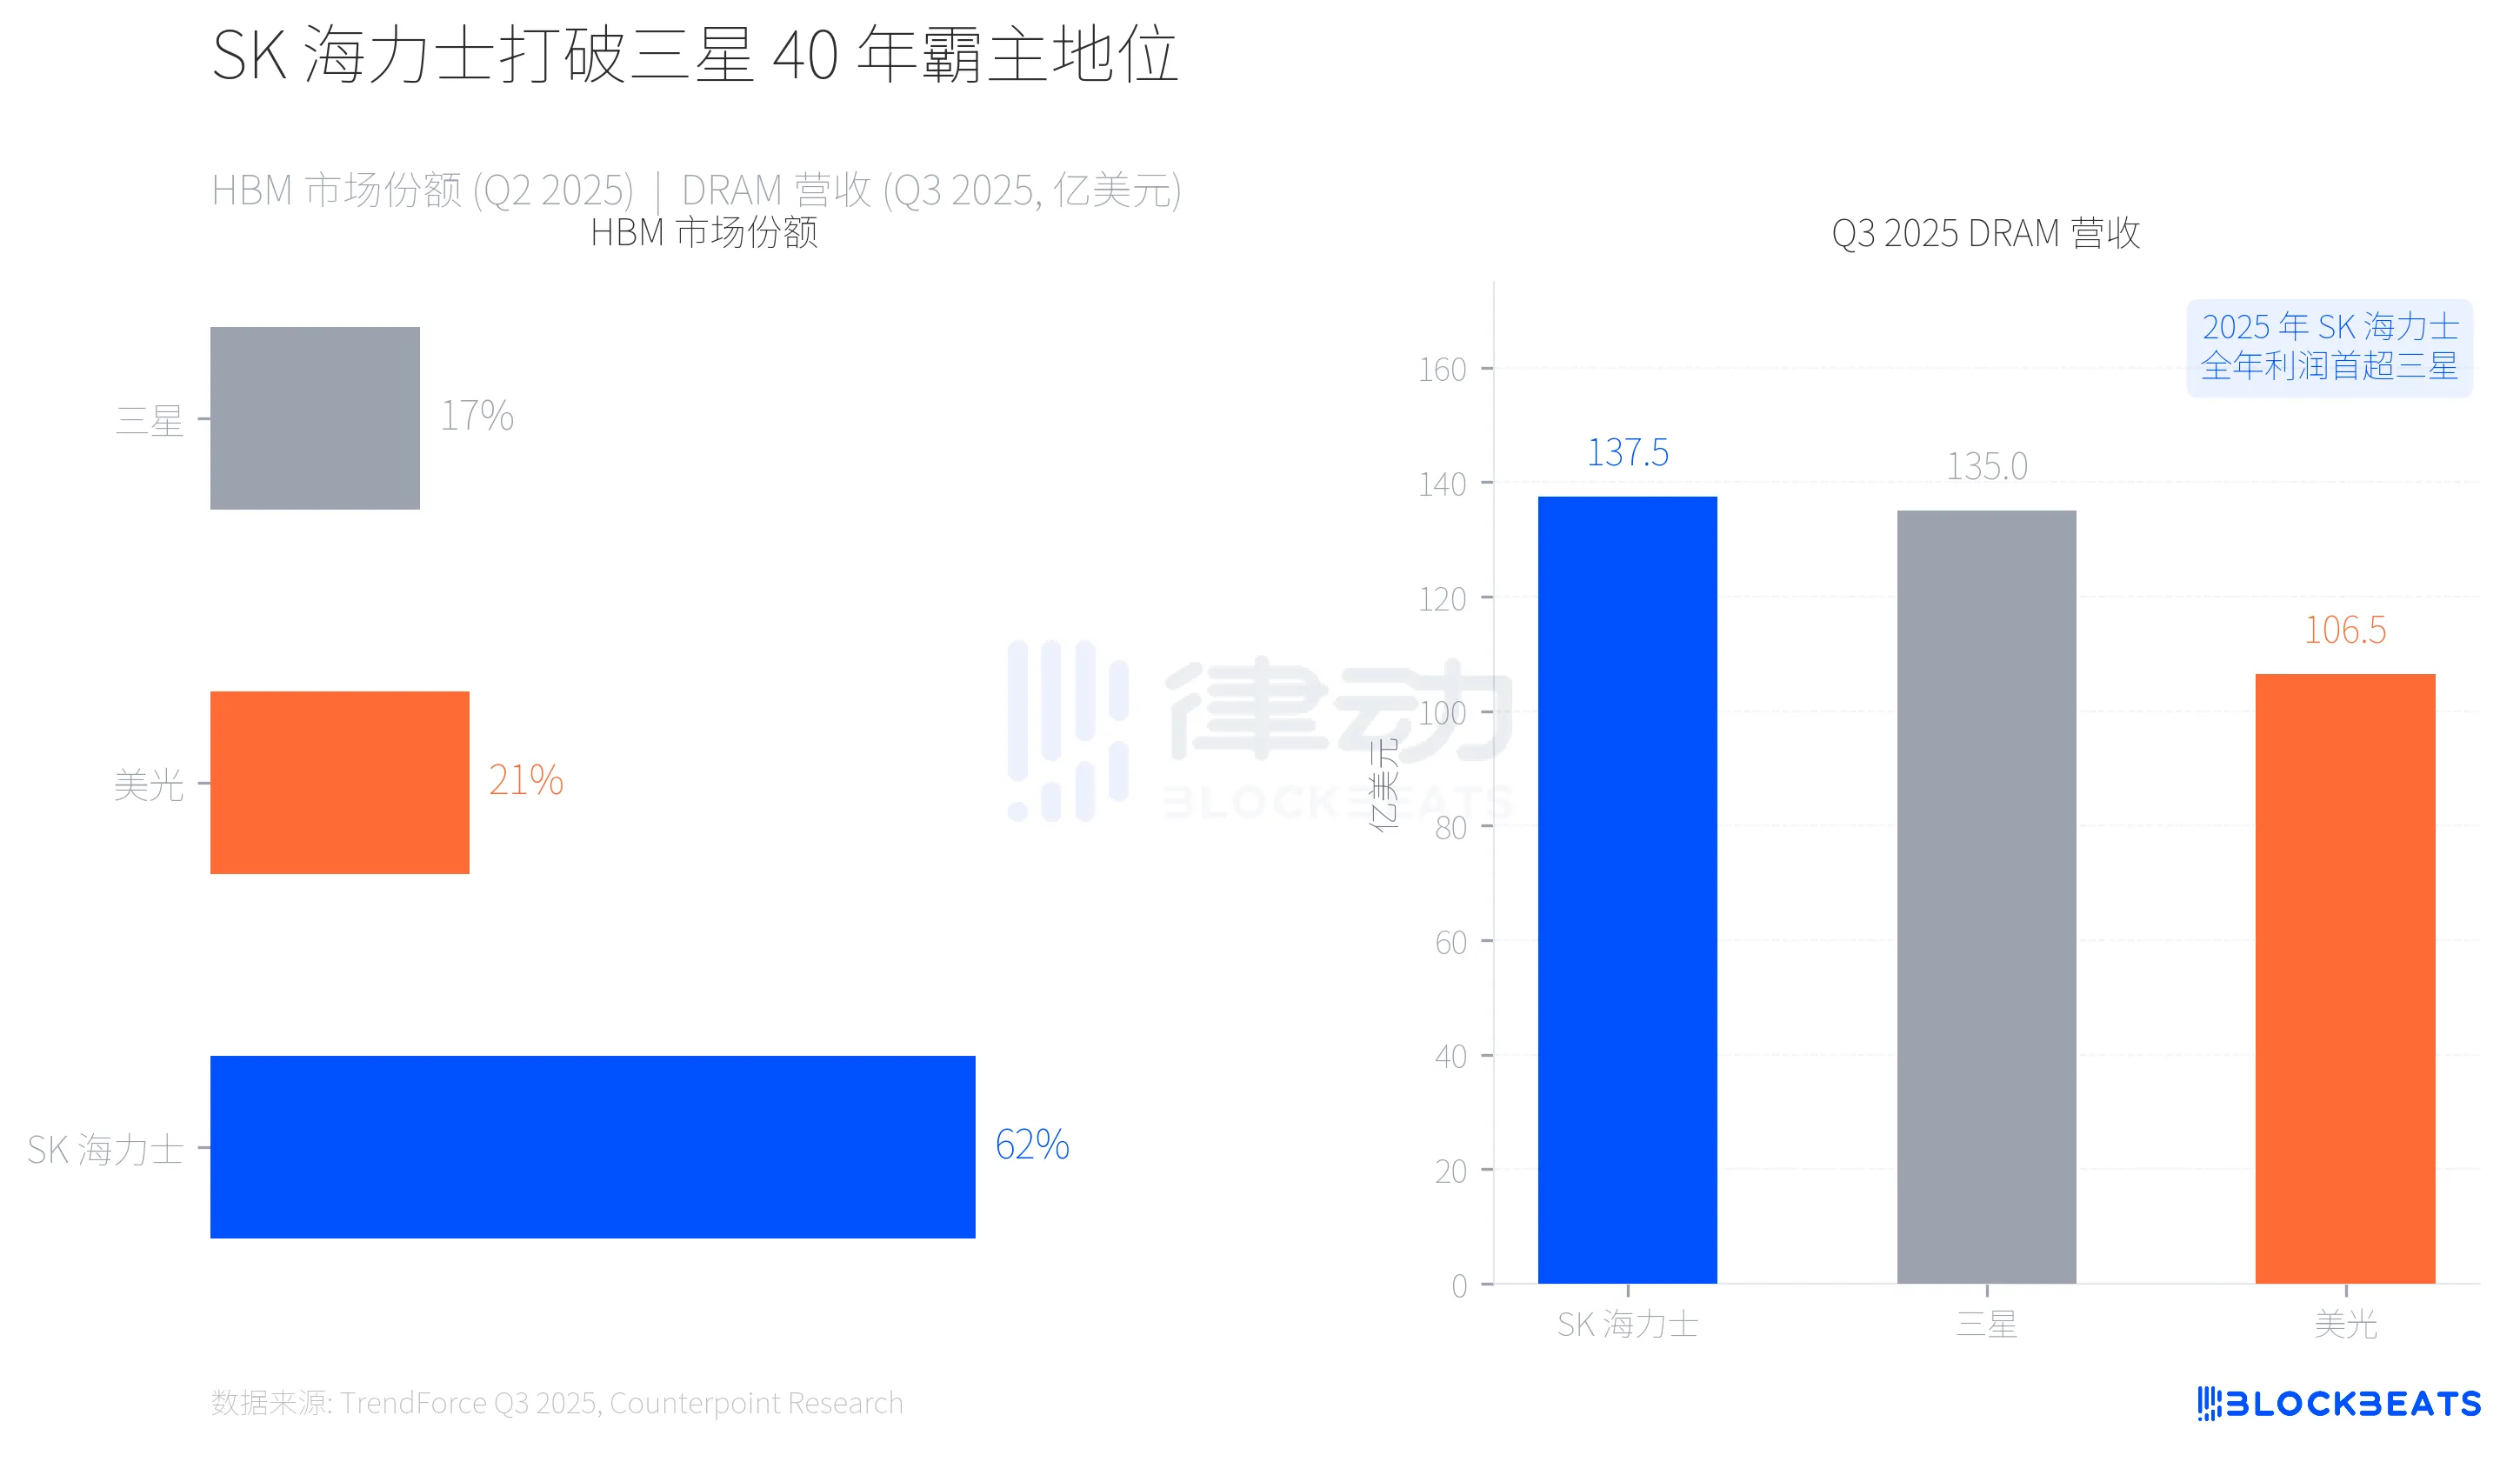
さらに画期的なのは、収益面での逆転だ。TrendForceの2025年第3四半期報告によると、SKハイニックスは1375億ドルの単季DRAM収益で初めて首位に立ち、サムスンは1350億ドルで続いた。両者の差はわずか25億ドルだが、これはサムスンにとって約40年ぶりにメモリ収益でのトップの座を失ったことを意味する。CNBCによると、SKハイニックスは2025年の年間営業利益も初めてサムスンを上回った。
HBMの先行優位性はSKハイニックスに十分なカードを与えたが、この競争はまだ終わっていない。サムスンはHBM4の量産スケジュールに全力を尽くしており、美光は消費市場を諦めたものの、エンタープライズおよびAI分野の収益成長率(第3四半期対前四半期比+53.2%)は3大メーカー中で最も速い。
1つのアルゴリズムが価格上昇論理を揺さぶった?
3月25日、GoogleはICLR 2026でTurboQuantアルゴリズムを発表した。このアルゴリズムは、大規模言語モデルの推論時にKVキャッシュ(推論プロセス中に最も多くのメモリを占める部分)をFP16精度から3ビットに圧縮し、メモリ使用量を少なくとも6倍削減し、同時にH100 GPU上で最高8倍のアテンション計算を加速化できるようになった。Google Researchブログによると、Needle-in-a-Haystackなどの5つの長いコンテキストベンチマークテストでは、精度の損失はゼロだった。
市場は迅速に計算を行いました。もしTurboQuantや類似のアルゴリズムが主要なAI企業に広く採用されると、AI推論がDRAMに対する増加需要を大幅に縮小させるでしょう。過去半年間、メモリ価格の上昇を支えてきた中心的な物語は、「AIインフラが多くのメモリ容量を消費している」というものでした。

4日後、チャネルの信頼が崩壊しました。
指摘すべきは、TurboQuantが対象としているのはAI推論エンドのKVキャッシュであり、トレーニングエンドのHBM需要ではありません。HBMの需給関係は急速に変化することはありません。しかし、市場は常にこの2つを区別しているわけではありません。新浪財経によると、急落前に国内チャネルが値上げにより大量のサイドチェーンのストッカーを引き付け、高価格が小売販売量を60%以上急減させ、資金繋局下のチェーンリアクションにより急落が拡大しました。
1つのAI産業チェーンがメモリの不足感と過剰感のパニックを同時に引き起こしています。HBMの物理的な生産能力の制約により、消費者レベルのメモリの供給が需要を満たせず、TurboQuantのアルゴリズム効率向上により、AIのメモリ需要は予想外に急落しています。値上げと崩壊をもたらすのは、同じ力です。
BlockBeats の公式コミュニティに参加しよう:
Telegram 公式チャンネル:https://t.me/theblockbeats
Telegram 交流グループ:https://t.me/BlockBeats_App
Twitter 公式アカウント:https://twitter.com/BlockBeatsAsia