Hermesを使って「AI臭さ」を修正する方法
原文タイトル:How To Fix AI Slop (Using Hermes)
原文著者:@EXM7777
翻訳:Peggy
編集者注:AI生成コンテンツの「ゴミ化」は、しばしばプロンプトが不十分、モデルが弱い、またはコンテキストが不完全であることに起因するとされています。しかし、この記事はよりエンジニアリングシステムに近い判断を提示しています。問題は入力側ではなく、出力側にあるのです。
著者は、多くの人がすでにプロンプトの書き換え、モデルのアップグレード、メモリの有効化、コンテキストファイルの積み重ねを繰り返し試みているが、それでもAIスロップが繰り返し発生すると述べています。その理由は、これらの方法がすべて「生成」自体を最適化しているものの、安定した品質管理メカニズムを確立していないからです。工場が製品の出荷判断を作業員の感覚だけに依存しないのと同様に、AIの出力もモデルからユーザーへ直接流れるべきではなく、テスト、スコアリング、遮断のプロセスが欠けています。
この記事の核心的な解決策は、Hermesというオープンソースのエージェントにeval loopを組み込むことです。まず「良い出力」とは何かを定義し、その基準を定量化可能なスコアリングシステムに変換し、公開前、実行時、本番環境で継続的に検出します。コンテンツ作成における空虚な表現であれ、製品における幻覚回答、フォーマットエラー、体験の劣化であれ、本質的には測定されていないAI出力が直接オーディエンスに届いていることに起因します。
したがって、本当に重要なのは、より長いプロンプトを書くことではなく、欠落している品質システムの層を補うことです。テストケース、スコアリング指標、しきい値、回帰テスト、承認ボタン、本番環境の監視が、このメカニズムを構成します。これにより、「AI出力の品質」は主観的な感覚から、観察、比較、修正可能な数字へと変わります。
以下は原文です:
ある人々が常に最高のソフトウェアを提供し、素晴らしいコンテンツを書き、あるいは驚くべき画像を生成できるのには、理由があります。
彼らはeval loopを採用しているのです。あなたはまだしていません。
より良いプロンプトを試し、より高価なモデルに切り替え、より長い指示を書き、メモリ機能を有効にし、小説のように巨大なコンテキストファイルを構築しても、AIのゴミコンテンツは何度も現れます。
それが繰り返し現れるのは、あなたが壊れていない層をずっと修繕しているからです。
AIスロップはプロンプトの問題ではなく、システムの問題です。工場が欠陥製品を出し続ける場合、問題は特定の作業員にあるのではなく、品質管理メカニズムにあります。つまり、製品が建物を出る前に誰もチェックしていないのです。
そこで、この記事で構築するのは、まさにこの仕組みです。読み終える頃には、Hermes というオープンソースのエージェント内で動作する eval loop(評価ループ)を手に入れられます。このループは、各出力が公開される前に、あなたの基準に従ってスコアリングし、公開後も実際の出力パフォーマンスを監視し続けます。そして、失敗するたびにそれを新しいテストに変換し、品質の最低ラインを自動的に引き上げていきます。
ステップバイステップで構築していきましょう。最終的なメリットは具体的です。真にクリーンで信頼できる出力を得られ、夜中に一字一句チェックし直す必要がなくなります。直感的にわかる品質スコアを手に入れられます。そして、あの AI ゴミコンテンツは、あなたのオーディエンスが気づく前に、外に出ていくのを阻止されます。
この記事から得られるものは以下の通りです。
なぜ、より良いプロンプト、より大きなモデル、メモリ機能では、AI ゴミコンテンツを完全に撲滅できないのか。そして、本当に効果を発揮するのはどのレイヤーなのか。
AI ゴミコンテンツは、あなたの仕事の中の2つの場所に潜んでいます。それは「コンテンツ出力」と「プロダクト出力」です。そして、なぜ両方の修正方法が全く同じなのか。
eval loop(評価ループ)を平易な言葉で説明します。日常的にほとんど実行されていないこの品質レイヤーと、なぜ誰もあなたにその構築を促さなかったのか。
今週中に構築できる品質ベースライン。コンテンツにもプロダクトにも適用可能です。具体的に何を測定すべきか、そして画面上のどの数字が「良い」と言えるのか。
完全な構築手順。Hermes が既に提供しているコンポーネント(skills、memory、cron、承認ボタン)を使って、ループ全体を連携させ、品質ゲートを自動化し、あなたの手動チェックに依存しないようにする方法。
もし「AI ゴミコンテンツを解決する5つのプロンプト」を期待して来たのなら、この記事は違います。
そういったものは確かに存在しますが、本当に効果的ではありません。この記事で語るのは、効果的なバージョンです。
あなたは、本当に試すべきだったあの一つ以外、ほとんど全てを試してきた。
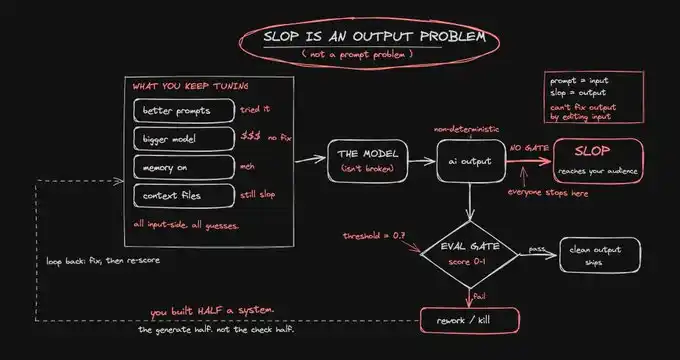
まず、あなたがこれまで何をしてきたかを簡単に振り返りましょう。プロンプトを書き換えました。3回、4回と。例を追加し、ペルソナを設定し、「こうするな」という長いリストを追加しました。最先端のモデルにアップグレードし、トークンあたり5倍のコストを払いましたが、出力はより自信に満ちたものになっただけで、空虚さは変わりませんでした。メモリ機能をオンにし、コンテキストファイルを構築し、ブランドのトーン、過去の作品、スタイルガイドをすべて与えました。
これらの操作の一つ一つが、数回の良い生成結果をもたらしてくれます。そして、AIゴミコンテンツがまたゆっくりと戻ってくるのです。
なぜなら、これらはすべて入力側の修正に過ぎないからです。あなたは「生成」するものばかり磨き続け、本来「遮断」すべきものを無視しています。どんなに優れた銃でも、暗闇に向かって撃ち続けるだけでは、何も当たりません。
AIゴミコンテンツは出力側の問題です。問題はモデルが良い作品を生み出せないことではなく、重要な人の前に届く前に、良い作品と悪い作品を事前に見分ける手段がないことです。
あなたにはevalループがなく、品質基準もなく、スコアボードもありません。だから盲目的に調整し続けているのです。プロンプトを変更して、良くなったように感じても、感覚は測定ではなく、その後の50回の生成に潜む1回の悪い出力を防ぐことはできません。
そこで、あなたは自分自身を責め、プロンプトを責め、Agent設定を責め、コンテキストエンジニアリングを責めます。しかし、本当に欠けているのは、あなたがこれまで教えられたことのない、AIの働き方の全く別の層です。この記事を読み終えた後、その層はあなた自身のマシン上で、Hermesの中で動き出すでしょう。
なぜより良いプロンプトがこの問題を解決できないのか、そしてなぜ人々がまだそれを試し続けるのか
プロンプトは仮説であり、出力は結果であり、evalだけがこの二つを閉じたループで結びつける唯一のものです。
このループがなければ、あなたは永遠に推測の中に留まります。仮説を調整し、目で結果を一つ確認し、勝利を宣言する。同じプロンプトが実は30%の確率でゴミを生み出していることに気づくことは決してありません。なぜなら、あなたは毎回目の前の出力だけを見ているからです。
モデルは非決定的です。同じプロンプトを2回実行すると、異なる答えが返ってきます。つまり、「完璧な」プロンプトでさえ、一定の割合でAIゴミコンテンツを生み出します。そして、顧客やユーザーが実際に目にする前に、それがどの実行回なのかを知ることはできません。
したがって、完璧なプロンプトは品質保証ではなく、勝率が少し高いコイン投げに過ぎません。そして今、あなたはそのコイン投げの結果を毎回そのまま送り出しているのです。
人々がプロンプトに期待を寄せ続ける理由は単純です。プロンプトはあなたが唯一目に見えるレバーだからです。編集でき、編集することでコントロール感を得られます。
測定は目に見えません。測定に関するコースを売る人はおらず、「このevalスイートで出力品質が10倍向上した」というバイラルポストもありません。そのため、議論全体が、単独では問題を解決できないレバーに閉じ込められてしまっているのです。
AIの出力が常にクリーンな人々は、あなたよりもプロンプトの書き方が上手いわけではない。彼らはあなたが持っていないレバレッジを一つ持っているだけだ。それは、すべての出力を公開する前に、一定の基準で評価する仕組みを持っていることだ。この評価メカニズムこそが、彼らのプロンプトを魔法のように見せているのだ。
AIゴミコンテンツは2つの場所に潜んでいる
AIゴミコンテンツはたった2つの場所に潜んでおり、ほとんどすべての人がそのうちの1つだけに注目している。
最初の場所は、あなたのコンテンツ出力だ。
ツイート、記事、メール、ランディングページ、投稿など、AIを使って生成し、自分の名前で公開するものはすべてこれに該当する。
ここでのAIゴミコンテンツは、しばしば「技術的には間違っていないが、完全に中身が空っぽ」な作品に見える。タイムライン上のすべてのAIアカウントが発信するもののように聞こえる。外見は正しいが、内面は空虚だ。
それは公開の場で失敗するが、なぜかはっきりとは言えない。送信ボタンを押したとき、個々の投稿はどれもそれなりに見えていたからだ。
2つ目の場所は、あなたのプロダクト出力だ。
あなたがリリースしたAI機能、Agent、チャットボット、カスタマーサポート返信システム、情報抽出パイプラインなど、ユーザーが実際に触れるものはすべてこれに該当する。
ここでのAIゴミコンテンツは、絶対的な自信を持った誤った回答、幻覚による数字、壊れたJSON出力、ブランドに合わないトーン、デモではうまくいったのに3回のデプロイ後に静かに劣化した出力として現れる。
それは公開の場で即座に死ぬことはない。沈黙の中で広がっていく。すべてのユーザーが少しずつ悪い体験を受け取り、ほとんどの人は決してそれを伝えない。彼らはただ去っていくだけだ。
これらは同じ病であり、解決策も同じだ。
コンテンツゴミとプロダクトゴミは、本質的には測定されていないAI出力であり、品質のゲートを一切通さずに、そのままオーディエンスの前に送り出されている。
唯一の違いは、リスクと可視性だ。コンテンツゴミは公開の場で恥をかかせ、プロダクトゴミは静かにビジネスを蝕む。そして、私たちがHermesで構築するこのループは、同じスキルを使って両方を評価する。これにより、異なるシナリオごとに2つのシステムを維持するのではなく、1つの品質システムですべての生成コンテンツを管理できるようになる。
eval loopとは一体何か
eval loop(評価ループ)とは、繰り返し実行可能なテストのことです。AIの出力が公開される前と後に、自動的にあなたが定義した基準と照らし合わせ、スコアを算出します。
これだけです。それ以上でも以下でもありません。そして、これこそが、ほとんどのAI構築者に欠けているレイヤーなのです。
出力を生成 → 定義したベンチマークでスコアリング → 基準を下回る結果をブロック → 失敗した部分を修正 → 再スコアリングし、テストに合格した出力のみを次のステップへ
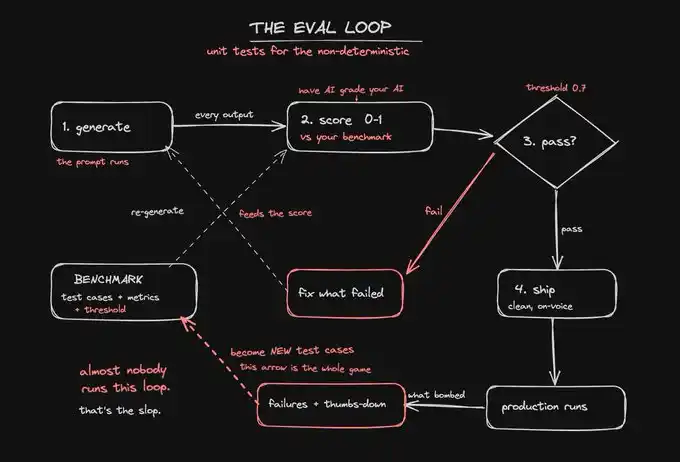
ソフトウェアエンジニアは、この仕組みをずっと前から持っていました。それは「テスト」と呼ばれています。テストもせずにコードを本番環境にデプロイして、うまく動くことを祈るようなことは決してしません。しかし、現在の業界では、まさにこの方法でAI出力がリリースされています。モデルから直接ユーザーへ、すべては「感覚と祈り」に頼っているのです。
eval loopを持っている人はほとんどいません。その理由は、人々のバックグラウンドに関係しています。今日、AIを使って何かを構築している人の多くは、エンジニアリングではなく、コンテンツ、営業、プロダクト、スタートアップの出身です。そのため、「自分の出力にテストを書く」という発想は、彼らのツールキットには元々ありません。evalは「本物のエンジニア」が使うインフラのように聞こえ、最も必要としている人ほど、自分には使う資格がないと無意識に感じてしまうのです。
これは、非決定論的なシステムのためのユニットテストだと考えてください。テストするのはコードが動くかどうかではなく、出力が十分に良いかどうかです。十分な数のケースでテストを行い、たまたま質の低い生成が行われても、それが簡単にすり抜けてしまわないようにする必要があります。
eval loopは、3つの場所で実行されます。これから構築するシステムでは、このループを以下の3つの段階に組み込みます。
公開前:保存されたテストケースを使って、新しいプロンプトや新しいモデルをテストし、品質が低下していないことを確認します。これはリグレッションテストであり、ある修正が一つの問題を直したものの、別の三つの問題を静かに壊してしまうのを防ぎます。
実行時:出力が生成される過程でスコアリングを行い、条件付きロジックを使って、不合格の結果がユーザーに届く前にブロックします。これがガードレールです。
本番環境:実際の実行結果を継続的にサンプリングしてスコアリングすることで、品質が低下し始めたその日に問題を発見でき、一週間後に顧客からクレームが来るのを待つ必要がなくなります。
最初のタイプ(公開前のテスト)は、スプレッドシートでも構築できます。しかし、これら3つのテストを継続的に実行し、それをあなたの第二の仕事にしないためには、エージェントに組み込む必要があるのです。
品質が数値化されれば、AIのゴミ出力は、あなたが繰り返し感じる「何か変だ」という感覚ではなくなり、修正可能なバグになります。感覚をデバッグすることはできませんが、0.82から0.61に下がったスコアをデバッグすることはできるのです。
ベンチマーク:次に構築すべき3つの要素
ベンチマークには3つの構成要素があります。コンテンツを評価する場合でも、プロダクトを評価する場合でも、同じ3つの要素です:
テストケース:実際の入力と、それに対応する高品質な出力サンプル、つまりグラウンドトゥルース
指標:出力をスコアに変換する方法。理想的には0から1の間のスコア
閾値:このラインを下回るものは一切公開を許可しない
この3つを構築すれば、品質ゲートが完成します。どれか1つでも欠ければ、それは単なる願望に過ぎません。次のセクションでは、各要素に何を入れるべきかを説明し、その後これらすべてをHermesに統合します。
コンテンツの場合、テストケースはあなたのゴールドスタンダードです。
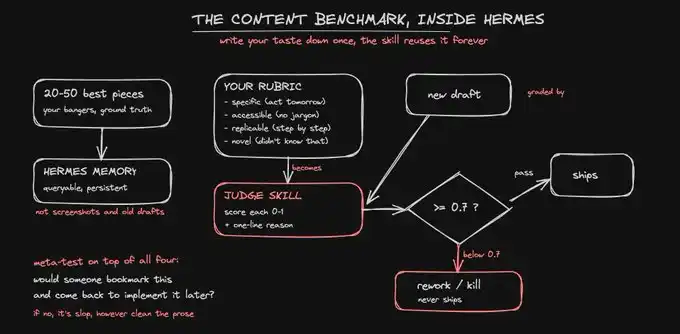
最も優れた20~50作品を選び出しましょう:実際にパフォーマンスが良かったもの、保存された投稿、あなたが自分の名前を堂々と載せられる記事。それが「良い」の姿です。あなたはゼロから基準を発明しているのではなく、すでに最高の状態で達成した基準を抽出しているのです。
コンテンツの場合、指標は評価スケールのセットです。
スコアの信頼性は、その背後にある評価スケールの信頼性に依存します。だからこそ、あなたが本当に信じる「良いコンテンツの基準」をコード化する必要があります。コンテンツの場合、私は4つの基準で各作品を評価します:
具体的なやり方を説明しているか(単なる感覚ではなく)、読者が明日すぐに行動に移せるか。
ターゲットオーディエンス全員が理解できるか;専門用語の壁や、業界関係者だけに通じる表現がないか。
構造が明確で、再利用可能で、ステップごとに展開されているか(単なる励ましではないか)。
十分に新しいか;読者はこれまでこの方法を知らなかったか。
これら4つの基準を覆うメタ基準は:読者がこのコンテンツを保存し、後で戻ってきて実行するかどうか?
答えが「いいえ」なら、どれだけ文章がきれいに読めても、それはAIゴミコンテンツです。
鍵は評価スケールそのものにあります。曖昧なスケール、例えば「このコンテンツは良いか?魅力的か?」は、曖昧なスコアしか生み出しません。具体的なスケール、例えば「このコンテンツには、直接コピーして使えるテンプレートや操作マニュアルが少なくとも1つ含まれているか?」は、信頼できるスコアを生み出します。自分のセンスを実際に書き留めて初めて、judgeはあなたのセンスを継承できるのです。
プロダクトにとって、テストケースはログから得られるものだ。
ログや実際のユーザーセッションから、機能が実際に直面する入力を抽出すべきであり、リリース当日にテストした3つのハッピーパスの例だけに頼ってはいけない。システムを本当に壊すのは、往々にして奇妙なケースであり、そうした奇妙なケースはすべてログの中に隠れている。
プロダクトにとって、指標はタスクそのものに一致させる必要がある。
各入力に対して、どのような出力が正しいかを定義し、指標をタスクの種類に合わせる。正解ラベルが1つだけなら正確一致を使い、構造が成立しなければならないならバリデーターを使い、出力がオープンエンドならセマンティック類似度とジャッジを使う。指標がすべきことはただ一つ:数値を返すこと。数値だけが閾値に組み込めるからだ。
コンテンツとプロダクトにとって、閾値は守るべきラインだ。
0.7は妥当な出発点だ。0.7未満のコンテンツは、例外なく公開前に作り直すか破棄しなければならない。閾値は、「これが気に入った」という理由で0.6の結果を見逃すことが決してない場合にのみ、真に効果を発揮する。その意義は、深夜の自己投影的な判断を意思決定から排除することにある。
これがベンチマークだ。そして今、それを自律的に動かす必要がある。
Hermesでこのループを構築する
Hermesには、evalボタンや「品質」というダッシュボードが標準で備わっているわけではなく、「AIゴミコンテンツ対策を有効化」する機能もない。
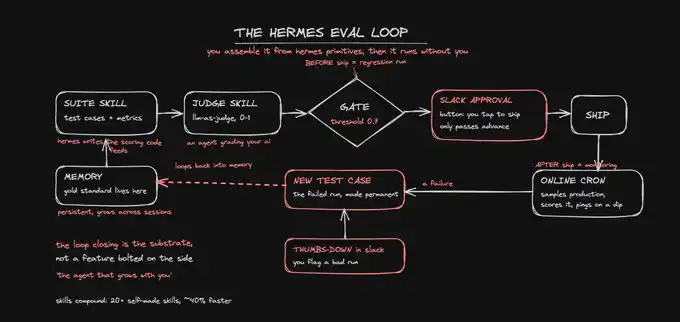
しかし、Hermesが提供するものは実はもっと優れている。evalループの基本コンポーネントを提供しているのだ。これらの基本機能を一度組み立てるだけで、真にそれを手に入れられる。
これらのコンポーネントには、自己記述・再利用可能なスキル、セッションを超えて成長する永続的な記憶、内蔵のcron、任意のプラットフォームに配信可能な機能、Slack上の承認ボタン、そしてコアメカニズムに組み込まれた自己改善の習慣が含まれる。
Hermesは自らを「あなたと共に成長するエージェント」と呼んでいる。そして、この成長こそが、私たちが構築しようとしているループなのだ。
では、配線を始めよう。全6ステップだ。
ステップ1:Hermesを、あなたがアクセスできる場所にデプロイする。
Hermesをインストールし、Telegramに接続する。これは聞こえ以上に重要だ。なぜなら、品質ゲートはあなたを中断できる場合にのみ真に効果を発揮するからだ。Hermesは20以上のチャネルで動作可能で、SlackやTelegramにネイティブで承認ボタンをプッシュできる。つまり、エージェントがバックグラウンドで作業を完了し、あなたの判断が必要な時に肩を軽く叩いて知らせてくれる。
第二ステップ:ゴールドスタンダードをメモリにロードする。
Hermesはセッションを超えて成長する永続的なメモリを持ち、完全なクロスセッションリコールをサポートする。そのため、あなたのベンチマークにある20~50の最高の作品を一度だけ入れれば、そこに永久に残る。
この部分は通常、スクリーンショット、古いドラフト、散在するファイルに分散している。しかしここでは、エージェントの長期記憶となり、クエリ可能で、スコアリング時に比較するためのグラウンドトゥルースとなる。
第三ステップ:評価スケールをジャッジスキルに変換する。
これがシステム全体の核心だ。必要なのは、自然言語でHermesに一度指示するだけだ:スキルを作成し、出力と評価スケールを受け取り、各基準に対して0から1のスコアと理由を返すようにする。
これがLLM-as-a-judgeだ:エージェントにあなたのLLM出力を評価させる。明確で鋭い評価スケールと組み合わせることで、モデルはあなたよりも安定した批評家になる。なぜなら、自尊心がなく、あなたが密かに誇りに思っている文を削除するのをためらわないからだ。
これを一回限りのプロンプトではなくスキルにする理由は、Hermesのスキルが本質的に手続き記憶だからだ。エージェントはそれらを作成し、保存し、繰り返し再利用する。あなたのセンスを一度コード化するだけで、その後は毎回の出力を継続的に評価できる。
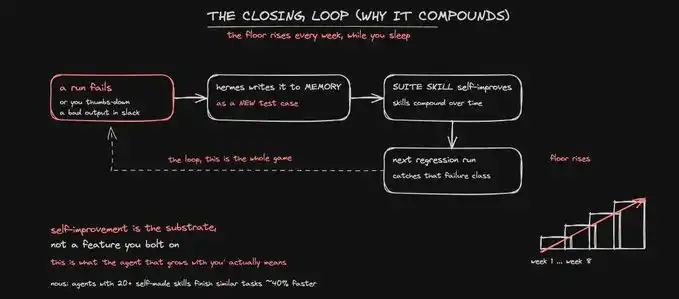
さらに、スキルは複利効果を生む。Nousは、20以上の自己作成スキルを持つエージェントが、類似タスクを完了する際に40%高速になることを発見した。なぜなら、プロセスを何度も再発見する必要がなくなるからだ。あなたのジャッジも、実行回数が増えるほど鋭くなる。
第四ステップ:テストスイートをテーブルではなくスキルにする。
あなたのテストケースと指標関数は、Hermesによって保存されバージョン管理されるスキルに統合されます。指標ライブラリはタスクに応じて決定されます。分類タスクでは完全一致、抽出タスクでは正規表現、構造化出力ではJSONバリデーターとキー・バリューバリデーター、生成出力では意味的類似度が使用されます。
オープンエンドなタスクには、あなたのjudgeスキルを使用します。Hermesが自らスコアリングコードを作成します。タスクを説明するだけで、対応する指標が構築されます。これらすべてが一箇所にまとめられ、エージェント自身が管理するため、いずれ見つからなくなるスプレッドシートに散らばることはありません。
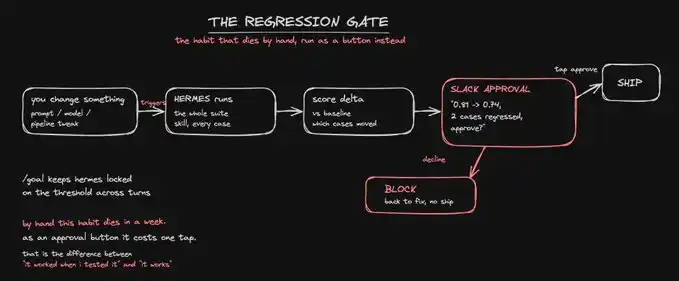
ステップ5:回帰テストと承認ボタンでリリースの関門を守る。
これはシステム全体で最もレバレッジの効く習慣であり、同時に長期間手動で継続できる人が最も少ない習慣でもあります。だからこそ、エージェントに任せます。
フローを接続した後は、新しいプロンプト、モデルの変更、調整されたパイプラインなど、あらゆる変更が自動的にテストスイートをトリガーします。Hermesはすべてのケースを再実行し、ベースラインからのスコア変化を計算し、静かにリリースするのではなく、Slackで通知します:「スコアが0.81から0.74に低下、2つのケースで後退が発生。承認しますか?」
承認ボタンをクリックした後にのみ、処理が進められます。
/goalを使用して、このタスクに継続的にロックインし、エージェントが複数回の対話にわたって同じ目標を実行できるようにします。より大きなタスクでは、マルチエージェントボードが実行フローを分解し、並行してスコアリングし、実行スケジュールを設定します。
これにより、品質ゲートは常駐プロセスとなり、手動で覚えて実行しなければならない作業ではなくなります。
ステップ6:cronで本番環境を監視し、フィードバックループを完成させる。
Hermesにはcronが組み込まれており、結果を任意のプラットフォームに送信できます。そのため、実際の実行結果をサンプリングし、同じjudgeスキルでスコアリングし、スコアが基準値を下回った瞬間にプライベートメッセージで通知する定期タスクを設定できます。
これにより、品質が低下し始めた当日に問題を発見でき、1週間後に顧客からクレームが来るのを待つ必要がありません。
「evalスコアが低下した」というのはすぐに対処できる問題ですが、「ある顧客が少し不満そうだ」というのはそうではありません。
次に、システム全体が複利効果を生み始める重要な部分です。
Slackで低品質な出力に「サムズダウン」を押すと、Hermesはそれをテストスイートスキルに新しいテストケースとして書き戻します。その失敗した実行は、恒久的なチェック項目になります。
さらに、自己改善はHermesの中核メカニズムであり、後付けの機能ではないため、このテストスイートは毎週自動的に強化されていきます。
あなたが寝ている間も、品質の最低ラインは上がり続けます。
このシステムが実際に稼働すると、良い状態は非常に具体的になります。評価スケールで0.7未満のコンテンツは決して公開されません。製品の変更が何らかの指標をベースライン以下に落とした場合、あなたが直接承認するまでデプロイが阻止されます。
そして、本番環境のスコアラインは安定するか、継続的に上昇します。それが下落し始めた日には、Hermesがあなたに通知します。1週間後にユーザー離脱データが現れるのを待つ必要はありません。
誰も聞きたがらない部分
あなたのAI出力が不安定なのは、プロンプトの書き方が下手だからでも、モデルが十分に賢くないからでもありません。
生成ステップだけを実行し、品質ステップを実行していないからです。あなたは半分のシステムしか構築しておらず、実際に機能している半分の部分を責め続けているのです。
修正方法は、より良いプロンプトに変えることではなく、欠けている層を補うことです。
「良い」とは何かを定義し、それを数字に変え、その数字で毎回の出力を評価し、基準を下回る結果をすべて阻止し、フィードバックループを完成させて、品質の最低ラインを毎週自動的に引き上げます。
今や、この層は「後でやる」プロジェクトではなく、あなた自身のマシン上で、エージェントを通じて、6つのステップで実行できるシステムです。
これを実現すれば、AIゴミコンテンツはもはやランダムに発生するものではなく、毎回あなたの目の前で阻止できるものになります。まるで本物の工場が、不良品が顧客に届く前に差し止めるように。
プロンプトは決してシステムではありません。
eval loopこそがシステムです。Hermesはそれが動作する場所です。
これで、あなたはそれを手に入れました。
[原文リンク]
BlockBeats の公式コミュニティに参加しよう:
Telegram 公式チャンネル:https://t.me/theblockbeats
Telegram 交流グループ:https://t.me/BlockBeats_App
Twitter 公式アカウント:https://twitter.com/BlockBeatsAsia
 関連記事