ストレージから決済へ:BitrootがAIデータ価値層を再構築する方法!
文章来源:Bitroot
ストレージはコストセンターではなく、Bitroot AI Stackの価値配分システムである
多くのチームは、立ち上げから半年以上経って初めて、ストレージ層の選択をもっと慎重に行うべきだったと気づく。データは失われず、サービスも停止していないが、問題は別の形で現れる。アーカイブされたトレーニングデータの取得が徐々に遅くなり、ホットベクトルクエリのテールレイテンシがミリ秒から秒単位に跳ね上がる。そして、あるオンライン障害を振り返ろうとしたとき、誰もそのモデルが当時どのバージョンのトレーニングデータを使っていたのか説明できない。この段階に至っては、解決すべきはスケーリングではなく、さらに難しい三つの問題である。誰がデータが常に利用可能であることを証明できるのか、誰がバージョン管理に責任を持つのか、そして誰が長期的なコストを負担するのか。
ストレージを、ファイルを中央集権型クラウドからオフチェーンネットワークに移すことと理解するのは、NFTメタデータの時代にはまだ通用した。しかし、ビジネスがAIトレーニングコーパス、モデルウェイト、ベクトルインデックスに拡大すると、この考え方はすぐに機能しなくなる。
多くのチームは今でもストレージを、節約すればするほど良い後方支援コストと見なしている。これこそが最も過小評価され、かつ最も誤った選択をしやすい点である。AIパブリックチェーンにおいて、それは実際には、誰がデータを掌握し、誰が収益を分配するかを決定する価値配分層なのだ。この記事はただ一つの問いに答える。AIとパブリックチェーンが融合するシナリオにおいて、どのように検証可能で、ガバナンス可能で、持続可能な分散型ストレージソリューションを構築するか。以下では、まず三つの主流パラダイムの能力限界を分解し、次にAIデータの特殊な難しさを明確にし、最後に五層の実装アーキテクチャと段階的な導入基準に落とし込む。判断基準は主に公式プロトコル文書に基づき、可能な限り検証可能な資料に依拠する。
Bitrootを例にとると、ストレージ層のより正確な位置づけは、AI Stackの価値配分基盤である。Bitrootは一方で、並列化EVMとPipeline BFTにより高性能なオンチェーン実行環境を提供し、他方で分散型トレーニング、推論ネットワーク、信頼できる実行、AI資産管理を通じて、データ、モデル、計算リソース、Agentアプリケーションを決済可能なネットワークに接続する。このネットワークにおいて、ストレージは孤立したモジュールではなく、データの権利確定、モデルの再現可能性、計算リソースの決済、貢献者の持続的な収益獲得を決定するインフラである。
フルオンチェーンとフル中央集権化は、AIシナリオではどちらも行き詰まっている
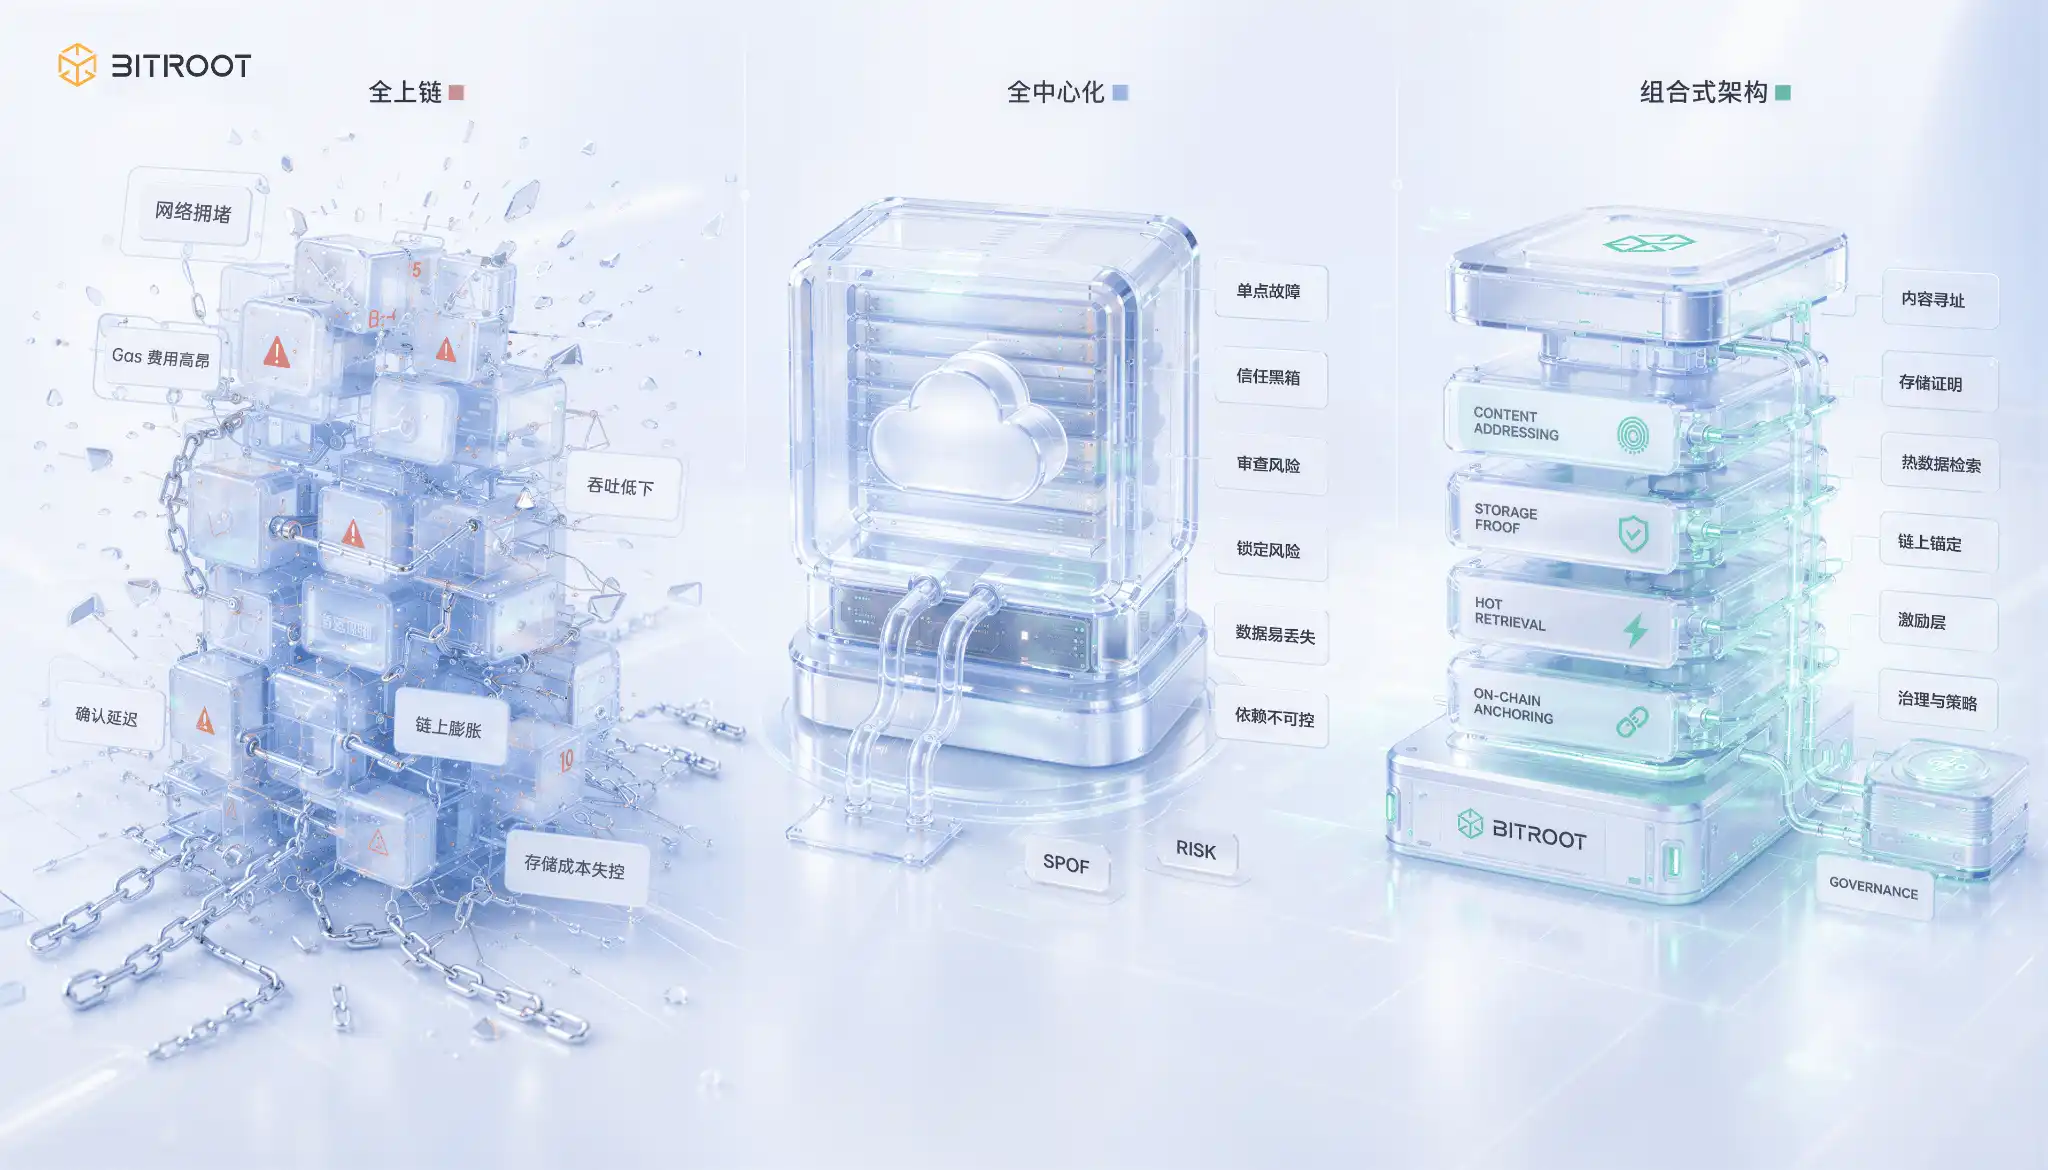
過去数年間、ストレージ問題はしばしば二択に単純化されてきた。フルオンチェーンか、フル中央集権化か。この二つの道は、AIシナリオではどちらも持続不可能である。
オンチェーン化のプレッシャーは極めて具体的だ。トレーニングデータ、モデルウェイト、推論ログ、ベクトルインデックスは、一般的に高ボリュームかつ高頻度の更新が発生する。たとえスライスしてからオンチェーン化しても、スループットの上限とコスト曲線の両方に同時にぶつかることになる。完全な中央集権化は高速だが、検証可能性、トレーサビリティ、データ主権、そしてクロスエンティティの協調に依存する信頼基盤は脆弱であり、マルチパーティ間の利益配分や権利確定が絡むとたちまち成立しなくなる。
さらに重要な変化は、AIがストレージをコスト項目から生産要素へと変えたことだ。データのバージョンを誰が管理するかで、モデル反復の主導権が誰の手に渡るかが決まる。データの可用性を証明できるかどうかは、計算リソースのスケジューリングと決済の優先順位に直接影響する。そして、データを資産化する能力は、チームがエコシステム内で長期的なインセンティブを構築できるかどうかに関わる。ストレージ層は、この段階に至ってもはや後方支援システムではなく、価値分配システムとなっている。
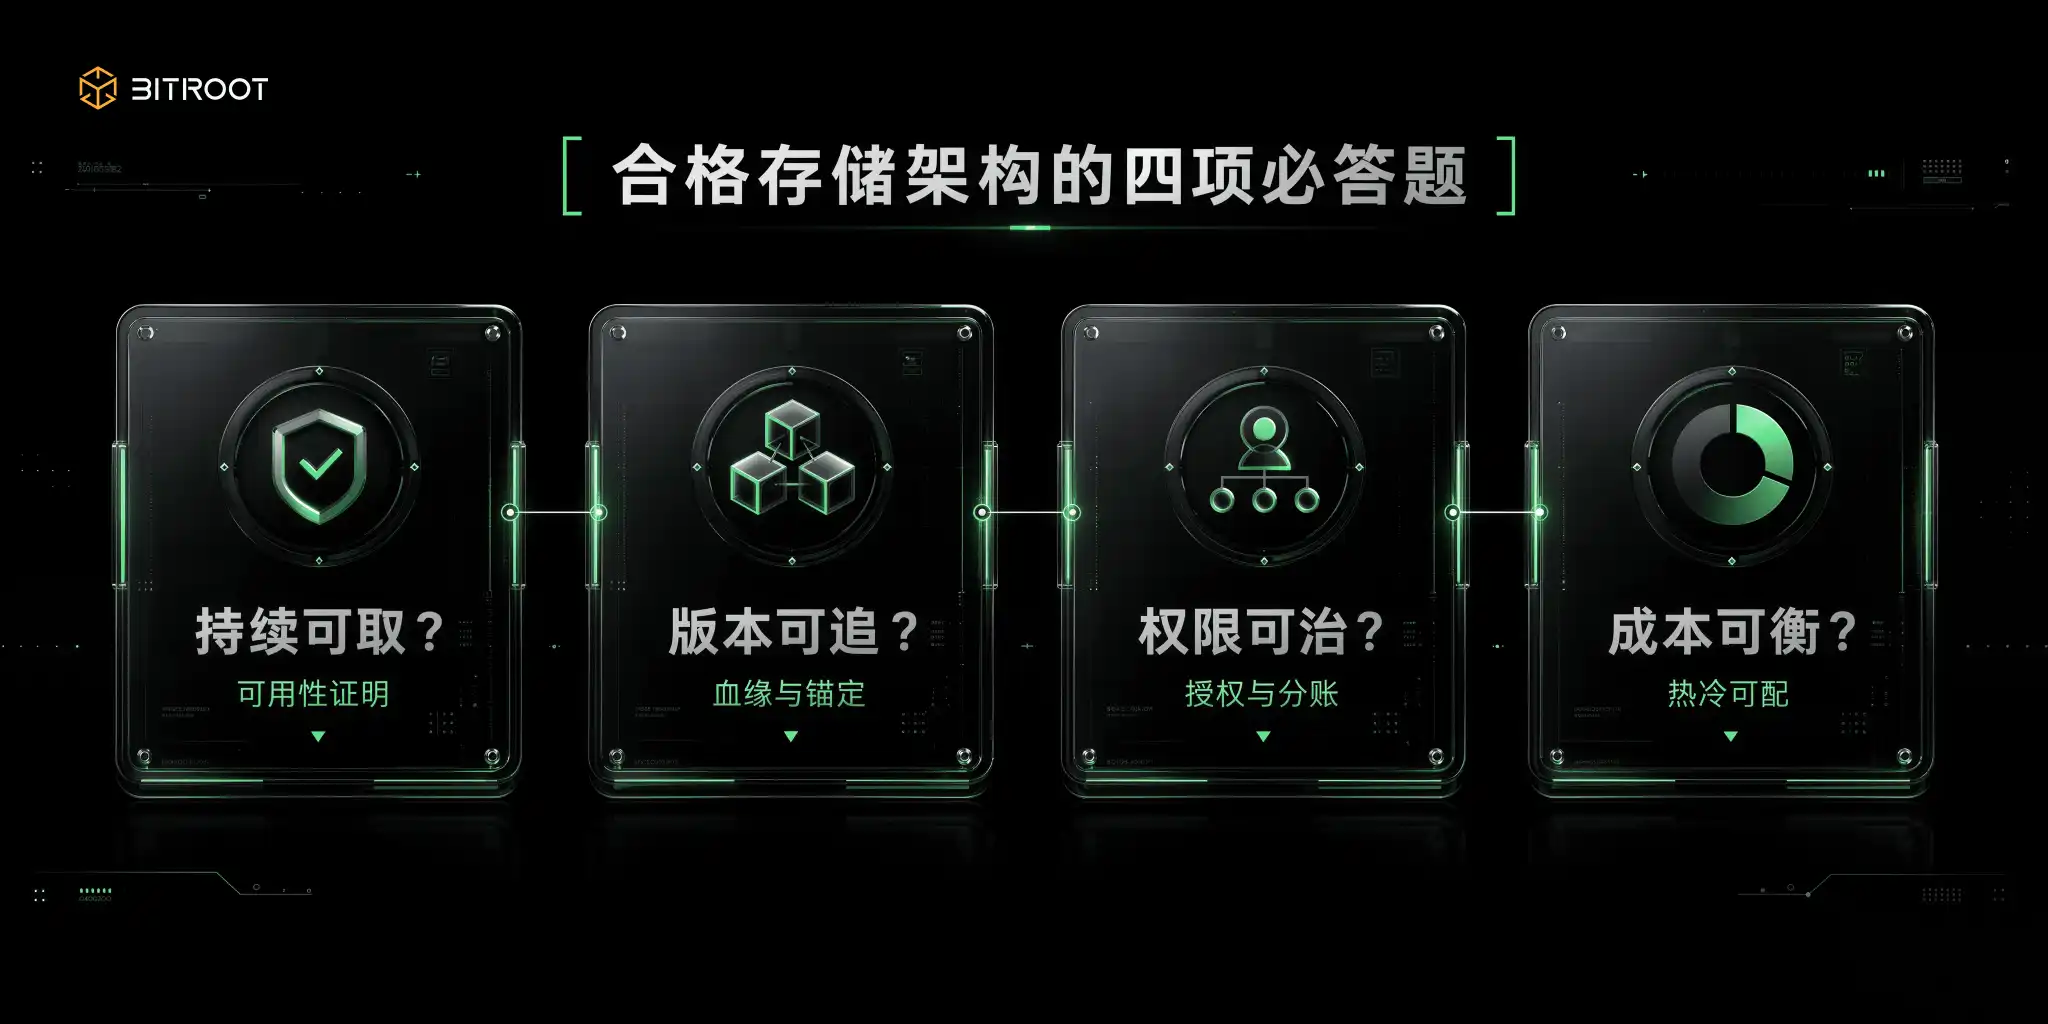
したがって、適切なストレージアーキテクチャは、次の4つの問いに同時に答えなければならない。データが実際に存在し、継続的に取得可能かどうか、データとモデルのバージョン関係が追跡可能かどうか、権限と収益がガバナンス可能かどうか、システムがコストとパフォーマンスの間で長期的にバランスを取れるかどうか、である。
Bitrootの切り口:AIデータを「保存可能」から「決済可能」へ
まさにここがBitrootが埋めるべきポジションである。AIシナリオ向けの高性能Parallel EVMパブリックチェーンとして、Bitrootのストレージに関するナラティブは「データをどこに置くか」に留まるべきではなく、「データをどのように証明し、どのように呼び出し、どのように利益配分に参加させるか」に答える必要がある。トレーニングコーパス、モデルウェイト、ベクトルインデックス、推論ログは、大規模オブジェクトに適した分散ストレージ層に残すことができるが、それらのハッシュコミットメント、バージョン関係、権限ポリシー、呼び出し記録、収益イベントは、Bitroot上で統一されたオンチェーンエビデンスを形成する必要がある。
この観点から見ると、Bitrootの高スループットと低レイテンシは、単にDeFi取引にサービスを提供するためではなく、AI Stackにおけるより細かい粒度で高頻度なガバナンスイベントにサービスを提供するためのものである。データセットの更新はアンカーリングされ、モデルバージョンは登録され、AIエージェントの呼び出しは決済され、検索結果の紛争は仲裁され、ストレージノードの可用性は継続的にチャレンジされ報酬が与えられる必要がある。基盤チェーンがこれらのイベントを処理できて初めて、AIデータ資産は中央集権型データベースに閉じ込められず、責任追及が不可能なオフチェーンのブラックボックスに成り下がることもない。
3つの主流パラダイム、どれ一つとして全シナリオを単独で突破できない
分散ストレージの競争は、決して「どれが最も先進的か」ではなく、「どれがあなたのデータ構造に最も適しているか」である。
コンテンツアドレッシングネットワークが解決するのは「これはそのデータかどうか」であり、「誰がそれをオンラインで保証するか」ではありません。IPFSの公式ドキュメントによると、CIDはコンテンツハッシュに基づく識別子であり、位置アドレッシングに依存しません。同じコンテンツは同じコーデック設定で同一のCIDを生成し、コンテンツが1バイトでも変更されるとCIDも変わります。この特性により、完全性検証、重複排除、クロスシステム参照に自然に適しており、データの権利確定の基盤能力となります。しかし、コンテンツアドレッシングは経済的な持続的可用性を意味するわけではありません。CIDは「身元」の問題に答えるものであり、「誰がそれを常にオンラインで保証するか」には答えません。多くのチームが立ち上げ後に最初に陥る落とし穴はここにあります。技術的にはCIDを取得できても、ビジネス的には可用性の保証を得られていないのです。
ストレージマーケットネットワークは、経済メカニズムを用いて時間軸上の可用性を購入します。Filecoinのドキュメントによると、ネットワークはProof-of-ReplicationとProof-of-Spacetimeを通じて、ストレージコミットメントと継続的な証明のメカニズムを確立します。PoRepは初期のシーリング時に、このユニークなコピーが確かに保存されていることを証明し、PoStはその後のサイクルでそれがまだ存在することを繰り返し証明します。WindowPoStの証明サイクルは通常24時間単位で構成され、さらに複数の30分の証明ウィンドウに分割されます。ストレージプロバイダーがウィンドウ内に有効な証明を提出しない場合、担保の没収とストレージ能力の低下が発生します。このシステムでは、可用性は継続的な評価項目であり、契約後の一度きりの約束ではありません。この契約化・監査可能なモデルは、中長期的なアーカイブ、バックアップ、データマーケットに適していますが、証明付きの長期倉庫のようなものであり、本質的に低遅延のオンラインサービスではありません。高頻度のオンラインクエリを直接適用すると、テールレイテンシーによって体験が損なわれます。
パーマネントストレージネットワークは別の道を進み、一度の支払いで不変の履歴を取得します。Arweaveのプロトコルとイエローペーパーによると、アップロード料金の一部はストレージ寄付プール(endowment)に入り、長期のストレージインセンティブをカバーします。これにより、長期的な持続可能性を課金モデルに組み込み、後続の更新習慣に依存しません。歴史的アーカイブ、重要な証明書、著作権素材など、改ざん不可能な記録に適しています。欠点も明確です。永続性は自動的に高並列・低遅延を意味するわけではなく、実際の運用ではキャッシュ、ゲートウェイ、またはニアラインインデックス層を追加して、ユーザー側のリアルタイム体験を満たす必要があります。
これら3つの基本パラダイムに加えて、エンジニアリング上では2つの一般的な組み合わせを検討する価値があります。1つはデータ可用性層とオブジェクトストレージのハイブリッドで、データ公開と可用性証明がより標準化されますが、コストはクロスレイヤーの複雑な連携とインターフェース管理の高コストです。もう1つはマルチクラウドとエッジの連携で、低遅延と災害復旧に優れますが、コスト管理と一貫性管理が難しくなります。
どの選択肢を取るにせよ、1つのプロトコルですべてのシナリオをカバーすることはエンジニアリング上不可能です。効果的な方法は、データタイプごとに組み合わせることです。永続性、検索レイテンシー、コンプライアンスを分解し、それぞれを能力層にマッチングさせ、さらにオンチェーンアンカリングとガバナンス層で統一してオーケストレーションします。
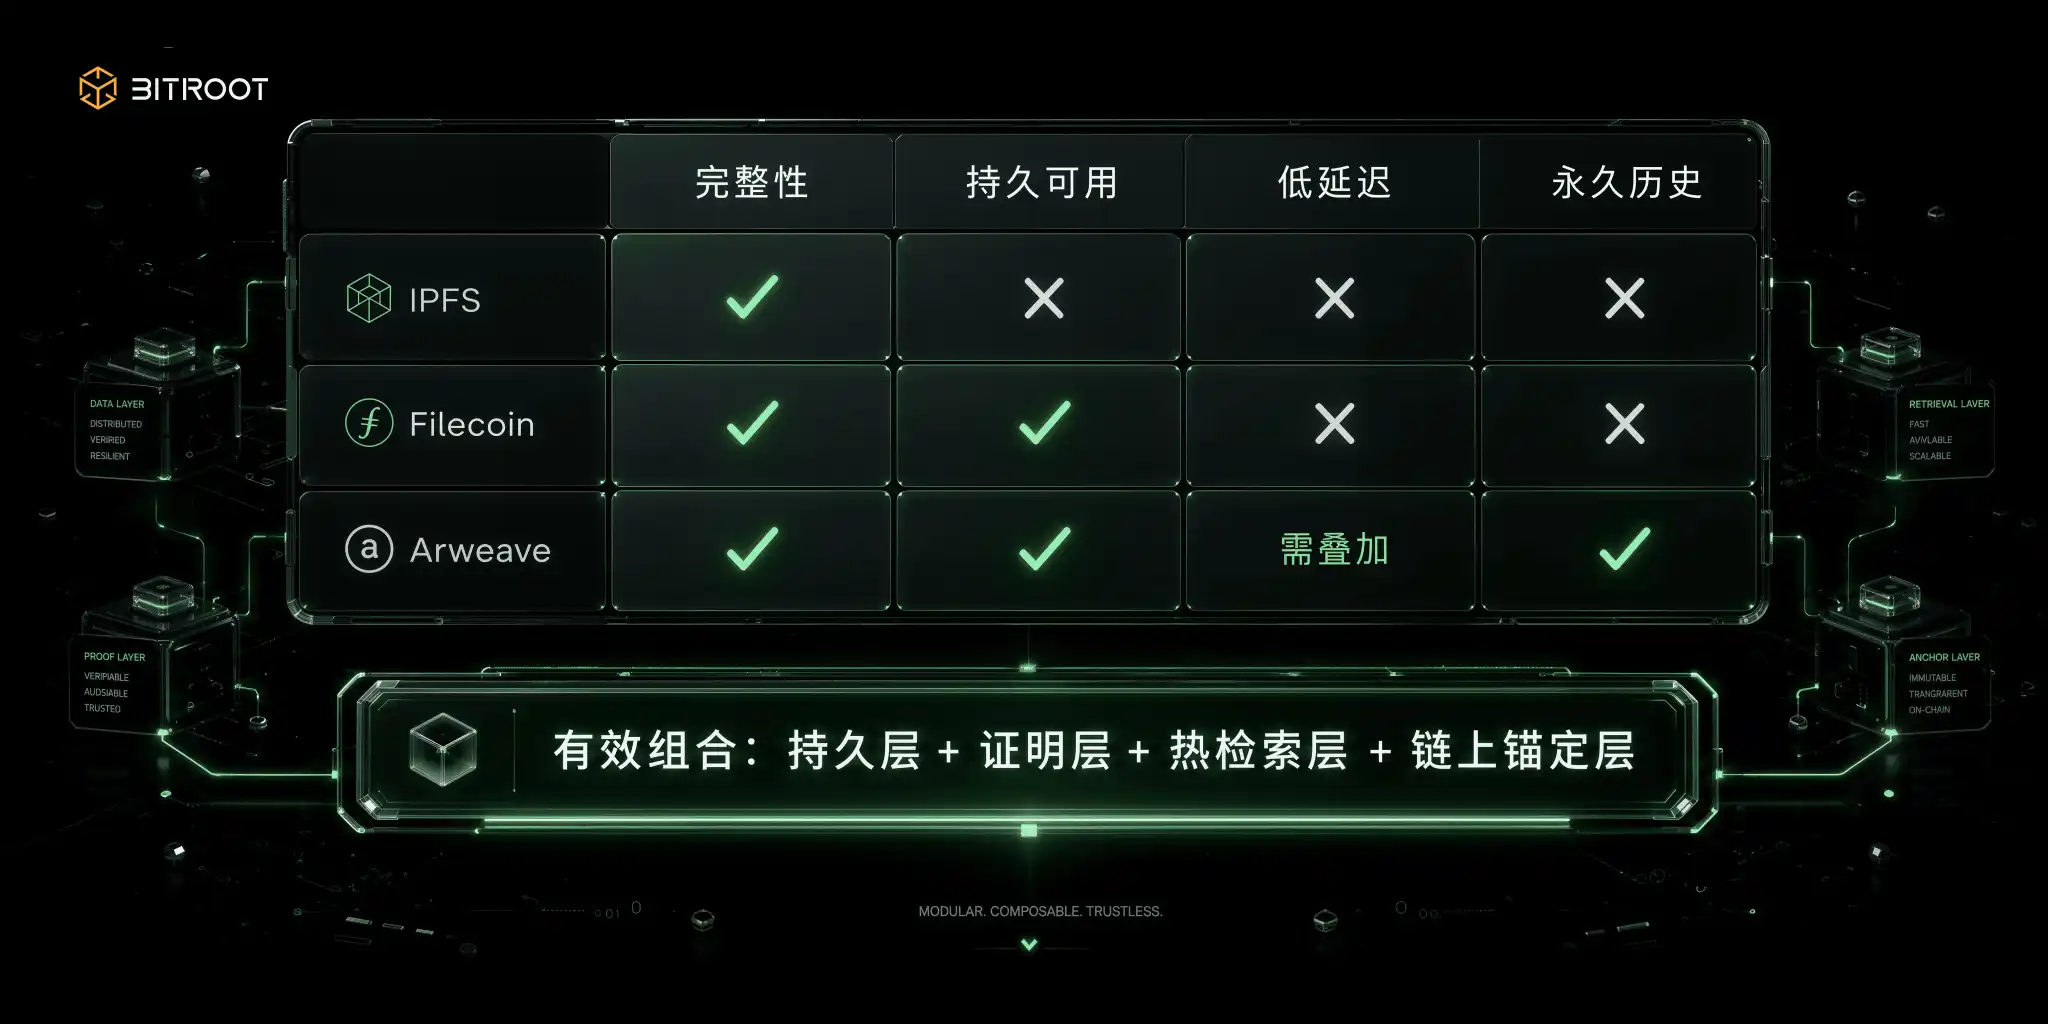
Bitrootの選択空間も、この組み合わせ論理に基づいて構築されるべきである。つまり、IPFS、Filecoin、Arweave、オブジェクトストレージを互いに代替するものとして捉えるのではなく、それぞれを異なる責務レイヤーに配置するのである。コンテンツアドレッシングはデータの同一性と完全性に、ストレージ証明は長期的な可用性に、パーマネントレイヤーは重要な履歴と証明書に、ホットリトリーバルレイヤーはAIアプリケーションの体験に、そしてBitrootチェーン上のレイヤーはバージョンアンカリング、権限ポリシー、呼び出し決済、紛争処理を統一的に担う。言い換えれば、Bitrootはすべてのデータの物理的な倉庫となる必要はなく、AIデータの価値フローにおける信頼できる台帳となるべきなのである。
AIストレージの難所は、ファイル保存ではなく、プロダクションパイプラインの管理にある
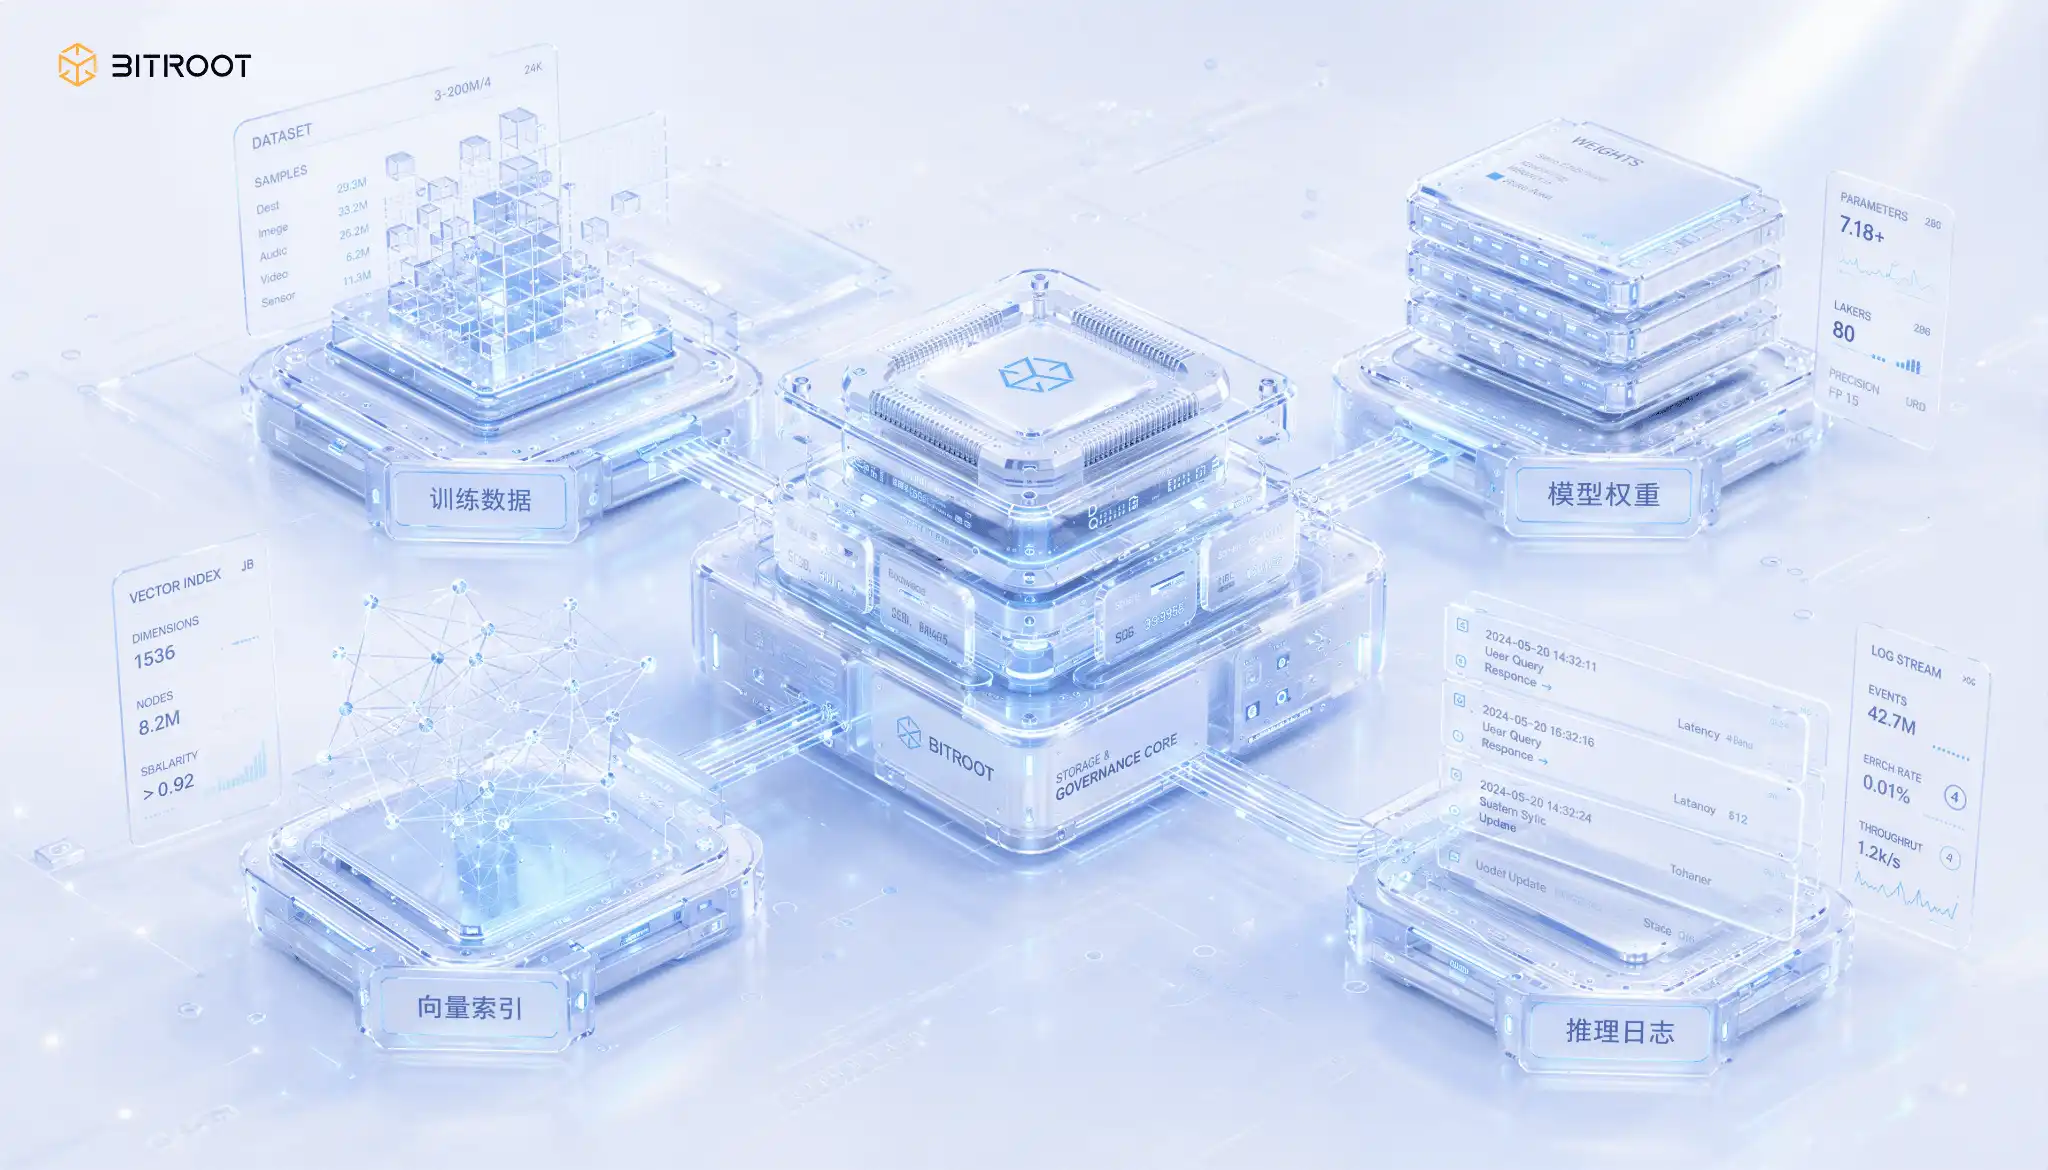
AIのシナリオでは、ストレージオブジェクトは少なくとも4つのカテゴリに分類される。すなわち、トレーニングデータ、モデルウェイト、ベクトルインデックス、推論ログである。これら4つのカテゴリは、ライフサイクル、アクセスパターン、価値密度が完全に異なるため、単一の戦略で管理すると、短期的には手間が省けても、長期的にはガバナンスが制御不能に陥る。
トレーニングデータの問題は容量ではなく、バージョンのドリフトにある。多くのチームはトレーニングデータの問題をTB単位のストレージコストと同一視しているが、実際にはより厄介なのはドリフトである。クリーニングルール、サンプル選択の閾値、ラベリング基準が変われば、モデルの動作もそれに伴って変化する。データバージョンとモデルバージョンがバインドされていなければ、オフライン評価の再現検証は困難になる。MLflowのモデルとデータ追跡の実践によれば、トレーニング実行とデータバージョンのバインドは実験再現の前提条件である。この原則はオンチェーンでも同様に有効である。生データすべてをオンチェーンに載せる必要はないが、バージョンコミットメント、重要なサマリー、ソースフィンガープリントはオンチェーンでアンカリングしなければならない。エンジニアリングレベルでは、少なくともデータバージョン、トレーニング実行、モデルバージョンの3つの識別子をバインドする必要がある。一つでも欠けると、本番環境の問題の原因追及は、証拠を探すことから原因を推測することに堕してしまう。
モデルウェイトの問題は、多くの場合、ダウンロードの可否ではなく、呼び出しの境界を誰が管理するかにある。モデルが本番環境に入ると、通常、カナリアリリース、メイン運用、ロールバック、退役といった状態を経る。標準化された登録・認可システムがなければ、本番環境での呼び出しは監査不可能なブラックボックスとなる。成熟したモデルレジストリは、血統(lineage)、バージョンエイリアス、シグネチャ制約、監査タグを同時に記録する。オンチェーンシステムにとって、モデルバージョンは単なるファイルハッシュであるべきではなく、権限ポリシー、収益配分、責任範囲と結びつけられるべきである。
ベクトルインデックスの難所は、一箇所に集中している。それは、ホット・コールド階層化後の一貫性である。ベクトル検索には固有の矛盾がある。低レイテンシと低コストが相反するのである。ホットレイヤーはメモリや高性能インデックスサービスに依存してオンラインレスポンスを保証し、コールドレイヤーはオブジェクトストレージに依存して長期的なコストを抑える。統一されたメタデータと同期戦略がなければ、2つのレイヤーは急速に分岐し、最終的には同一クエリがノードによって異なるセマンティック結果を返すという問題が発生する。したがって、ベクトルシステムは2つのことをサポートしなければならない。すなわち、インデックス構築プロセスが追跡可能であること、そしてホットレイヤーのインデックスバージョンとコールドレイヤーのマスターデータが照合可能であることである。これこそが、後述する検証可能な検索が解決すべき課題なのである。
推論ログにおいて、プライバシー、監査、コンプライアンスの三者を同時に成立させることは難しい。これはセキュリティ監査資料であると同時に、プライバシーリスクの源泉でもある。全量の平文を保存すればコンプライアンスリスクが生じ、全く保存しなければ事故の事後検証能力を失う。実行可能な方法は三層構造である。内容を難読化して保存し、ハッシュコミットメントをチェーン上に置き、アクセスには監査による承認を必要とし、改ざん不可能性とアクセス取り消し可能性を階層的に実現する。
BitrootのAI Stackでは、これら4つの対象に対して4つのガバナンスアクションを対応付けることができる。トレーニングデータにはバージョンアンカリングとソース登録、モデルウェイトには資産登録と認可呼び出し、ベクトルインデックスにはホット/コールド階層化と一貫性証明、推論ログには難読化保存と監査コミットメントを行う。これらはすべて同じ方法でチェーン上に載せる必要はないが、Bitroot上で統一された資産ID、バージョン系統、呼び出しイベントを形成する必要がある。そうすることで、データ資産、モデル資産、エージェントアプリケーションの間に再利用可能なビジネスサイクルが形成される可能性が生まれる。
検証可能性は最低条件、可用性証明こそが分水嶺
可用性証明のないストレージコミットメントは、実運用環境ではコミットメントがないに等しい。分散ストレージを実運用に導入するには、少なくとも3つの条件をクリアする必要がある。完全性が証明可能であること、可用性が証明可能であること、動作が監査可能であること。AI検索シナリオに入ると、さらに最も難しい条件、検索が証明可能であることが加わる。
完全性の証明は、コンテンツアドレッシングとMerkleコミットメントに依存する。コンテンツアドレッシングはデータフィンガープリントの安定性を保証し、Merkleコミットメントは部分的な検証を可能にする。工学的な意義は、シャードレベルの証明を使用してオブジェクトのサブセットを検証でき、毎回全量を読み取る必要がないことにある。大規模モデルの重み、大規模コーパス、マルチメディアデータにとって、これは検証コストを直接決定する。
可用性の証明は、チャレンジメカニズムとサンプリング検証に依存する。Filecoinの実践は、可用性が口頭でのSLAではなく、定期的なチャレンジとチェーン上の証明であることを示している。汎用的なアーキテクチャに抽象化すると、受動的スポットチェック、能動的巡回、失敗時のペナルティの3点セットとなる。ノードは指定されたウィンドウ内にチャレンジに応答する必要があり、そうでなければペナルティや重みの低下が発生する。同様の考え方はデータ可用性層でさらに進んでいる。Celestiaのデータ可用性サンプリング設計によれば、データはk×kから2k×2kの行列に拡張され、ライトノードは複数回のランダムサンプリングと確率の累積により、ブロックデータ全体をダウンロードすることなく、可用性に対して高い確率の信頼を構築できる。これはAIシナリオに応用可能な示唆を与える。超大規模オブジェクトと高同時アクセスに直面した場合、すべての可用性を全量ダウンロードで検証する必要はなく、大規模システムでは統計的確認の方が現実的である。
動作の監査可能性は、チェーン上のアンカリングとイベントの記録に依存する。ストレージシステムで最も管理が難しいのは、実際の動作である。誰が何をアップロードしたか、誰がポリシーを変更したか、誰が移行をトリガーしたか、誰がいつ機密モデルを呼び出したか。これらの動作が統一されたイベントフローに集約されなければ、紛争が発生した際に証拠がない状態に戻ってしまう。ガバナンス層がすべきことは、すべての詳細をチェーン上に載せることではなく、紛争発生時に最小限で確定的かつ検証可能な証拠セットを手元に持つことである。
検索の証明可能性は、AI シナリオに特有であり、かつ最も難しい課題の一つです。問題は、見落とされがちなギャップにあります。結果が返ってきたとしても、それが正しい結果であるとは限らないのです。ベクトル検索ノードは、期限切れのインデックスを使用したり、本当の最近傍をスキップして、一見もっともらしい top-k を返すことができますが、返り値だけを見てそれを見分けることはできません。意味検索の出力自体には自己証明性がなく、エラーはエラーとして報告されず、静かに検索品質とモデル性能を低下させます。検索結果が決済、認可、またはオンチェーン上の意思決定に使用される場合、このギャップは品質問題から信頼問題へと格上げされます。
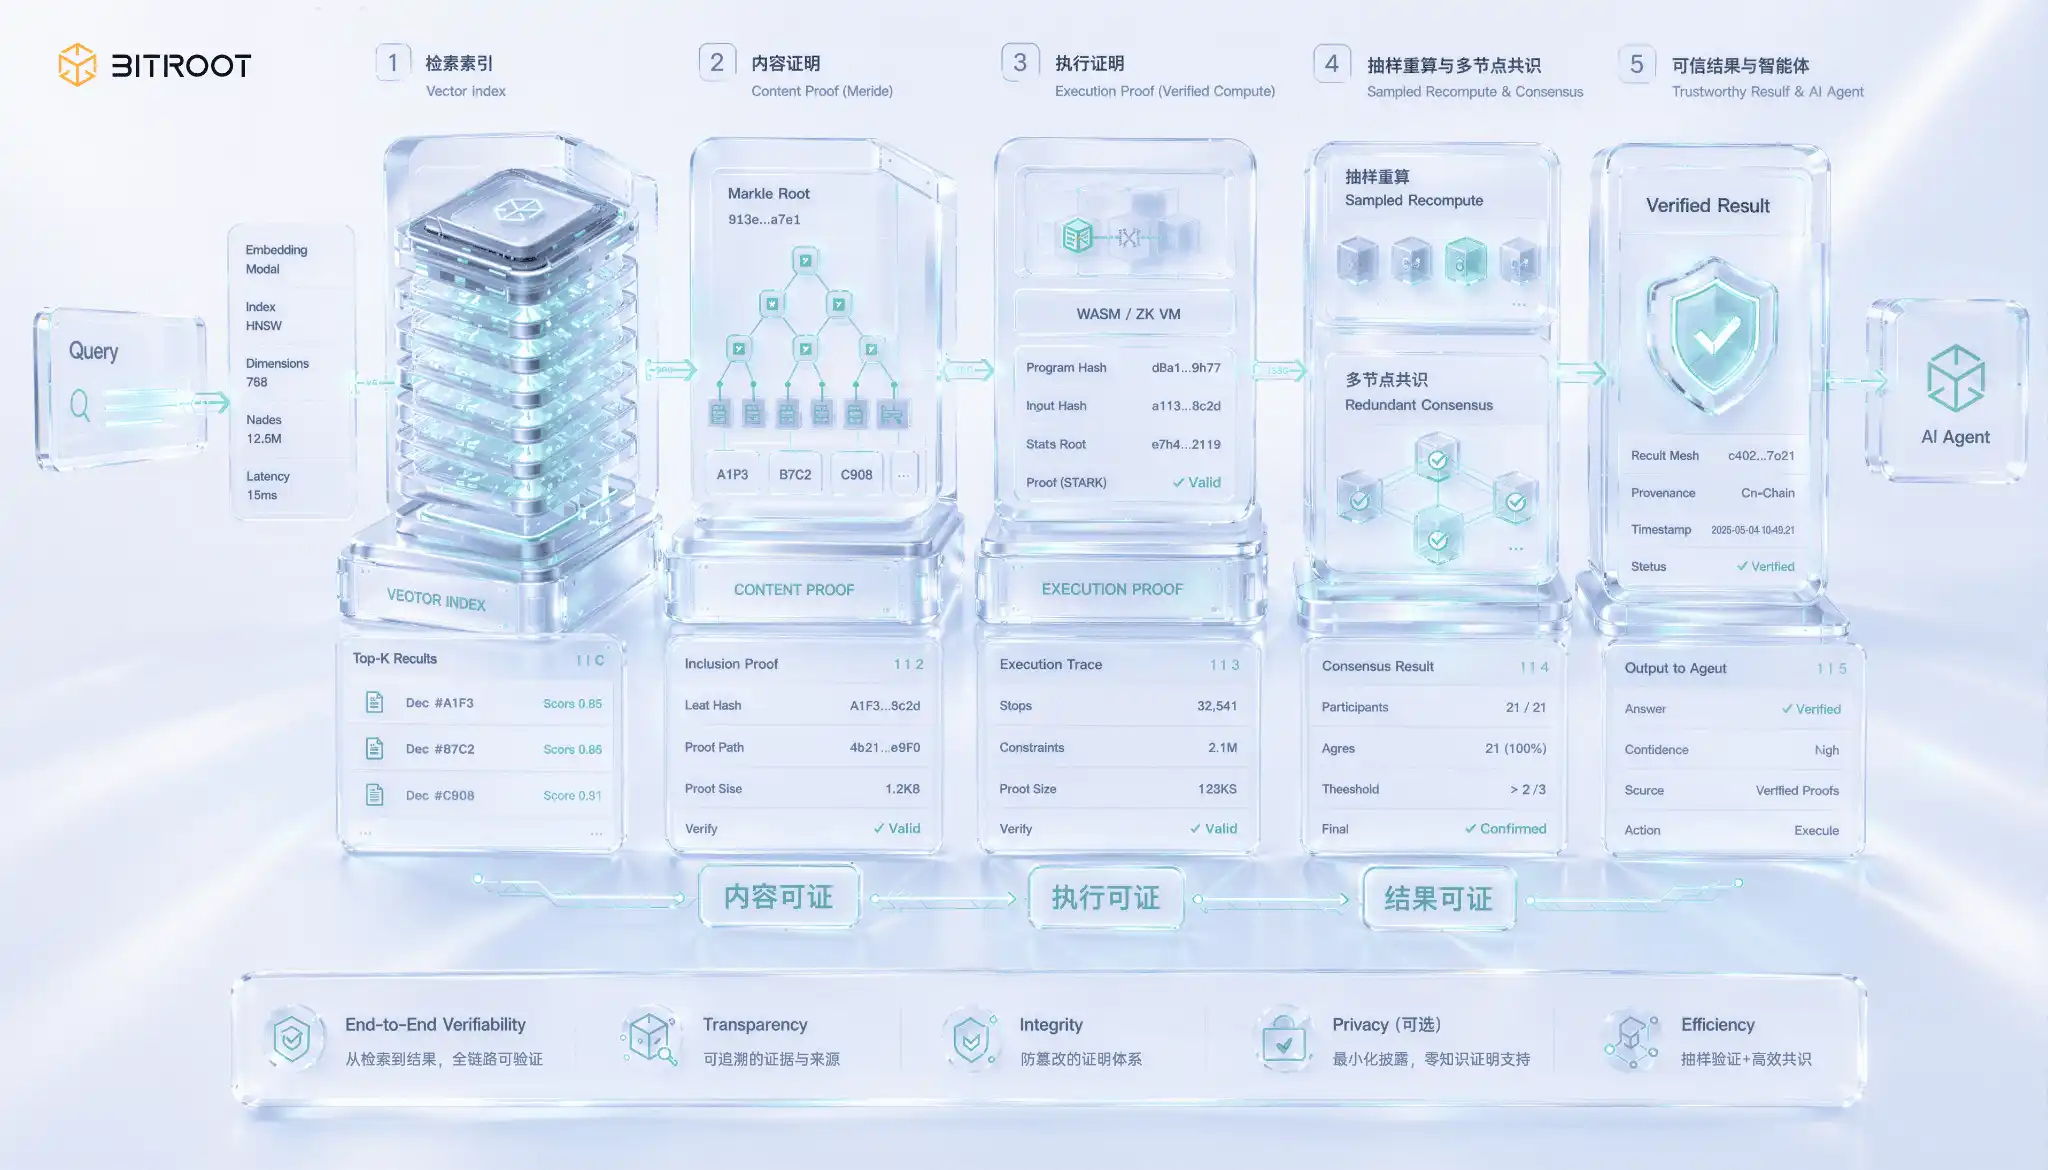
検索の証明可能性を分解すると、実は難易度が段階的に上がる3つの層からなる保証です。第一層は内容の証明可能性です。返されたベクトルが確かに約束されたインデックスバージョンに属することを証明します。これは、インデックスに認証データ構造を確立し、Merkle コミットメントを使用してインデックスルートをチェーン上に置き、結果を返す際に包含証明を添付することで、ノードがデータを捏造したりすり替えたりすることを防ぎます。第二層は実行の証明可能性です。このクエリが確かに約束されたバージョン上で実行されたのであり、改ざんされたインデックス上ではないことを証明します。これには、クエリプロセスを検証可能な計算の領域に含める必要があります。第三層は最も難しく、結果の証明可能性です。返された top-k が、与えられた尺度において確かに最近傍のものであり、より近い近傍を見逃していないことを証明します。これは本質的に、近似最近傍探索の正確性を証明するものです。
プロダクション規模で高次元の近似最近傍探索に対して厳密な結果の証明可能性を実現することは、現在でも最先端の課題です。ゼロ知識証明などの暗号技術は進歩していますが、高次元ベクトル演算の証明オーバーヘッドは、大規模なオンライン利用が可能なレベルには程遠い状況です。実用的なエンジニアリングによる解決策は、一足飛びに完全なものを目指すのではなく、段階的に防御を重ねることです。まず、インデックスバージョンと構築パラメータのコミットメントをチェーン上に置き、トレーサビリティを保証します。次に、クエリに対してサンプリングによる再計算を行い、オンラインクエリの一定割合を信頼できるレプリカで再実行して結果を比較し、個別の証明の代わりに統計的信頼度を使用します。同時に、複数の独立したノードに冗長検索をさせ、返された結果に対してコンセンサスを取ることで、単一ノードによる不正のコストを引き上げます。比較やコンセンサスで不一致が生じた場合にのみ、問題のあるクエリに対する全量再計算とオンチェーン裁定にエスカレーションします。このアプローチは、可用性証明におけるサンプリング検証優先の考え方と一貫しています。大規模システムでは、個別の厳密な証明よりも、統計的確認と異議申し立てによるエスカレーションの方が、実装が容易な場合が多いのです。
Bitroot にとって、検証可能な検索は独立したストレージ機能ではなく、AI Agent の信頼できる実行の一部です。オンチェーン Agent が外部の知識ベース、モデル重み、またはベクトルインデックスに依存して意思決定を行う場合、システムは少なくとも3つの質問に答えられる必要があります。どのデータバージョンを読み取ったか、どのモデルバージョンを呼び出したか、返された結果が登録されたインデックスバージョンからのものかどうか。Bitroot はこれらの証拠をオンチェーンで検証可能なイベントに圧縮し、Agent の動作を「賢そうに見える」から「トレース可能、異議申し立て可能、決済可能」へと進化させることができます。
選定の本質的な問題:プロトコル選びではなく、組み合わせの設計
多くのプロジェクトレビューが失敗するのは、質問の立て方が間違っているからです。正しい問いは「特定のプロトコルを使うべきか」ではなく、「データの組み合わせは何か、目標指標は何か、制約条件は何か」です。以下の4つのステップで進めることを推奨します。
まず、データ資産の棚卸しを行います。少なくとも状態データ、オブジェクトデータ、検索データ、監査データを区別し、棚卸しテンプレートを固定フィールド化します。最低8項目:データタイプ、日次増分、ピーク同時接続数、読み書き比率、保持期間、コンプライアンスレベル、目標レイテンシ、コスト上限。フィールドを統一すれば、クロスチームでの選定コミュニケーションが格段にスムーズになります。
次に、サービスレベル目標を定義します。P95/P99レイテンシ、復旧時間目標(RTO)、復旧ポイント目標(RPO)、可用性目標、1TBあたりのコスト上限をすべて明文化します。これがないと、以降の議論に基準がなくなります。
続いて、能力マッピングを構築します。永続ストレージ、定期的な可用性証明、低遅延検索、アクセスガバナンスといった能力を、それぞれ異なる技術レイヤーにマッピングします。単一レイヤーですべてをカバーしようとしないことが重要です。
最後に、移行の閾値を決定します。どのデータが移行期間中に中央集権型ホスティングを許可されるか、どの指標が移行をトリガーするか、いつまでに非中央集権型への置き換えを完了すべきかを明確にします。実用的な方法として、二重閾値を設定します:1TBあたりのコストが連続2統計期間で予算超過、またはP95レイテンシが連続2週間目標超過の場合、自動的にアーキテクチャ移行レビューをトリガーします。閾値がなければガバナンスは機能せず、移行期間が恒久状態と化します。
実装ソリューション:5層アーキテクチャで「保存・取得・管理」を閉じたループに
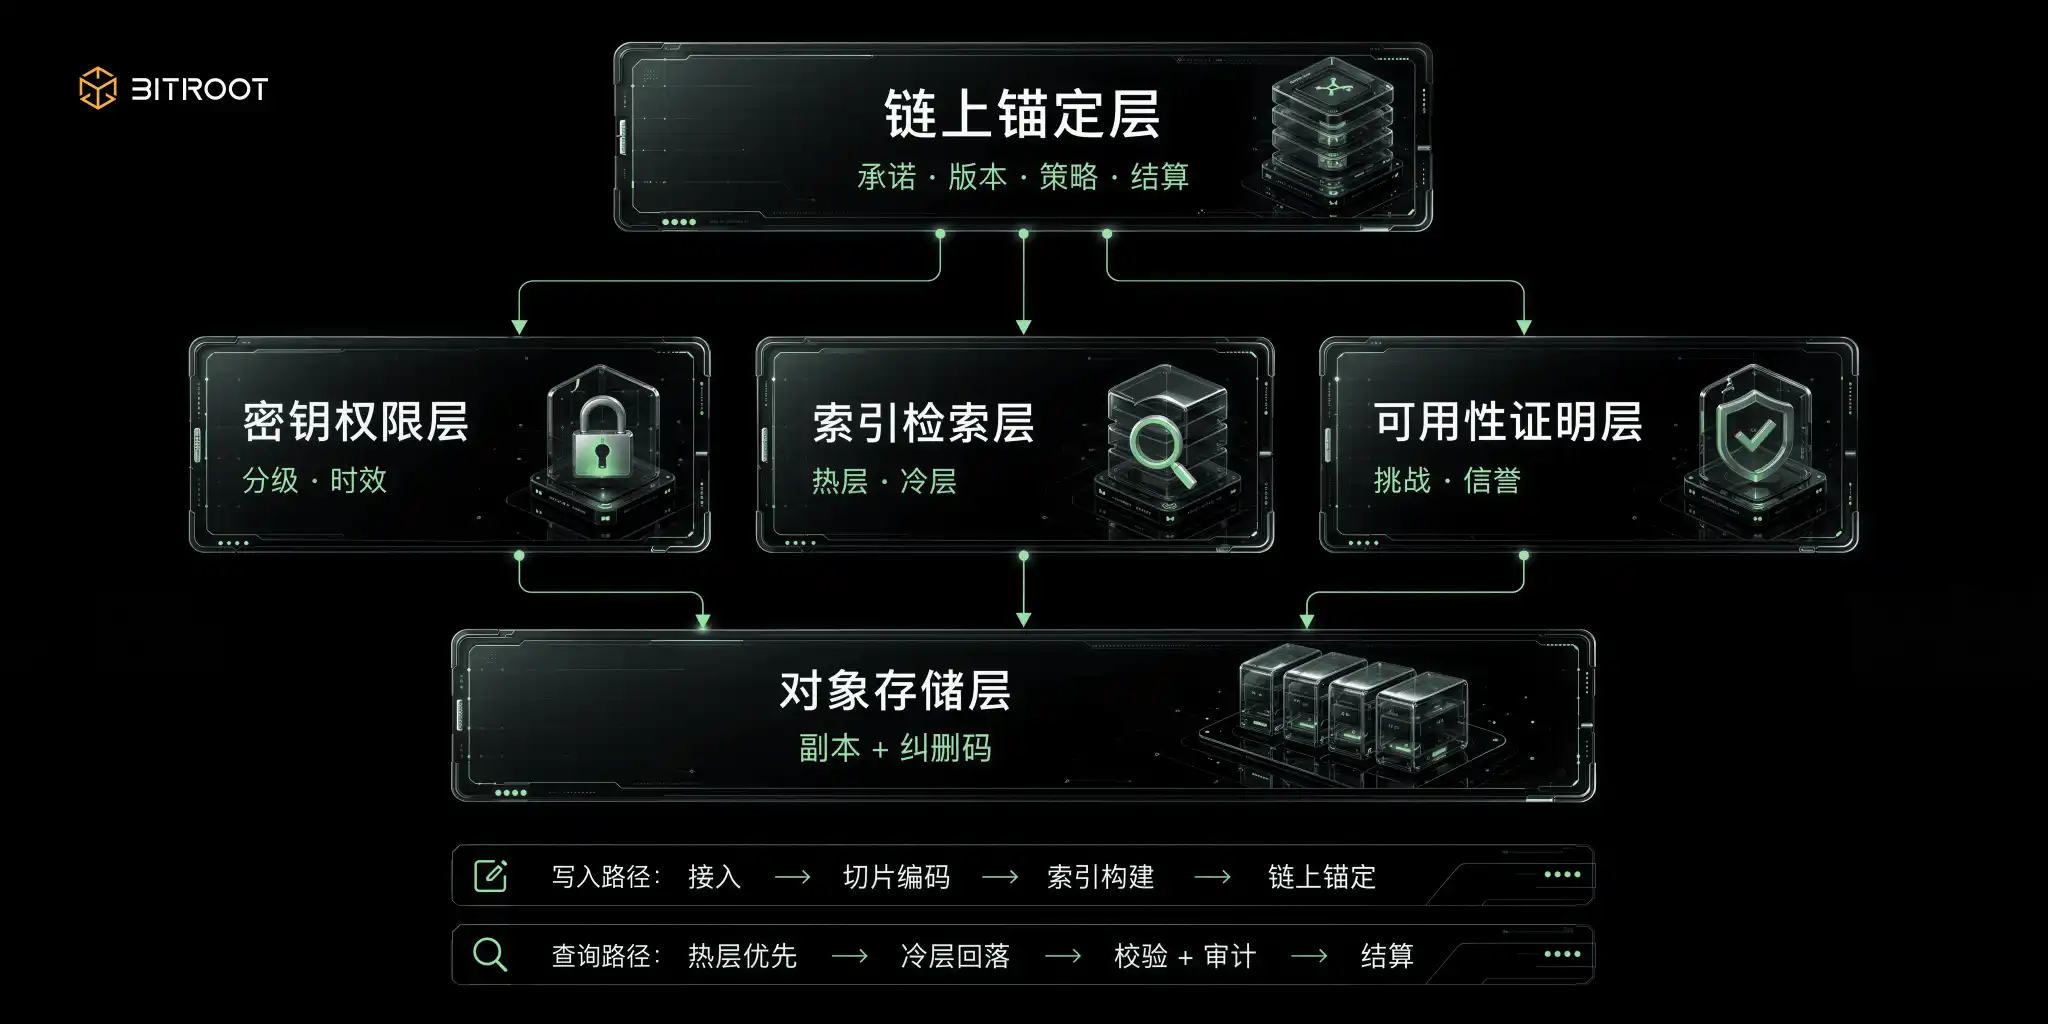
アーキテクチャの価値は層の数ではなく、検証可能な閉ループを形成できるかどうかにあります。前述のフレームワークに基づき、ソリューションは5層に集約されます:オンチェーンアンカリング層、オブジェクトストレージ層、インデックス検索層、可用性証明層、鍵・権限層。目標は、検証可能性をデフォルト機能に、高性能を設定可能な機能に、ガバナンスを実行可能なプロセスにすることです。
Bitrootにおいて、この5層はさらにAI Stackのストレージガバナンスモジュールとして理解できます:Parallel EVMが高頻度のアンカリングと決済能力を提供し、Pipeline BFTが低遅延の決定性を提供し、分散ストレージネットワークが大規模オブジェクトと履歴データを処理し、インデックス検索層がAIエージェントとアプリケーション呼び出しをサポートし、可用性証明層がノードのサービス品質を評判と報酬に変換し、鍵・権限層がユーザー主権、プライバシー保護、モデル商用化ライセンスを接続します。
オンチェーンアンカリング層は、最小限の必須状態のみを保存します:データコミットメント、バージョンフィンガープリント、権限ポリシーの要約、決済イベント。大規模オブジェクトはオンチェーン化せず、オンチェーンに載せるのは、そのオブジェクトが存在し、バージョンが正しいことを証明する証拠のみです。これにより、オンチェーンでの検証可能性を確保しつつ、スループットが大規模ファイルによって低下するのを防ぎます。
Bitrootのアーキテクチャにおいて、オンチェーンアンカリング層は単なる「ハッシュの記録」場所ではなく、AI資産の登録、権限ガバナンス、収益分配、紛争裁定の共通エントリーポイントです。データセット、モデルウェイト、ベクトルインデックス、推論ログは、オフチェーンで最適な方法で保存できますが、それらのバージョンコミットメント、認可ステータス、呼び出し記録、収益帰属はBitrootのオンチェーン状態に取り込む必要があります。これにより、オフチェーンストレージがデータ量を担い、Bitrootが信頼を担う構造が実現します。
オブジェクトストレージ層は実データを保持し、イレイジャーコーディングとレプリカを組み合わせたハイブリッド戦略を採用します。高価値で低頻度アクセスのオブジェクトはフォールトトレランスを重視し、中価値で高頻度アクセスのオブジェクトは検索効率を重視します。この戦略は静的な設定ではなく、アクセスホットネスとビジネスグレードに応じて動的に調整されます。
インデックス検索層は、メタデータインデックスとベクトルインデックスを統一ディレクトリに統合し、ホット層がオンライン検索を、コールド層がアーカイブと再構築を担当します。すべてのインデックスバージョンは、元データのバージョンと構築パラメータを登録する必要があります。そうしなければ、インデックスのドリフトが発生した際に責任追及ができません。
可用性証明層は、ノードの動作を定量化します。チャレンジ応答成功率、応答レイテンシ、修復成功率がすべて信頼スコアに反映され、そのスコアが報酬配分と連動します。これにより、容量のみを報酬対象とし、可用性を無視することを防ぎます。
鍵権限層は、アクセスとコンプライアンスを制御します。高機密データには階層鍵と期限付き認可、推論ログには匿名化保存と監査リプレイ、モデル呼び出しには取消可能な許可を使用します。権限操作自体も記録を残し、設定のドリフトを防止します。
これら5つの層は実行レベルで閉ループを形成し、単方向のパイプラインではありません。データが取り込まれると、まずスライスされてオブジェクト層にエンコードされ、書き込み後にインデックスが生成され、オンチェーンにアンカリングされます。オンラインクエリはホット層を経由し、ヒットしない場合はコールド層にフォールバックします。結果が返される際に、整合性チェックと権限チェックがトリガーされ、重要な動作は決済と監査に送られます。このチェーンの真の価値は、どのノードでも、どの時点でも、データの出所、現在のバージョン、アクセス権限を持つ者、システムがその可用性を証明できるか、という4つの質問に答えられる点にあります。
これこそが、BitrootがAIストレージガバナンスを担うのに適している理由です。AIエージェントの呼び出し、モデルバージョンの切り替え、データ認可の変更、検索結果に関する紛争は、低頻度のバックグラウンド操作ではなく、アプリケーションの成長に伴って継続的に発生するオンチェーンイベントです。基盤チェーンが十分に低い確認遅延と高いスループットを提供できなければ、ストレージガバナンスは最終的にオフチェーンのスプレッドシートと手動照合に戻らざるを得ません。BitrootのParallel EVMとPipeline BFTの組み合わせの価値は、単なる高いTPSではなく、これらの高頻度ガバナンスイベントをリアルタイムでアンカリング、決済、責任追及できる点にあります。
誰が支払うのか:容量ではなく可用性が収益を決める
ストレージを長期的に持続可能にするには、インセンティブを容量の積み上げではなく、可用性に合わせる必要がある。容量だけに報酬を与えることは、ノードがサービスを軽視してハードディスクを積むことを事実上促進する。この点について、Filecoinはメカニズムで修正を加えている。同プロジェクトは「品質調整済み算力(quality-adjusted power)」の概念を導入し、実際のストレージ注文、特に検証済みの有効注文を引き受けたセクター(ストレージ空間の最小計量単位)が算力計算でより高い重みを得られるようにした。これにより、単に空の容量を封入するだけのものではなく、実際にサービスを提供する容量に報酬が傾く仕組みとなっている。この考え方は、独自のインセンティブ層を構築する際に参考にすべきである。
これを実行可能な報酬関数に落とし込むには、少なくとも4つの次元を同時に考慮し、それぞれの重み付けのロジックを明確にする必要がある。容量は基本シェアを決定し、どれだけのスペースを約束するかを示す。オンライン率と応答レイテンシーはサービス品質係数を決定し、約束されたスペースが必要なときに実際に利用可能かどうかを示す。この項目は高い重みを持つべきであり、そうでなければ可用性は単なるスローガンに終わる。データ復旧成功率は災害復旧の信頼性を決定し、ノードがダウンした後にレプリカが再構築可能かどうかを示す。これは長期保存データの生存性に直接関係する。データ価値密度は需要側の倍率を決定し、高価値データセットや高需要モデルに対して差別化された倍率を設定することで、希少で頻繁に呼び出されるデータがより高いリターンを得られるようにする。報酬は宣言された容量ではなく、証明可能なサービスに対して支払われるべきである。
ポジティブなインセンティブだけでは不十分であり、制約側のステーキング、ペナルティ、仲裁も同時に整備する必要がある。さらに、以下の基本的な不等式を満たさなければならない:不正行為の期待収益は没収される期待コストを下回らなければならない。そうでなければ、いかなる証明メカニズムも経済的合理性によって回避される。ステーキングにより、ノードは可用性の約束に対してコストを負担することになる。ステーキングの規模は、約束された算力とデータ価値に比例すべきである。Filecoinの設計では、ストレージ提供者は約束された算力に応じて事前ステーキングを支払う必要があり、証明ウィンドウ内でダウンすると障害料金が発生し、セクターが永久に放棄されるとより重い終了ペナルティが課される。この段階的なペナルティの意義は、短期的なダウンと悪意のある離脱を区別することにある。仲裁はチェーン上の証拠を用いて紛争処理を推進する。ユーザーがデータの利用不可を主張し、ノードが正常なサービスを主張する場合、チャレンジ記録、サンプリング証明、イベントログが機械可読な裁定根拠を構成し、本来人手を介する必要があった紛争を検証可能なチェーン上の判定に圧縮する。
AIのシナリオでは、さらに難しいガバナンスの層を重ねる必要がある:三者間の収益をどのように分配するか。繰り返し呼び出されるモデルの背後には、データ提供者が提供するコーパス、モデル提供者が投入したトレーニング、ストレージノードが担うホスティングがあり、三者とも最終的な呼び出し価値に貢献しているが、その貢献は直接観測することが難しい。実行可能な方法は、価値の帰属を計量可能なチェーン上のイベントに基づかせることである:呼び出しは回数ごとに課金され自動決済され、データとモデルはバージョンフィンガープリントと血縁関係を通じて各呼び出しに紐づけられ、事前に書き込まれたプログラム可能な分配比率に従って自動的に分割される。これにより、事後の揉め事を回避できる。これに付随して、ブラックリストと没収メカニズムが必要である。悪意のあるデータアップロード、著作権侵害、モデル盗用などの行為に対しては、仲裁で認定され次第、ステーキングを差し押さえ、将来の収益を凍結する。そうしなければ、逆説的な結果が生じる:資産化が成功すればするほど、分配と権利確定の紛争が増え、最終的にはエコシステムの信頼そのものが崩壊する。
コンプライアンスはリリース後のパッチではなく、アーキテクチャ設計段階での制約である。セキュリティベースラインは、エンドツーエンド暗号化、階層型鍵管理、定期的な鍵ローテーションに加え、ハッシュ検証とMerkleコミットメントによるダウンロードの検証可能性、さらにマルチレプリカと消失訂正符号による障害復旧の冗長性を備える。プライバシー面では、データレベルに応じた最小権限アクセス制御を実施し、取り消し可能な認可、ワンタイム認可、期限付き認可をサポートし、重要なアクセスと操作は全チェーンで記録を残し、監査とリプレイを可能にする。コンプライアンスは最も後回しにされやすく、かつ最もコストがかかる要素でもある。データのローカライゼーションとクロスドメイン転送ポリシーは設定可能とし、削除、アクセス、監査リクエストには標準的なプロセスインターフェースを用意する。最も厄介なのは、改ざん不可能性と削除可能性の本質的な矛盾であり、現実的な解決策は暗号化による消去とインデックス無効化の組み合わせである。鍵を破棄して暗号文を復元不能にし、インデックスを無効化してデータを検索不能にすることで、チェーン上の記録を保持しつつ削除要求を満たす。パイロットから本番環境への移行には3つの段階的なハードルがある。まず最小限の信頼できるクローズドループを構築し、オブジェクトストレージ、チェーン上のアンカリング、完全性検証、基本監視を安定稼働させる。検証基準は可用性、読み書き成功率、アンカーとオブジェクトバージョンの一致率、障害復旧の実演可能性とする。次に、AIアセット化とインデックスガバナンスを導入し、データセットとモデルアセット管理、バージョン系統、ベクトルインデックスのホット/コールド階層化、モデル認可呼び出し、トレーニングデータソース登録を実装する。検証基準はトレーニングのトレーサビリティ、モデルのロールバックと監査可能性、ホット層のレイテンシ目標達成、インデックス再構築の影響制御とする。最後に、検証可能な検索と自動化ガバナンスを導入し、チャレンジプルーフ、ポリシーマイグレーション、報酬とペナルティの自動化を実装する。検証基準は可用性証明のカバレッジ、リスク対応レイテンシ、単位コスト削減、ポリシー変更のトレーサビリティとロールバック可能性とする。指標体系は表示用のレポートではなく、戦略システムである。技術項目のみを記述しビジネス成果を無視すると、ストレージソリューションは純粋なコストセンターに陥る。3層に分けることを推奨する。基本技術指標(可用性、P95/P99レイテンシ、スループット、RTO/RPO、エラー率)はシステムの健全性を回答し、AI特化指標(トレーニングデータトレーサビリティ率、モデル再現率、推論検証カバレッジ、インデックス一貫性)はモデル品質のガバナンス可能性を回答し、ビジネス成果指標(データ供給成長、呼び出しコスト削減、ノードアクティビティ、アセット取引規模)はシステムの価値創造を回答する。3層間にはマッピング関係が必要であり、指標の真の用途は戦略調整の入力であり、表示用のレポートではない。最も一般的な5つの失敗点は事前に回避可能である。ストレージのみでバージョンガバナンスを行わない場合、データが存在しても利用可能とは限らず、利用可能でも再現可能とは限らない。容量のみに注目し可用性証明を無視する場合、容量ベースの報酬は容量の積み上げを促進しサービスを軽視させる。ホット/コールド階層化は行うが同期戦略を欠く場合、インデックスバージョンの同期と無効化処理がクローズドループにならない。コンプライアンス戦略を後回しにすると、権限、ログ、匿名化、削除対応が遅れるほど修正コストが増大する。過渡的アーキテクチャに退出メカニズムがない場合、中央集権から分散化への移行は合理的な経路だが、移行閾値が欠如すると過渡的状態が固定化され、本来の目的から逸脱する。
Bitrootの完全クローズドループ:データ、モデルからAIエージェントへ
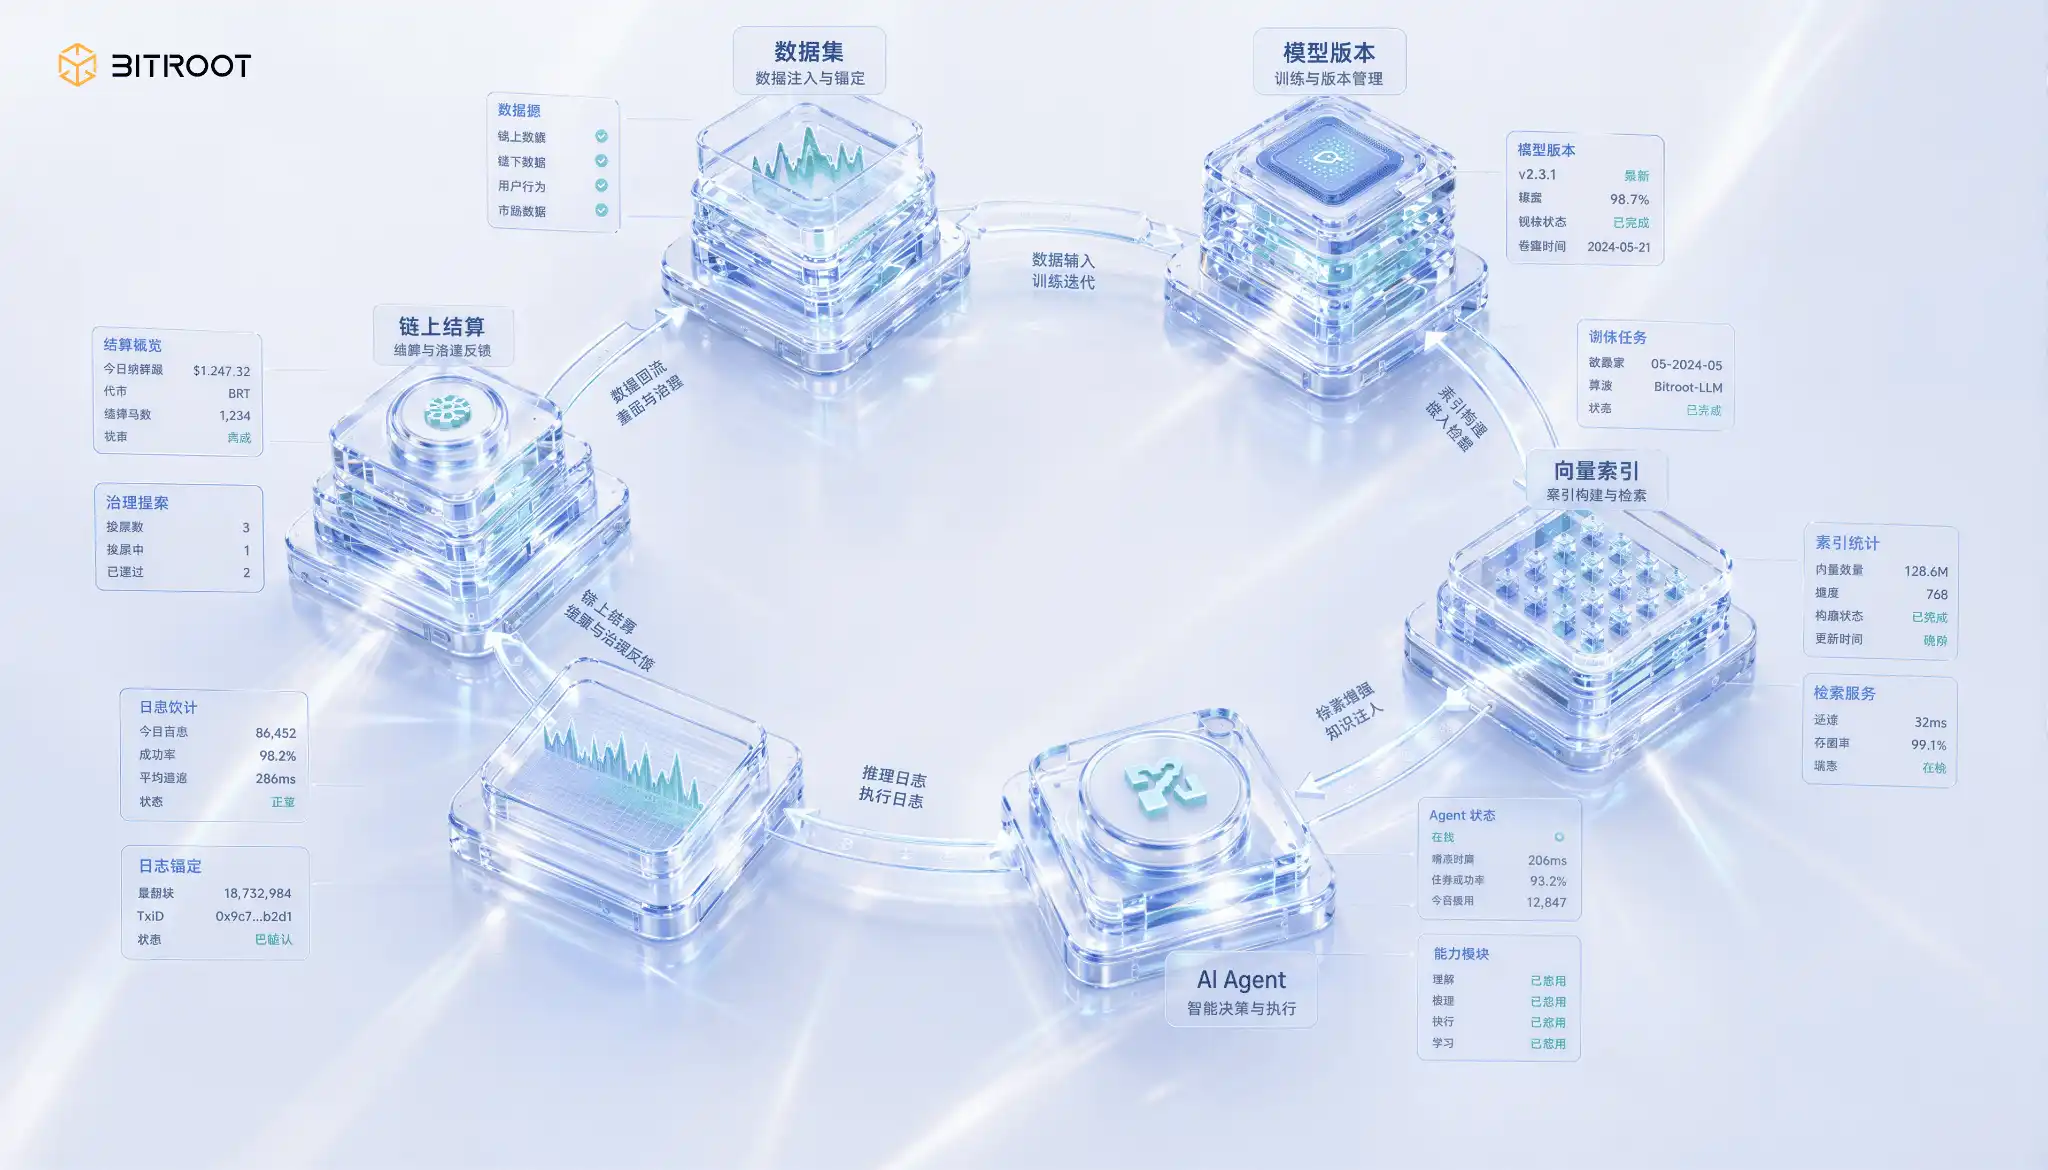
このクローズドループにおいて、BitrootはAIアセットの重要なアクションをすべて決済可能なイベントに変換できる。データセットの登録、モデルバージョンのリリース、ベクトルインデックスの再構築、AIエージェントの呼び出し、推論ログのアンカリング、権限の付与と取り消し、異議申し立てと仲裁結果などだ。チェーン上にすべてのデータを保持する必要はないが、これらのアクションの最小限の証拠は保持しなければならない。そうでなければ、データ、モデル、計算リソース、アプリケーション間の価値関係は口約束に留まり、プログラム可能な分配と監査可能なガバナンスの領域には到達しない。
このメカニズムをBitrootの運用とエコシステム拡大に組み込む場合、ストレージインセンティブは単なるハードウェア補助金として設計されるべきではなく、AIスタックの価値フローの一部となるべきだ。データ提供者はデータがトレーニングや呼び出しに使用されることで報酬を得、モデル提供者はモデルサービスによって報酬を得、ストレージおよび検索ノードは継続的な可用性と低レイテンシサービスによって報酬を得、検証およびチャレンジノードは利用不可、インデックスドリフト、権限異常の発見によって報酬を得る。こうして、Bitrootの経済システムは「アップロードしたこと」ではなく、「継続的に証明可能な有用性」に対して報酬を与える。
ストレージはコストセンターではなく、信頼と価値の分配システム
分散型ストレージがAI時代に解決すべきことは、特定のオブジェクトストレージ製品を置き換えることでも、分散化というナラティブを追求することでもない。より重要な4つの課題がある。長期的に利用可能な信頼証明、主体間の協調ガバナンス秩序、データとモデルの責任連鎖、持続可能な経済的インセンティブだ。
単一プロトコル、単一レイヤーのアーキテクチャではこれらの目標をカバーできない。より現実的な道はコンポーザブルアーキテクチャだ。コンテントアドレッシングで完全性を保証し、ストレージ証明で時間軸上の可用性を保証し、パーマネントレイヤーで重要な履歴を保証し、ホットレイヤーでオンライン体験を保証し、チェーン上のアンカリングでガバナンスと決済の証明可能性を保証する。これは妥協ではなく、エンジニアリングの合理性だ。実装の焦点は機能の完全性ではなく、クローズドループの早期確立にある。まず最小限の信頼できるクローズドループを動かし、その後、AIの資産化、検証可能な検索、自動化ガバナンスを段階的に積み重ねていく。
このアプローチを1週間の行動に圧縮すると、実質的に3つのステップになる。1日目に8フィールドのデータ棚卸し表を作成し、3日目に実際のビジネスドメインで、取り込み、ストレージ、検索、検証の最小限のパイプラインを実行し、7日目にP95レイテンシとユニットコストを用いて移行しきい値のレビュー会議を開く。この3ステップを達成すれば、チームは概念的な合意からエンジニアリング的な合意へと移行する。
また、現実的な限界を認める必要がある。どのプロトコルコンビネーションを採用しても、コスト、レイテンシ、永続性の間にはトレードオフが存在し、すべてのビジネスに同時に最適な単一の答えはない。真に持続可能なソリューションは、明確な境界条件の下での継続的な反復から生まれ、一度決めて長期にわたって静的に構成するものではない。
将来プロジェクトを淘汰するのは、往々にしてTPSの低さではなく、データの責任連鎖が不明確であることだ。AIパブリックチェーン時代において、ストレージとは単にデータを保存することではなく、データがいつでも証明可能であることを意味する。
結び
真のAIパブリックチェーン競争は、最終的にTPS、ガス代、確認時間の比較に留まらない。パフォーマンスは入り口だが、終着点ではない。AIネイティブアプリケーション時代に入ると、オンチェーンシステムが担うのは取引だけでなく、データのバージョン管理、モデル呼び出し、計算リソースのスケジューリング、推論記録、エージェントの行動、そして複数関係者への収益分配も含まれる。
これこそがBitrootのストレージ層に対する判断である。ストレージは付属モジュールではなく、AIスタックの中で価値の源泉に最も近い層である。データが証明可能か、モデルが再現可能か、呼び出しが監査可能か、収益が自動分配可能かどうかが、分散型AIネットワークが真に長期的な生命力を持つかどうかを決定づける。
Bitrootが構築しようとしているのは、単により高速な実行を追求するチェーンではなく、AI資産が確認、呼び出し、決済、ガバナンスされるためのインフラである。Parallel EVMとPipeline BFTは高頻度のオンチェーンイベントの処理能力を解決し、分散ストレージと検証可能なメカニズムはAIデータとモデルの信頼基盤を提供し、プログラム可能な収益分配とオンチェーンガバナンスは貢献を持続的な経済的インセンティブへと変換する。
AIエージェントがユーザーに代わって行動し、モデルやデータが流通可能な資産となり、計算リソース、ストレージ、推論サービスが同一の価値ネットワークに統合される時、ストレージはもはや「ファイルをどこに置くか」という問題ではない。
それはAIパブリックチェーンの信頼基盤となり、次世代スマートネットワークの価値分配システムとなるだろう。
Bitrootの見解では、将来本当に重要なのは誰が最も多くのデータを持つかではなく、誰がデータをいつでも証明可能、呼び出し可能、追跡可能にし、最終的に価値決済に参加させられるかである。
Bitrootについて
Bitrootは並列実行とAIネイティブアーキテクチャに特化したLayer 1パブリックチェーンプロジェクトである。BitrootはEVM互換の技術路線を採用し、並列実行メカニズム、コンセンサス最適化、AI関連インターフェース設計を通じて、AIエージェント、DeFi、Web3アプリケーションに高性能で低コストなオンチェーン実行環境を提供することを目指している。
本記事は投稿によるものであり、BlcokBeatsの見解を代表するものではありません。
BlockBeats の公式コミュニティに参加しよう:
Telegram 公式チャンネル:https://t.me/theblockbeats
Telegram 交流グループ:https://t.me/BlockBeats_App
Twitter 公式アカウント:https://twitter.com/BlockBeatsAsia