新たにフィールズ賞を受賞した王虹氏、AIにも挑戦していた?
原文タイトル:「フィールズ賞受賞者・王虹、NeurIPSにも論文を発表していた」
原文出典:量子位
え?新たにフィールズ賞を受賞した王虹氏が、AIにも挑戦していた?
NeurIPS 2026の採否発表を控え、ネットユーザーが王虹教授がNeurIPS 2019に論文を発表していたことを発見した。
しかも単なる共著ではなく、実際に共同筆頭著者だった。
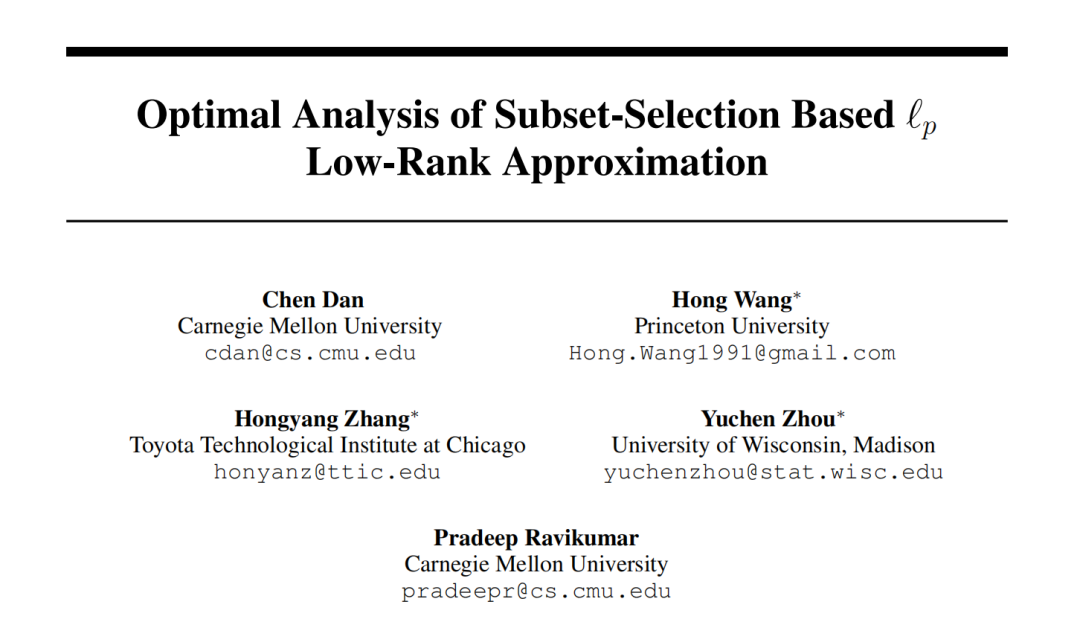
では問題は、純粋数学のトップ数学者がなぜAIトップ会議に論文を発表したのか?
読み通した結果、我々の結論は、これは数学理論+機械学習の最良の事例だということだ。
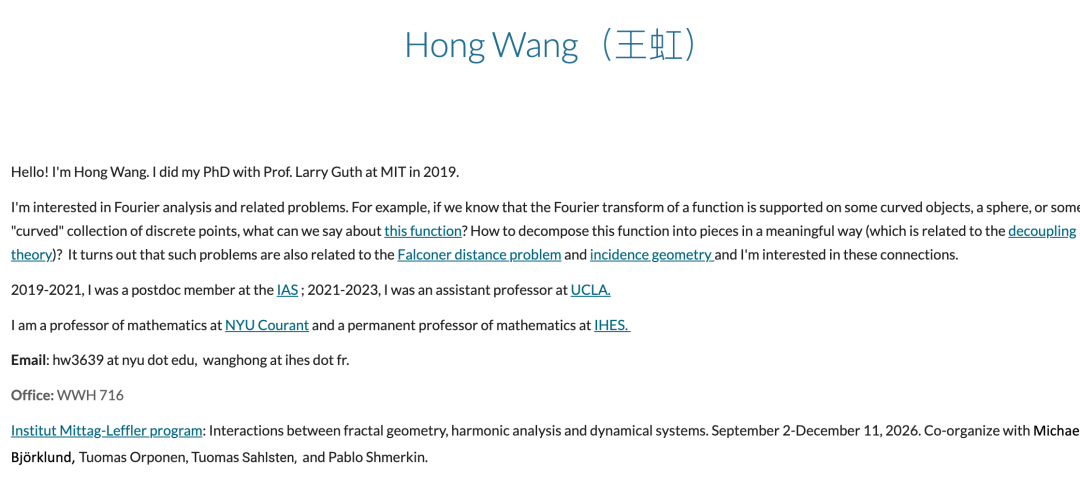
しかし興味深いことに、王虹氏の個人ページに掲載されている約40以上の論文とプレプリントのほとんどに完全なリンクが付いている。
ただ、この論文だけは例外だった。
王虹がAIに挑戦
この論文が研究しているのは、機械学習とデータ分析における基本的なタスク:低ランク行列近似だ。
簡単に言えば、現実のデータは通常行列に整理できるが、これらの行列は非常に大きいことが多く、直接保存・処理するコストが極めて高い。
低ランク近似は、より構造が単純でランクの低い行列を使って、元の行列を可能な限り正確に再現するものだ。
最近よく使われる近似アルゴリズムは列部分集合選択(Column Subset Selection、CSS)だ。
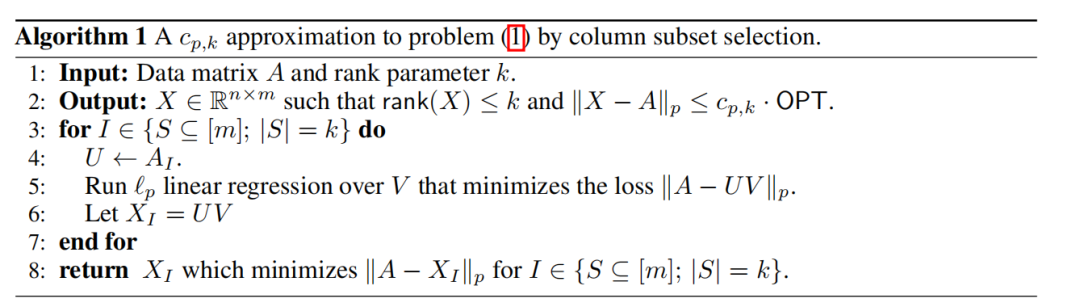
その考え方は非常に直感的だ。
大量の列を含むデータ行列を扱う際、新たな低ランク行列を直接求めるのではなく、元の行列から代表的な列をいくつか選び、それらが張る空間で行列全体を近似する。
CSSで選ばれた列は元のデータから直接得られるため、通常の行列分解で得られる抽象的なベクトルよりも解釈しやすく、同時に保存・計算コストを削減でき、大規模データの処理に適している。
これまでの研究により、一般的な低ランク近似において、CSSアルゴリズムの近似比の上限はおおよそO(k+1)であることが証明されている。
ここでのkは目標行列のランクを指し、kが大きいほど理論上許容される最悪誤差も大きくなる。
王虹らの研究は、この境界をさらに押し進めたものである:
・1≤p≤2の場合、近似比は(k+1)^(1/p);
・p≥2の場合、近似比は(k+1)^(1−1/p)。
従来の統一的なO(k+1)の結果と比較して、この境界は明らかにタイトであり、アルゴリズムは厳密に制限され、最悪の結果でも最適解からわずかに劣るだけとなる。
さらに、p≥2の場合については、論文は対応する下界も構築し、その結果が定数1まで正確であることを証明している。
言い換えれば、この論文はほぼ完璧な理論的答えを示している。
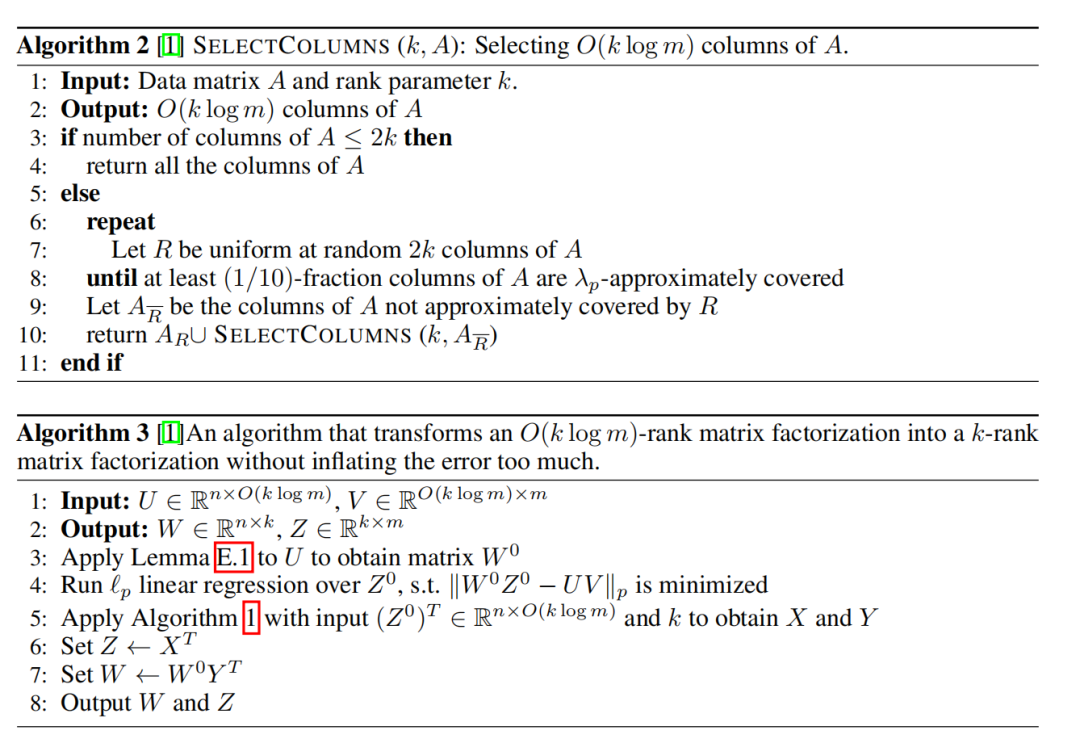
そして、この論文で最も重要であり、王虹の数学的背景が最もよく表れている部分は、調和解析の古典的なツールであるRiesz–Thorin補間定理を使用した点である。
通常、あるアルゴリズムがすべてのp値で成立することを証明するには、異なるpごとに複雑な解析を個別に行う必要がある。
特定の端点ケース、例えばp=1、p=2、p=∞については、比較的扱いやすい。
次に、Riesz–Thorin補間定理を用いることで、これらの端点結果を把握した後、結論を中間のすべてのp値に「補間」することができる。
具体的には、論文はまずp=1、2、∞の3つの特殊ケースを証明し、その後補間理論を通じて範囲全体の近似境界を導出する。
実際、このツールは調和解析や作用素理論では古典的な手法であるが、当時の理論計算機科学の研究者が最も頻繁に使用する技術ではなかった。
NeurIPSの当時の査読者もこの点に注目していた。
査読者は最終的に、この論文の最も主要な技術的革新は、コンピュータ分野にRiesz–Thorin定理を導入したことであると認め、最終的なMeta Reviewでは、非常に堅牢な論証を持つ論文であると評価された。
今日の視点で見ると、この論文は非常に典型的な学際的な事例を提供している。機械学習の難題が、純粋数学の中で突破口を見つけられるかもしれない。
NeurIPS 2026 のスコア発表間近
現在に目を向けると、NeurIPSの査読メカニズムに顕著な調整が行われている。
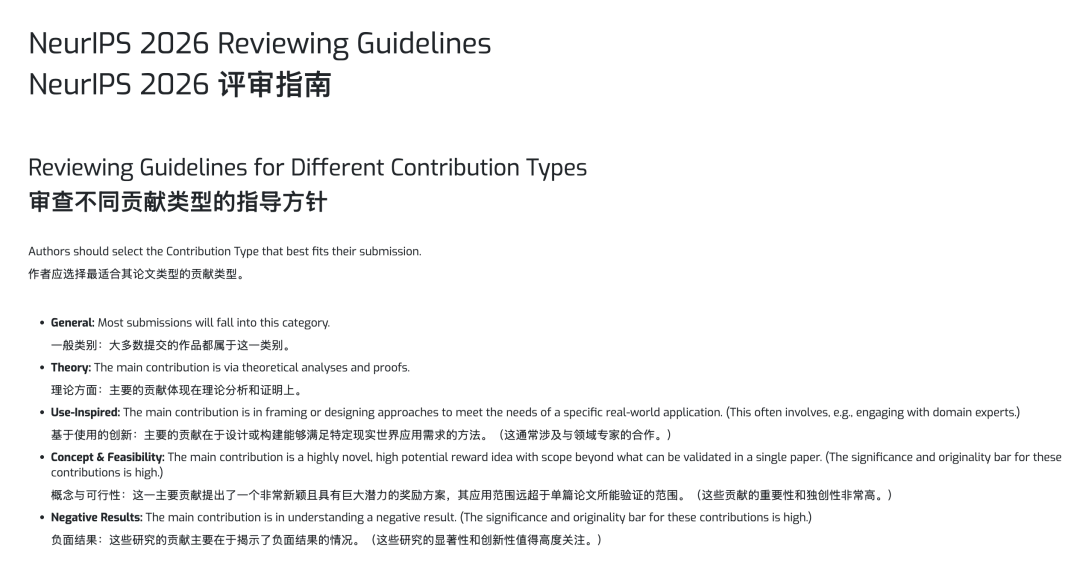
NeurIPS 2026では、著者は投稿時に論文の位置づけに最も適した貢献タイプを5つ(General、Theory、Use-Inspired、Concept & Feasibility、Negative Results)から選択する必要がある。
間違いなく、王虹氏の2019年の論文はその中のTheoryタイプに該当する。
NeurIPS 2026の最新の査読ガイドラインによれば、理論論文はまず数学的な厳密性と正確性が評価される。証明、補題、全体的な論理が成立していなければならず、理論論文は実験が不足しているからといって軽視されるべきではない。
同時に、NeurIPS 2026は理論的貢献が独立して成立し得ることを明確に示しており、新しいアルゴリズムを設計する目的は、必ずしも最新の応用モデルや最大データセット上のSOTAを打ち負かすことではない。
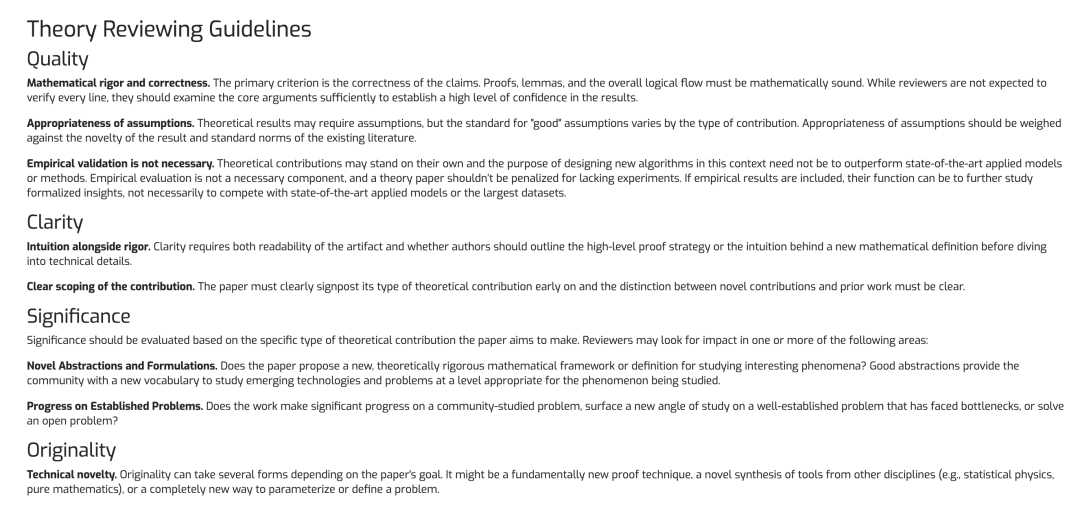
独創性の面では、他の学問分野から新しい証明ツールを導入したり、既存のツールを革新的に統合することも可能である。
そして、これはまさに王虹氏の論文の正確な描写である。
彼らは今日的な意味でのニューラルネットワークアーキテクチャを提案したわけでも、膨大なパラメータ数のモデルを訓練したわけでもない。代わりに、調和解析における補間定理を低ランク近似に導入し、近似アルゴリズムの限界問題を解決した。
2026年の評価フレームワークに当てはめても、それは依然として非常に標準的なNeurIPSの理論論文である。
また、これは逆に、NeurIPSがニューラルネットワークモデルの発表会と同義ではないことを示している。既存の手法に新たな理解を与え、新しい性質を発見し、より厳密な理論的限界を確立することも、価値ある独自の貢献である。
数学とAIの境界線も、想像されていたほど明確では決してない。
フィールズ賞受賞者がNeurIPSに論文を発表できる——数学の言語も、AIにとって真の普遍解を見つける手助けとなる。
参考リンク:
[1]https://proceedings.neurips.cc/paper_files/paper/2019/file/80a8155eb153025ea1d513d0b2c4b675-Paper.pdf
[2]https://neurips.cc/Conferences/2026/ReviewerGuidelines
[3]https://sites.google.com/view/hongwang/home
[4]http://xhslink.cn/o/8oQ3gm7qaxu
原文リンク
BlockBeats の公式コミュニティに参加しよう:
Telegram 公式チャンネル:https://t.me/theblockbeats
Telegram 交流グループ:https://t.me/BlockBeats_App
Twitter 公式アカウント:https://twitter.com/BlockBeatsAsia

 関連記事