SemiAnalysisリサーチレポート:なぜ半導体需要の予想を引き下げ、NVIDIAの売上予想を大幅に下方修正したのか?
原文タイトル:アクセラレータ需要と出荷見通しを下方修正、エヌビディアが打撃を受ける
原文著者:Myron Xie と Ivan Chiam
編集者注:1つのエヌビディア Feynman Ultra は、SemiAnalysis の2つのバージョンのモデルにおいて、平均販売価格が約7.7万ドル異なる。11月13日、この半導体研究機関はこのチップの平均販売価格予測を約17.5万ドルから9.8万ドルへ引き下げ、下落率は約44%となった。高帯域幅メモリ(HBM)のコスト回落がその一部を説明し、残りの調整はアナリストによるエヌビディアの価格設定能力に関する新たな判断を反映している。大口顧客の手元に代替案が増えるにつれ、エヌビディアの次世代チップが課せるプレミアムは従来の予想を下回る可能性がある。
この調整はエヌビディアにとどまらない。SemiAnalysis は2028年の世界 AI アクセラレータ支出予測を1兆540億ドルから7,580億ドルへ引き下げ、約3,000億ドル減少した。新モデルによれば、2030年まで年間支出は依然9,000億ドルを超え、2026年の2倍以上となる。増分は依然として相当だが、最先端 AI ラボの第3四半期における純新規年換算経常収益は減速し、投資家もデータセンターへの融資を引き締めている。大口顧客の調達コミットメントを欠くプロジェクトは、多くの場合、誰が資金を出して機房を建て、電力を引き込み、設備を買うのかを先に解決しなければ、チップ注文の実現は見込めない。
エヌビディアが直面する圧力は2種類の顧客から来ている。Anthropic はグーグル TPU、アマゾン Trainium、そして2社の GPU メーカーの間で算力を配分できる。OpenAI は自社チップ開発を進める一方、AMD とのワラント取引から潜在的な利益も得られる。同時に、エヌビディアは各チップサプライヤーの中で新興クラウドサービス事業者へのエクスポージャーが最大である。これらの顧客はまず資金を調達して GPU を購入し、その後算力のレンタルで投入を回収する必要がある。上位の買い手にはより多くの選択肢があり、融資で拡大する買い手はさらに発注しにくくなる。2つの圧力が重なり、SemiAnalysis はエヌビディアの2030年の出荷に対応する算力製品収入予測を66%引き下げた。
ブロードコムとメディアテックの対比は、この競争の中で見落とされがちなもう一つの勘定を明らかにする。両社とも TPU プロジェクトに参加しており、メディアテックはより低いシステムコストを提供できるが、ブロードコムは土地、電力、機房、設備の融資手配を支援する能力を持つ。資金繰りが厳しい買い手にとって、システムが最終的にいくらかかるかと、今日いくらの現金を出す必要があるかは、2つの異なる調達ハードルである。チップ競争がデータセンター全体に広がる中、顧客のプロジェクト構築を支援できるサプライヤーほど、受注の機会も大きくなる。
以下が原文です:
TL;DR
·SemiAnalysisは2028年のアクセラレータ支出予測を1兆540億ドルから7,580億ドルに下方修正し、2030年の予測は旧版より約40%低い。
·最先端AIラボの第3四半期における純増年換算経常収益は減速し、債権・株式投資家もAIインフラへの融資を引き締めており、大手クラウド事業者の調達コミットメントを欠くプロジェクトは特に脆弱である。
·高帯域幅メモリ(HBM)の価格前提の下方修正は、アクセラレータ支出予測の低下の主な原因の一つである。新モデルにおいても、ビット単位のHBM需要は年々増加している。
·NVIDIAの数量と価格の前提はともに引き下げられた。出荷に対応する演算製品収益で測ると、2027年から2030年の予測はそれぞれ22%、39%、56%、66%下方修正された。
·Broadcomの2026年から2030年のカスタムチップ累計収益予測は11%下方修正され、主にHBM価格の下落によるものである。MediaTekがAnthropic向けに設計したTriggerfishは、ライフサイクル全体の出荷量予測が42%下方修正された。
·AMDの長期支出予測も同様に下方修正されたが、ワラント取引によりMetaとOpenAIに対する魅力が高まった。Amazon Trainiumの2027年と2028年の出荷予測は従来の水準を維持している。
需要予測の調整
われわれは予測期間全体にわたりAIチップとサーバーの出荷量、支出、電力需要の予測を引き下げ、特に2028年から2030年の予測がより大きく影響を受けた。今回の下方修正は三つの調整を反映している。すなわち、出荷量の減少、価格の下落、そして2029年と2030年の将来のアクセラレータプロジェクトにおけるチップ単体消費電力の前提をより低く設定したことである。
全体として、われわれが予測を調整した理由は以下のとおりである。
1、われわれはエコシステム全体のトークン総収益見通しを再評価した。特に各最先端AIラボの第3四半期における純増年換算経常収益(ARR)の減速を考慮したためである。その結果、われわれは最近のレポートで指摘したように、収益が全体の演算コストをより持続的にカバーできるよう、新規供給の推定値を引き下げた。われわれはこれらのラボの収益について依然として市場コンセンサスより楽観的であり、最先端AI能力を展開し高い投資収益を得られる分野を多く見出している。しかし、インフラ建設が融資を得られるかどうかは、資本市場参加者の全体的な見通しに依存しており、それが次の点につながる。
2、資本市場はすでに引き締まっており、債権投資家も株式投資家も、AIインフラ構築に関連する設備投資への出資に一層消極的になっている。特に、ハイパースケーラーによる調達コミットのないプロジェクトでは顕著である。この問題については資金調達フレームワーク報告書で議論した。これにより、データセンターの土地開発、電力関連設備、および本体建築の建設が減少し、影響を受けるプロジェクトはハイパースケーラーの支援を欠くプロジェクトに一層集中する。システムの展開に利用可能な電力もそれに伴って減少する。
3、米国中間選挙の結果により、当初2027年下半期および2028年上半期に稼働予定であった米国のデータセンター容量5.8GWが延期された。規制要因による更なる延期も2028年のデータセンター総容量を押し下げている。我々の分析でもこの要因を考慮しており、それが足元の計算能力設備の出荷量をいくらか減少させたことは確かだが、前述の二つの要因の方がより重要であることを強調する。
引き下げ幅は各チッププラットフォームおよびサプライヤー間で一様ではない。我々の分析フレームワークに従えば、顧客は依然として単位総所有コスト当たりの性能(perf/TCO)および単位消費電力当たりの性能(perf/W)が最も優れたチップを優先的に選択し、その上で資金調達条件を考慮する。これらの指標で最下位に位置するプラットフォームほど、削減幅は大きくなる。その結果、エヌビディアが最も大きな打撃を受け、支出削減の大部分はエヌビディアに集中する。さらに、ASICプロジェクトの中では、聯発科(MediaTek)のTPUプロジェクトも影響を受けると予想する。その資金調達力がブロードコム(Broadcom)よりも弱いためである。下図はアクセラレータおよびHBM関連の総支出の変化をまとめたものである。
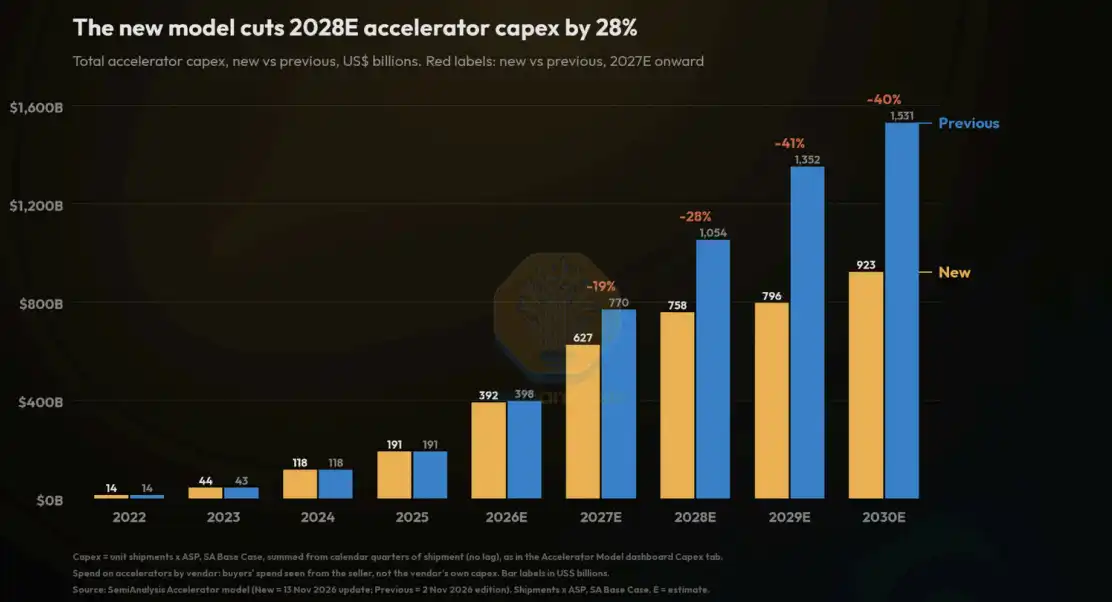
新モデルは2028年のアクセラレータ設備投資予測を28%引き下げる。アクセラレータ設備投資総額、新旧モデル比較、単位は十億ドル。2027年の予測値以降、赤色の数字は新モデルが旧モデルに対して変動したことを示す。黄色が新版、青色が旧版。
総支出の減少は主に価格の下落によってもたらされる。出荷量予測の引き下げに伴い、HBMの需給関係はより均衡するため、HBMの価格仮定も引き下げた。詳細は同時期に発表されたメモリモデル更新を参照されたい。そのため、HBM価格の変化を各チップの予測に織り込み、部品表(BOM)コストの変化を反映させた。Feynman以降のエヌビディアの将来製品については、平均販売価格(ASP)の引き下げが、より低いマークアップ率およびHBMコストの変化も反映している。これはAIハードウェア市場における競争が著しく激化していることを示している。
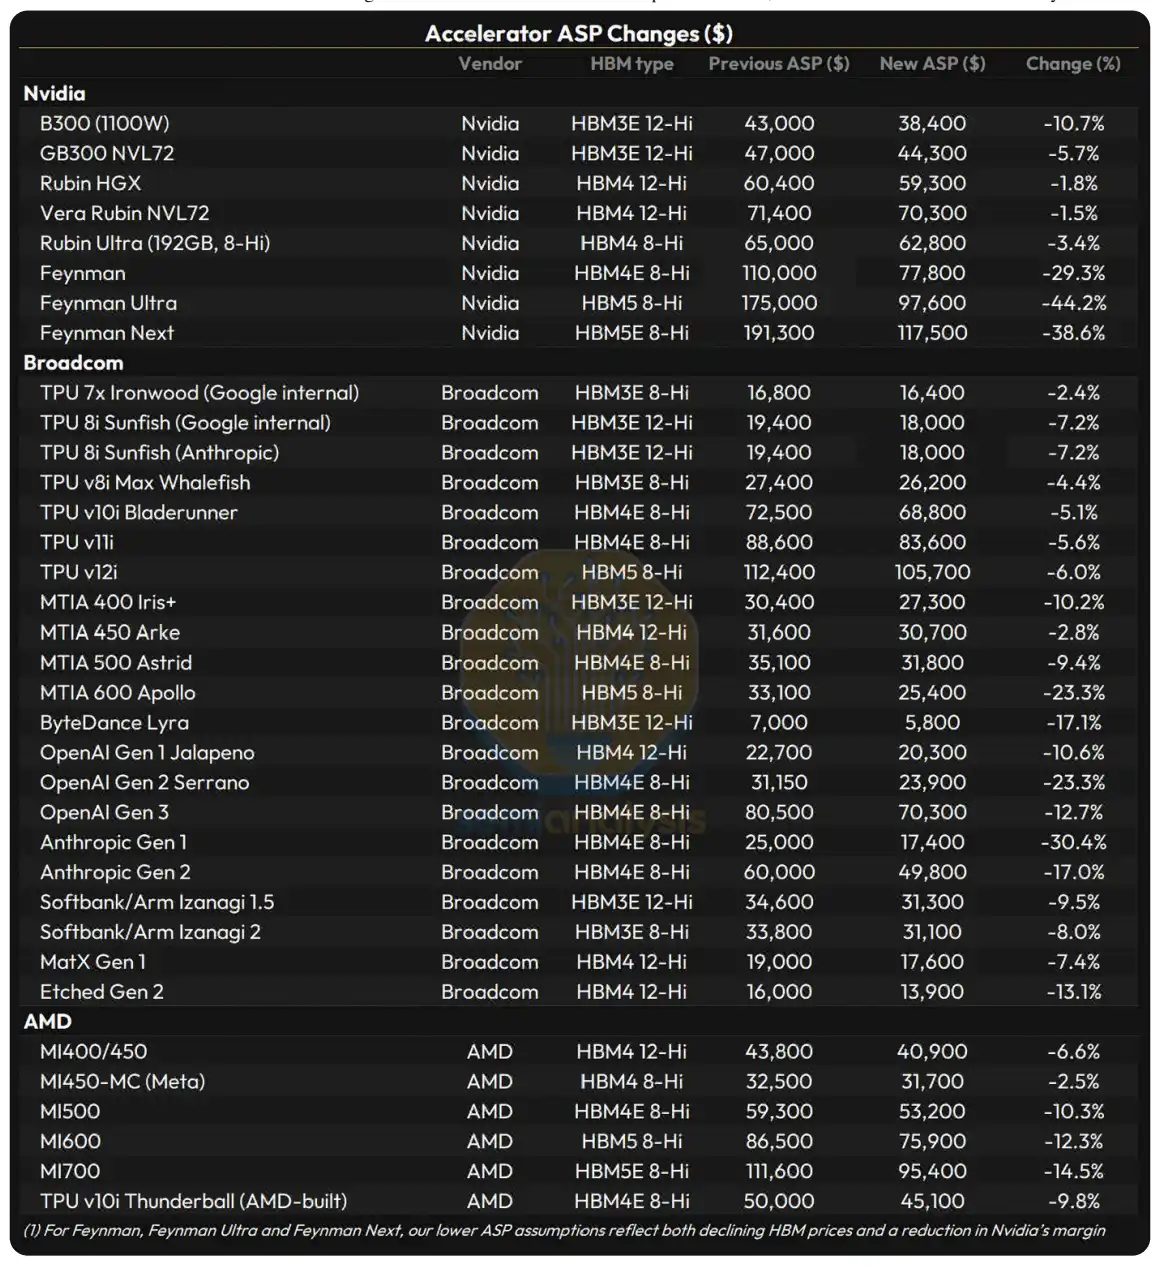
アクセラレータ平均販売価格(ASP)の調整、単位はドル。製品型番、サプライヤー、HBMタイプ、旧モデル平均販売価格、新モデル平均販売価格、変動幅(%)。出所:SemiAnalysis。
以前予測された2027年の支出増加分のうち、かなりの部分が価格上昇、特にメモリ価格の上昇によるものでした。したがって、その後の価格回落は、サプライチェーンがより「正常」な状態に戻ったことを意味します。
価格変化は、出荷に対応するシリコン面積とビット単位のHBM需要が依然として増加しており、かつ名目支出よりも速く成長している理由も説明します。
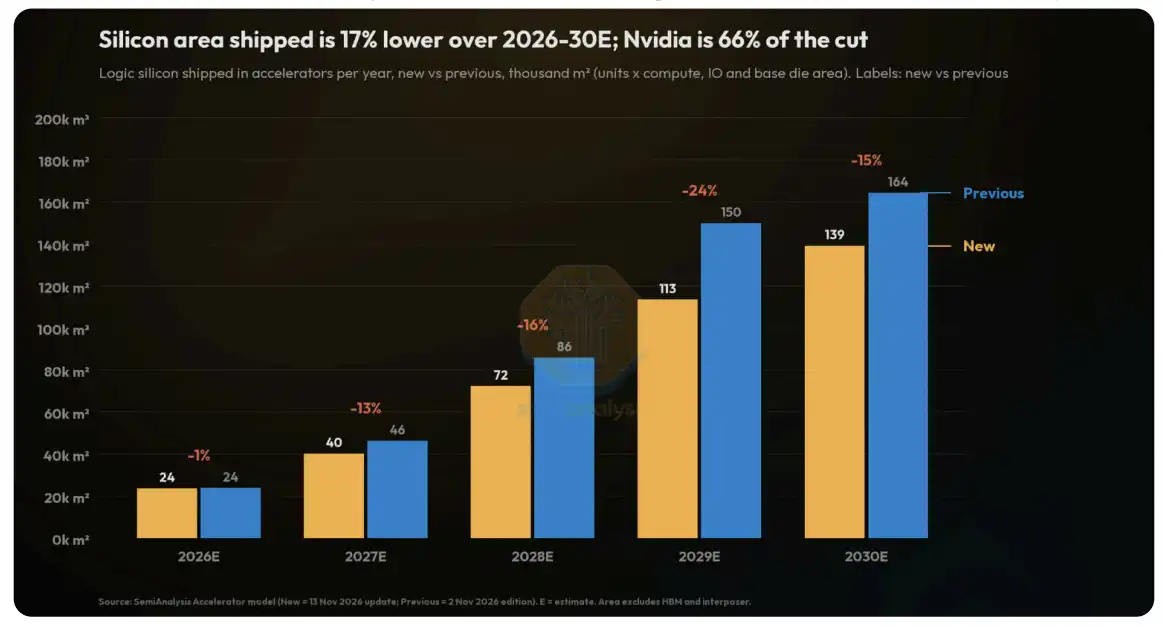
2026年から2030年の予測出荷シリコン面積の合計は17%下方修正され、NVIDIAが下方修正量の66%を占めています。
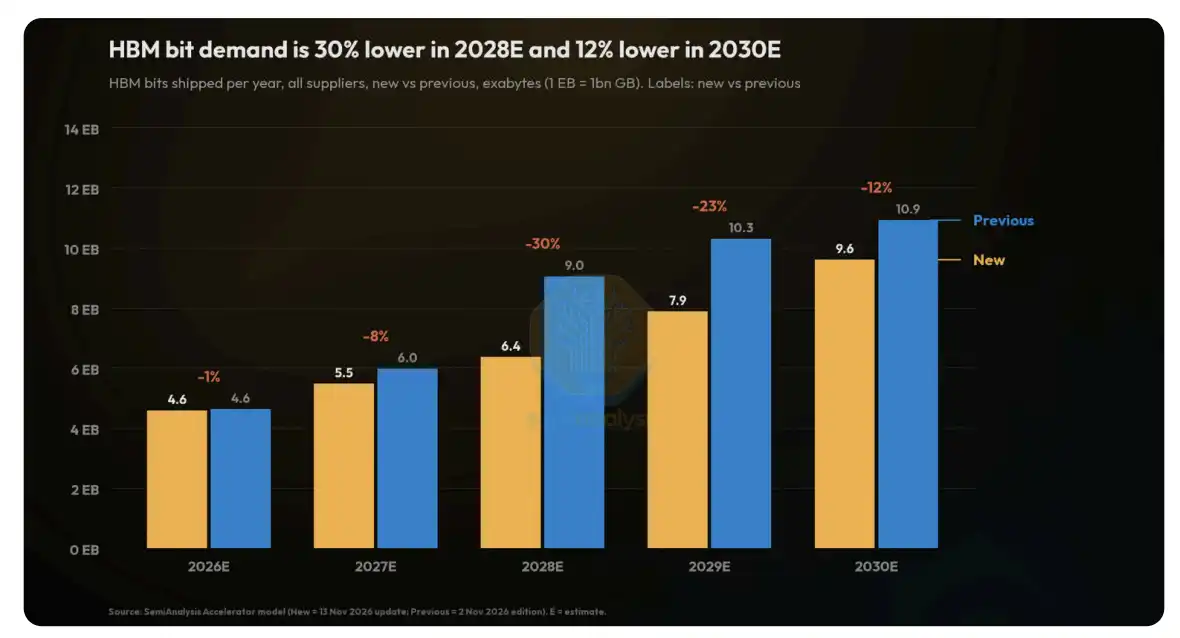
2028年のHBMビット需要予測は30%下方修正され、2030年は12%下方修正されました。
AI電力需要予測も下方修正されました。これは出荷量の減少と単一チップの消費電力仮定の引き下げが相乗的に作用した結果です。電力は依然として制約要因であるため、今後の製品ロードマップではチップの最大消費電力が引き下げられると予想しています。電力需要の低下はまた、当社のデータセンター模型を改訂した後の2027年から2029年の世界(中国を除く)電力供給予測において、これらの出荷機器が展開を完了するのに十分な電力があることを意味します。
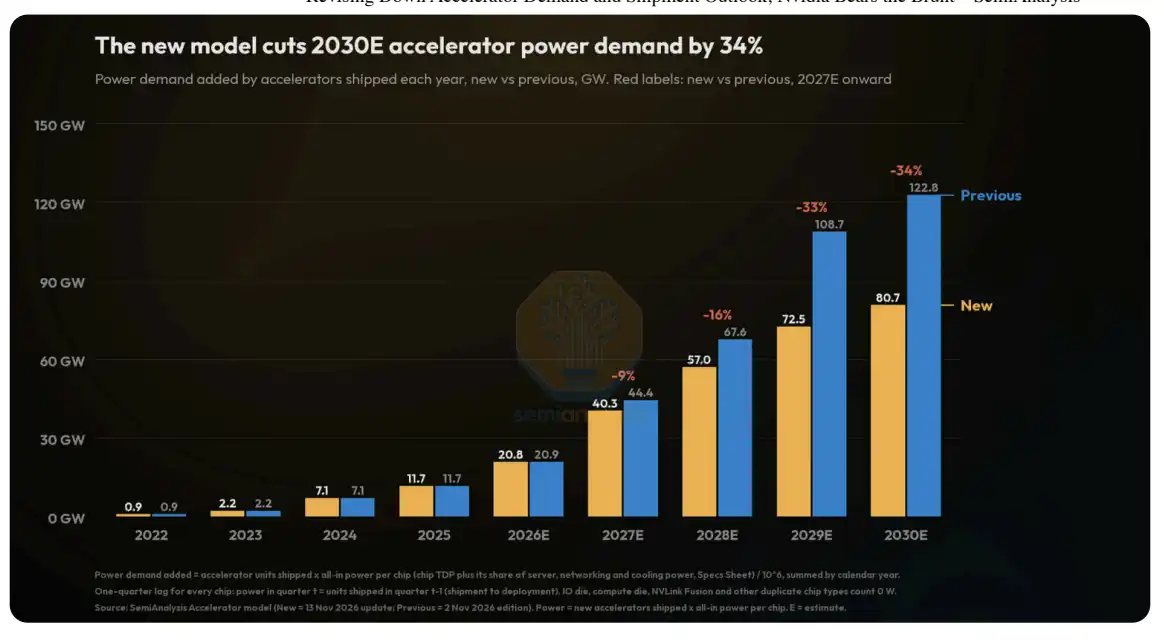
新モデルは2030年のアクセラレータ電力需要予測を34%下方修正しました。
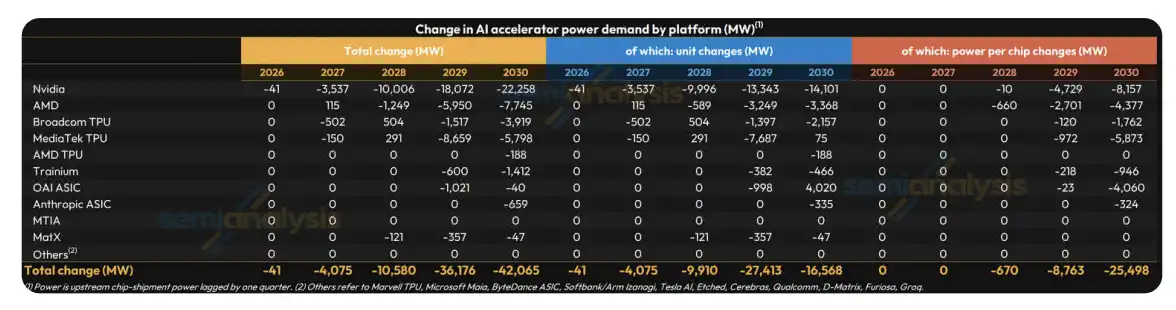
各プラットフォームのAIアクセラレータ電力需要の変動、単位はMW。
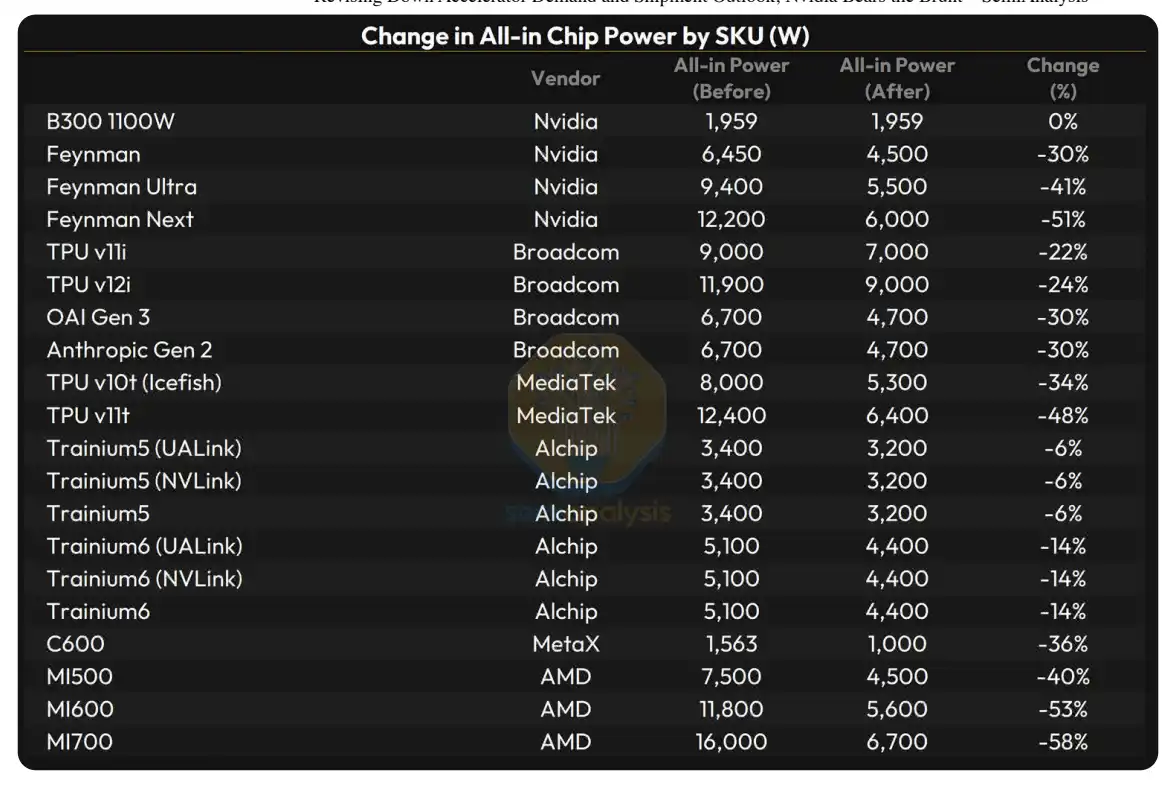
各型番チップの総合消費電力の変動、単位はW。
次に、これらの変化をサプライヤーとプラットフォームごとに順に見ていきます。
NVIDIA
演算製品収入で測ると、NVIDIAの2027年、2028年、2029年、2030年の出荷予測をそれぞれ22%、39%、56%、66%と大幅に下方修正しました。総合消費電力で測ると、それぞれ14%、35%、50%、59%下方修正しました。Feynmanからは、HBMコスト変化を計上するほか、平均販売価格の仮定もさらに引き下げました。なぜなら、NVIDIAは他のプロジェクトに対する競争力を維持するために、より低い利益率を受け入れる必要があると考えているからです。Feynmanの予測販売価格は約11万ドルから約7.8万ドルに、Feynman Ultraは約17.5万ドルから約9.8万ドルに、Feynman Nextは約19.1万ドルから約11.8万ドルに引き下げられました。価格と出荷量の同時下方修正は、NVIDIAの予測収入が大幅に減少することを意味します。下方修正はGPU、Groq LPU、独立CPUに及びます。
当社はNVIDIAの需要を最も大きく下方修正した。最先端AIラボの計算基盤において、NVIDIA GPUの魅力は下位に位置するからだ。Anthropicが使用する4大計算プラットフォーム、すなわちTPU、Trainium、AMD GPU、NVIDIA GPUの中で、NVIDIA GPUの地位は最も周辺的である。単位コスト当たりの性能に関して、Anthropicは他のプラットフォームをより好む。
GPUはOpenAIのインフラでより重要な役割を果たすが、AMDのワラント取引による相当な財務的便益を考慮すると、AMD GPUは非常に魅力的な選択肢となっている。さらに、OpenAIはASICプロジェクトのJalapenoと次世代Serranoを優先的に展開する。これらのチップは単位総所有コスト当たりの性能ですでにリードしているからだ。
さらに、NVIDIAは各サプライヤーの中で新興クラウドサービス事業者(Neocloud)顧客へのエクスポージャーが最大であり、特に規模の小さいロングテール顧客に対してそうである。今日、新興クラウドサービス事業者はプロジェクト実行と資金調達能力の両面ではるかに大きなリスクに直面している。中国のエンド顧客が新興クラウドサービス事業者に約束した計算資源の調達規模も相当なものである。「RASA法案」が法律となる可能性は高まっているようだ。一旦発効すれば、GPUへのリモートアクセスは輸出とみなされ、中国顧客による先進GPUへのリモートアクセスは輸出管理違反を構成することになる。
最後に、今回のモデル調整はジェンスン・フアン氏のNVIDIA CEO辞任の影響を織り込んでいないことを指摘する。たとえフアン氏がCEOを続投しても、当社は同じ調整を行う。NVIDIAに対するフアン氏の重要性を鑑みると、今回の経営陣の交代は市場シェア下落のリスクを高め、下落幅はここに列挙した予測を超える可能性があると考える。
Vera Rubin L6ボードの出荷が第3四半期から第4四半期に延期されたため、当社は2026年第3・第4四半期の予測も調整した。約10万個のRubin GPUを2026年第3四半期から第4四半期に移し、2026年のVera Rubin通年出荷量は約98万個を維持する。GB300は第3四半期に出荷量を約13万個増やし、この穴を埋める。Rubinの立ち上がり加速に伴い、当社は2026年第4四半期の予測でGB300を約26万個、H200を約15万個減らした。これらの調整を総合すると、NVIDIAの2026年第3四半期の総収入は約1,091億ドル、第4四半期は約1,253億ドルとなる。
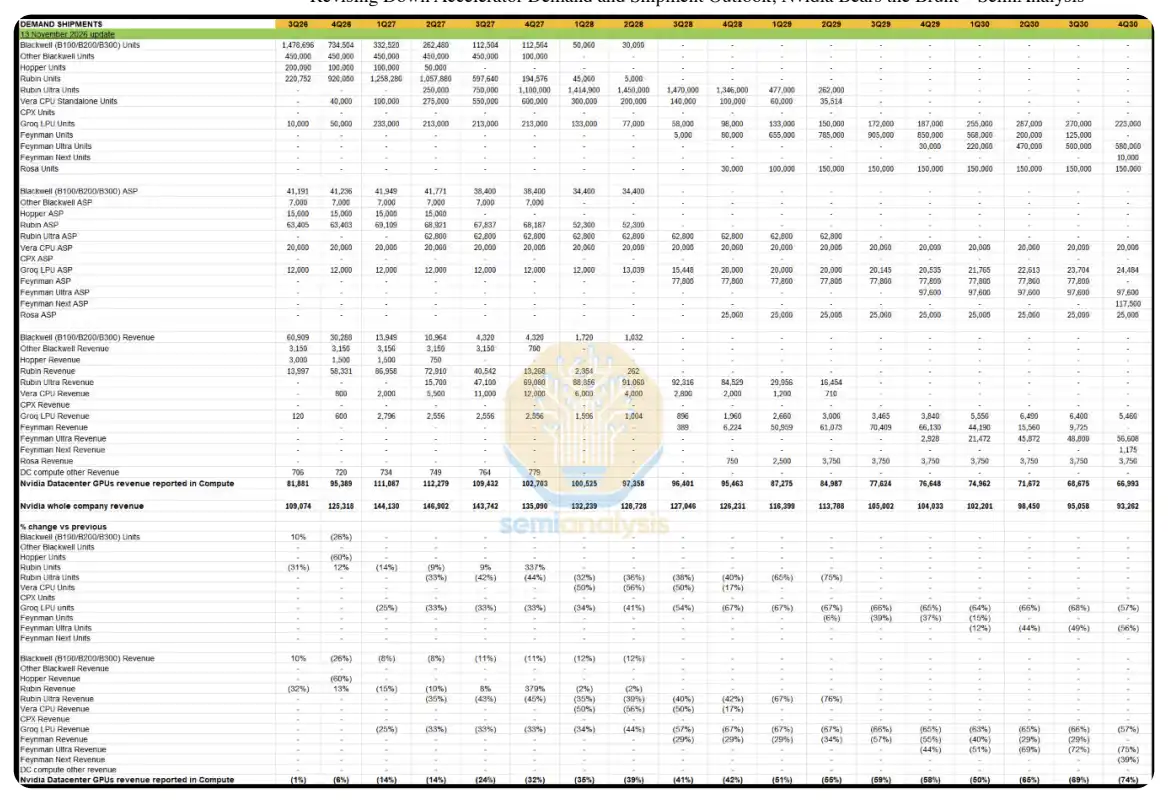
出荷量予測(NVIDIA)。表は2026年11月13日を更新日とし、四半期ごとに各モデルの出荷量、平均販売価格、収入を列示し、さらに前版に対する変動比率を別途列示する。集計項目には計算事業に計上されるNVIDIAデータセンターGPU収入とNVIDIA全社収入を含む。出所:SemiAnalysis。
ブロードコム
ブロードコムの影響は最小で、2026年から2030年のASIC累計収入予測は11%下方修正された。主にHBMコスト低下に伴う平均販売価格の引き下げによるもので、出荷量削減の影響は小さい。当社はブロードコムの需要は低下しないと考える。その3大ASICプロジェクト(TPU、OpenAI、Anthropic)はエンド顧客により高い単位コスト当たり性能と単位消費電力当たり性能を提供でき、同時にブロードコムには債権者向けの資金調達安排を下支えし、土地、電力、主要建物、システムの資金を調達する能力があるからだ。OpenAIに関しては、2029年の第2世代Serranoの予測規模を1GW下方修正し、同時に2030年の第3世代製品の出荷量を大幅に上方修正した。
TPUの出荷量を小幅に下方修正し、GoogleとAnthropicに関わる内容です。テキサス州のデータセンター開発が一時停止すると予想されるため、2027年にAnthropicへ納入予定だった700MWのTPUを2028年に延期しました。当社のデータセンターチームは、Crusoe/Goodnightプロジェクトの約275MWの容量が2027年第4四半期から後ろ倒しになる見込みで、HubbardにあるNexusプロジェクトの別の330MWはまだ承認されておらず、リスクに直面していると予想しています。両プロジェクトはいずれもAnthropicのTPUを展開するために使用されます。
Broadcomで当社がもう一つ予測を下方修正したプロジェクトは、スタートアップのMatXによるものです。MatXは不確実性がより高く、資金調達もより困難だと当社は考えているため、AnthropicによるMatXチップへの需要予測を引き下げました。
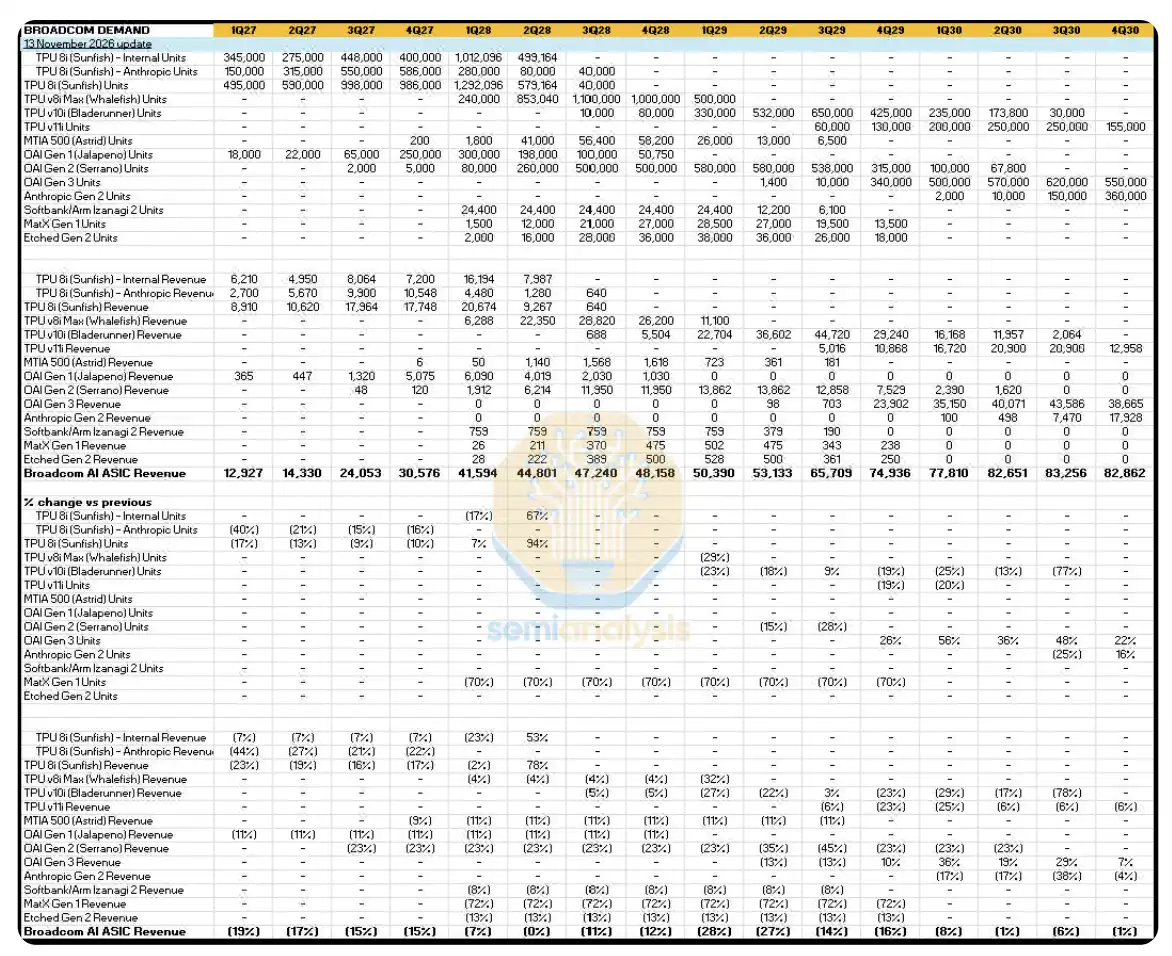
Broadcomの需要。表は2026年11月13日を更新日とし、TPU、OpenAI、Anthropicなどのプロジェクトの出荷量、収入、および前版と比較した変動比率を四半期ごとに示しています。集計項目はBroadcomのAI ASIC収入です。出所:SemiAnalysis。
MediaTek
当社はMediaTekの出荷量をより大きく下方修正しました。
これは、資金調達要因によるAnthropicの需要減少を反映するとともに、TPU全体の需要に対する当社の再調整も反映しています。当社のモデルでは、今後MediaTekがTPU出荷量の大部分を担うことになり、特にGoogle内部で使用されるTPUがその対象となるためです。今回の下方修正後でも、MediaTekの2029年から2030年のTPU出荷量は、BroadcomやAMD/Marvellなど他のパートナーよりも依然として多くなっています。さらに、MediaTekの顧客はHBMを自行調達しているため、HBMの値下がりはMediaTekに影響せず、収入予測の変化は完全に出荷量の下方修正によるものです。
下方修正は主にTPU v9の2製品、HumufishとTriggerfishに集中しています。Humufishの2028年と2029年の全ライフサイクル出荷量を合計47万個下方修正しました。これは主にEMIB-Tの歩留まりが依然としてリスクに直面していることを反映しています。
資金調達の制約が今回の調整の主な原因の一つであることを踏まえ、Broadcomが建設プロジェクト全体に対して資金調達支援を提供する能力がAnthropicにとってより重要だと当社は考えています。そのため、当社が最も大きく下方修正したプロジェクトはTPU v9i(Triggerfish)であり、その全ライフサイクル出荷量を42%下方修正しました。Triggerfishは設計時にAnthropicの意見を参考にしており、当初はMediaTekがAnthropicへ外部販売する初のTPUとなる予定でした。
ただし、MediaTekの全体的な利益率はBroadcomより低いことも認識しており、そのためシステム総コストが低く、資金が制約される状況では魅力的である。これにはGoogleがより多くの資金調達責任を負うか、Anthropicが前払い金を増額する必要がある。
後続のTPU v10t(Icefish)については、2029年の立ち上げペースを鈍化させ、より多くの出荷量を2030年に移した。
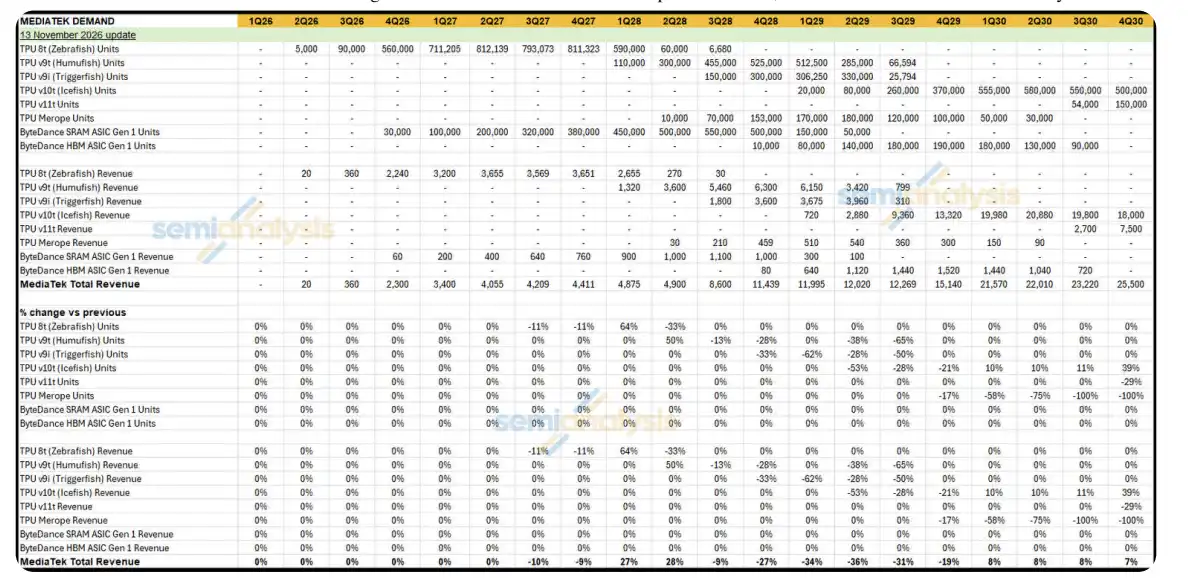
MediaTek需要。表は2026年11月13日を更新日とし、四半期ごとに各型番のTPUおよびByteDanceのASICプロジェクトの出荷量、収入、前版に対する変動比率を列記する。集計項目はMediaTekの総収入。出典:SemiAnalysis。
AMD
総合消費電力ベースで、AMDの2028年、2029年、2030年の予測をそれぞれ23%、55%、57%引き下げ、支出ベースではそれぞれ29%、35%、32%引き下げる。2027年の消費電力予測はほぼ横ばいで、支出予測は11%引き下げる。AMDも公開市場向けに商用チップを販売するサプライヤーに属するが、収入の引き下げ幅はNVIDIAより小さい。AMDはハイパースケーラーや最先端AIラボの顧客へのエクスポージャーがより大きく、これらの顧客にはMeta、OpenAI、Anthropicが含まれるためである。MetaとOpenAIにとって、ワラント取引によりAMDシステムの購入はほぼ迷う必要のない選択となっている。Anthropicにはワラント取引はないが、AMDの価格設定はAnthropicにとっても依然として非常に有利であると考える。推論の単位ドル当たり性能において、AMDはAnthropicにとってTPUに次ぐ魅力を持つ。
さらに、足元については、2026年第4四半期のより力強い生産立ち上げを反映するため、MI400の立ち上げ時期を前倒しする。約2.5万個のMI400と約3万個のMetaカスタム版MI450-MCを2027年第4四半期から2026年第4四半期に移す。
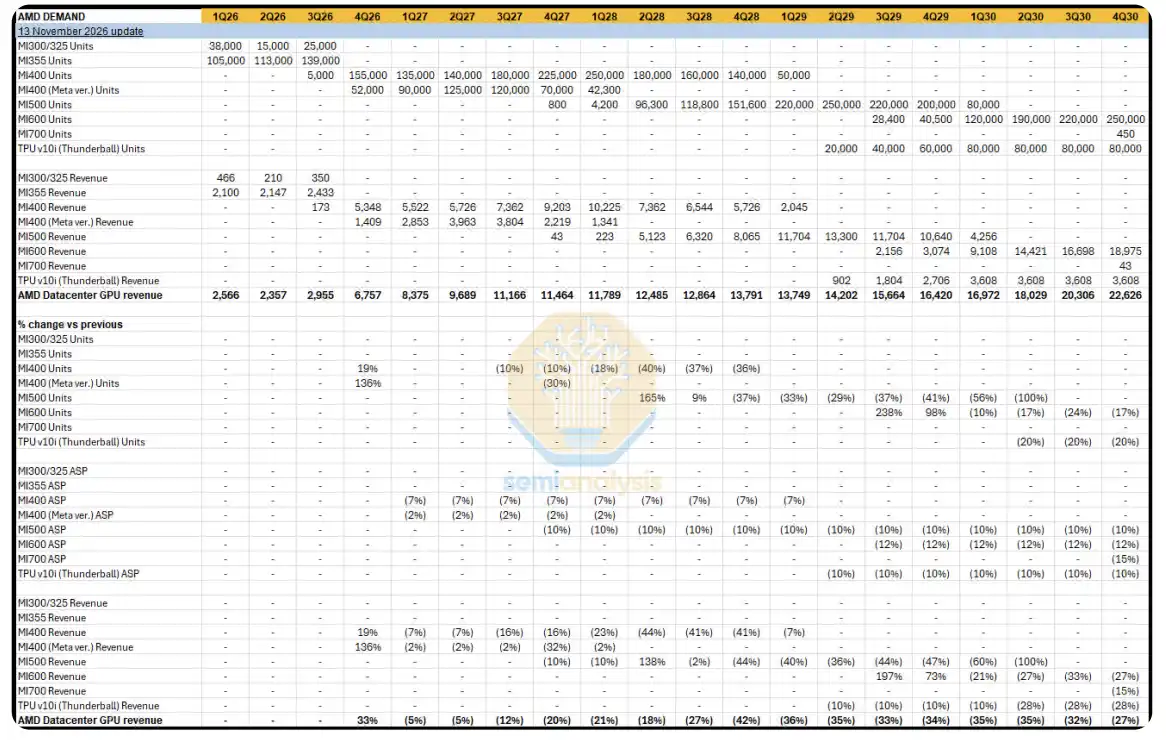
AMD需要。表は2026年11月13日を更新日とし、四半期ごとに各型番の出荷量、収入、前版に対する変動比率を列記し、平均販売価格の変動比率も示す。集計項目はAMDデータセンターGPU収入。出典:SemiAnalysis。
Amazon Trainium
2027年と2028年のTrainiumの出荷予測を維持する。2029年については、Trainium4が担うと見込んでいた出荷量をTrainium5に移し、Trainium5のライフサイクルをさらに2030年まで延長するとともに、Trainium6の立ち上げ規模を引き下げる。Amazonの建設中および準備中のデータセンタープロジェクトのパイプラインは非常に豊富で、ほとんど影響を受けていないため、Trainiumの足元の出荷予測を維持する。さらに、Trainiumの製造コストははるかに低いため、エンド顧客のコストも低い。Amazonはまた、戦略的考慮から、AnthropicやOpenAIなどの重要顧客がTrainiumを使用するプロジェクトに対して補助金を提供することにも意欲的である。
その他の調整
TPU v9i(Whalefish)を TPU v8i Max(Whalefish)に名称変更しました。
「B300 1200W」を「B300 1100W」に名称変更し、それに伴い熱設計電力(TDP)を更新しました。チップの総合消費電力は変更ありません。
ODMモデルにおいて、マイクロソフトの2027年のVera Rubinラック発注数を200台引き下げました。
BlockBeats の公式コミュニティに参加しよう:
Telegram 公式チャンネル:https://t.me/theblockbeats
Telegram 交流グループ:https://t.me/BlockBeats_App
Twitter 公式アカウント:https://twitter.com/BlockBeatsAsia
 関連記事