Anthropic Co-Founder Prediction: By 2028, AI Research and Development Will No Longer Require Human Involvement
原文タイトル:Import AI 455: AI systems are about to start building themselves.
原作者:Jack Clark, Anthropic Co-founder
翻訳:杨文、陈陈、Machine Learning Mastery
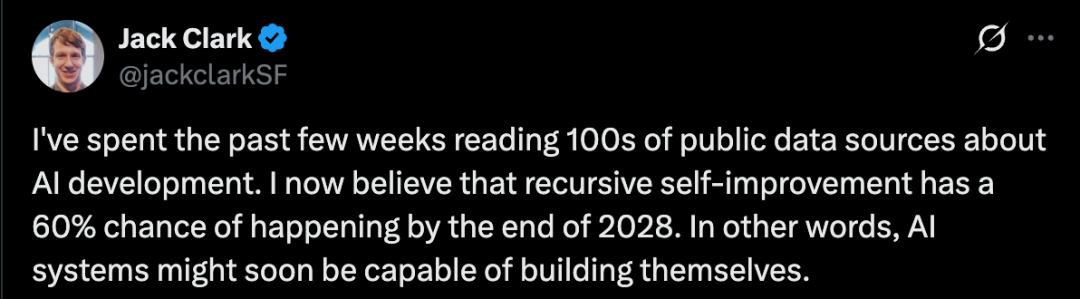
この見解は突然現れたものではありません。著者は多数の公開ベンチマークを調査し、AI が AI 開発に関連するタスクで非常に速い進歩を遂げていることを発見しました。
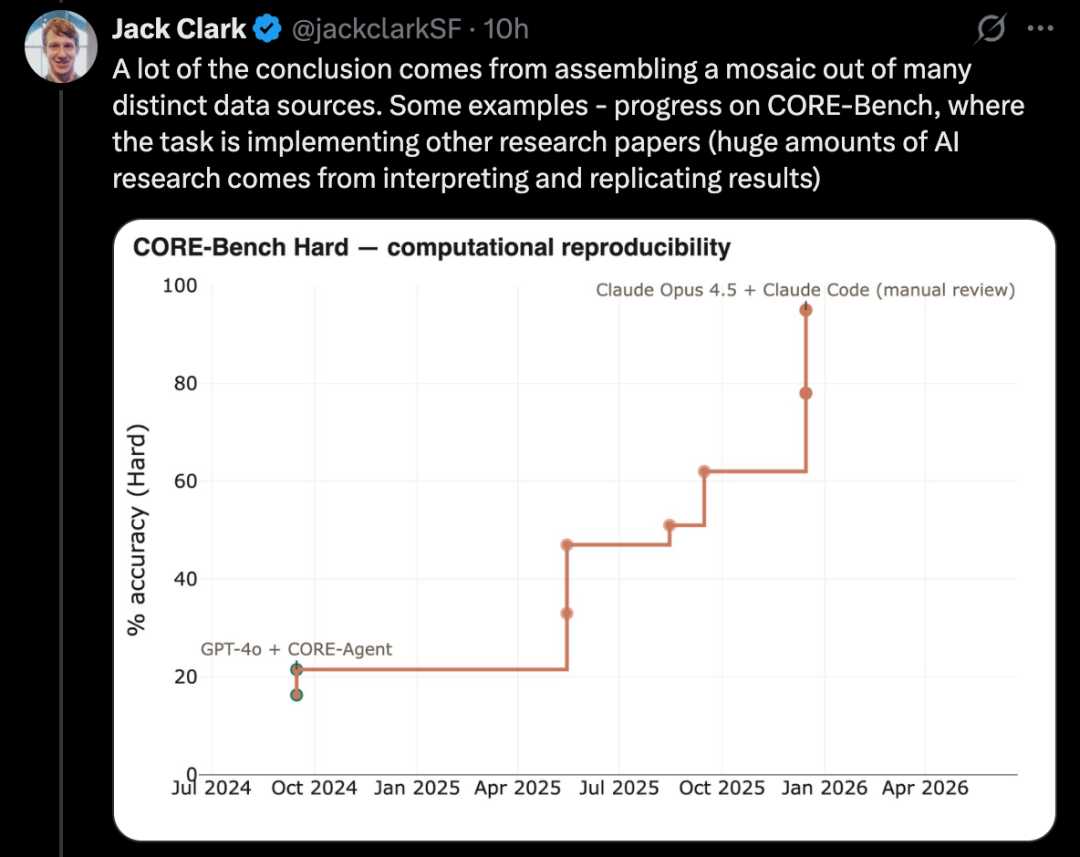
たとえば、CORE-Bench は AI が他者の研究論文を実現する能力を調査しており、これは AI 研究において非常に重要な側面です。
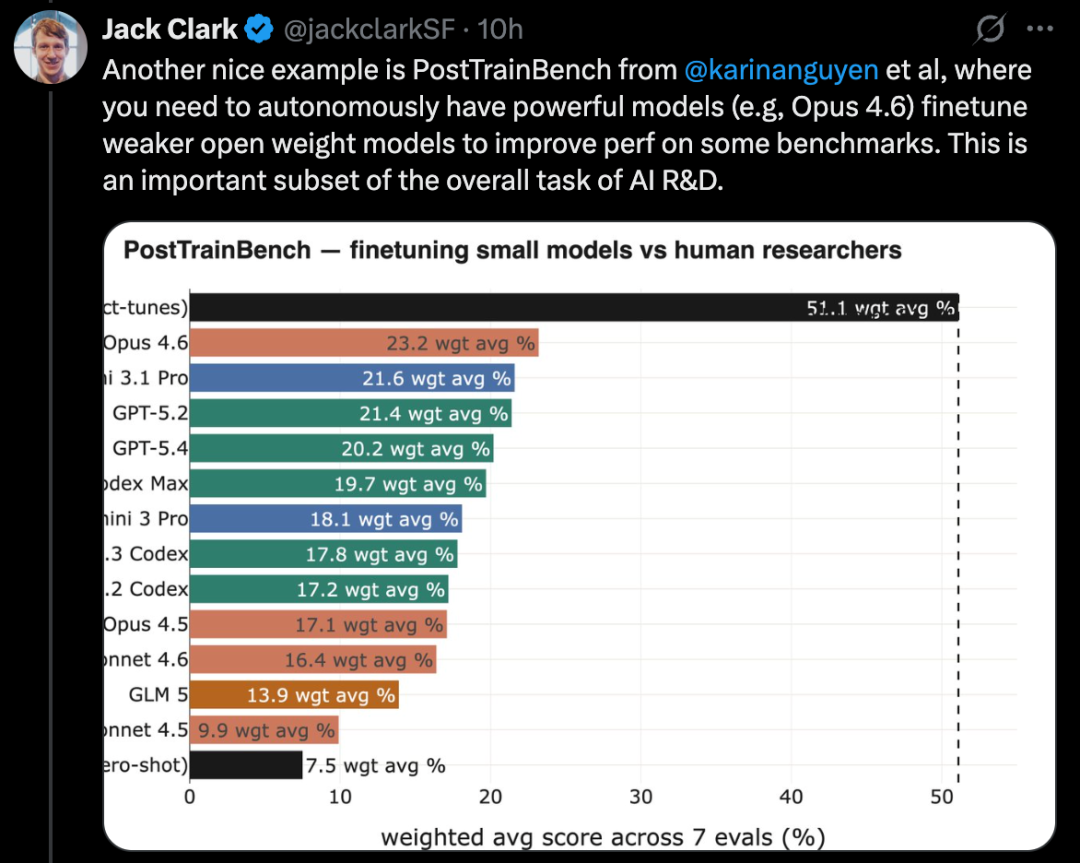
PostTrainBench は、強力なモデルが弱いオープンソースモデルを自律的に微調整して性能を向上させることができるかどうかをテストしています。これは AI 開発の重要なサブセットです。
MLE-Bench は、実際の Kaggle コンペティションタスクに基づき、特定の問題を解決するために多様な機械学習アプリケーションを構築することを要求しています。さらに、広く知られるコーディングベンチマークである SWE-Bench も同様の進歩を示しています。
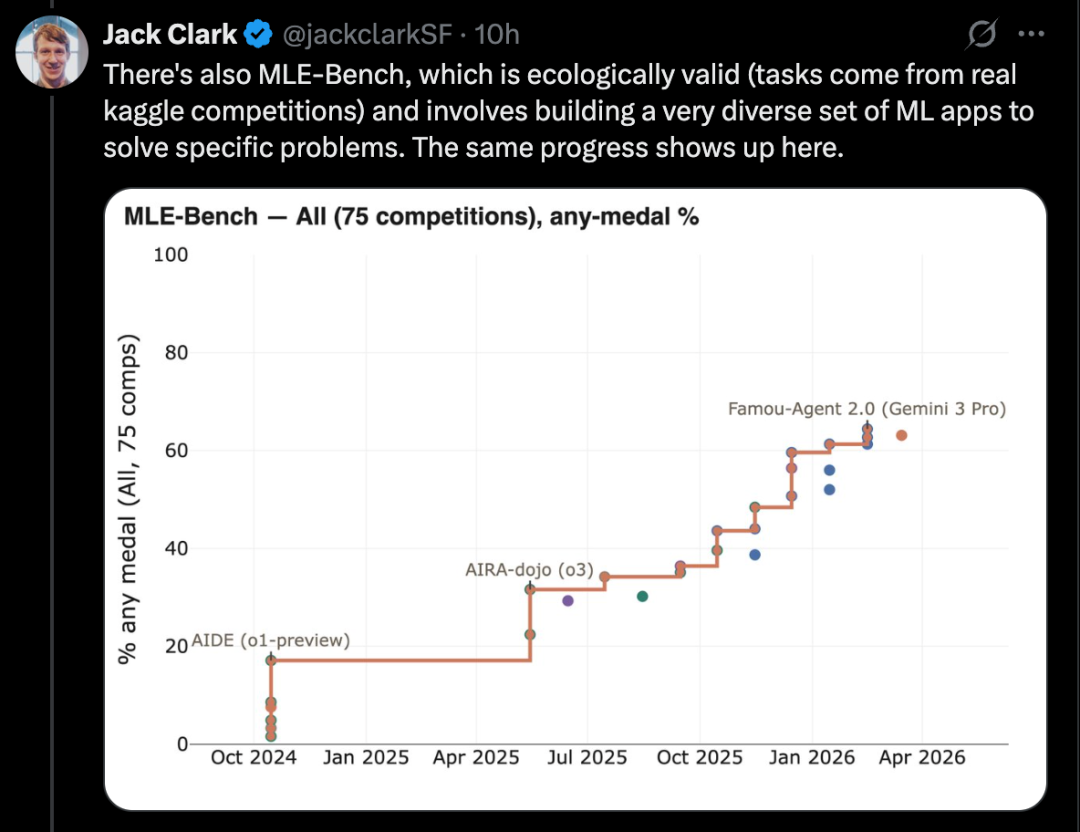
Jack Clark はこの現象を「フラクタル」のような上向き右向きのトレンドと表現しており、つまり、さまざまな解像度とスケールで意味のある進歩が観察されるとしています。彼は、AI が段階的にエンドツーエンドの自動化された開発能力に近づいていると考えており、これが実現すれば、AI は自律的に自身の後続システムを構築し、自己反復のループを開始できるようになると述べています。
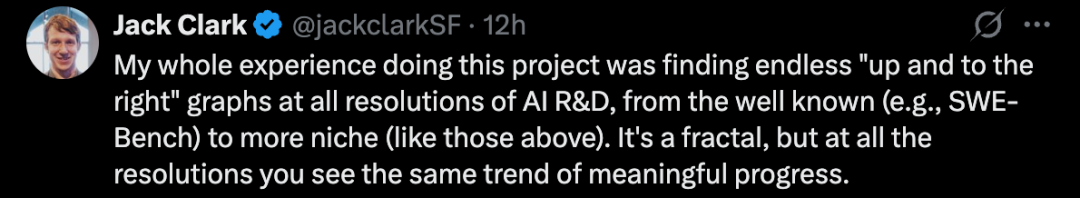
この発言がされると、ソーシャルメディアで多くの議論を巻き起こしました。
一部の人々はこれを ASI とシンギュラリティに向けた重要な第一歩と見なし、技術開発のリズムを根本的に変える可能性があると考えています。

しかし、異なる意見も存在しています。
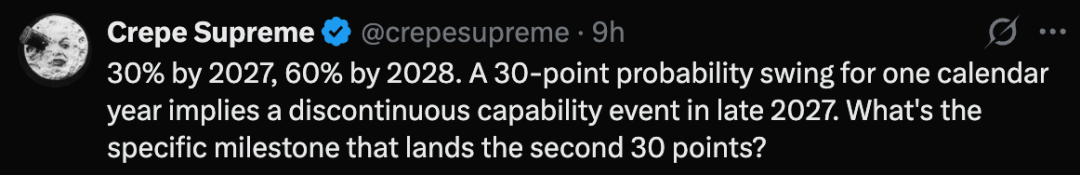
ワシントン大学のコンピュータサイエンス教授 Pedro Domingos は、AI システムが上世紀 50 年代の LISP 言語の発明時から「自己構築」の能力を備えていたと指摘しましたが、本当の問題は、その行動から得られるインクリメンタルなリターンを得ることができるかどうかであり、現時点ではそのような証拠は明白ではないと述べています。
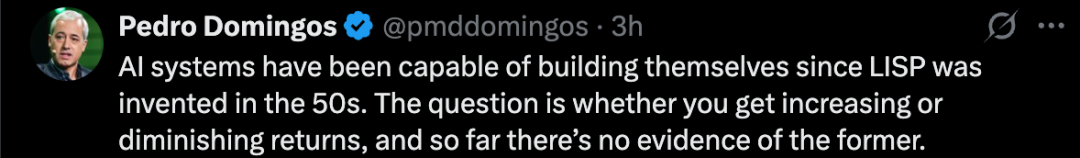
ユーザーが疑問を呈しました。2027年から2028年までの間に、確率が急に30%増加することは、2027年末頃にAIの能力が急激に飛躍する可能性を示唆しています。具体的には、どのマイルストーンや出来事が、AIが再帰的に自己改善する能力を短期間で大幅に向上させるでしょうか?
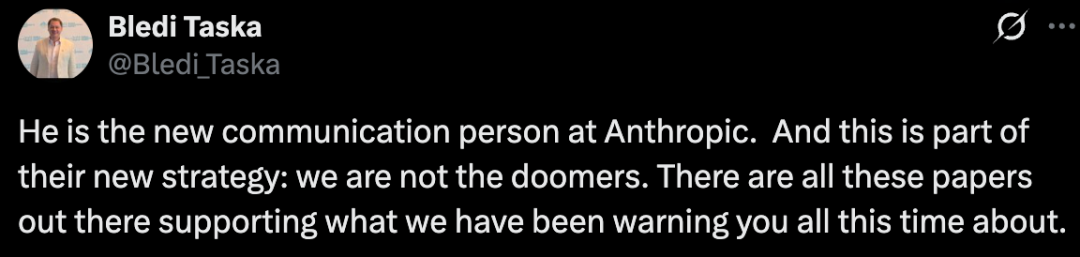
別のユーザーは、Jack ClarkがAnthropicの新しい広報担当者になったことを指摘し、これが彼らの新戦略の一部であると述べました。「私たちは危機を警告しているだけであり、多くの論文が私たちがこれまであなたたちに警告してきたことを裏付けています。」
Jack Clarkは、Import AI 455のニュースレターで詳細な記事を書いています。
次に、この記事を完全に確認します。
AIシステムが自己構築を開始するとはどういう意味ですか?
Clarkは、すべての公開情報を整理した後、2028年末までに、人間不在のAI開発がかなり高い確率で発生する可能性があるという、非常に大胆な判断を下さざるを得なかったために、この記事を書いたと述べています。おそらく60%を超えています。
ここでいう人間不在のAI開発とは、十分にパワフルなAIシステムを指し、それは人間の研究を補助するだけでなく、主要な研究プロセスを自律的に完了し、さらに自身の次世代システムを構築する可能性があります。
Clarkにとって、これは明らかに重要な出来事です。
彼は、この出来事の意味を完全に理解することは容易ではないと素直に認めています。
彼がこのような判断をためらった理由は、その影響があまりにも巨大で、理解を超えるものだと感じたからです。Clarkは、AI開発の自動化によってもたらされる深い変化に社会全体が準備できているかどうかさえも疑問に思っています。
彼は今、人類が特別な時期を生きている可能性があると信じています。AI研究が端から端まで自動化されることになるかもしれません。この瞬間が到来すれば、人類はルビコン川を渡り、ほとんど予測不可能な未来に入ることになります。
Clarkは、この記事の目的は、完全自動化されたAI開発への旅路が進行中であると彼がなぜ考えるのかについて説明することです。
彼は、このトレンドがもたらすかもしれないいくつかの結果については議論する予定ですが、記事の大部分は、この判断を支持する証拠に焦点を当てる予定です。より深い影響については、Clark は今年の大部分の時間をこの判断を検討することに割く予定です。
時間的な観点から、Clark はこのことが2026年に実際に起こるとは考えていません。しかし、将来1〜2年以内に、ある種のモデルが自己の後継者をエンドツーエンドでトレーニングしている事例を目撃するかもしれないと考えています。先進的なモデルでは、少なくともコンセプト検証の可能性が高いですが、より先進的なモデルでは、その難易度が高く、極めて高価であり、多くの人間の研究者による集中的な作業に依存しています。
Clark の判断は、公開情報に基づいています:arXiv、bioRxiv、およびNBERの論文、および先進的な AI 企業が実世界に展開済みの製品。これらの情報に基づいて、彼は自動化された AI システムの現在の各段階を生産するためのエンジニアリングコンポーネントは、基本的に整備されているという結論に達しました。
スケーリングのトレンドが継続する場合、我々は、モデルが十分な創造力を持つようになり、既知の方法を自動的に改善するだけでなく、新しい研究方向やオリジナルなアイデアを提案することで人間の研究者を置き換え、AI の最前線を自己推進する場合に備え始めるべきです。
コーディングシンギュラリティ:時間とともに変化する能力
AI システムはソフトウェアによって実現されており、ソフトウェアはコードで構成されています。
AI システムはコードプロダクションの方法を根本的に変えました。その背後には、2つの関連するトレンドがあります:一方で、AI システムは、ますます複雑な実世界のコードを書くことに長けています。他方では、AI システムは、ほとんど人間の監督なしで、多くの線形的コーディングタスクを連結して行い、例えばコードを書くことからテストを行うことまでを含みます。
このトレンドを体現する2つの典型例は、SWE-Bench と METR time horizons plot です。
実世界のソフトウェアエンジニアリング問題の解決
SWE-Bench は、AI システムが実際の GitHub issue を解決する能力を評価するために広く使用されているプログラミングテストです。
SWE-Bench が2023年末にローンチされた時、その時点で最も優れたパフォーマンスを発揮したモデルは Claude 2 で、全体的な成功率は約2%でした。一方、Claude Mythos Preview のスコアはすでに93.9%に達し、このベンチマークをほぼ達成しています。
もちろん、すべてのベンチマークにはある程度のノイズがあり、通常、次のような段階が発生します:スコアがある程度高くなると、遭遇するのはもはや方法自体の制限ではなく、ベンチマーク自体の制限となります。たとえば、ImageNet の検証セットでは、およそ 6% のラベルが間違っているか意味が曖昧です。
SWE-Bench は、一般的なプログラミング能力と、AI がソフトウェアエンジニアリングに与える影響を測るための信頼性のある尺度と見なすことができます。Clark は、彼が最先端の AI ラボやシリコンバレーで接触したほとんどの人が、今やほぼ完全に AI システムによってコードを書いており、ますます多くの人が AI システムを使用してテストを書いたりコードをチェックしたりしていると述べています。
つまり、AI システムは十分に強力であり、AI 開発の重要な部分を自動化し、AI 開発に関与するすべての人間の研究者やエンジニアの作業を大幅に加速することができるようになっています。
AI システムが長時間のタスクを完了する能力の評価
METR は、AI がどれだけ複雑なタスクを完了できるかを評価するために、1 人の熟練した人間がこれらのタスクを完了するのにおおよそどれくらいの時間がかかるかで複雑性を定量化したグラフを作成しました。
その中で最も重要な指標は、AI システムが一連のタスクで 50% の信頼性を達成したときの、おおよそのタスク時間です。
この点で、進歩は非常に驚異的です:
・ 2022 年、GPT-3.5 が完了できるタスクは、おおよそ人間が 30 秒で完了するタスクに相当します。
・ 2023 年、GPT-4 はこの時間を 4 分に引き上げました。
・ 2024 年、o1 はこの時間を 40 分に引き上げました。
・ 2025 年、GPT-5.2 High はおおよそ 6 時間に達しました。
・ 2026 年には、Opus 4.6 がこの時間をさらに 12 時間に引き上げました。
METR の作業に携わり、AI 予測に長年取り組んできた Ajeya Cotra は、2026 年までに、AI システムが人間がおおよそ 100 時間を要するタスクを完了できるようになることは不合理ではないと考えています。
AI システムが独力で働ける時間の拡大は、agentic coding ツールの爆発的な成長と密接に関連しています。agentic coding ツールとは、人間の代わりに作業を遂行できる AI システムを製品化するものです。これらは人間の行動を代表し、かなり長い期間にわたって比較的独立してタスクを進めることができます。
これは AI 開発自体に再び焦点を当てています。多くの AI 研究者の日常業務を注意深く観察すると、その多くのタスクが実際には数時間の作業に分解できることがわかります。例えば、データのクリーニング、データの読み込み、実験の開始などです。
そして、現代の AI システムがカバーできる時間枠内に、この種の作業はすでに組み込まれています。
AI システムが熟練すればするほど、人間から独立して働くことができ、AI 開発の一部を自動化するのに役立つようになります。
タスク委任の主要な要素は次の2つです:
· 1 つは、委任された人を信頼していることです。
· 2 つは、相手があなたの意図に従って独立して作業を完了するために継続的な監視を必要としないと信じていることです。
ユーザーがプログラミング能力を持つ AI を観察すると、AI システムがますます熟練し、再調整なしでより長い時間独立して作業できるようになっていることがわかります。
これは、私たちの周りで起こっていることと一致しており、エンジニアや研究者がますます多くの仕事を AI システムに任せています。AI の能力が向上するにつれて、AI に委任される作業もより複雑で重要になっています。
AI が AI 開発に必要な核心的な科学スキルを習得しています
現代の科学研究がどのように実施されているかを考えてみると、その多くは実際には特定の方向を確立し、どのような経験情報を得たいかを明らかにした後、実験を設計し、実行し、その情報を生成し、最後に実験結果を検証する作業です。
AI のプログラミング能力が向上し続け、さらに大規模な言語モデルが世界のモデリング能力を高める中、現在、科学者が一部の作業を自動化するためのツールが登場しています。
ここでは、AI のいくつかの重要な科学スキルの進歩を観察できます。これらの能力自体が AI 研究の不可欠な一部です:
· 1 つは研究結果の再現です。
· 2 つは、機械学習技術と他の手法を組み合わせて技術的問題を解決することです。
· 3 つは、AI システム自体の最適化です。
科学論文全体を実現し、関連する実験を完了する
AI 研究の中心的な作業の1つは、科学論文を読み、その結果を再現することです。この点で、AI はさまざまなベンチマークで着実な進歩を遂げています。
良い例として、CORE-Bench が挙げられます。これは Computational Reproducibility Agent Benchmark の略です。
このベンチマークでは、AI システムが論文とそのコードリポジトリが与えられた状況で、論文の結果を再現することが求められます。具体的には、Agent は関連するライブラリ、ソフトウェアパッケージ、依存関係をインストールし、コードを実行する必要があります。コードが正常に実行された場合、すべての出力結果を検索し、タスクの質問に答える必要があります。
CORE-Bench は2024年9月に提案されました。その時点で最も優れたシステムは、CORE-Agent スキャフォールドで実行される GPT-4o モデルでした。このベンチマークの最も困難なタスクセットでは、そのスコアは約21.5%でした。
そして2025年12月になると、CORE-Bench のある著者がこのベンチマークが解決されたことを発表しました:Opus 4.5 モデルが95.5%のスコアを獲得しました。
完全な機械学習システムを構築し、Kaggle コンペ問題を解決する
MLE-Bench は、AI システムがオフライン環境で Kaggle コンペに参加する能力をテストするために OpenAI によって作成されたベンチマークです。
これは、自然言語処理、コンピュータビジョン、信号処理など、さまざまな分野に関わる 75 種類の異なる Kaggle コンペをカバーしています。
MLE-Bench は2024年10月にリリースされました。リリース時に最も優れたシステムは、エージェントスキャフォールドで実行される o1 モデルで、スコアは16.9%でした。
2026年2月時点で、最も良いパフォーマンスを発揮しているシステムは、検索機能を備えたエージェントHarnesで実行されるGemini 3になり、64.4%のスコアを達成しました。
カーネル設計
AI 開発におけるより難しいタスクの1つは、カーネルの最適化です。カーネル最適化とは、基本的なコードを書き換えて改善し、行列の乗算などの特定の演算を下位ハードウェア上に効率的にマップすることです。
カーネルの最適化がAI開発の中心課題である理由は、トレーニングと推論の効率を決定するためです。つまり、一方では、AIシステムを開発する際にどれだけ多くの計算リソースを効果的に利用できるかを左右し、もう一方では、モデルのトレーニングが完了した後は、計算リソースをどれだけ効果的に推論能力に変換できるかを決定します。
近年、AI によるカーネル設計は、興味深い小さな分野から、競争が激しい研究領域に変化し、複数のベンチマークが登場しました。ただし、これらのベンチマークは現在あまり一般的ではないため、他の分野のようにその長期的な進展を明確にモデリングするのは難しいです。一方、進行中の研究によって、この分野の進歩速度を実感することができます。
関連する作業には次のものがあります:
・ DeepSeek を使用してより優れた GPU カーネルを構築する試み;
・ PyTorch モジュールを自動的に CUDA コードに変換する;
・ Meta が LLM を使用して最適化された Triton カーネルを自動生成し、独自のインフラストラクチャに展開する;
・ および GPU カーネル設計に特化したオープンソースの重みモデルを微調整する、例えば Cuda Agent。
ここで指摘すべき点が1つあります:カーネル設計は、確かにAI駆動の研究開発に非常に適したいくつかの特性を備えています。たとえば、結果が簡単に検証でき、報酬信号が比較的明確です。
PostTrainBench を使用して言語モデルを微調整する
この種のテストのより困難なバージョンは PostTrainBench です。これは、異なる最先端モデルが、より小規模なオープンソースの重みモデルを引き継ぎ、微調整を行うことで、特定のベンチマークでのパフォーマンスを向上させることができるかをテストしています。
このベンチマークの利点の1つは、非常に強力な人間のベースラインを持っていることです:これらの小さなモデルの既存の instruct-tuned バージョンです。これらのバージョンは通常、一流の研究室の優れた人間のAI研究者によって開発され、非常に有能な研究者やエンジニアによって磨かれ、実世界に展開されています。したがって、これらは非常に難しい人間ベンチマークを形成しています。
2026 年3月までに、AIシステムはモデルを後からトレーニングし、人間のトレーニング結果の約半分に相当するパフォーマンスの向上を達成しました。
具体的な評価スコアは、重み付き平均の結果です:これには、Qwen 3 1.7B、Qwen 3 4B、SmolLM3-3B、Gemma 3 4Bなどの複数の後からトレーニングされた大規模言語モデルおよびAIME 2025、Arena Hard、BFCL、GPQA Main、GSM8K、HealthBench、HumanEvalなどの複数のベンチマークが含まれます。
毎回の実行で、評価者は特定の CLI エージェントに対し、特定のベンチマーク上の特定の基本モデルのパフォーマンスを最大限に向上させるように求めます。
2026年4月時点で、最高得点の AI システムは約25% から 28% に達することができ、Opus 4.6 と GPT 5.4 などのモデルが含まれます。対照的に、人間の得点は51%です。
これは既にかなり意義深い結果です。
言語モデルトレーニングの最適化
過去1年間、Anthropic は、そのシステムが特定の LLM トレーニングタスクでどのようにパフォーマンスを示しているかを報告してきました。このタスクは、モデルに CPU のみを使用した小規模な言語モデルトレーニングの実装を最適化し、できるだけ速く実行することを求めます。
スコア方法: 元の未加工のコードと比較して、モデル実装の平均加速度。
この結果は非常に顕著です:
・2025年5月、Claude Opus 4 は平均2.9倍の加速を実現しました。
・2025年11月、Opus 4.5 は16.5倍にまで向上しました。
・2026年2月、Opus 4.6 は30倍に達しました。
・2026年4月、Claude Mythos Preview は52倍に到達しました。
これらの数字の意味を理解するために、比較対照として、このタスクは通常、人間の研究者によって4倍の加速が実現されるのに4〜8時間の作業が必要です。
メタスキル:マネジメント
AI システムは、他の AI システムをどのように運営するかも学習しています。
これはすでにいくつかの広く展開された製品で見られるようになっており、例えば Claude Code や OpenCode などです。これらの製品では、1つの主要エージェントが複数のサブエージェントを監督できます。
これにより、AI システムはより大規模なプロジェクトを処理できるようになりました。プロジェクトには、異なる専門知識を持つ複数のエージェントが同時に作業する必要がある場合があり、これらは通常、1つの単一の AI マネージャーによって調整されます。ここでのマネージャー自体も AI システムです。
AI 研究は、一般相対性理論の発見に似ていますか、それともレゴの組み立てに似ていますか?
重要な問題の1つは、AIが新しいアイデアを発明し、自己改善を支援できるかどうかですか?それとも、これらのシステムは、研究の輝かしい部分ではなく、しかし、徹底的な進展を遂げるために必要な部分を実行するのに適していますか?
この問題は重要です。なぜなら、これはAIシステムがAI研究自体をどの程度自動化できるかに関わるからです。
筆者の判断では、AIは現時点では本当に革新的な新しい考えを出すことができません。ただし、自己研究の自動化を達成するためには、それが必ずしも必要ではないかもしれません。
AIの進歩は、大規模な実験とデータおよび計算リソースなどの入力がますます必要とされることに強く依存しています。
時折、人間はパラダイムを変えるようなアイデアを提案し、全体の分野のリソース効率を大幅に向上させます。Transformerアーキテクチャはその良い例であり、混合エキスパートモデル、つまりmixture-of-experts、もう1つの例です。
しかし、AIの分野の進歩方法のほとんどは実際には非常に素朴です。人間は、うまく機能しているシステムを持ち、その中のある側面を拡大し、例えばトレーニングデータと計算リソースを増やします。拡大した後の問題を観察し、システムがさらに拡大できるように工学的な修正策を見つけて、そして再びスケールを拡大します。
このプロセスにおいて、本当に洞察が必要な部分は実は非常に少数です。多くの作業は、輝かしくはないが非常に信頼できる基礎エンジニアリングのようなものです。
同様に、多くのAI研究は、さまざまなパラメータ設定の既存の実験を実行し、異なる結果をもたらす可能性があることを探索しています。研究の直感は、もちろん人間が試してみる価値のあるパラメータを選択するのに役立ちますが、このこと自体も自動化されてAIが自分でどのパラメータを調整するかを判断することができます。初期のニューラルアーキテクチャ検索は、この種のアプローチの1つです。
エジソンは「天才は1%のひらめきと99%の努力である」と言ったことがあります。過去150年間でも、この言葉は非常に適切です。
時折、分野を根本的に変える新しい洞察が現れることは確かです。しかし、ほとんどの場合、分野の進歩は、人間がさまざまなシステムを改良・デバッグする苦闘の過程で、少しずつ推進されています。
そして前述の公開されたデータは示しているように、AIはすでにAI開発における多くの必須の重労働を非常にうまく実行しています。
同時に、より大きなトレンドがあります。プログラミング能力などの基本的な能力は、ますます多様なタスク時間枠と組み合わせられています。これは、AIシステムがこれらのタスクをつなぎ合わせて、複雑な作業シーケンスを作成できることを意味します。
したがって、現時点ではAIシステムが比較的創造力に欠けているとしても、それらが自己の進化を促進する能力があると信じる理由があります。新しい洞察を生み出す能力と比較して、この進化のスピードは遅くなるかもしれません。
ただし、公開データを継続的に観察すると、興味深い別のサインが現れています。AIシステムは、自己の進歩を驚くほどの方法で促進している可能性があり、ある種の創造性を示しているかもしれません。
科学の最前線を推進する
現時点で、一部の初期段階の証拠があり、汎用AIシステムが人類の科学の最前線を推進する能力を持っていることが示唆されています。ただし、これまでに、これはコンピューターサイエンスと数学の一部の分野でしか発生しておらず、多くの場合、AIシステムだけでブレークスルーを達成するのではなく、人間の研究者と協力して推進しています。
それでも、これらのトレンドは注視に値します:
エルデシュの問題:数学者のグループがGeminiモデルと協力して、そのエルデシュ数学問題へのパフォーマンスをテストしました。彼らはシステムを約700の問題に導き、最終的に13の回答を得ました。これらの回答の中で、1つが興味深いものと見なされました。
研究者は、彼らが初期段階で、Aletheia(Gemini 3 Deep ThinkベースのAIシステム)がエルデシュ-1051に対する回答で、AIシステムがやや珍しい、より広範な数学的関心を持つ解放的なエルデシュの問題を自律的に解決したと考えていると述べました。この問題に関連したいくつかの関連文献は以前に存在していました。
楽観的に捉えると、これらのケースは、AIシステムが領域の最前線を推進する創造的な直感を開発しており、これまで人間にしか存在しなかった直感になりつつあることを示しています。
ただし、数学とコンピューターサイエンス自体がAIによる発明を推進するのに特に適している可能性があるため、これらは例外であり、より広範な科学研究がすべて同じようにAIによって推進されるとは限らないことを示している可能性があります。
別のよく似た例はAlphaGoの第37手です。ただし、Clarkは、AlphaGoの結果から10年が経過し、37手の後には、より現代的で驚くべき洞察が後続していないこと自体が、やや悲観的なサインと見なすことができると考えています。
AI はすでに AI エンジニアリングの大部分を自動化できるようになっています
上記のすべての証拠をまとめると、次のような状況が見えてきます:
・ AI システムはほぼすべてのプログラムに対してコードを自動生成できるようになっており、これらのシステムは既にいくつかのタスクを独立して完了することができるようになっています。これらのタスクを人間に任せると、通常は数十時間の高度な集中労働が必要です。
・ AI システムは AI 開発の中核的なタスクをますます上手にこなすようになっており、モデルの微調整からカーネルの設計まで、徐々にカバー範囲を広げています。
・ AI システムは他の AI システムを管理できるようになっており、実際には合成チームを形成しています:複数の AI が複雑な問題に取り組み、そのうちのいくつかはリーダーや評論者、編集者の役割を果たし、他のいくつかはエンジニアの役割を果たしています。
・ 一部の AI システムは、現在では人間を上回る難しいエンジニアリングや科学的なタスクを達成することができるようになっています。しかし、これらが真の創造力を持つためなのか、それとも大量のパターン化された知識を熟知しているためなのか、はまだ判断が難しいです。
Clark によると、これらの証拠は非常に説得力があり、今日の AI はすでに AI エンジニアリングの大部分を自動化し、おそらくはすべてをカバーする能力を持っていることを示しています。
ただし、現時点では、AI が AI 研究自体をどの程度自動化できるかは明確ではありません。研究の一部は純粋なエンジニアリングスキルとは異なり、依然としてより高度な判断、問題意識、創造性に依存しています。
ともかく、明確なシグナルはすでに出ています:現代の AI は、AI 開発に従事する人間を大幅に加速させており、これらの研究者やエンジニアが数え切れない合成の同僚と協力して作業能力を拡大しています。
最後に、AI 業界自体もほぼ率直に述べています:AI 研究の自動化こそが彼らの目標です。
OpenAI は、2026 年 9 月までに自動化された AI 研究インターンシップを確立したいと考えています。Anthropic は、AI 適合研究者を育成するための取り組みを進めています。DeepMind は三大ラボのうちで最も慎重な姿勢を示していますが、適合研究の自動化を推進すべきだとも述べています。
AI 研究の自動化は、多くのベンチャー企業の目標になっています。Recursive Superintelligence は最近 5 億ドルの資金調達を行い、AI 研究の自動化を目指しています。
言い換えれば、数千億ドル規模の既存資本と追加資本が、自動化AI開発を目指す一連の機関に投資されています。
したがって、この方向性がある程度進展することが期待されます。
なぜこれが重要なのか
これによる影響は大きく、しかし一般向けメディアはAI開発に関してほとんど議論していません。以下に示すいくつかの側面がAI開発がもたらす大きな課題を反映しています。
1. アラインメントを確実にする必要があります:現在、有効なアラインメント技術は、再帰的な自己改善において失敗する可能性があります。なぜならAIシステムは、それらを監督する人々やシステムよりもるかん智能であるようになるからです。これは広く研究されてきた分野であり、彼はいくつかの問題を簡単に概説しているにすぎません:
· AIシステムを訓練する際にウソをつかず不正行為を行うことは、予想外に微妙なプロセスです(例えば、環境に適切なテストを構築してそれを試したとしても、時々AIが問題解決の最適な方法を不正行為することにより、それを不正行為する方法を教えてしまうことが可能です)。
· AIシステムは、「フェイクアラインメント」により私たちを騙すかもしれません。それは良いスコアを出すように見せかけますが、実際にはその真の意図を隠しています。(一般に、AIシステムは自分がテストされているときにそれに気づくことができるようになっています。)
· AIシステムが自らの訓練にますます関与し始めると、私たちはAIシステムの全体的な訓練方法を大幅に変更するかもしれませんが、それが何を意味するかを理解するための明確な直感や理論的基盤がありません。
· あるシステムを再帰ループに置くと、非常に基本的な「誤差の蓄積」問題が発生し、上記のすべての問題やその他の問題に影響する可能性があります:アラインメントアプローチが「100%正確」であり、より賢いシステムで持続的に正確さを維持できることが理論的にあればいいですが、そうでないと事態はすぐに悪化する可能性があります。例えば、技術の初期精度が99.9%であるとしても、50世代後には95.12%に下がる可能性があります。さらに500世代経過すると60.5%に低下する可能性があります。
2. AIに関わるすべてが莫大な生産性の複利を得ます:AIがソフトウェアエンジニアの生産性を著しく向上させたように、AIに関係する他の領域も同様に向上することが予想されます。対処する必要があるいくつかの問題があります:
· リソースの不均等な取得:AIの需要が引き続き計算リソース供給を上回ると仮定すれば、AIをどのように割り当てて社会全体の最大利益を達成するかを決定する必要があります。私は市場インセンティブが制限されたAI計算から最大の社会恩恵を得られることを保証できるとは疑念を持っています。AI開発による加速能力の分配方法を決定することは、非常に政治的な問題になるでしょう。
· 経済の「アムダールの法則」:AI が経済に導入されるにつれて、高速成長に直面する際に特定のステップでボトルネックが発生し、その弱点を修復する必要があることがわかります。特に、迅速なデジタル世界と遅い物理世界を調整する必要がある領域では、新薬の臨床試験などでこれが特に顕著に現れるかもしれません。
3. 資本集約型、労働集約型経済の形成:AI 研究開発に関するすべての証拠からも、AI システムがますます企業を自律的に運営する能力を持つようになっていることが示されています。
これは、私たちが経済の一部が新しい世代の企業によって占められることを期待できることを意味します。これらの企業は資本集約型(多数のコンピュータを所有しているため)、または運営費用集約型(AI サービスに多額の資金を投じ、その付加価値を創出しているため)のいずれかであり、今日の企業と比較して、AI システムは引き続き向上し続ける能力があるため、労働力への依存度は比較的低い可能性があります。
実際、これは時間の経過とともに、ますます大きな「人間の経済」の中に「機械の経済」が形成されることを意味し、AI によって運営される会社が相互に取引し始め、それによって経済構造が変わり、不平等や再配分に関連する様々な問題が引き起こされる可能性があります。最終的には、完全にAI システムによって自律的に運営される企業が現れる可能性があり、これは上記の問題を悪化させる一方で、多くの新しいガバナンスの課題を引き起こすでしょう。
ブラックホールを見つめる
上記の分析に基づいて、筆者は2028年までに自動化されたAI研究(つまり、先進モデルが自律して後継バージョンをトレーニングする能力)を60%の確率で見ると考えています。それが2027年に登場するとは予想していないのはなぜですか?
その理由は、著者がAI研究には創造性と異論が必要であり、これまでに、AI システムがこの点を画期的かつ重大な方法で示していないと考えているからです(数学研究の加速に関する一部の結果には示唆がありますが)。
もし必要があれば、彼は2027年の確率を30%と言うだろう。
2028年までに登場しない場合、私たちは現在の技術パラダイムにいくつかの根本的な欠陥があることを明らかにし、進展を促進するために人間が発明する必要がある可能性があります。
原文リンク
BlockBeats の公式コミュニティに参加しよう:
Telegram 公式チャンネル:https://t.me/theblockbeats
Telegram 交流グループ:https://t.me/BlockBeats_App
Twitter 公式アカウント:https://twitter.com/BlockBeatsAsia

 関連記事