クロードがコードを書くといつもエラーが発生する? これら12のルールに従うと、エラー率が3%に低減します。
原文タイトル:Karpathy の 4 つの CLAUDE.md ルールにより、Claude のミス率が 41% から 11% に削減。30 個のコードベースを対象に、さらに 8 つのルールを追加
編者注:2026 年 1 月、Andrej Karpathy が Claude のコーディングに対するQueを投稿し、AI プログラミングワークフローにおいて非常に重要なファイル:CLAUDE.mdについて言及しました。その後、Forrest Chang はこれらの問題を4つの行動ルールに整理し、Claude がコーディング中に犯す一般的なミスを抑制しようとしました:暗黙の前提、過剰なエンジニアリング、関連のないコードの破壊、そして明確な成功基準の欠如。
しかし、数ヶ月後、Claude コードの使用シーンはもはや「モデルにコードを書かせる」だけではありませんでした。マルチステップ Agent、フックによるチェーン式トリガー、スキルの読み込み、および複数のコードライブラリでの協力が一般的になるにつれ、新しい失敗モードも現れ始めました:モデルが長期タスクで制御を失う、テストは合格しているが実際のロジックは検証されていない、移行が完了しても暗黙のうちにエラーがスキップされる、異なるコードスタイルが誤って混在する。
筆者は、6 週間で 30 のコードベースをテストし、Karpathy の元々の 4 つのルールにさらに 8 つのルールを追加し、AI プログラミングが単一の補完からエージェント化された共同作業に移行した後の新しい問題をカバーしようとしました。
以下は元文です:
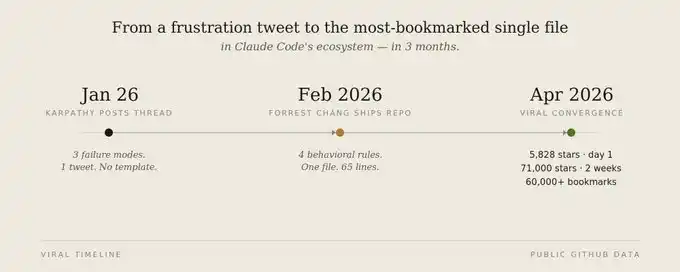
2026 年 1 月下旬、Andrej Karpathy は Claude のコーディング方法についてツイートを投稿しました。彼は説明がない状況での誤った前提、過剰な複雑化、および本来変更すべきでないコードへの無関係な変更という3つの典型的な問題を指摘しました。
Forrest Chang はこのツイートを見て、その不満を4 つの行動規則に整理し、別個のCLAUDE.mdファイルに記入してGitHubに公開しました。このプロジェクトはリリース初日に 5,828 のスターを獲得し、2 週間で 60,000 回ブックマークされ、今では 120,000 のスターを獲得し、2026 年に最も急成長した単一ファイルのコードリポジトリとなりました。
その後、私は 6 週間かけて、30 のコードベースでそれをテストしました。
These 4 rules are indeed effective. The past approximately 40% error rate has dropped to below 3% in tasks suitable for these rules. However, the problem is that this template was originally designed to address the errors Claude encountered while coding in January.
By May 2026, the challenges faced by Claude Code's ecosystem had evolved: conflicts between Agents, hook chain triggering, skill loading conflicts, and interruptions in cross-session multi-step workflows, among others.
Therefore, I added 8 more rules. Below is the full 12-rule version of CLAUDE.md: why each one deserves inclusion and where the original Karpathy template quietly breaks in four places.
If you wish to skip the explanation and directly copy for use, the complete file is placed at the end of the document.
Why This Matters
Claude Code's CLAUDE.md is the most underestimated file in the entire AI programming stack. Most developers typically make three types of mistakes:
First, treating it as a junk-drawer preference and cramming all their habits in, eventually ballooning to over 4000 tokens, with rule compliance plummeting to 30%.
Second, not using it at all and prompting anew each time. This leads to a five-fold waste of tokens and a lack of consistency across different sessions.
Third, copying a template and then ignoring it forever. It may be effective for two weeks, but as the codebase evolves, it silently becomes outdated.
The Anthropic official documentation is clear: CLAUDE.md is essentially just advisory. Claude follows it for about 80% of the time. Once it crosses 200 lines, the compliance rate significantly drops as important rules get drowned in noise.
Karpathy's template solves this issue: one file, 65 lines, 4 rules. This is the minimum benchmark.
But the upper limit can be higher. By adding the following 8 rules, it covers not only the code writing issues complained about by Karpathy in January 2026 but also the Agent orchestration issues that emerged only in May 2026—issues that did not exist when the original template was written.
The Original 4 Rules
もしまだ Forrest Chang のリポジトリをご覧になっていない場合は、まずこのベースバージョンをご覧ください:
ルール1:コーディングの前に考える。
黙って仮定しないでください。仮定を説明し、トレードオフを明らかにしてください。推測する前に質問してください。よりシンプルな解決策が存在する場合は、積極的に反対意見を述べてください。
ルール2:シンプルさを優先する。
問題を解決できる最小限のコードを使用してください。想像上の機能を追加しないでください。一度限りのコードのために抽象化レイヤを設計しないでください。シニアエンジニアが過度に複雑だと考える場合は、単純化すべきです。
ルール3:外科手術のような修正。
修正する必要がある部分のみを修正してください。隣接するコード、コメント、または形式を手際よく「最適化」しないでください。壊れていないものをリファクタリングしないでください。既存のスタイルに一貫性を保ちます。
ルール4:目標志向の実行。
成功基準をまず定義し、それから反復的に進めて検証を完了するまで続けてください。すべてのステップをクロードに教えるのではなく、成功の結果がどのように見えるべきかを伝え、自分で反復させてください。
これら4つのルールは、独学のクロードコードセッションで見られる約40%の失敗パターンを解決できます。残りの約60%の問題は、以下の空白地帯に隠れています。
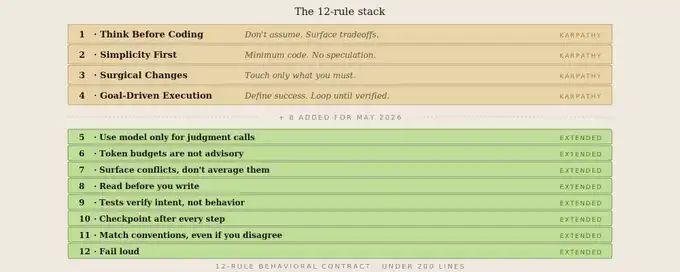
私が追加した8つのルールとその理由
それぞれのルールは、リアルタイムから来ています:Karpathy の元々の4つのルールでは不十分でした。次に、そのシーンを説明し、対応するルールを示します。
ルール5:モデルに非言語的作業をさせない
クロードを使用して処理できるもの:分類、ドラフト作成、要約、非構造化テキストからの情報抽出。 クロードを使用しないでください:ルーティング、リトライ、ステータスコード処理、確定的変換。 ステータスコードで問題が解決されている場合は、通常のコードで問題を解決してください。
Karpathy のルールにはこの点がカバーされていませんでした。その結果、モデルが、本来決定論的コードが処理すべき問題を決定し始めました。APIコールをリトライするかどうか、メッセージをどのようにルーティングするか、処理をいつアップグレードするかなど。結果として、毎週異なる判断を得ます。おそらく、疑似的な if-else の一連が0.003ドルのトークンごとに請求されます。
そのシーンは次のようでした:あるコードセグメントがClaudeを呼び出して「503を受けた場合にリトライすべきかどうかを判断する」ことがありました。最初はうまく機能していましたが、2週間続いた後、突然安定性が失われました。なぜなら、モデルがリクエスト本体も判断の文脈として扱い始めたためです。プロンプト自体がランダムなので、リトライ戦略がランダムになりました。
ルール 6:ハードなトークン予算を設定し、例外はありません
単一タスクの予算:4,000 トークン。 単一セッションの予算:30,000 トークン。 タスクが予算の上限に近づいた場合、現在の状態を要約し、再開始します。無理に続行しないでください。 予算超過の問題を明確に示し、黙って予算を超過しないようにします。
予算制約のない CLAUDE.md は、空白の小切手と同等です。各ループは制御を失い、50,000 トークンのコンテキストダンプになる可能性があります。モデルは自動的に停止しません。
その瞬間は次のようになりました:1回のデバッグセッションが90分間続きました。モデルは続けざまに同じ8KBのエラーメッセージを反復し、自分が試みた修正方法を徐々に忘れていきました。最終的には、私が否定した40通りの提案を出し始めました。予算があれば、このプロセスは12分目に終了していました。
ルール 7:衝突を露出し、妥協せず
コードベースに既存の2つのモードが互いに矛盾している場合、それらを混在させないでください。 2つのモードのうち、更新されたまたはよりテストされたモードを選択し、理由を説明し、残りのモードのクリーンアップを後で行う必要があることをマークします。 2つのルールを同時に満たそうとする「平均コード」は、最も悪いコードです。
コードベース内の2つの部分が互いに矛盾するとき、Claude は両方に取り入れようとし、その結果、不連続なコードが書かれます。
その瞬間は次のようになりました:1つのコードベースに2つのエラー処理モードが存在し、1つは async/await に明示的な try/catch、もう1つはグローバルエラーバウンダリがあるものでした。Claude が書いた新しいコードは、両方のモードを使用しました。その結果、エラー処理が2回行われました。私はエラーが2回抑制される理由を理解するのに30分かかりました。
ルール 8:先読み、後書き
ファイルに新しいコードを追加する前に、そのファイルのエクスポートされたコンテンツ、直接の呼び出し元、および明らかに関連する共有ユーティリティ関数を読んでください。 既存のコードがなぜそのように組織されているか理解できない場合は、直接その理由を尋ね、直接コードを追加しないでください。 「これは関係ないと思います」というのは、このコードベースで最も危険な文言です。
Karpathyの「外科的手術のような変更」は、Claude に隣接するコードを変更しないよう指示しました。しかし、Claude には伝えませんでした:まず隣接するコードを理解してください。このルールがないと、Claude は30行先のコードと衝突する新しいコードを書いてしまいます。
その瞬間はこうだった:Claude は既存の関数の隣に、元の関数を読まずに完全に同じ機能の関数を追加しました。 2 つの関数は同じことをしています。 しかし、import の順序に関連して、新しい関数は古い関数を上書きしました。 そして古い関数は事実上 6 か月間唯一の基準として存在していました。
ルール 9:テストはオプションではないが、テスト自体が目標ではない
各テストは、「なぜその動作が重要なのか」をコード化する必要があり、「それが何を行うか」だけではありません。 `expect(getUserName()).toBe('John')` のようなテストは、実際にはハードコードされた ID を受け取る関数には価値がありません。 ビジネスロジックが変更された場合に失敗するテストを書くことができない場合、その関数自体に問題があります。
Karpathy の「目標志向的実行」は、テストを成功基準と見なすことができることを示唆しています。 しかし、実際には、Claude は「テスト合格」を唯一の目標とし、浅いテストに合格するだけで他のものを壊すコードを書いてしまいます。
その瞬間はこうだった:Claude は認証関数に 12 個のテストを書きましたが、すべて合格しました。 しかし、本番環境の認証ロジックは壊れていました。 それらのテストは、関数が「何かを返す」ことを検証するだけであり、「正しいものを返すか」を検証していません。 関数がテストに合格した理由は、それが定数を返していたからです。
ルール 10:長時間実行される操作にはチェックポイントが必要です
多段階のタスクでは、各ステップの完了後に行ったこと、検証したこと、残っていることをまとめます。 自分で説明できない状態から先に進まないでください。 自分が迷子になったら、止まって現在の状態を再述します。
Karpathy のテンプレートのデフォルトのインタラクションは一度限りです。 しかし、実際の Claude Code の作業はしばしば複数段階です:20 ファイルをまたいだリファクタリング、セッションで機能を構築、複数のコミットでデバッグします。 チェックポイントがないと、1 つステップを誤ると、前進したすべてが失われる可能性があります。
その瞬間はこうだった:6 ステップのリファクタリングタスクで第 4 ステップでエラーが発生しました。 私が気づいたときには、Claude は既に誤った状態で第 5 ステップと第 6 ステップを続けて完了していました。 修正に費やされる時間は、タスク全体をやり直すよりも長いです。 チェックポイントがあれば、第 4 ステップで問題が見つかったでしょう。
ルール 11: 約束は新規性よりも優先される
コードベースが snake_case を使用しており、あなたが camelCase を好む場合:snake_case を使用してください。 コードベースがクラスベースのコンポーネントを使用しており、あなたがフックを好む場合:クラスベースのコンポーネントを使用してください。 異なる意見は別の議論です。コードベース内では、一貫性が個人の好みよりも優先されます。 特定の約束が有害だと本当に思う場合は、明確に提起してください。影響を与える分岐パスを静かに作成しないでください。
成熟したパターンがすでに存在するコードベースにおいて、Claude は独自のスタイルを導入するのが好きです。そのスタイルが「より良い」であるとしても、第二のパターンを導入すること自体が、どんな一つの単一のパターンよりも悪い結果をもたらします。
その瞬間は以下のようでした:Claude は class コンポーネントベースの React コードベースに hooks を導入しました。これは確かに動作しました。しかし同時に、この変更はコードベース内のテストパターンを壊し、それらのテストが componentDidMount に依存しているため、この変更を取り消してから再度書き直すのに半日かかりました。
ルール 12: 明示的な失敗を意図する、静黙の失敗ではない
あることが成功したかどうか確信が持てない場合は、そのことを明示的に述べてください。30 のレコードが静かにスキップされた場合、「移行が完了した」とは言えません。どのテストかをスキップした場合、「テストが合格した」とは言えません。要求された境界条件を検証していない場合、「機能が利用可能である」とは言えません。不確実性をデフォルトで露出し、それを隠蔽しないでください。
Claude の最も高価な失敗は、成功したように見える失敗です。関数は「実行可能」ですが、誤ったデータを返します。1 回のマイグレーションは「完了した」が、30 のレコードがスキップされました。1 つのテストは「合格した」が、それはアサーション自体が誤っているだけです。
その瞬間は以下のようでした:Claude は1回のデータベースマイグレーションが「成功裏に完了した」と述べました。しかし、実際には、これは 14% の重複制約違反のレコードが静かにスキップされたことを意味していました。スキップされた動作はログに記録されましたが、明示的に露出されませんでした。11 日後、レポートデータが異常な結果を示し始めた時、私たちは問題に気付きました。
データ結果
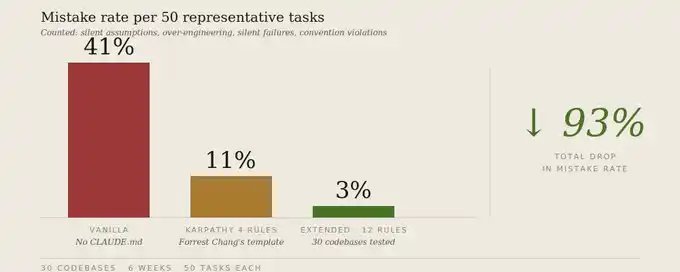
私は 6 週間の間、30 のコードベースをカバーする 50 件の代表的なタスクグループを追跡し、3つの異なる構成をテストしました。
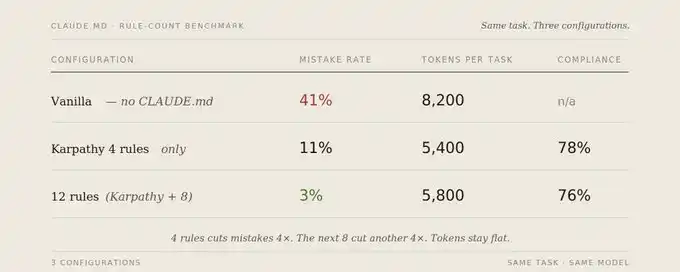
エラー率とは、タスクを修正または書き直して元の意図に一致させる必要がある割合を指します。カウントされるエラーには、静かなエラーの仮定、過剰エンジニアリング、無関係な破壊、静かな失敗、規約違反、トレードオフの衝突、チェックポイントの見落としなどが含まれます。
コンプライアンス率とは、特定のルールが適用される場合、Claude がそのルールをいかに明示的に適用する可能性があるかを示します。
本当に興味深い結果は、エラー率が 41% から 3% に低下したことだけではありません。より重要なのは、4つのルールから12つのルールに拡張されたことで、コンプライアンス負担がほとんど増加せず、コンプライアンス率がたった2% 下がっただけで、エラー率が8ポイントも低下したことです。新たに追加されたルールは、以前の4つのルールで処理されなかった失敗モデルをカバーしており、これらのルール間で同じ注意予算を争っているわけではありません。
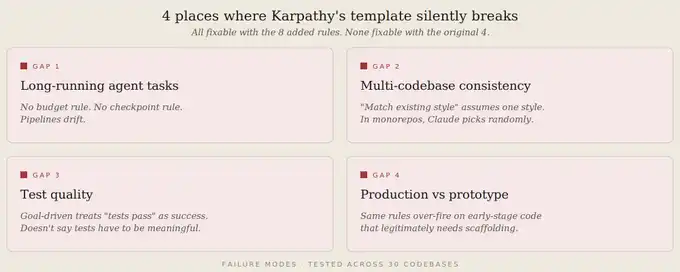
Karpathy テンプレートがひそかに失敗する場所
新しい規則を追加しなくても、元の4つのルールテンプレートは少なくとも4つの箇所で不十分であることがあります。
第一に、長時間実行されるエージェントのタスク。
Karpathy のルールは主に、Claude がコードを書いている瞬間に焦点が当てられています。しかし、Claude が複数段階からなるパイプラインを実行している際に何が起こるでしょうか?元のテンプレートには規則が予算化されておらず、チェックポイントの規則もなく、「ラウドな失敗」の規則もありません。したがって、パイプラインはゆっくりとドリフトしてしまいます。
第二に、複数のコードベースの一貫性。
「既存のスタイルに合わせる」はデフォルトで1つのスタイルしか持っていません。しかし、12のサービスを持つモノレポで、Claude はどのスタイルに合わせるかを選択する必要があります。元のルールは、Claude にどのスタイルを選択すべきかを教えていません。そのため、Claude はランダムに選択するか、いくつかのスタイルを均等に混在させるしかありません。
第三に、テストの品質。
「目標志向的に実行」は「テストが合格」を成功と見なしますが、テスト自体が意味を持つ必要があるかどうかは説明されていません。その結果、Claude はほとんど何も検証していないテストを作成し、それらのテストによって自信を持っていると誤解してしまいます。
第四に、本番環境とプロトタイプ段階の違い。
同じ4つのルールでも、本番コードの過剰エンジニアリングを防ぐことができますが、プロトタイプ開発を遅くする可能性もあります。なぜなら、プロトタイプ段階では、方向性を理解するために100行の探索的なスケルトンが必要な場合があるからです。Karpathy の「シンプルさ優先」は、初期のコードで過度にトリガーされる可能性があります。
これらの8つの新しいルールは、Karpathy の元の4つのルールを置き換えるものではなく、それらの空白を補うために存在しています。元のテンプレートは、2026年1月のような、部分的に自動補完されたコードライティングシーンに対応しています。しかし、2026年5月には、Claude Code はエージェント駆動型の、段階的で複数のコードベースでの協力環境に入っており、それぞれが異なる問題に直面しています。
どの方法が効果を上げなかったか
これら 12 のルールを最終的に確定する前に、私はいくつかの他のアプローチも試しました。
Reddit / X で見たルールを追加。
そのほとんどは、Karpathy の元の 4 つのルールを異なる言葉で繰り返しただけのものであり、または「常に Tailwind クラスを使用する」といった特定のドメインに一般化できないルールでした。最終的に、これらはすべて削除されました。
12 のルールを超える。
最大で 18 のルールまでテストしました。14 を超えると、遵守率は 76% から 52% に下がりました。200 行の制限が実際に存在します。この長さを超えると、Claude は「ここにルールがある」とパターンマッチングを始め、実際にはルールを1つずつ読み込むのではなくなります。
特定のツールに依存するルール。
たとえば、「常に eslint を使用する」、プロジェクトに eslint がインストールされていない場合、このルールは無効になります。さらに、静かな無効になります。後に、具体的なツールに依存しない表現に変更し、「eslint を使用する」を「コードベースで既に強制されているスタイルに従う」などに変更しました。
CLAUDE.md に例を記載し、ルールではなく。
例はルールよりも多くのコンテキストを消費します。3 つの例が消費するコンテキストは、ほぼ 10 のルールに相当し、Claude は例に過剰適合しやすくなります。ルールは抽象的であり、例は具体的です。したがって、ルールを使用する必要があります。
「少し気をつけて」「真剣に考える」「少し集中する」。
これらはすべてノイズです。これらのタイプの指示の遵守率は約 30% に低下しました。これらは検証できないためです。後に、これらをより具体的なコマンドスタイルのルールに置き換え、「前提を明示する」などに変更しました。
Claude に「シニアエンジニアのように振る舞う」と伝える。
これは役に立ちませんでした。Claude は元々自分をシニアエンジニアのように考えていました。問題は、それがどのように実行されるかではなく、それがどのように見なされるかです。コマンドスタイルのルールはこの差を縮小できますが、身元のヒントワードはパフォーマンスがありません。
完全な 12 のルール版 CLAUDE.md
以下に、直接コピーして貼り付けられる完全バージョンがあります。
この内容は現在飛書の外部で表示できません
これをリポジトリのルートディレクトリに CLAUDE.md として保存します。これらの 12 のルールの下に、技術スタック、テストコマンド、エラーパターンなどのプロジェクト固有のルールを追加します。全体の行数が 200 を超えないようにし、それを超えるとルールの遵守率が著しく低下します。
インストール方法
2 つのステップで完了します:
1. Karpathy の 4 つの基本ルールをあなたの CLAUDE.md に追加します
curl https://raw.githubusercontent.com/forrestchang/andrej-karpathy-skills/main/CLAUDE.md >> CLAUDE.md
2. このドキュメント内のルールを 5–12 の間をコピー&ペーストします
ファイルをリポジトリのルートディレクトリに保存します。ここでの >> は重要です。これにより CLAUDE.md に追加され、既存のプロジェクト固有のルールが上書きされることはありません。
メンタルモデル
CLAUDE.md は願い事のリストではなく、既に観察された具体的な失敗パターンを封じ込めるための取引行動契約です。
各ルールは1つの質問に答えるべきです:それはどんなエラーを防ぐのでしょうか?
Karpathy の 4 つのルールは、彼が 2026 年 1 月に見た失敗パターンを防ぐものです:沈黙の仮定、過剰エンジニアリング、不必要な破壊、弱い成功基準。これらは基本であり、スキップしないでください。
私が追加した 8 つのルールは、2026 年 5 月以降に現れた新しい失敗パターンを防ぎます:予算制約のないエージェントループ、チェックポイントのない多段階タスク、見かけはテスト済みでも実際には重要なロジックがテストされていないテスト、そして沈黙の失敗を沈黙の成功としてラップする問題。これらは増分パッチです。
もちろん、その効果は個人によって異なります。マルチステップパイプラインを実行しない場合、ルール 10 はそこまで重要ではありません。コードベースが1つの統一されたスタイルのみであり、すでに lint が適用されている場合、ルール 11 は冗長です。これら12のルールを読み終えたら、実際に犯したエラーに対応するルールを保持し、その他の部分を削除してください。
実際の失敗パターンに合わせてカスタマイズされた、6つのルールバージョンの CLAUDE.md は、12のルールがあり、そのうち6つが使用されないバージョンよりも優れています。
結論
2026 年 1 月の Karpathy のツイートは、本質的に不平を言うものでした。Forrest Chang はそれを4つのルールに変えました。最終的には、12 万の開発者がこの結果にスターを付けました。しかし、そのうちのほとんどは、今日でもその4つのルールしか使用していません。
モデルは進化し、エコシステムも変わりました。Multi-step Agent、hook チェーン トリガー、skill ロード、複数のコードライブラリの協力 — これらは Karpathy がそのツイートをしたときにはまだ存在していませんでした。元々の 4 つのルールはこれらの問題を解決していませんでした。それらが間違っているわけではなく、単に不完全であるだけです。
新たに 8 つのルールを追加しました。6 週間の時間で、30 のコードライブラリにテストを適用。エラー率が 41% から 3% に低下しました。
今夜はこの記事をブックマークし、これらの 12 のルールをあなたの CLAUDE.md に貼り付けてください。これがあなたが Claude の過程を 1 週間省くのに役立つ場合は、ぜひ共有してください。
BlockBeats の公式コミュニティに参加しよう:
Telegram 公式チャンネル:https://t.me/theblockbeats
Telegram 交流グループ:https://t.me/BlockBeats_App
Twitter 公式アカウント:https://twitter.com/BlockBeatsAsia
 関連記事