Kimi K3が新たな問題を提起:モデルが安くなればなるほど、チップの需要は逆に大きくなるのか?
原文タイトル:「より多くのトークン、より多くのチップ!Kimi K3が示す「ジェヴォンズのパラドックス」——効率向上がむしろ資源消費を増やす」
原文著者:趙穎、ウォールストリート・ジャパン
Kimi K3は、AI投資家を再び核心的な問題に引き戻す。モデルがより安価で効率的になることは、チップやメモリの需要減少を意味するのか?シティとバンク・オブ・アメリカ証券の答えは、いずれも否定的だ。効率向上は使用量を拡大させ、結果的に総資源消費を押し上げる可能性がある。
追風トレーディングデスクによると、月之暗面(Moonshot AI)が発表したKimi K3は2.8兆パラメータを持ち、100万トークンのコンテキストウィンドウと長期エージェントタスクに対応する。シティの半導体アナリスト、ピーター・リー氏は、Kimi K3が広く使用されたとしても、サーバー向けDDR5やeSSDなどの汎用メモリ需要は増加すると見ている。
バンク・オブ・アメリカ証券の半導体アナリスト、ヴィヴェック・アリヤ氏は7月17日のリサーチでも、米国の最先端AIラボはむしろ計算リソースへの投資を増やす可能性が高く、減らすことはないと指摘する。中国のオープンソースモデルが継続的に迫る場合、OpenAI、Anthropic、Googleなどのリーダーは、より大規模なトレーニング、より重い推論、より迅速な製品イテレーションで差別化を維持する必要がある。
これは、Kimi K3に対する市場の価格設定ロジックが、単なる1回の推論コスト削減だけでは決まらないことを意味する。より重要なのは、低価格モデルがより多くの呼び出し、より長いタスクチェーン、より多くのトークン生成をもたらすかどうかだ。答えがイエスなら、GPU、HBM、DDR5、eSSD、高速ネットワーク、推論システムはすべて恩恵を受け続ける可能性がある。
低価格・高性能が「ジェヴォンズのパラドックス」を引き起こす
シティはKimi K3を、AI産業チェーンにおける「ジェヴォンズのパラドックス」の潜在的な事例と見なしている。このパラドックスの核心は、技術効率の向上が単位使用コストを低下させると、使用量が大幅に増加し、最終的に資源の総消費量が減少するどころか増加するという点にある。
Kimi K3の魅力は、低コストと高性能の組み合わせにある。公開価格によると、キャッシュヒット時の入力価格は100万トークンあたり0.3ドル、出力価格は100万トークンあたり15ドルだ。完全な重みは7月27日に開示される予定で、長期エージェントワークをサポートすることを目指している。
シティの判断は、モデル価格の低下が自動的にハードウェア需要を減らすわけではないというものだ。むしろ、低コストは開発者や企業がモデルを呼び出す意欲を高め、より多くのAIエージェントの展開を促進する可能性がある。エージェントタスクは一回限りのQ&Aではなく、連続的なタスクの中でトークンを生成、読み取り、処理し続ける。呼び出し回数とタスク長の増加は、単位コストの低下を再び総資源消費に転換させる。
したがって、Kimi K3が半導体チェーンに与える影響の焦点は、「1回の呼び出しがより安価かどうか」ではなく、「総トークン量が拡大するかどうか」にある。これこそが、シティグループがサーバー向けDDR5とeSSDの需要を強気に見る理由である。
長文脈推論がメモリに負荷を伝達
Kimi K3は、Kimi Delta Attention、Attention Residuals、Stable LatentMoEという3つの主要技術を採用している。Kimi Delta Attentionは100万トークンのコンテキストウィンドウのコストを削減し、Attention Residualsはモデルの異なる深さ間で表現を選択的に検索し、Stable LatentMoEはスパース性を高め、各トークンが896のエキスパートのうち16のみを活性化する。
月之暗面(Moonshot AI)の技術資料によると、このアーキテクチャによりKimi K3の拡張効率はK2の2.5倍に達する。高いスパース性と長文脈能力は、その運用コストを抑える重要な基盤である。
しかし、シティグループはこれが推論側のリソース負荷の消失を意味しないと強調する。Kimi K3は依然として軽量なデプロイメントソリューションではなく、その運用にはマルチノードクラスターが必要であり、スーパーノード構成では64基以上のGPUを搭載する。さらに重要なのは、長文脈とエージェントタスクがKV Cacheの占有を押し上げ、推論側のメモリ負荷を増加させることである。
KV Cacheの需要は、サーバー向けDDR5とeSSDに直接関連する。DDR5は高頻度のデータアクセスを担い、eSSDはより大きなキャッシュとデータストレージ需要から恩恵を受ける。メモリメーカーにとって、重要な変数は個々のモデルがより少ない計算リソースで済むかどうかではなく、低価格化後にモデルが何回呼び出されるか、呼び出しごとに何トークン生成されるか、そしてエージェントタスクチェーンがどれだけ長くなるかである。
モデルの接近がむしろ計算リソースのハードルを引き上げる
バンク・オブ・アメリカ証券の結論はシティグループの見解と呼応するが、焦点はGPUとAIインフラストラクチャにやや偏っている。Vivek Aryaは、より強力な中国のオープンソースモデルが必ずしも米国のAI大手に計算リソースへの投資削減を促すとは限らないと考える。むしろ、モデル間の差が縮まることで、リーダーが優位性を維持するためのコストが上昇する。
バンク・オブ・アメリカ証券は、オープンソースモデルが継続的に接近する場合、OpenAI、Anthropic、Googleは、より大規模なトレーニング、より多くの強化学習と合成データのループ、より重いテスト時推論、そしてより速い製品リリースペースに依存して差別化を維持する必要があると指摘する。
このロジックは、どのモデルが短期的にリードするかには依存しない。大規模言語モデルのランキングは急速に入れ替わる可能性があるが、企業が実際に購入するのは、安定性、低レイテンシ、高可用性を備えたAIアウトプット、そしてより低い「単位有効出力あたりのコスト」である。モデルの性能が収束するにつれ、競争圧力はGPU、HBM、高速ネットワーク、推論システムを含む基盤インフラに波及する。
したがって、BofA証券は、Kimi K3のようなモデルの登場を単に「モデルがより効率的になり、チップが少なくなる」と解釈すべきではないと考える。より現実的な道筋は、モデル競争が激化し、リーダーが差を維持するためにさらに演算能力を強化することである。
MoEアーキテクチャがボトルネックを変化させ、VRAMと相互接続がより重要に
Kimi K3はMoEアーキテクチャを採用しており、総パラメータ数と推論ごとに実際に活性化されるパラメータを分離できることを意味する。この変化により計算負荷の一部は軽減されるが、インフラのボトルネックは単なる演算能力から、VRAMアクセス、エキスパートルーティング、応答レイテンシ、相互接続能力へと移行する。
BofA証券は、MoE推論ではシステムがより効率的にデータを転送し、エキスパートモジュールをスケジューリングし、より大規模な計算クラスタを接続する必要があると強調する。NVIDIAは、現代のMoE推論にはより大規模なGPUドメインが必要だと述べている。その試算によると、GB300 NVL72は主要なオープンソースモデルにおいて、Hopperプラットフォームの最大25倍のワットあたりの性能を達成できる。
CoreWeaveがKimi K2.6を中心に行ったテストも、オープンソースのMoEモデルが毎回一部のパラメータのみを活性化する場合でも、速度とコストパフォーマンスでリードを維持するには、最適化されたNVIDIA GB300/GB200 NVL72インフラが必要であることを示している。
これは、モデルの重みが徐々にコモディティ化する可能性がある一方で、モデル実行に必要なGPU、高帯域幅メモリ、ネットワーク相互接続、推論システムは価値を失わないことを意味する。むしろ、モデルの呼び出し量が拡大するにつれ、これらの要素が競争のより集中する領域となる可能性がある。
トークン使用量は依然拡大中、需要側はまだピークに達していない
BofA証券はまた、OpenRouterのデータを引用し、モデルの呼び出し量が急速に増加していると指摘する。複数のモデルラボを接続するサードパーティAPIプラットフォームとして、OpenRouter上のトークン使用量は継続的に増加しており、中国のAIラボモデルのトークン使用量はすでに非中国ラボモデルを上回っている。
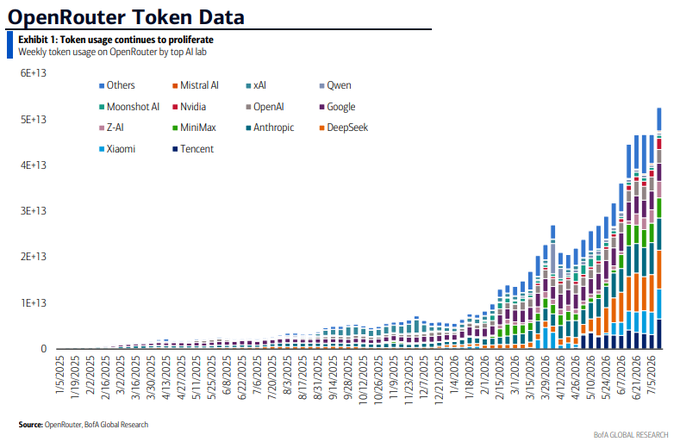
このデータは、すべての企業や消費者向けシナリオを直接的に代表するものではありませんが、少なくとも、オープンモデルエコシステムにおける開発者の選択が変化していることを示しています。モデル価格の低下と能力向上は、単一モデルの効率向上によって相殺されるのではなく、呼び出し量の継続的な拡大を促進する可能性があります。
企業による有料利用も増加しています。Rampのデータによると、2026年6月時点で、米国企業の約55%がAIモデル、プラットフォーム、またはツールを有料で購読しており、これは米国国勢調査局のBTOS調査による推定21%を上回っています。モデル別に見ると、Anthropicの企業導入率は42.4%、OpenAIは39.5%です。
ただし、AI支出は依然として高度に集中しています。上位1%の企業ユーザーは、従業員1人あたりの月間AI支出が平均約4833ドルで、上位10%は516ドル、全体の中央値はわずか11ドルです。テクノロジー・メディア業界の購読率は79.8%に達し、大企業の導入率は65.5%で、中堅企業の61.3%や中小企業の48.7%を上回っています。
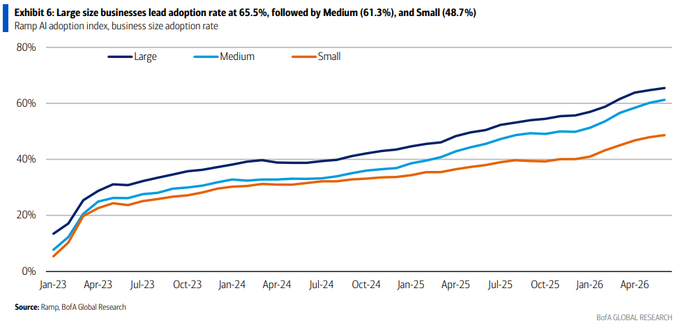
このデータ群は、AIの利用が依然として普及過程にあるという判断を支持しています。低価格モデルが参入障壁を下げれば、将来の需要増加は、より多くの企業、より多くの開発者、そしてより多くのエージェントアプリケーションから生まれる可能性があります。
「省力化」から「ワークロード増加」へ
シティとバンク・オブ・アメリカ・メリルリンチ証券の共通の結論は、Kimi K3の意義は、単一モデルが単位あたりの推論コストを削減するかどうかではなく、低コストがより大規模なワークロードを解放するかどうかにあるということです。
シティにとって、最も直接的な恩恵を受ける分野は、サーバー向けDDR5とeSSDです。長いコンテキスト、KVキャッシュ、エージェントタスクは、メモリアクセスとストレージ需要を増加させます。バンク・オブ・アメリカ・メリルリンチ証券にとって、より重要なのはGPU、HBM、高速ネットワーク、推論システムであり、モデル競争がリーダーにインフラへの投資継続を強いるからです。
バンク・オブ・アメリカ・メリルリンチ証券はまた、Kimi K3に関連する「45nmオープンソースEDA」は、商用EDAが代替されるという単純な解釈をすべきではないと述べています。むしろ、これはチップ設計が依然としてEDAツールを必要としていることを示しています。先端プロセスにおいては、CadenceやSynopsysなどの商用EDAベンダーは依然として重要な位置を占めています。
リスクは別のシナリオにあります。モデル圧縮、推論最適化、ハードウェア効率の向上が、新たなワークロードの増加を長期的に上回る場合、AIインフラの拡大は一時的に減速する可能性があります。しかし、現在の2つの投資銀行の枠組みでは、Kimi K3はチップ需要を弱めるシグナルではなく、使用量を押し上げる触媒のように見えます。効率向上の後、市場が注目すべきは、むしろより多くのトークン、より多くの推論、そしてより多くの基盤ハードウェア消費です。
原文リンク
BlockBeats の公式コミュニティに参加しよう:
Telegram 公式チャンネル:https://t.me/theblockbeats
Telegram 交流グループ:https://t.me/BlockBeats_App
Twitter 公式アカウント:https://twitter.com/BlockBeatsAsia

 関連記事