Anthropicの株主による最新レポートが、企業市場で最も収益を上げている中国製モデルを暴露
原文タイトル:「Anthropic株主の最新レポート、企業市場で最も稼ぐ中国モデルを暴露」
原文著者:動察Beating
11月3日、シリコンバレーの老舗ベンチャーキャピタルMenlo Venturesが今年の「企業AI現状レポート」を発表した。
企業が今年実際にいくら使ったのかを把握するため、MenloはMorning Consultに委託し、9月に約400社の米国企業のAI意思決定者に聞き取り調査を行った。これらの人々が扱うAI支出は40億ドルを超える。Menloの試算によると、今年9月時点で米国企業がAI導入に費やした金額は1768億ドルに達し、1年前の330億ドルの5.4倍となった。
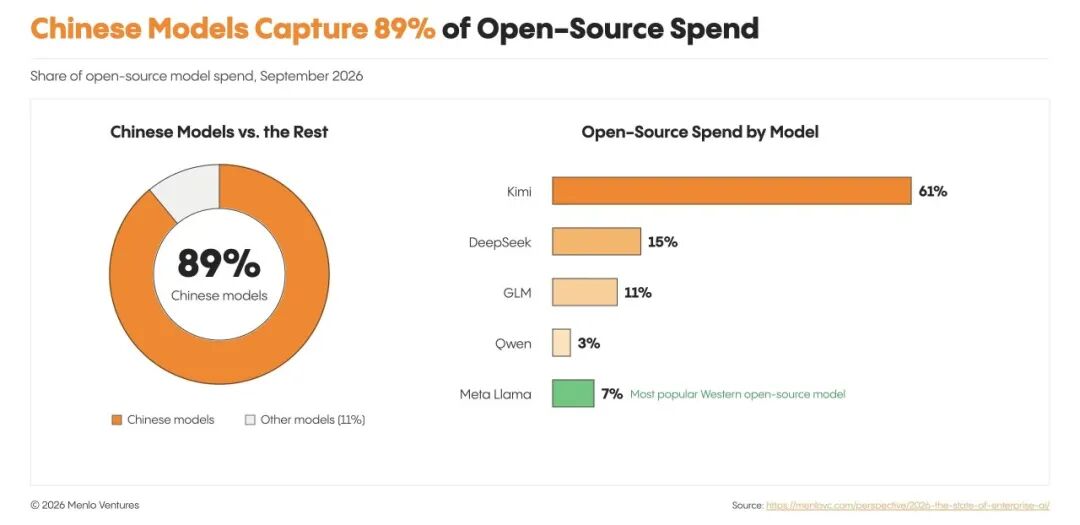
2026年9月、中国モデルが米国企業のオープンソースモデル支出の89%を占める
うちKimiが61%のシェアで首位
画像出典:Menlo Ventures
このシリコンバレー向けのレポートには、一組の数字がある。米国企業がオープンソースモデルに費やす本番支出のうち、中国モデルが約9割を占めている。うちKimiが単独で61%、続いてDeepSeek 15%、GLM 11%、Qwen 3%。西洋のオープンソースモデルで首位のMeta Llamaは、わずか7%にすぎない。
レポートを執筆したMenlo Venturesは、Anthropicの重要株主であり、2024年にその7.5億ドルのDラウンドをリードした。
さらに、Kimiをサーバー上でホストして米国企業に販売し、今年の年換算収益がちょうど10億ドルを突破したトップ推論クラウドFireworks AIはMenloが出資している。毎週160兆トークンを処理するモデルルーティングプラットフォームOpenRouterもMenloが出資している。レポートが特に名指しし、Kimi K2.5上でComposer 2を訓練したCursorも、Menloが出資している。
レポートのデータだけを見れば、クローズドソースの巨人とオープンソース陣営はとっくに死闘を繰り広げているはずだし、太平洋の両岸のモデルもはっきりと区別されるべきだと思うだろう。しかし大人は損得を見て、子供だけが陣営を分けるのだ。
これらのデータや利害関係とは別に、動察 Beating がより明らかにしたいのは、なぜほかでもなく Kimi が、アメリカ企業がクローズドソースのフラッグシップ以外で最も金を惜しまず払う選択肢になったのか、ということだ。
やり直しの値段
Kimi のこの「61%」を理解するには、まず今年アメリカ企業が AI にお金を使う際の奇妙な癖を知る必要がある。安いモデルほど、誰も使わなくなっているのだ。
過去2年間、業界で最も流行った判断は、推論コストが毎年9割下がるのだから、企業はいずれワークフローを安価な小型モデルに切り替えるだろう、というものだった。各ラボも実際に小型モデルをますます安く売るようになった。
結果はまったく逆だった。
2025年第3四半期から2026年第3四半期にかけて、Haiku や Luna といった小型クローズドソースモデルの企業市場における token シェアは29%から13%へと落ち、半分以上も減少した。単価が最も高い最先端フラッグシップは、token シェアが18%から42%へ、支出シェアが35%から63%へと上昇した。
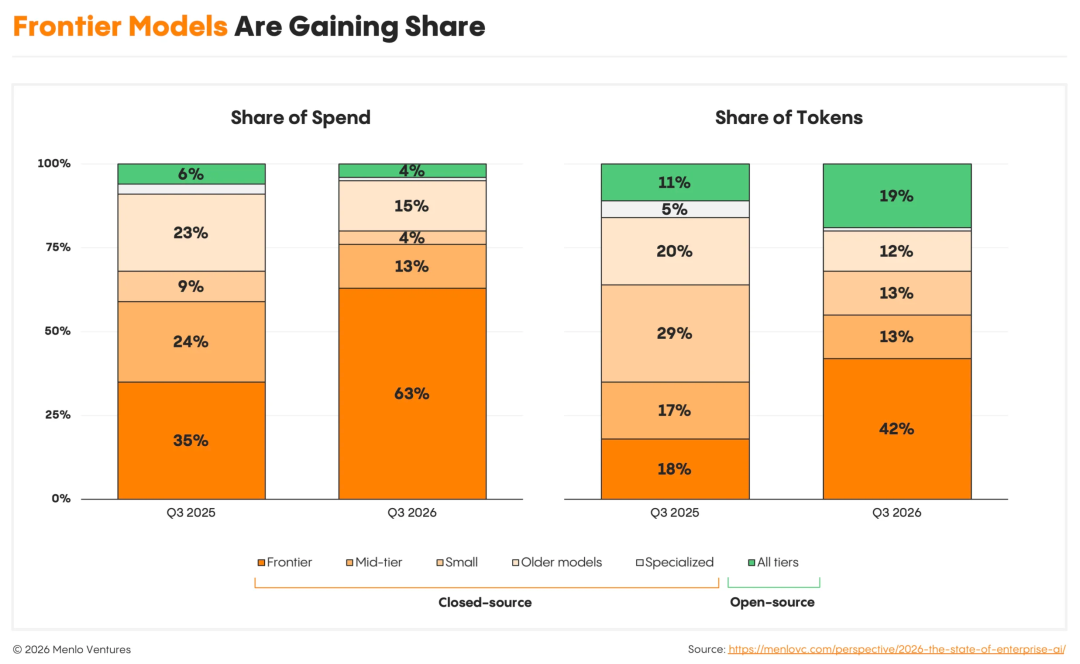
最先端モデルの企業 AI 支出と token 使用量におけるシェアが同時に上昇
図源:Menlo Ventures
1年前、アメリカ企業が最もよく使っていた主力は、入力3ドル・出力15ドル(100万 token あたり、以下同)の Claude Sonnet 4.5 と、1.25ドル・10ドルの GPT-5 だった。しかし今年の秋になると、みんなが列をなしてより高価なフラッグシップモデルに乗り換えた。
賢明なアメリカ企業は、なぜ突然安さを求めなくなったのか?
理由は簡単だ。モデルを使って仕事をするのが、人間から Agent に変わったのだ。
今年2月、OpenRouter 上で Agent が发起したトラフィックが正式に人間を超えた。9月末までに、プラットフォーム上の token の80%は Agent がバックグラウンドで自ら走らせたもので、半年余りで37倍に増えた。773億ドルの企業 AI アプリケーション支出のうち、76%がプログラミングと企業 Agent に集中している。
Agent が仕事をすることと、人間が AI を使うことは同じ論理ではない。
あるプログラミング Agent がタスクを引き受けると、しばしばコードベース、ターミナル、サンドボックスの間で四五十回も連続して実行する:ファイルを読み、ツールを呼び出し、テストを走らせ、エラーを見て、またコードを修正する。
長いチェーン状のタスクでは、エラーのコストは掛け算で累積する。単ステップ精度99%のモデルを50ステップ連続で走らせると、無事に納品できる確率は約6割。単ステップ95%のモデルに変えると、50ステップを問題なく走り切る確率は8%未満だ。
そこで企業はすぐに理解した。今モデルを買うときに見るべきは、価格表の表示単価だけではなく、物事を一度で片付けるための総コストだ。
この点に思い至れば、オープンソースモデルの今年の状況も理解できる。
過去1年で、オープンソースモデルのtokenシェアは11%から19%に上昇し、呼び出し量は1年前の22.5倍になった。しかし支出シェアは6%から4%に下落した。理由は、大多数のオープンソースモデルが価格競争に巻き込まれ、平均単価が元の3分の1未満まで下がり、100万tokenあたり0.13ドルだけになり、クローズドソースモデルの総合平均価格の5分の1未満になったからだ。
オープンソースモデルは仕事のほぼ5分の1をこなしているのに、テーブルから分け前として受け取ったのは25分の1の金だけだ。
Kimiの61%は、まさにそれが0.13ドルの罠に飛び込まなかったからだ。
標準部品
今年7月16日、月之暗面は2.8兆パラメータのKimi K3を発表した。公式APIの価格は入力3ドル、出力15ドルで、1年前のクローズドソース旗艦Sonnet 4.5と同じ価格であり、前世代のK2.6の3倍以上でもある。10月23日に登場したK3.1 Proは2ドルと10ドルに下がったが、依然として旗艦価格帯にある。
平均価格0.13ドルのオープンソース市場で旗艦価格を付ける自信は、まずモデル自体の長コンテキスト、ネイティブマルチモーダル、プログラミングにおける成果から来ている。
しかしベンチマークのスコアだけでは足りない。
オープンソースモデルの重みは公開されており、推論クラウドのドロップダウンメニューでモデルを切り替えるには、設定を1行変えるだけで済む。米国企業の調達は、なぜそれに余分な金を払うのか。
ここには、オープンソースモデルが実験室を出た後に最も頭を悩ませるエンジニアリング問題が潜んでいる。
データコンプライアンスとレイテンシのために、大多数の米国企業はコードや文書を直接海外サーバーに送るのではなく、Fireworks、Together、Amazon Bedrockといった現地クラウドのマネージドサービスを買う。しかし過去1年、シリコンバレーのエンジニアリングチームは頻繁に気づいた。あるオープンソースモデルは公式デモでは極めて賢いのに、自社の本番環境に接続し、サードパーティ推論クラウドのインターフェース経由で呼び出すと、数十ラウンドの連続ツール呼び出しの後に不可解に馬鹿になるのだ。
その理由は、推論クラウドがGPUの回転率を極めて重視するビジネスだからだ。1枚のカードに1秒間でどれだけのリクエストを詰め込めるかが、クラウド事業者のその四半期の粗利を直接左右する。VRAMを節約しスループットを稼ぐため、各プラットフォームはバックエンドで兆単位パラメータのMoEモデルに異なる量子化圧縮を施したり、ツール呼び出しの解析テンプレートを簡略化したりするのが常だ。
普段のチャットでは、この程度の精度低下は見えない。しかし数十ステップが連鎖するAgentループに入れると、偏差はモデルに誤ったエキスパートを選ばせ、フォーマットを壊させ、ワークフロー全体を破綻させるのに十分なものになる。
顧客はモデルの看板を信じて課金し、そしてタスクが失敗する。その責任は最終的にオリジナルベンダーが負うことになる。
Kimiは賢い。声明を出してどのクラウド事業者と言い争うのではなく、ベンダーの精度検証ツールを直接オープンソース化し、継続的に運用している。
すでにK2の時期に、KimiはK2 Vendor Verifierをオープンソース化し、同じテストセットで各推論クラウドと公式APIのツール呼び出し性能を比較していた。今年4月にK2.6を発表した際、このツールはKVV(Kimi Vendor Verifier)にアップグレードされ、テスト項目には長コンテキスト下でのツール呼び出し回帰サンプル、JSON schema検証、不正な呼び出しの拒否、百万トークン級の長記憶テスト、そして113のプログラミングAgentタスクが含まれる。各推論クラウドの実行結果は表形式でGitHubに公開されている。
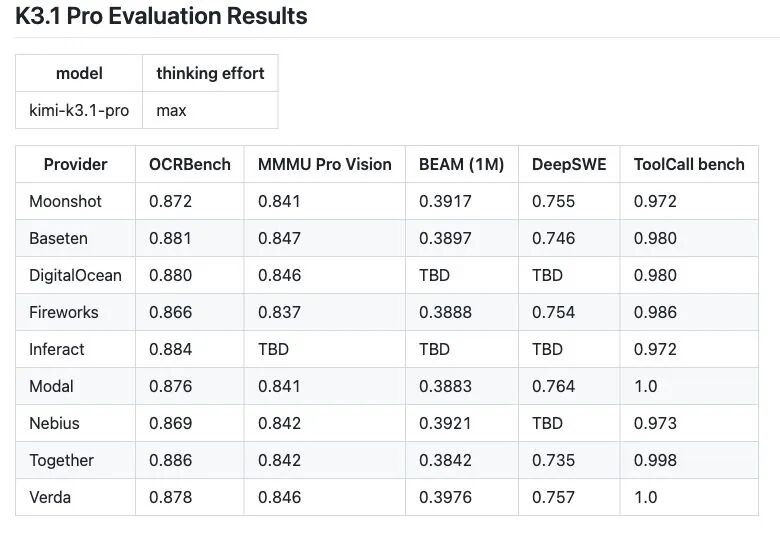
Kimi Vendor Verifierが異なるベンダーの
K3.1 Proデプロイ性能を公開比較
画像出典:Moonshot AI / GitHub
どのクラウド事業者がマシンを節約するために密かに精度を下げたかは、開発者がダッシュボードで一目で分かる。
KVVのスコアをKimi公式APIの水準に合わせるため、シリコンバレーの推論クラウド事業者は逆にKimiのエンジニアと一緒にバグ探しをせざるを得なくなった。
Fireworks AIのエンジニアリングチームは後に専用の記事で振り返り、Kimiチームと共同で低層のデコードガードレールを修正し、マルチターン対話内の冗長フィールドを整理し、最終的にホスト型インターフェースのツール呼び出し性能をオリジナルベンダー水準まで磨き上げた経緯を説明している。
ほとんどのチームはオープンソースに取り組むとき、重みをネットに置いてあとは成り行きに任せる。しかしMoonshot AIは厳格な品質管理の手腕をオープンソースの世界に持ち込んだ。入場料は取らないが、どうやって料理をテーブルに出すかは管理する。
これは企業調達の最も敏感な神経を直撃した。シリコンバレーの技術責任者にとって、KVVは各社のデータセンターに散らばる非標準品を、メーカー認証の標準部品へと再校准したのだ。
4分の3
ホスティング品質だけなら、Kimiはせいぜい使い勝手の良い外部助っ人に過ぎない。レポートが指摘したもう一つの名前が、その海外での第二の価値を明らかにした。それがCursorだ。
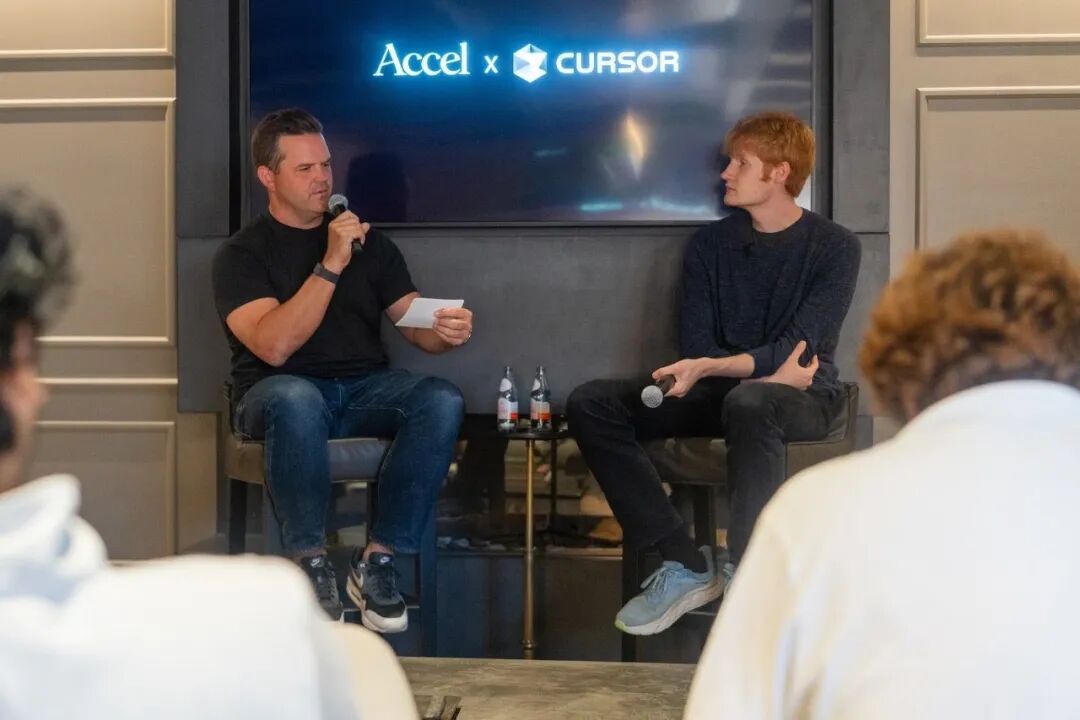
Cursorと投資家Accelの現場交流イベント
画像提供:Accel
Menloは、今年ポストトレーニングを行うAI開発者の割合が6%から10%に増えたと書いている。最も典型的な事例は、CursorがKimi K2.5上でComposer 2を訓練し、強化学習段階の推論をFireworksが提供したことだ。
Menloのデータは独立系アプリ企業の置かれた状況を克明に映し出している。今年の企業AI支出1768億ドルのうち、Anthropic、OpenAI、Googleの3研究所が1227億ドルを占め、割合は69%で、1年前は50%だった。うち研究所自社のアプリが400億ドルを取っている。
340億ドルのプログラミング分野だけを見ると、Claude CodeとCodexの2製品が240億ドルを占め、70%に達する。
アプリ企業が成功するほど、上流に対してこの市場が十分大きいことを証明できる。そして市場が十分大きいと証明されれば、モデルと計算資源を握る上流が自ら参入する理由がますます強くなる。中間業者のままでいれば、いずれ上流に押しつぶされる。
今年1月初め、Cursorは社内で「War Time」と呼ばれる会議を開き、創業者のMichael Truellは全員に自社モデル開発の加速を求めた。
しかしアプリ企業が上を目指すのは容易ではない。Cursorの手元には、数百万のプログラマーが毎日コードを書き、ファイルを変更し、ターミナルを走らせる実際のインタラクション軌跡があり、これは強化学習の最良の燃料だ。しかし手元にあるのは数万枚のGPUだけで、百万枚のカードはなく、半年以上かけてゼロから兆パラメータの事前学習基盤を訓練する時間もない。
それとは別に、Cursorが社内会議を開いてから数日後、Anthropicはルールを厳格化し、サードパーティのプログラミングツールが個人サブスクリプションアカウントでログインして呼び出すことを許可しなくなった。
唯一の活路は、オープンソースの世界から優れた素体を借りてきて、良い鋼をすべて後半の強化学習に使うことだった。
3月19日、CursorはComposer 2をリリースした。価格は入力0.5ドル、出力2.5ドルで、ちょうど当時のClaude Opus 4.6の10分の1だった。CursorのLee Robinsonは後に、最終モデルが消費する計算資源のうち、約4分の1だけが基座モデル由来で、残りはすべてCursor自身のトレーニングに費やされたと述べた。
これはアプリケーション企業がオープンソースモデルを選ぶ基準を書き換えた。
以前は誰もがオープンソースモデルを選ぶとき、買ってそのまま着られる既製服を選ぶように、公開ベンチマークで2点でも多く取った方を選んでいた。しかしCursorがその後公開した46ページの技術レポートの付録で、研究チームは、候補基座を評価する際に、チームは意図的にプログラミングAgent系のスコアを見なかったと書いている。その理由は、こうしたベンチマークは最終的な効果に対する予測力がより弱いからだ。Agentや長距離タスクの能力は強化学習の段階で大きく変わるからである。
多くのモデルは、ベンチマーク公開日に見栄えを良くするため、出荷前に特定の题库向けのファインチューニングを詰め込まれており、重み空間は水を吸い尽くしたスポンジのように圧迫されている。外から見ればスコアは高いが、買ってきてさらに3倍の強化学習計算資源を注ぎ込もうとすると、モデルはすぐに能力崩壊を起こす。
Cursorは候補モデルを自社の現場に直接連れてきて試用させた。
彼らがテストしたのは3つだけだ。基盤となるコーディング知識の蓄積、1つのファイルが連続して数十回変更された後の状態追跡能力、そしてCursorのプライベートな大規模コードベース上でのモデルのperplexityである。
テストの結果、Kimi K2.5が残った。レポートが挙げた理由は、総合的な性能が強く、Cursor自身のインフラ上で効率的に動作したことだった。継続的な事前学習と強化学習を経て、Composer 2はCursor独自の評価セットCursorBenchで基座の36.0から61.3に上昇し、Claude Opus 4.6の58.2を超えた。
5月、Cursorは同じK2.5基座の上でComposer 2.5をリリースした。
春から夏にかけてのこの突破は、シリコンバレーに一つのサンプルを残した。最先端のアプリケーション企業にとって、オープンウェイトモデルはもはやコスト削減の代替品ではなく、少数ながら手に取ってその上にさらに資金を投じて自社資産を訓練できる出発点なのだ。
茶代
Cursor は K2.5 をベースに訓練した Composer 2 を自社ユーザーに提供しており、アメリカ企業が本番環境で Kimi を呼び出している。こうしたトラフィックを受け止めているのは、主に Fireworks や Together といったアメリカの推論クラウドだ。
Kimi、Fireworks、Cursor を並べてみると、非常に絶妙な役割分担が見えてくる。
商業化能力を早く示したい企業なら、自社モデルがシリコンバレーで人気だと知った第一反応は、たいていサンフランシスコにオフィスを借り、高給で企業営業を引き抜き、直接アメリカの大顧客の扉を叩いて、中間の差益をすべて自分の懐に入れることだ。
月之暗面はそうしなかった。
2025 年 7 月、Menlo も中間レポートで、アメリカ企業が中国企業の API を直接呼び出したがらないことがオープンソースモデルのシェア停滞の原因の一つだと書いている。このコンプライアンスと信頼の壁は、営業がカリフォルニアまで飛んで口を酸っぱくしても越えられない。
その壁に無理にぶつかるより、手前のうまみはアメリカ現地のパートナーに譲ったほうがいい。Kimi のエンジニアリングチームはモデル公開の前後に Fireworks などのプラットフォームと協力して推論エンジンを調整し、アメリカ企業はアメリカのクラウド事業者と契約を結び、データはアメリカのデータセンターに留める。
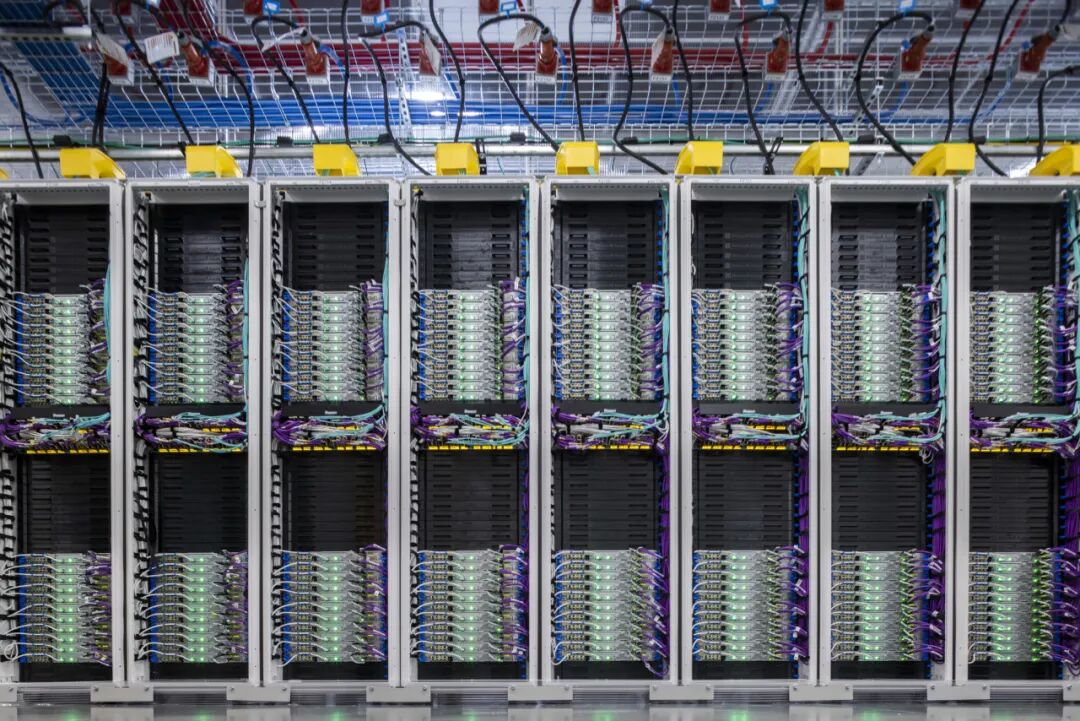
アメリカ・ワシントン州クインシーにあるマイクロソフトのデータセンターのサーバーラック
画像出典:John Brecher / Microsoft
月之暗面が商売に手を伸ばさなかったからこそ、Fireworks も本気で Kimi を推す気になり、Cursor のエンジニアも主力製品を K2.5 の重みの上に築く勇気を持てた。みんなが儲かるときに、このことは初めて軌道に乗る。
月之暗面自身の収益問題については、そのルールを K3.1 Pro のライセンスに書き込んでいる。
企業内でのデプロイ、研究、あるいは微調整して自社製品に使う場合は、事前の連絡は不要だ。話し合いが必要なのは二つの場合だけ。一つは、モデルホスティングに使い、外部に推論や微調整サービスを提供し、連続 12 か月の収益が 2000 万ドルを超える場合、事前に月之暗面と別途契約を結ぶ必要がある。もう一つは、エンド製品の月間アクティブユーザーが 1 億を超えるか月収益が 2000 万ドルを超える場合、インターフェース上にモデル名を明示的に表示する必要がある。月之暗面の公式製品または認定推論パートナーを通じて使用する場合は、この二つの制約を受けない。
8月、ロイターは、月之暗面(ムーンシャット・AI)がマイクロソフト、アマゾン、グーグルとK3関連サービスの収益分配について交渉中で、最大30%を要求していると報じた。
それから1ヶ月も経たない米国時間9月18日、アマゾンはK3をBedrockに搭載した。グローバル標準プランの価格は月之暗面公式と同じ3ドル、15ドルで、分配比率は公開されていない。
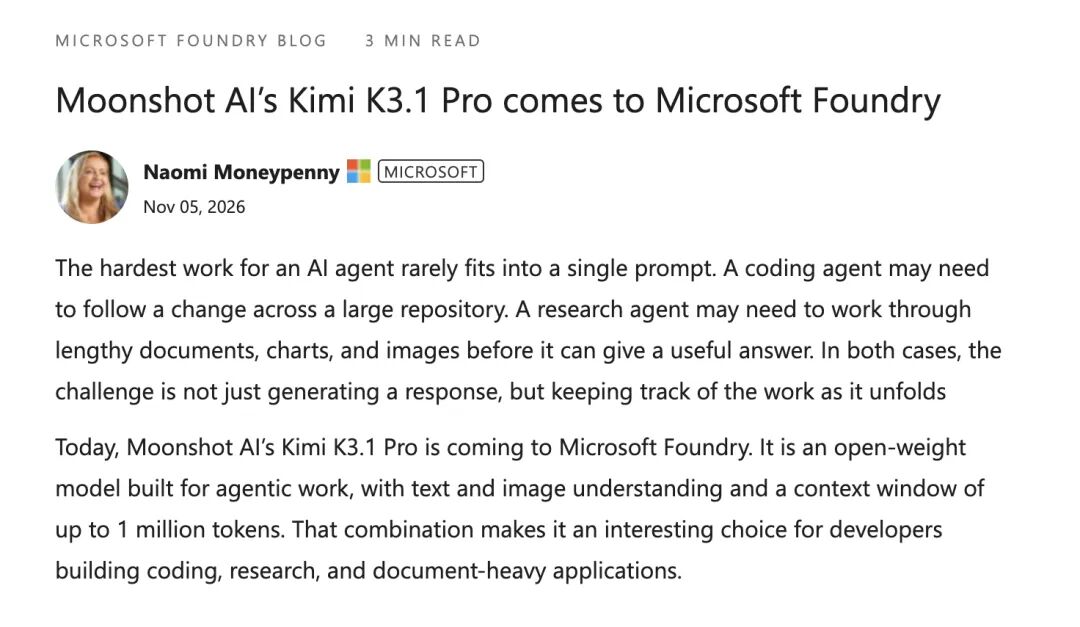
マイクロソフトのルートはやや回りくどい。K3は7月末にすでにMicrosoft Foundryに入っていたが、当時はFireworksが背後で推論を動かしており、Foundryは接続を担当するだけだった。米国時間11月5日、マイクロソフトは自社ブログでK3.1 Proが正式にFoundryに搭載されたと発表した。
昔ながらの商売人の言葉で言えば、これは「小道は自由に通れ、大通りでは茶銭を払え」ということだ。100社のうち99社がまだ試行錯誤中のスタートアップには、Kimiは一銭も取らない。誰かが本当に年間数千万ドル規模の大きな商売を成し遂げたときに、改めて規則に従って腰を据えて話し合う。
どの部分の金を今は自分が稼ぐべきでないかをはっきり分かっていることは、時にどうやって稼ぐかを知ることよりも、意志の強さを試される。
黒猫も白猫も
この61%の断面から少し視野を広げると、今年の秋のこのデータ群が興味深いのは、大規模モデル産業が3年の試行錯誤を経て自然に育んできた新たな関係を映し出しているからだ。
2年前、シリコンバレーでは業界の終局をめぐる議論が白黒はっきりしていた。一方の派はクローズドソースのフラッグシップがすべてを席巻し、アプリケーション企業はいずれ薄っぺらいインターフェース層に成り下がると考えた。もう一方の派は、オープンソースが知能を無料の水道水に変え、すべてのモデル企業が儲からなくなると信じていた。
2026年になっても、どちらの図式も現実にはならなかった。
AnthropicとOpenAIは依然として米国企業の大規模モデルAPI支出の86%を占めている。ウォール街の投資銀行がクロスボーダーM&A契約を審査するときも、製薬企業がゼロ容錯の文献調査を行うときも、依然として迷わず最も高価なクローズドソースのフラッグシップに金を払う。オープンソースに流れる予算も、安価な計算力の競争場にはならず、むしろKimiのようなフロンティアに近いモデルに集まっている。
オープンソースとクローズドソースの間は、もはや二者択一の塹壕ではない。複雑なタスクの触媒作用下で、両者の間には広い交界地帯が生まれた。
この交界地帯では、Kimiをヘビーに使う多くのシリコンバレー企業が、同時にAnthropicとOpenAIの大口顧客でもある。製品の初期段階では、最強のクローズドソースモデルで形態を走らせ、需要を検証する。ある長いチェーンのワークフローが成立することが検証され、呼び出し量が指数関数的に拡大し始めたとき、あるいはCursorのように独自のインタラクションデータを十分に蓄え、業界の経験を重みに訓練し込もうとするとき、彼らは振り向いて、フロンティアに最も近く、かつ自ら深く改造することを許すオープンな基盤を探すのだ。
かつて、モデル企業とアプリケーション企業の間では、一方がAPIを売り、他方がAPIを買うという関係だった。モデル企業が自らアプリケーションを作り始めた瞬間、双方はたちまちゼロサムゲームの敵同士になった。
しかし今、アプリケーション企業はオープンモデルに計算資源の4分の3を投じて継続的な学習を行い、「半分モデル企業」となっている。モデル開発者の影響力も、もはやどれだけのtokenを売ったかだけで測られるものではなく、どれだけの他社のコア製品がその重みから生まれているかによっても測られる。
Kimi K3.1 Pro 公式発表メインビジュアル
画像提供:月之暗面
Menloレポートが発表された翌日の11月4日、月之暗面は予定通りHugging FaceでKimi K3.1 Proの完全な重みを公開した。月之暗面自身が公表した成績によれば、プログラミングAgentの実戦能力を測るTerminal-Bench 4.0で65.7%を獲得し、GPT-6 Astraの58.2%を上回り、Claude Opus 5.5の66.4%とはわずか0.7ポイント差だった。
製品パイプラインをオープンソースの基盤に賭ける米国のチームにとって、この0.7ポイント、そしてK2、K2.5、K2.6からK3、K3.1 Proへと数か月ごとに一歩ずつ前進するリズムは、どんなオープンソースのスローガンよりも安心させてくれる。後段学習で作られた専用モデルは、数か月ごとに最先端に合わせて再学習する必要がある。基盤を一つ選ぶことは、その企業の今後1年のイテレーション速度を同時に選ぶことでもある。
サンフランシスコでは、ピッチ資料の最初のページに「私たちの基盤は中国製です」と書くスタートアップはおそらくないだろう。大規模モデルの原産地は依然として敏感な言葉である。
しかし、毎日稼働し続けるサーバールームに戻り、エンジニアが画面を見つめながら50ラウンドのAgentループが完走するのを待つ深夜に戻れば、あらゆるスローガンは実用主義に道を譲る。ネズミを捕まえられる者が良い猫なのだ。
海の向こうのアプリケーション企業が、本当に酷使に耐えるパートナーを必要としたとき、顔を上げれば、それがとっくにそこに立っているのが見える。
原文リンク
BlockBeats の公式コミュニティに参加しよう:
Telegram 公式チャンネル:https://t.me/theblockbeats
Telegram 交流グループ:https://t.me/BlockBeats_App
Twitter 公式アカウント:https://twitter.com/BlockBeatsAsia

 関連記事