機械学習モデルのためのカーネルレベルの証明メカニズム
原題: 機械学習モデルのカーネルワイズ証明
原著者: Zhiyong Fang
象をどうやって食べるか?一口ずつ食べればいい。
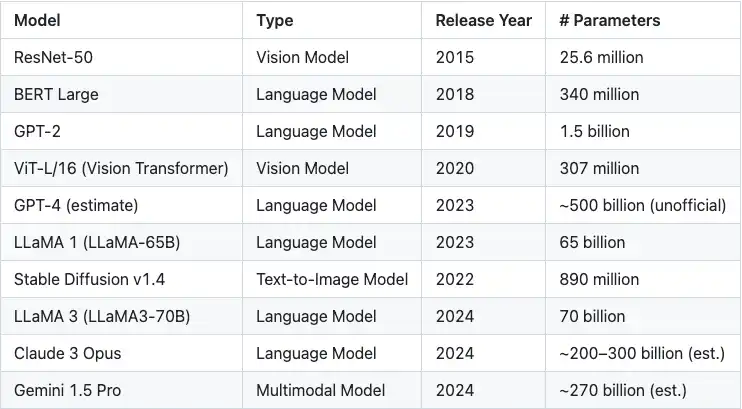
近年、機械学習モデルは驚異的な速度で飛躍的な進歩を遂げています。モデルの機能が向上するにつれて、その複雑さも急速に増大しており、今日の高度なモデルには数百万、あるいは数十億ものパラメータが含まれることも珍しくありません。この規模の課題に対処するため、証明時間、検証時間、証明サイズの間で動的なバランスを実現することに常に取り組んでいるさまざまなゼロ知識証明システムが登場しました。
表 1: モデル パラメータ サイズの指数関数的増加
ゼロ知識証明の分野における現在の研究のほとんどは、証明システム自体の最適化に焦点を当てていますが、重要な側面が見落とされがちです。それは、証明のために大規模なモデルをより小さく管理しやすいサブモジュールに適切に分割する方法です。なぜこれがそれほど重要なのかと疑問に思うかもしれません。
詳しく説明しましょう。
最新の機械学習モデルには数十億のパラメータがあることが多く、暗号化処理がない場合でも大量のメモリ リソースを消費します。この課題は、ゼロ知識証明(ZKP)のコンテキストでさらに増幅されます。
各浮動小数点パラメータは算術フィールドの要素に変換する必要があり、それ自体がメモリ使用量を約5〜10倍に増加させます。さらに、代数フィールドで浮動小数点演算を正確にシミュレートするために、通常は約5倍の追加演算オーバーヘッドが導入されます。
これらを合わせると、モデルの全体的なメモリ要件は元のサイズの25〜50倍に増加する可能性があります。たとえば、10億の32ビット浮動小数点パラメータを持つモデルでは、変換されたパラメータを格納するためだけに100〜200 GBのメモリが必要になる場合があります。中間計算値と証明システム自体のオーバーヘッドを考慮すると、全体的なメモリ使用量は簡単にTBレベルを超えます。
Groth16やPlonkといった現在主流の証明システムでは、最適化されていない実装では、関連するすべてのデータが同時にメモリにロードできると仮定することが一般的です。この仮定は技術的には実現可能ですが、実際のハードウェア環境では非常に困難であり、利用可能な証明計算リソースを大幅に制限します。
Polyhedra のソリューション: zkCuda
zkCuda とは?
zkCUDA 技術ドキュメントで説明したように、Polyhedra の zkCUDA は、高性能回路開発用のゼロ知識コンピューティング環境であり、証明生成の効率を向上させるように設計されています。回路の表現力を犠牲にすることなく、zkCUDA は基盤となる証明器とハードウェアの並列処理を最大限に活用して、高速な ZK 証明生成を実現します。
zkCUDA 言語は、構文とセマンティクスの点で CUDA と非常に類似しており、既に CUDA の経験がある開発者にとって非常に使いやすいものです。セキュリティとパフォーマンスの両方を確保するために、最下層では Rust で実装されています。
zkCUDA を使用すると、開発者は次のことが可能になります。
高性能な ZK 回路を迅速に構築します。
MPI をサポートする GPU やクラスター環境などの分散ハードウェア リソースを効率的にスケジュールして活用し、大規模な並列コンピューティングを実現します。
zkCUDA を選ぶ理由
zkCuda は、GPU コンピューティングにヒントを得た高性能なゼロ知識コンピューティング フレームワークです。超大規模な機械学習モデルをより小さく管理しやすいコンピューティング ユニット (カーネル) に分割し、CUDA のようなフロントエンド言語によって効率的な制御を実現します。この設計により、次の主な利点がもたらされます。
1.正確にマッチングした証明システムの選択
zkCUDA は、各コンピューティングカーネルのきめ細かな分析をサポートし、最適なゼロ知識証明システムとマッチングさせます。例:
高度に並列化されたコンピューティングタスクの場合、構造化された並列処理に適した GKR などのプロトコルを使用できます。
小規模なタスクや不規則に構造化されたタスクの場合、コンパクトなコンピューティングシナリオでオーバーヘッドが低い Groth16 などの証明システムを使用する方が適しています。
バックエンドの選択をカスタマイズすることで、zkCUDA はさまざまな ZK プロトコルのパフォーマンス上の利点を最大限に活用できます。
2. よりスマートなリソース スケジューリングと並列最適化
証明カーネルごとに、CPU、メモリ、I/O のリソース要件が大きく異なります。zkCUDA は、各タスクのリソース消費量を正確に評価し、全体的なスループットが最大化されるようにインテリジェントにスケジュールできます。
さらに重要なのは、zkCUDA が CPU、GPU、FPGA などの異種コンピューティング プラットフォーム間でのタスク分散をサポートし、ハードウェア リソースを最適に利用して、システムレベルのパフォーマンスを大幅に向上できることです。
ZkCuda は GKR プロトコルに自然に適合します
zkCuda は、さまざまなゼロ知識証明システムと互換性のある汎用コンピューティング フレームワークとして設計されていますが、GKR (Goldwasser-Kalai-Rothblum) プロトコルとのアーキテクチャ的な適合性が非常に高いです。
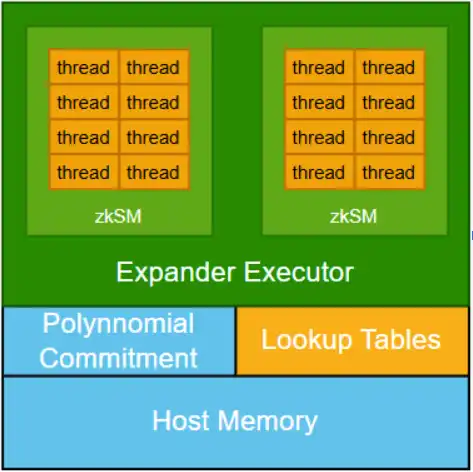
アーキテクチャ設計の観点から見ると、zkCUDA は多項式コミットメント メカニズムを導入することで、さまざまなサブコンピューティング カーネルを接続し、すべてのサブコンピューティングが一貫した共有データ上で実行されるようにします。このメカニズムはシステムの整合性を維持するために重要ですが、かなりの計算コストも伴います。
対照的に、GKR プロトコルはより効率的な代替パスを提供します。各カーネルが内部制約を完全に証明することを要求する従来のゼロ知識システムとは異なり、GKR では計算の正確性の検証をカーネル出力から入力まで再帰的に遡ることができます。このメカニズムにより、各モジュールで完全に検証するのではなく、カーネル間の正確性を転送することができます。その中核となるアイデアは、計算グラフを通じて正しさの主張を追跡・伝達する機械学習における勾配バックプロパゲーションに似ています。
このような「証明勾配」を複数のパスで統合することはある程度の複雑さをもたらしますが、このメカニズムこそがzkCUDAとGKRの緊密な連携の基盤となるものです。機械学習のトレーニングプロセスにおける構造的特徴を調整することで、zkCUDAはより緊密なシステム統合と、大規模モデルシナリオにおけるより効率的なゼロ知識証明生成を実現することが期待されています。
予備的な結果と今後の方向性
zkCudaフレームワークの初期開発を完了し、KeccakやSHA-256などの暗号ハッシュ関数や小規模機械学習モデルなど、複数のシナリオでテストに成功しました。
今後、メモリ効率の高いスケジューリングやグラフレベルの最適化といった、成熟したエンジニアリング手法を現代の機械学習トレーニングにさらに導入したいと考えています。これらの戦略をゼロ知識証明生成プロセスに組み込むことで、システムのパフォーマンス限界と適応柔軟性が大幅に向上すると考えています。
これは単なる出発点に過ぎません。zkCuda は、効率的で、拡張性と適応性に優れた汎用的な証明フレームワークを目指して進化を続けます。
BlockBeats の公式コミュニティに参加しよう:
Telegram 公式チャンネル:https://t.me/theblockbeats
Telegram 交流グループ:https://t.me/BlockBeats_App
Twitter 公式アカウント:https://twitter.com/BlockBeatsAsia
 関連記事