5分で、AIをあなたの第2の脳にする
原文のタイトル: Claude Code + Obsidian Ultimate Guide(AIセカンドブレインの構築)
原著者: AI Edge
翻訳: Peggy,BlockBeats
編集者注: この記事では、Claude CodeとObsidianに基づいて構築された個人向け知識システムについて説明しており、その中心にあるのは従来の RAG モードの「クエリごとの一時的な検索」ではなく、AIが持続的に進化する知識ベース(ウィキ)を構築し維持する試みです。
構造的には、このシステムは次の3層に分割されます:
· まず第一に、ノート、記事、トランスクリプトコンテンツなど、変更できない入力ソースを含む元のデータ層;
· 次に、AIによって維持される構造化された知識ベースで、継続的な更新を通じてクロスリンクと関係の構築を完成させる;
· 最後に、知識の組織方法とシステムの動作ロジックを規定するSchemaルール層です。
この構造を踏まえ、システムは次の3つの主要操作を通じて実行されます:Ingest(取り込み)、外部情報を連続的に組織に取り込む;Query(クエリ)、知識の瞬時の呼び出しを実現する;Lint(リント)、構造の整合性をチェックし潜在的な問題を修正するために使用されます。
このメカニズムにより、知識は一時的な対話結果にとどまるのではなく、「記述—整理—再利用」のサイクルを通じて、再利用可能な長期アセットに徐々に沈殿していきます。著者は、このようなモデルにより、知識が「複利」の蓄積効果に似た能力を持つようになると述べ、これにより個人の認知負担が軽減され、モデルの出力の正確性とコンテキストの整合性が向上すると主張しています。
ただし、このシステムの効果的な運用は、持続的な入力とメンテナンスに依存しています。安定したデータの組み込みと構造の更新が行われない場合、この「セカンドブレイン」は本当の蓄積効果を生み出すことが難しくなり、その利点も相応に減少するでしょう。
以下はオリジナルの文章です:
Claude Code + Obsidianは、私が使った中で最も強力なAIの組み合わせです。
私はほぼ「AIセカンドブレイン」を構築し、私の考え、読書、執筆、オンラインリサーチなどすべてをそこに取り込みました。そこには私のビジネスプラン、私が公開したすべてのYouTubeビデオ、書いた記事、および私にとって重要なすべてが含まれています。
Claude Code + Obsidianは、さまざまなプラットフォームで急速に人気を博し、これは偶然ではありません。
個人的に、このAIシステムは私の認知負荷を大幅に軽減し、私が本当に重要だと考えることに集中できるようにしてくれました-ビジネスであっても個人生活であっても。
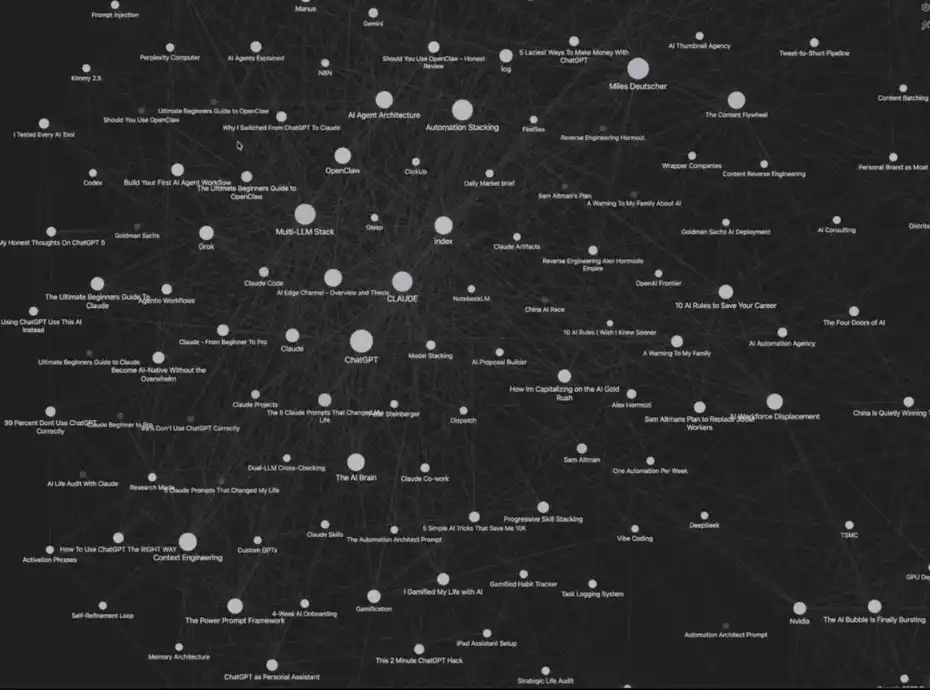
私のクロードコード+オブシディアンシステム
このシステムは少々複雑に見えるかもしれませんが、実際には構築には5分しかかかりません。さらに重要なのは、それがメモリ機能を備えており、使用するにつれて自己最適化されていくことです。
次に、この「AIセカンドブレイン」システムを一緒に再現していきますが、これは本当にあなたの効率を向上させることができるものです。
最後まで記事を読むことをお勧めします-私はClaude Code+Obsidianの完全な操作クイックリファレンスシートと、すべてのリソース(すべて無料)を記載しています。
開始する前に
このシステムは私だけのオリジナルではありません。そのインスピレーションは、数日前にAndej Karpathyが「LLMナレッジベース」についてツイートしたことから得ました。
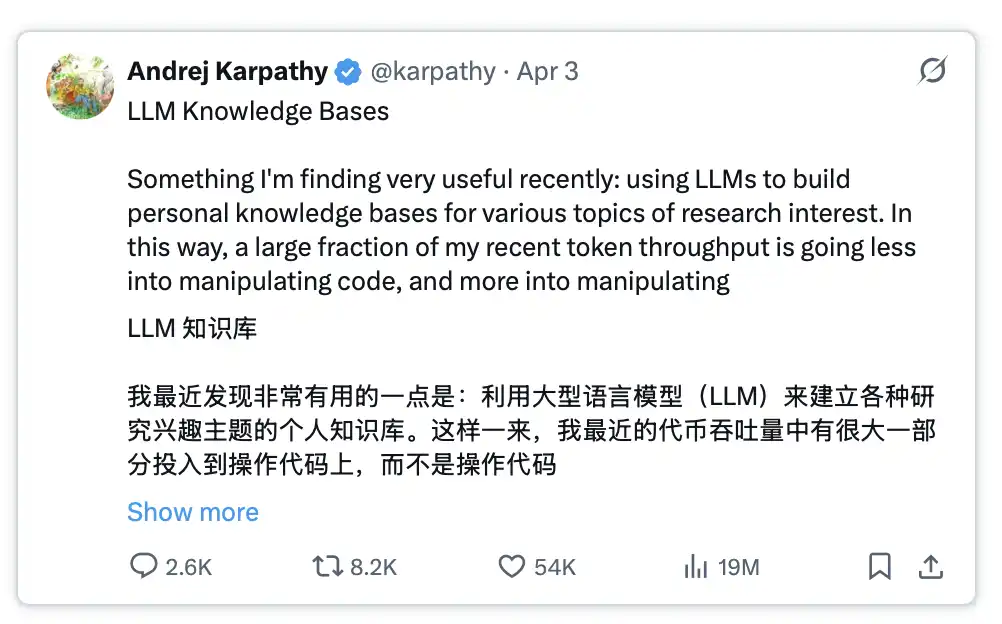
関連記事: https://x.com/karpathy/status/2039805659525644595
このツイートが急速に拡散したのは、それが現在のAIの発展における重要な課題に対するアプローチを提供したからです。
その問題は次のようなものです:新しい対話を開始するたびに、または新しいAIツールに切り替えるたびに、プロンプトの再入力やコンテキストの再提供を何度も繰り返さなければならず、ほぼゼロから始める必要があります。
しかし、このシステムのプロンプトワードをObsidianとClaude Codeと組み合わせると、この問題は完全に解決され、さらにAIの出力品質が大幅に向上します。
このシステムはどのように機能するのですか?
このシステム全体は、4つの主要モジュールで構成されています:
1、あなたのデータ:記事、ノート、トランスクリプトコンテンツ、アイデアなど
2、組織方法:Obsidian内でClaude Codeを使用して自動整理
3、リアルタイム呼び出し:いつでもこの「データベース」に質問し、回答を得ることができます
4、進化メモリ: システムは使用するにつれてますます賢くなります
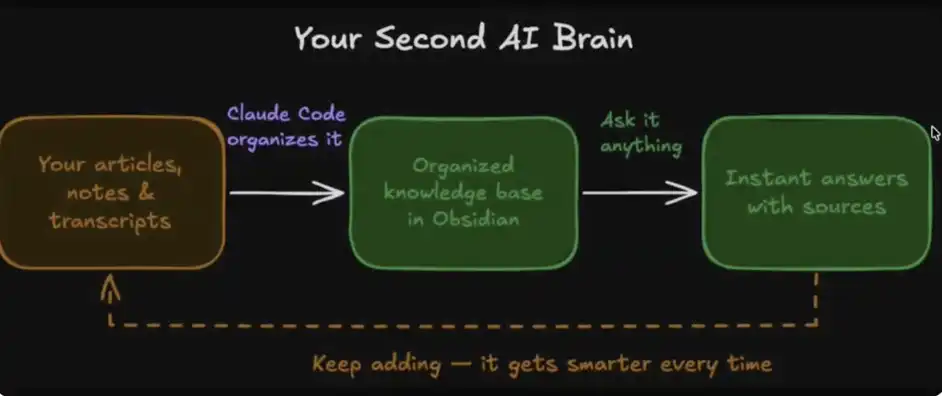
あなたの AI セカンドブレイン
このシステムの真の力は何ですか?
人間として、私たちの認知帯域には限界があります。私たちは忘れることがあり、時には異なる考えを結びつけることが難しいです。追跡および処理できる情報は限界があります。
しかし、この 4 つのモジュールからなるシステムを利用することで、実際には自身の認知負担を軽減し、「情報の結びつけ、整理、理解」という作業を Obsidian と Claude Code に任せることができます。
あなたの考えはシステム的に関連付けられ始め、1 つのメモが自動的に別のメモに関連付けられ、Claude を介してこれらの内容をいつでも再抽出、組み合わせ、呼び出すことができます。
この構造の下では、あなたの知識はもはや分散しておらず、継続的に呼び出しや再構築可能なネットワークとなります。ほぼ限界はありません。
5 分で自分の AI セカンドブレインを構築する方法
1、Obsidian をダウンロード
オフィシャルサイト: https://obsidian.md/
https://obsidian.md/
2、Vault(知識ベース)を作成
ダウンロードが完了すると、Obsidian は「Vault」を作成するように促します。
これはコンピュータ上のフォルダーと考えることができ、ここにすべてのコンテンツを保存し、Claude Code がこれらのデータにアクセスし管理できるようにします。
Vault の名前は任意に設定できます。たとえば、私はそれを「Obsidian Vault」と呼んでいます。
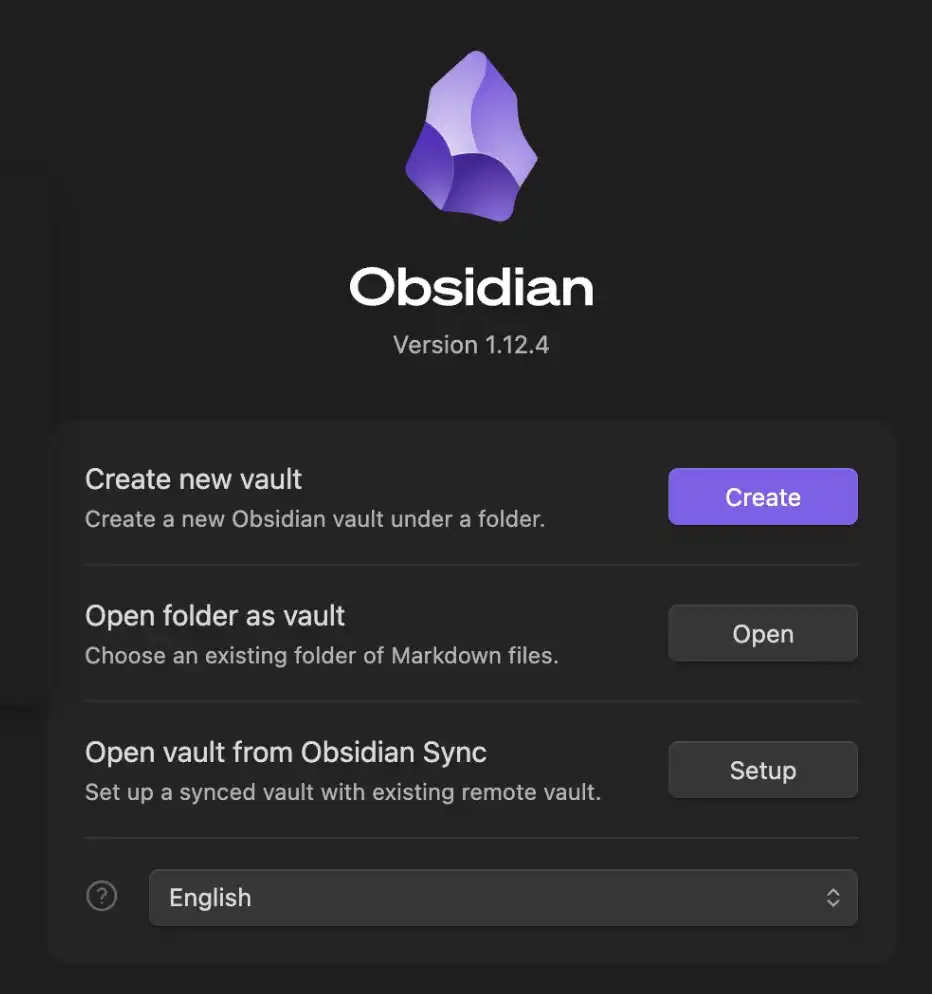
Obsidian Vault(知識ベース)
この Vault は、Obsidian がすべてのデータとメモを保存する場所です。すべての内容は MD(Markdown)ファイル形式で保存されます。
3. Claude Codeの設定
次に、Claude Codeにアクセスできる方法を設定する必要があります。私にとって(おそらくほとんどの人にとっても)、最も簡単な方法はデスクトップクライアントを直接使用することです。
メインチャット画面で、「フォルダーを選択」をクリックし、さきほど作成したObsidian Vaultを見つけて選択してください。
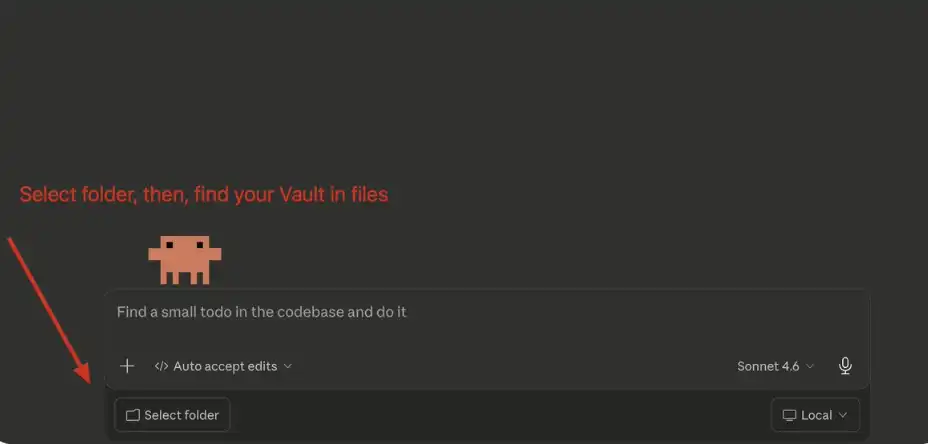
Claude Code: Vaultに接続
4. システムプロンプトの設定
フォルダーを選択した後、次のステップは、Andrej Karpathyのシステムプロンプトをメインチャットボックスに貼り付けることです。
このシステムプロンプトのセグメントをここでコピーできます:https://gist.github.com/karpathy/442a6bf555914893e9891c11519de94f
あなたの入力は次のようになるはずです:
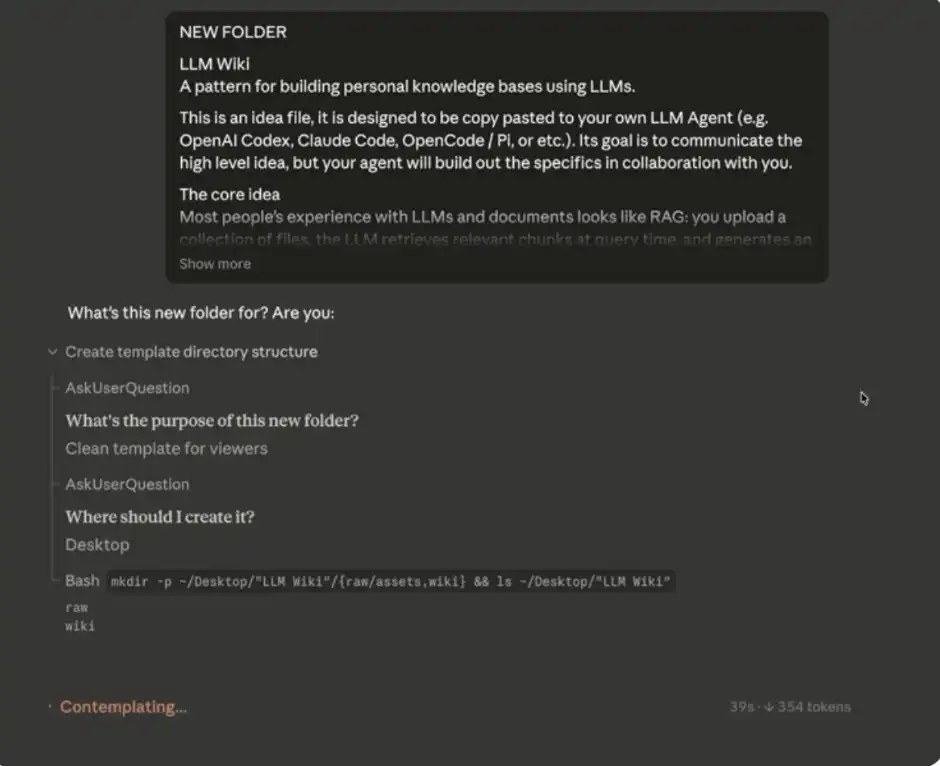
Claude Codeの初期入力
ヒント:Obsidianを手動で開かなくても構いません。MDフォルダー(つまり、Vault)と関連データをClaude Codeに提供すれば、Claude Codeがこれらのファイルを直接読み書きおよび編集できます。そしてこれらの内容は自動的にObsidianの「第二の脳」と同期されます。
5. データベースの構築
上記のシステムプロンプトを入力したら、Claude Codeは、あなたの「第二の脳」を初期化し、段階的に充実させるためのいくつかのデータソースについて尋ねてきます。
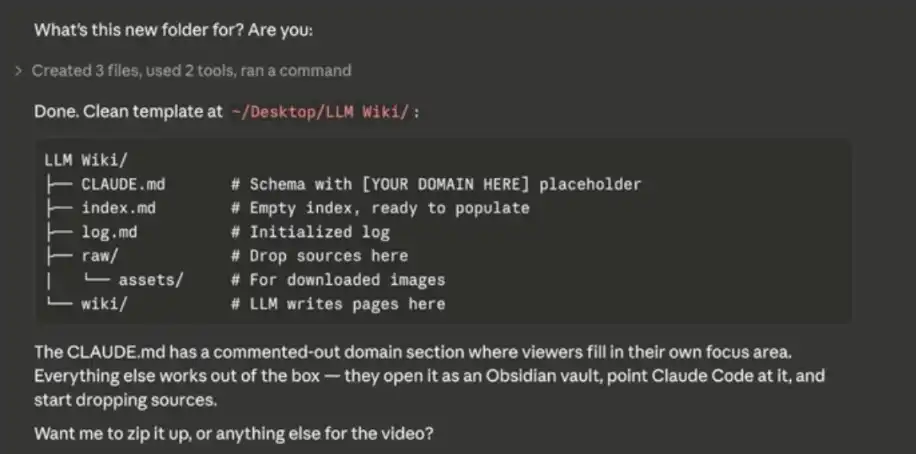
データベースの構築
Obsidian は「空白ノートブック」と考えることができます。最初はアクティブにコンテンツを入力する必要があり、データベースが徐々に構築されます。インポート可能なコンテンツには、ノート、CSV ファイル、Markdown / テキストファイルなどがあります。
いくつかの実用的なアドバイス:
・既存のノートツールからデータをエクスポートする
・Notion を使用している場合、CSV ファイルにエクスポートできます
・Claude(または他の大規模モデル)にあなたの情報についてまとめさせ、あなたの「セカンドブレイン」を初期化する
・既存の記事、コレクション、アイデアなどを一度にインポートします。これは初期データを構築する最適なタイミングであり、その後でも随時追加できます
大量のデータを持つ私のようなデータベースは、一朝一夕には完成しません。時間とともに入力し、徐々に蓄積されていくものです。
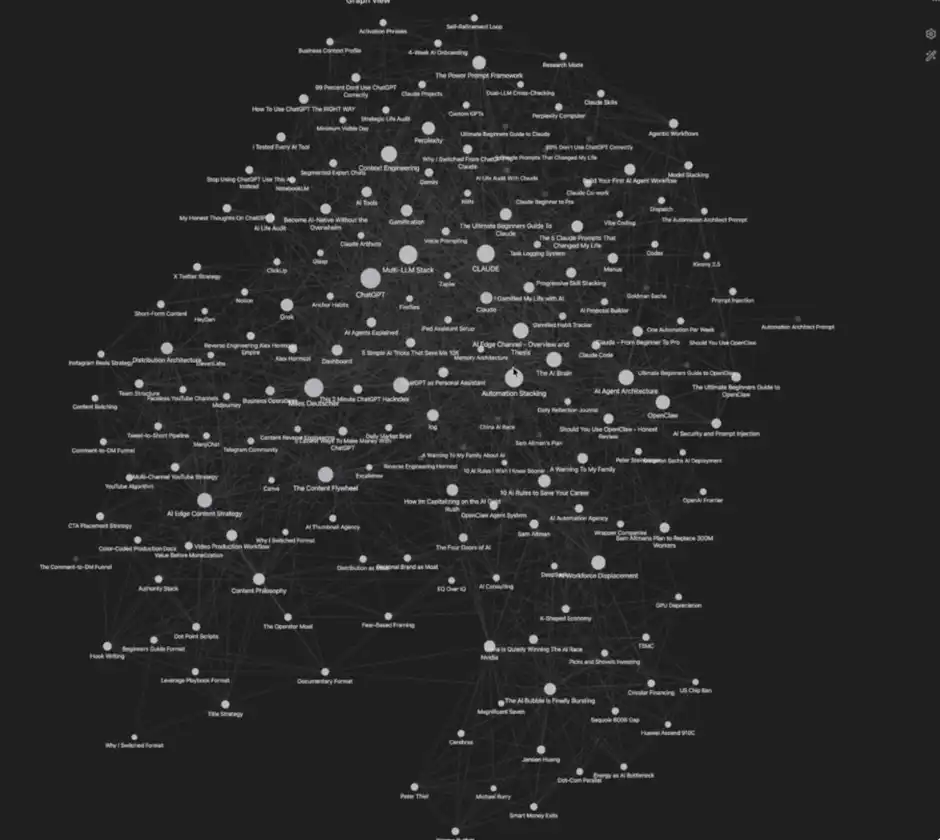
私のデータベース
これで、「AI セカンドブレイン」が構築されました。これで運用を開始できます。次に、いくつかの高度なテクニックを共有します。これにより、より効果的に活用できます。
高度なテクニック(Pro Tips)
1、Obsidian Chrome 拡張機能
システムにデータを簡単に追加したい場合は、Obsidian の Chrome 拡張機能をインストールするだけです。これにより、ウェブページを閲覧しているときに直接「Add to Obsidian(Obsidian に追加)」をクリックして、コンテンツをワンクリックで知識ベースに保存できます。これにより、「セカンドブレイン」を構築するプロセスが非常にスムーズになります。
私自身もこの機能を使用して、記事、ウェブページのデータ、研究資料などを収集しています。
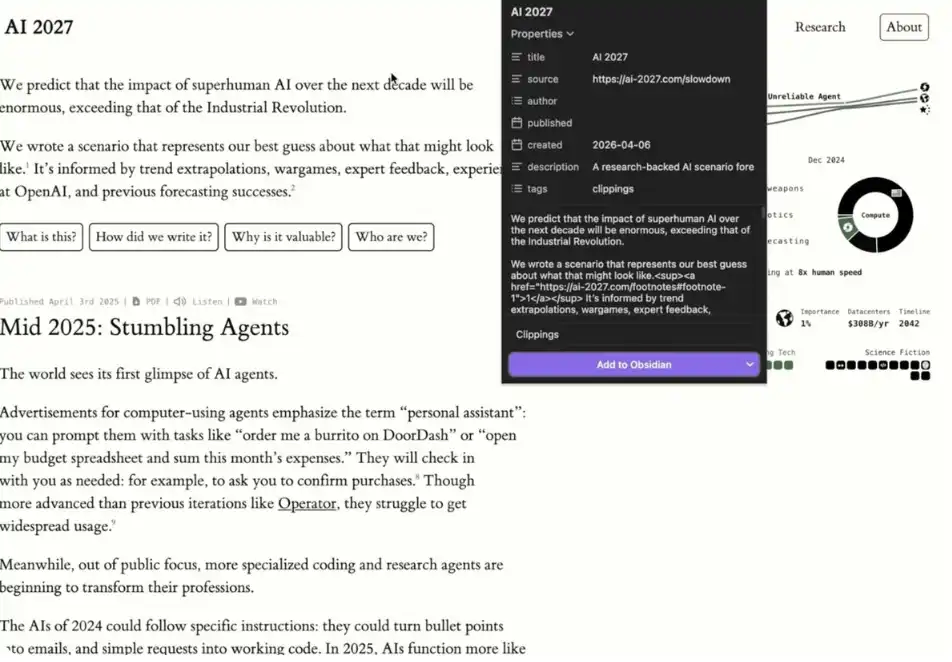
例:Obsidian Chrome 拡張機能の使用
拡張機能を介して追加されたデータは、最初は「孤立したデータソース」です。
次に、Claude Code に次のように伝えることができます。「私はさっき Obsidian に [x] を追加しました。これらのコンテンツを私の Wiki に統合するのを手伝ってください。」
Claude Code は新しいデータを自動的に既存のコンテンツと関連付け、リンクを生成し、それを本当の意味で「セカンドブレイン」に統合します。これがこのツールセットの強力な部分です。
2、フォルダを分けて作成する(Vault)
Andrej Karpathy は、独立した2つのフォルダ(Vault)の使用を提案しています:
・1つは仕事用 / ビジネスコンテンツ用
・もう1つは個人生活用 / ゴール管理用
私自身の使用経験も、このような構造が最も明確で効果的だと考えています。
3、実用性
私がこのシステムで最も価値ある用途だと感じたのは、実は非常にシンプルなものでした:あなたのLLMプロンプトをより精度高くすることです。
モデルがあなたの完全な個人情報、ビジネスプラン、執筆背景などのコンテキストにアクセスできると、より「カスタマイズされた」、現実に密接した高品質なプロンプト(さらには「スーパープロンプト」)を生成できます。
もちろん、このシステムの用途はそれだけではありませんが、もし最も実用的なシナリオから始めたい場合は、「プロンプトの品質向上」から始めることを強くお勧めします。
4、Orphans(オーファンノート)
Obsidianでは、「オーファン」とは、他のノートとリンクされていないデータポイントのことを指します。
この機能は非常に役立ちます。なぜなら、それによって次のことができるからです:
・統合されていないアイデアを見つける
・データベース内の「薄い領域」を発見する
・さらなる展開や深化が価値のあるコンテンツを判断する
つまり、それは整理ツールに留まらず、あなたが考える中での盲点を発見するのに役立つメカニズムです。
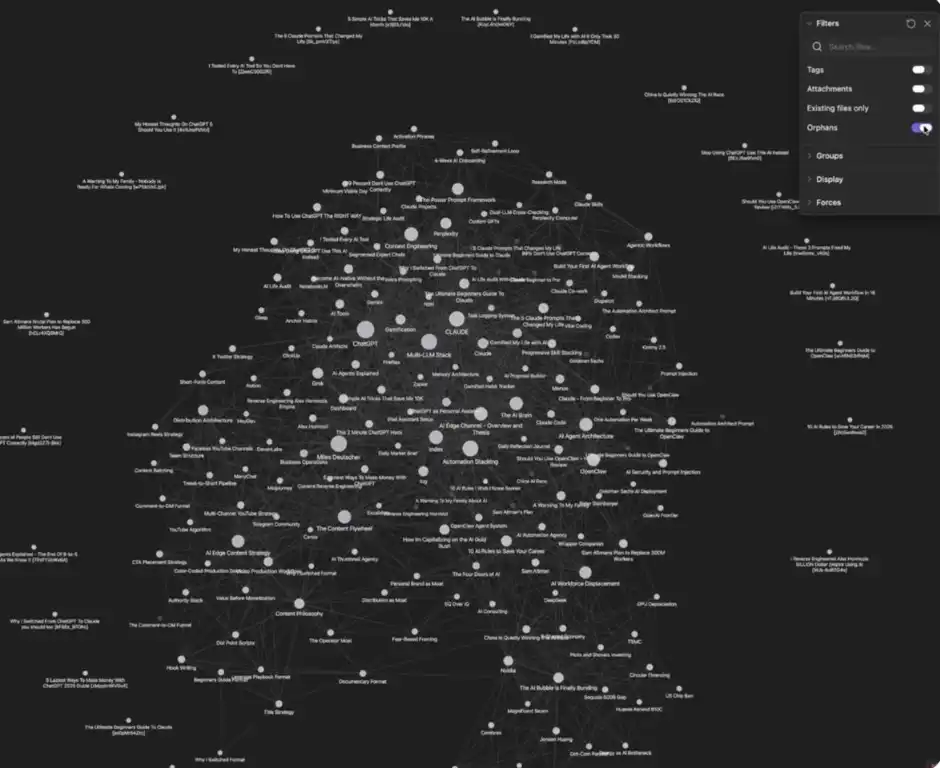
Orphans(オーファンノート)
右上隅で「3点」をクリックし、オーファンのスイッチを見つけてオンにすると、どのコンテンツがまだリンクされていないかを確認できます。
このシステムの潜在的な欠点
前述のように、メリット、使用シナリオ、最適化方法について多くを語りましたが、欠点は何でしょうか?このシステムを使用するのにあまり適していない状況はどのようなものでしょうか?
1、ビジュアルに慣れていない人
このシステムの主要な利点の1つは、データを視覚的に表示できることです。この方法に依存していないか、慣れていない場合、このシステムの助けは限定されるかもしれません。
2、一定のメンテナンスコストが必要
データベースを継続的にメンテナンスすることに応じない場合、このシステムはおそらく適していません。メンテナンスコストは高くありませんが、「セカンドブレイン」にデータを継続的に入力しないと、システムの価値を引き出すことが困難です。
3、ストレージの使用
すべてのコンテンツは、Markdownファイルの形式でローカルに保存されます。これには一定のデバイススペースが必要です。この点も事前に考慮する必要があります。
BlockBeats の公式コミュニティに参加しよう:
Telegram 公式チャンネル:https://t.me/theblockbeats
Telegram 交流グループ:https://t.me/BlockBeats_App
Twitter 公式アカウント:https://twitter.com/BlockBeatsAsia
 関連記事