黄仁勋最新ポッドキャスト:NVIDIAのモートン氏に学ぶ競争優位の持続可能性
ビデオタイトル:Jensen Huang: – Nvidiaの护城河は維持されるか?
ビデオの著者:Dwarkesh Patel
翻訳:Peggy,BlockBeats
Editor's Note: While the outside world is still discussing whether "Nvidia's moat comes from the supply chain," this conversation argues that what is truly difficult to replicate is not the chip itself, but the entire system capability to "tokenize electrons" — that is, the synergistic operation from the computing architecture, software system to the developer ecosystem.
This article is a translation of the conversation between Dwarkesh Patel and Jensen Huang. Dwarkesh Patel is one of Silicon Valley's most watched tech podcast hosts today, hosting the YouTube channel Dwarkesh Podcast, specializing in in-depth research interviews, engaging in long-term dialogues with AI researchers and key figures in the tech industry.
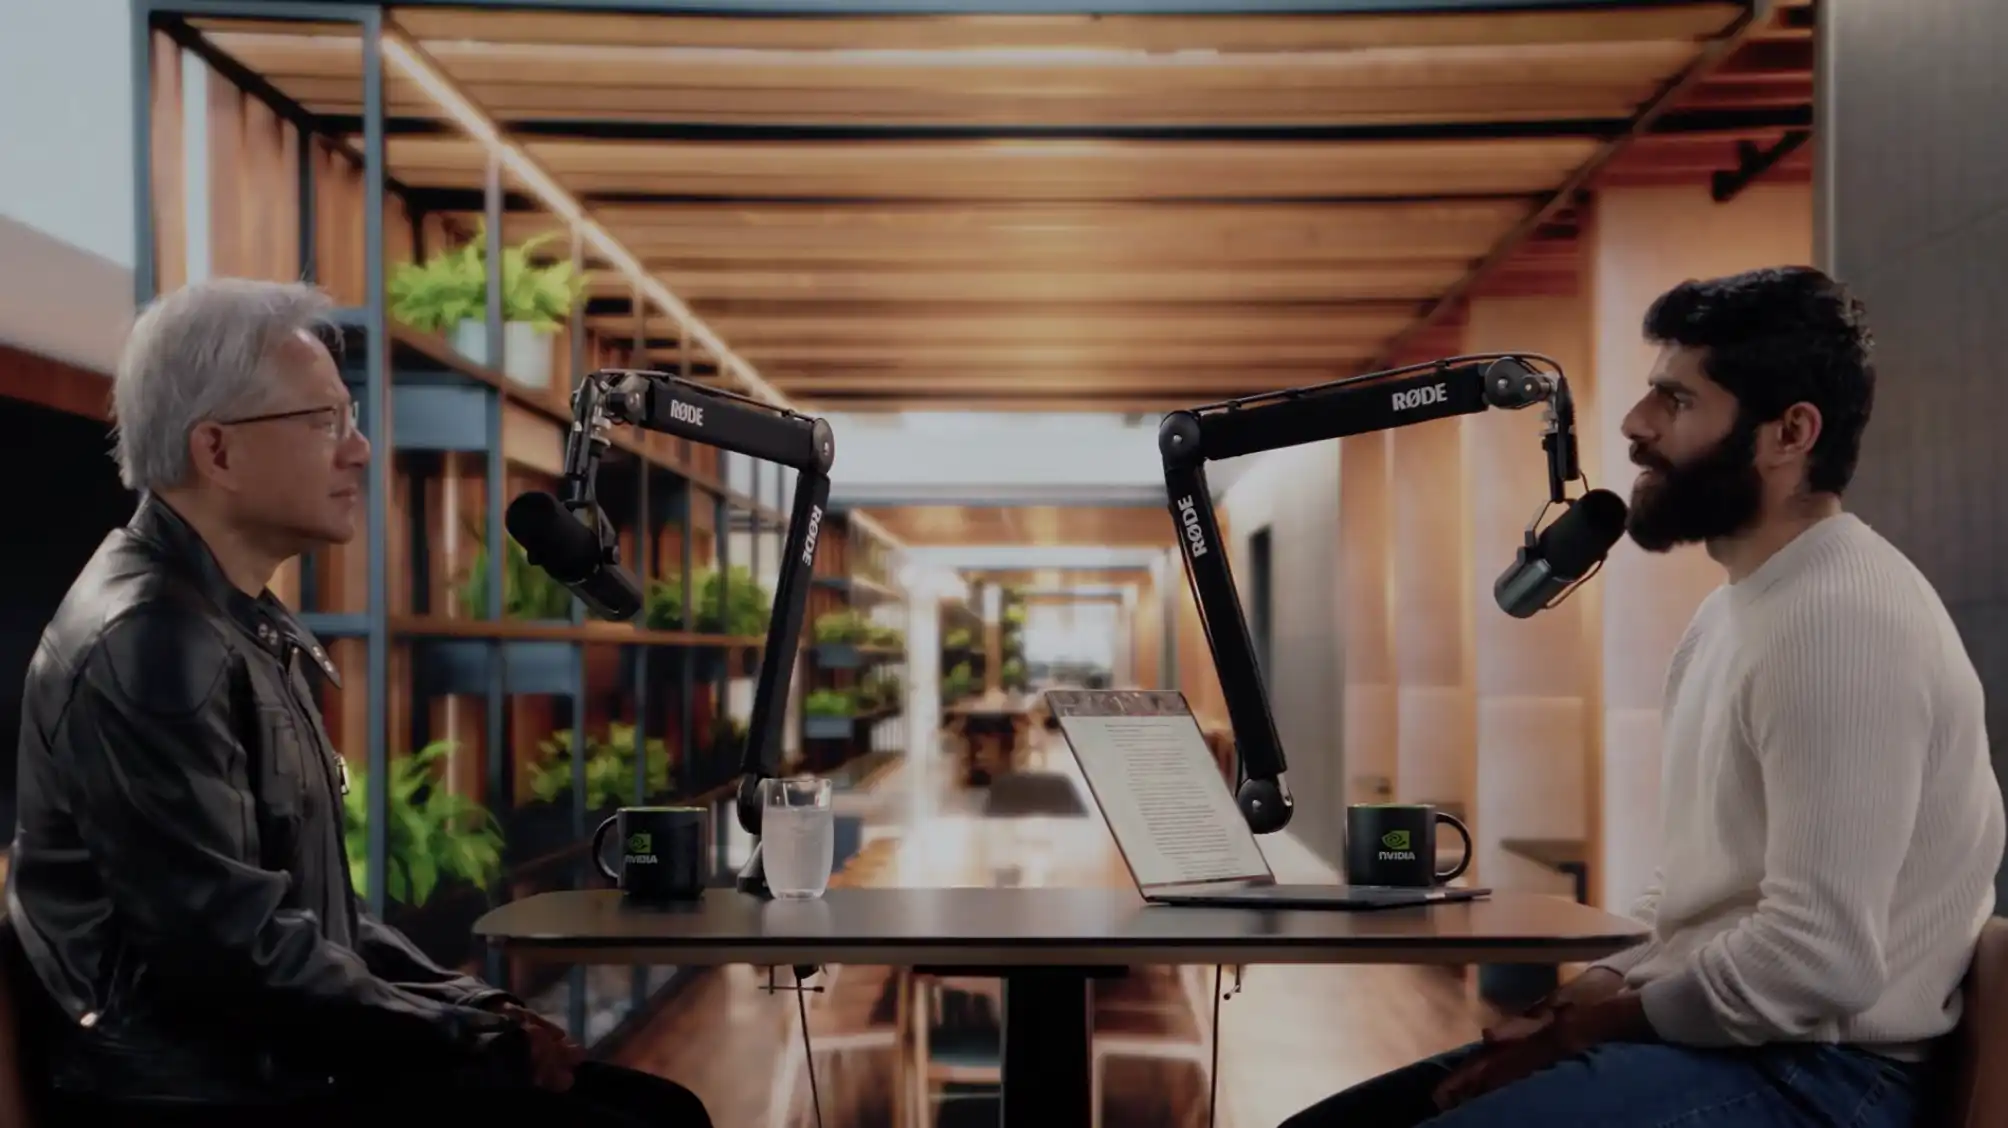
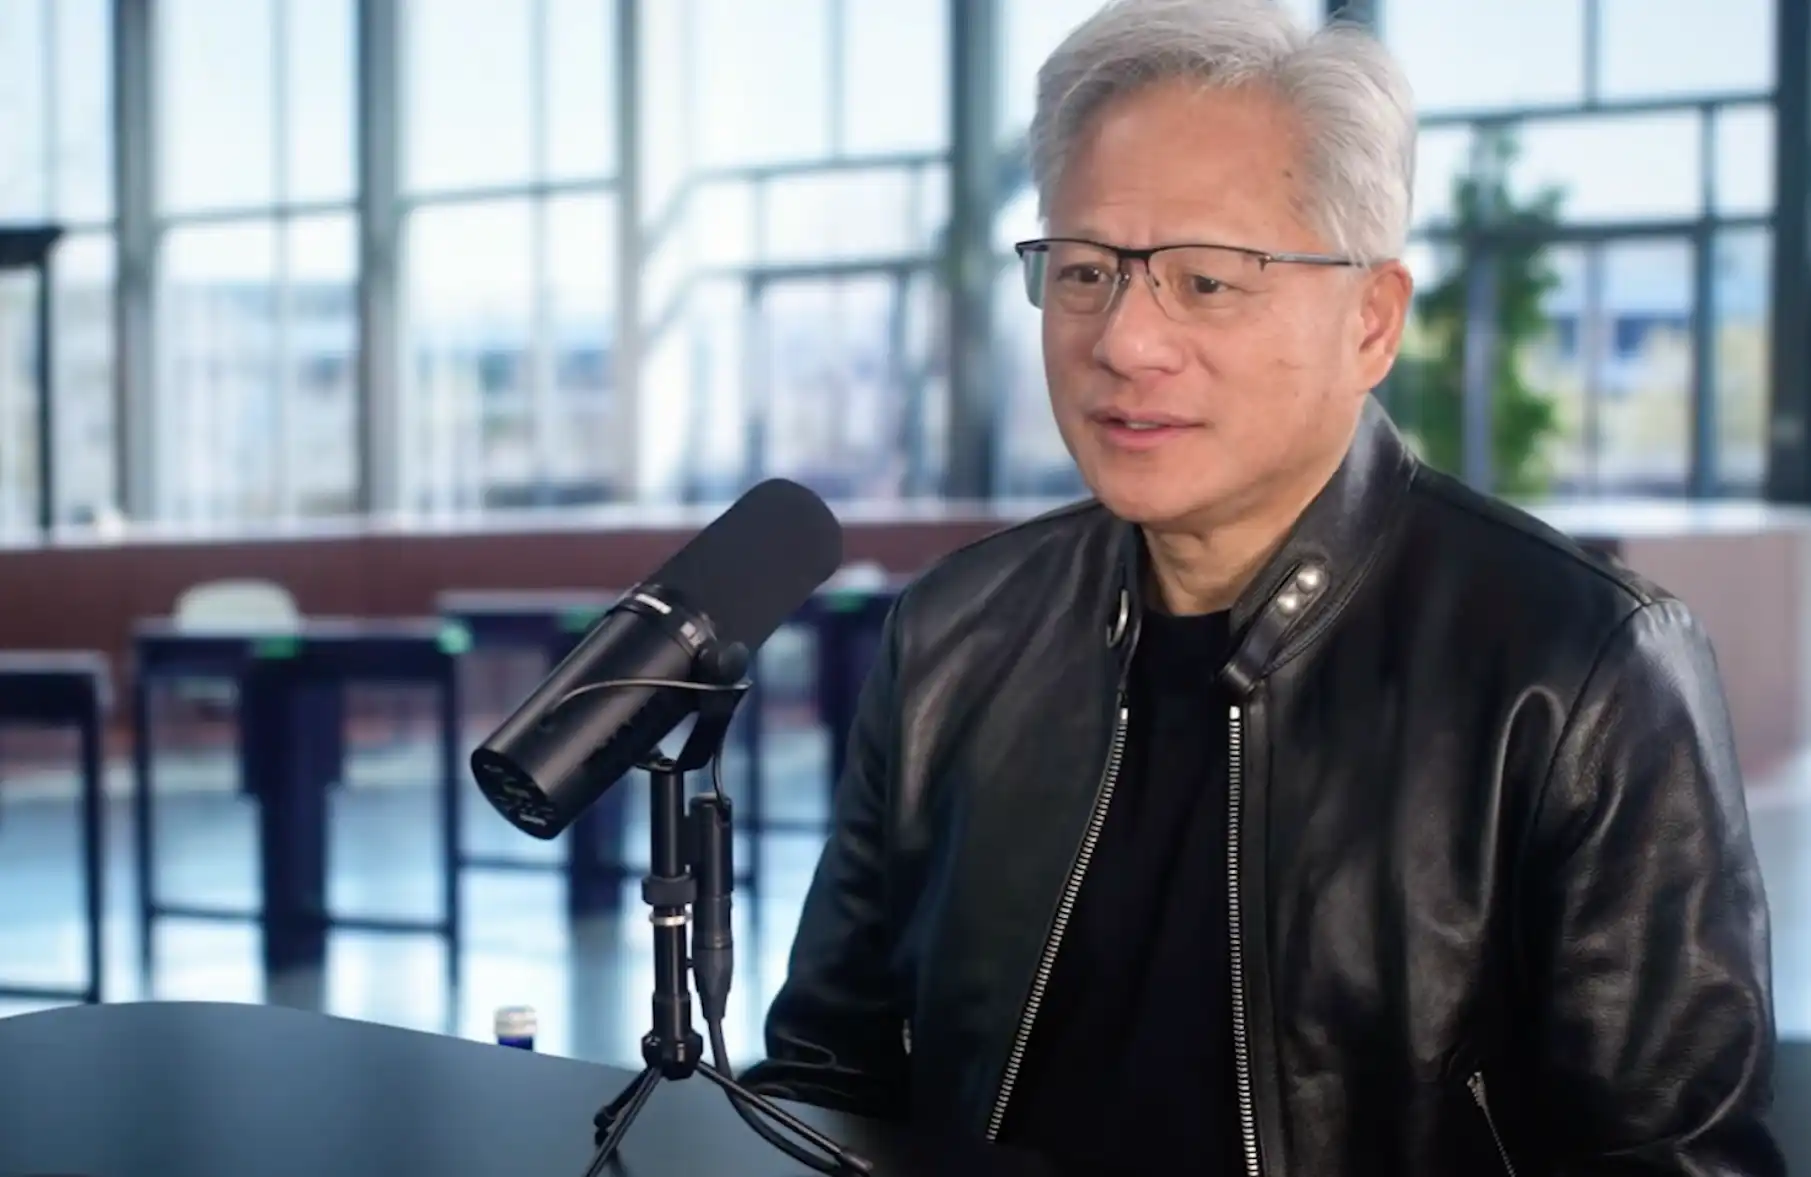
On the right is Dwarkesh Patel, on the left is Jensen Huang
Around this core, this conversation can be understood from three levels.
First, the change in technology and industry structure.
Nvidia's advantage lies not only in hardware performance, but in the developer ecosystem carried by CUDA, and the path dependency formed around the computing stack. In this system, computing power is no longer the only variable, and algorithms, system engineering, networking, and energy efficiency collectively determine the pace of AI advancement. This also leads to an important conclusion: software will not be simply "commoditized" by AI. Conversely, with the proliferation of agents, tool invocation will grow exponentially, further amplifying the value of software.
Second, the boundaries of business and strategic choices.
Facing the expanding AI industry chain, Nvidia chooses to "do what is necessary, but not everything." It does not enter cloud computing or engage in excessive vertical integration but amplifies the overall market size through investment and ecosystem support. This restraint allows it to maintain critical control while avoiding becoming an ecosystem substitute, thereby incorporating more participants into its technical system.
Third, the divergence in technology diffusion and industry landscape.
The most tension-filled part of the conversation is not in the specific conclusions but in how to understand "risk" itself. One viewpoint emphasizes the first-mover advantage brought by computing power leadership, while another is more concerned with the long-term ownership of the ecosystem and standards in the technology diffusion process. Rather than short-term capability gaps, the more critical question may be: which technical system will future AI models and developers run on.
換言いい方ですと、この競争の最終段階は、「より強力なモデルを最初に作ったのは誰か」ということだけでなく、「モデルの実行を定義したのは誰か」ということでもあります。
この意味では、NVIDIAの役割は、もはや単なるチップ企業ではなく、AI時代の「基盤となるオペレーティングシステムの提供者」により近づいています。計算能力がどのように普及しようとも、価値創造の経路が自社を中心に展開されるよう、同社は確かめようとしています。
以下は原文の内容(理解しやすくするため、一部編集されています):
要約
· NVIDIAのモートでは「チップ」ではなく、「電子からトークンへの包括的なシステム能力」にあります。コアはハードウェアの性能ではなく、計算を価値に転換するフルスタック能力(アーキテクチャ + ソフトウェア + エコシステム)です。
· CUDAの真の利点はツールではなく、世界最大のAI開発者エコシステムにあります。開発者、フレームワーク、モデルがすべて同じテックスタックに結びつき、かけがえのないパス依存関係が形成されています。
· AI競争の鍵は計算力だけでなく、「計算スタック × アルゴリズム × システムエンジニアリング」の組み合わせです。アーキテクチャ、ネットワーク、効率、ソフトウェアの協調による向上は、単なるプロセスの進歩をはるかに超えています。
· 計算力のボトルネックは短期的な問題であり、供給は2〜3年以内に需要信号によって追いつかれます。真の長期的な制約はチップではなく、エネルギーとインフラです。
· AIソフトウェアは商品化されることはありませんが、代わりにAgentの爆発によりツールの使用が指数関数的に増加することが予想されます。将来の展望は、ソフトウェアが安くなるのではなく、ソフトウェアの呼び出し回数が急増することです。
· クラウドをやらないことがNVIDIAの中核戦略です:「必要なすべて」を行いますが、全体の価値連鎖を飲み込むことはしません。垂直統合ではなく、投資とエコシステムの支援を通じて、総合的な市場規模を拡大します。
· 本当の戦略的リスクは、競合他社が計算力を得ることではなく、世界のAIエコシステムがもはや米国のテックスタックに基づいていないことです。モデルと開発者が移行すると、長期的なテクノロジスタンダードと産業主導権も移動します。
インタビュー内容
英伟达のモートはどこにあるのか:サプライチェーン、それとも「電子からトークン」の制御権?
Dwarkesh Patel(ホスト):
私たちは、多くのソフトウェア会社の評価が下落しているのを見てきました。これは、AIがソフトウェアを標準化された商品に変えると予想されるためです。もう1つのやや幼稚な理解方法は、おおよそ次のようなものです:デザインファイル(GDS2)を台湾台積電に渡すと、台湾台積電が論理チップを製造し、ウェハを作り、スイッチ回路を構築し、そしてSK Hynix、Micron、Samsungで生産されたHBMと一緒にパッケージングし、最後にODMに送ってホールフレームを組み立てます。
注:HBM(High Bandwidth Memory,ハイ バンド幅 メモリ)は、高性能コンピューティングおよび AI 用に設計された先進的なメモリ テクノロジです。ODM(Original Design Manufacturer,独自設計製造業者)は、製造だけでなく製品設計も担当する受託製造業者を指します。
したがって、この観点から見ると、NVIDIA は本質的にソフトウェアを開発しており、製造は他者によって行われています。ソフトウェアが商品化されれば、NVIDIA も商品化されるでしょう。
Jensen Huang(黄仁勲、NVIDIA CEO):
しかし、根本的には、電子をトークンに変換するプロセスが必要です。電子からトークンへの変換を行い、それらのトークンを時間とともにより価値のあるものにするプロセスは、完全に商品化するのが非常に難しいと考えています。
電子からトークンへの変換自体が、非常に特異なプロセスです。そして、トークンをより価値のあるものにすることは、1 つの分子を別の分子よりも価値の高いものにするようなもので、1 つのトークンを別のトークンよりも価値のあるものにすることです。
このプロセスには、多くの芸術、エンジニアリング、科学、発明が含まれており、これによりそのトークンに価値が生まれます。
明らかに、私たちはこれらすべてがリアルタイムで起こるのを見守っています。したがって、この変換プロセス、製造プロセス、および関連するすべてのシグナルは、実際にはまだ完全に理解されておらず、この旅はまだ終わっていません。そのため、そのような状況は起こらないとは思いません。
もちろん、私たちは効率を向上させるでしょう。実際、あなたが問題を説明した方法は、私が NVIDIA に対する理解の 1 つのモデルです:入力は電子、出力はトークン、その間は NVIDIA です。
私たちの仕事は、「必要なことを最大限に行い、不必要なことを最小限に抑えること」であり、この変換を実現し、非常に高い能力を持たせます。
私が言う「最小限に抑える」とは、私たち自身が行う必要のない部分については、他社と協力して、それを私たちのエコシステムに取り込むという意味です。今日の NVIDIA を見ると、我々は上流供給チェーンと下流供給チェーンの両方で、おそらく最大規模のエコシステムの 1 つを持っています。コンピュータメーカーやアプリケーション開発者、モデル開発者まで、AI を「5 層ケーキ」と考えることができます。そして、我々はこれら 5 つのレベルすべてにエコシステムを展開しています。
関連記事:《NVIDIA 黄仁勲 最新記事:AI の「5 層ケーキ」》
だから、私たちはできるだけ少ないことをしようとしていますが、やらなければならないその部分は実際には非常に難しいです。その部分が商品化されるとは思っていません。
実際、企業ソフトウェア会社が本質的に「ツール製造」を行っているとは考えていません。ただし、今日、ほとんどのソフトウェア会社は実際にツールプロバイダーです。
もちろん例外もあり、いくつかはワークフローシステムのコーディングと固定化を行っていますが、多くの企業は本質的にツール会社です。
たとえば、Excel はツール、PowerPoint はツール、Cadence はツールを作っており、Synopsys もツールです。
Jensen Huang:
私が見ているトレンドは、多くの人とは逆です。私はエージェントの数とツールの利用者数が指数関数的に増加すると考えています。
さまざまなツールの呼び出しインスタンス数も急増する可能性が非常に高いです。たとえば、Synopsys Design Compiler の使用インスタンス数は大幅に増加する可能性があります。
多くのエージェントがフロアプランナーや配置図ツール、設計ルールチェックツールを使用することになります。
今日、私たちはエンジニアの数に制限されています;そして明日、これらのエンジニアは多くのエージェントに支えられ、設計空間を探索するためにこれまでにない方法で進むでしょう。今日のツールを使うと、この変化は非常に明確になります。
ツールの使用は、これらのソフトウェア会社が爆発的な成長を遂げるのを促進します。これがまだ起こっていない理由は、今のエージェントはツールの使用に十分に長けていないからです。
ですので、これらの企業がエージェントを自力で構築するか、エージェント自体がツールを使用できるようになるか、最終的にはその両方が組み合わされると考えています。
Dwarkesh Patel
あなたの最新の開示で、ボーダーコンポーネント、メモリ、パッケージなどについて約 1000 億ドルの調達コミットメントがあることを覚えています。また、SemiAnalysis のレポートでは、この数字が 2500 億ドルに達する可能性があると述べています。
一つの解釈は、NVIDIA の砦は将来数年間にわたってこれら希少コンポーネントの供給をロックしているということです。つまり、他の誰かがアクセラレータを作成できるかもしれませんが、彼らは十分なメモリを手に入れることができますか?十分なロジックチップを手に入れることができますか?
これがNVIDIAの将来数年間の中核的な利点でしょうか?
Jensen Huang:
これは私たちが実現できることであり、他の人が難しくできることです。私たちが上流で巨額のコミットメントをする理由の一部は、明示的なものであり(つまり、あなたが言及したそのような調達コミットメントです)、もう一部は暗黙的なものです。
例えば、上流には実際には私たちのサプライチェーンパートナーが多くの投資をしています。なぜなら、私は彼らのCEOにこう言うからです:「この業界がどれほど大きいか、なぜそうなるのか、一緒に推測しましょう、私が見ているものを説明しましょう」と。
このようなプロセスを通じて情報を伝え、ビジョンを掻き立て、合意形成を行うことで、私は上流のさまざまな業界のCEOと一致し、彼らはこれらの投資を行うことを承諾するのです。
なぜ彼らが私に投資することを選んだのか、他の誰かに投資しないのか?それは彼らが、私が彼らの生産能力を購入し、私の下流でそれを消化する能力があることを知っているからです。NVIDIAの下流の需要とサプライチェーンの規模が非常に大きいため、彼らは上流で投資することに同意したのです。
GTCを見てください。イベントの規模は多くの人々にとって感動的です。実質的には、これは360度のAIユニバースであり、業界全体を一堂に会しています。みんなが一緒に集まるのは、互いに見える必要があるからです。私は彼らを一堂に会させ、上流が下流を見、下流が上流を見るようにし、すべての人がAIの進歩を見るようにしています。
さらに重要なのは、彼らがAIネイティブ企業やスタートアップに触れ、起こっているさまざまなイノベーションを見ることで、私が述べた判断が目の当たりにされることです。
したがって、私は自社のサプライチェーンやエコシステムパートナーに、目の前の機会を直接または間接的に説明するために多くの時間を費やしました。多くの人は、私の基調講演が従来の製品発表を一つずつ行うものとは異なり、「授業を受ける」ように聞こえると言います。しかし、これは私の目的そのものです。
私は、上流と下流の両方が次に何が起こり、なぜそれが起こるのか、いつそれが起こるのか、規模はどれくらいになるのかを理解し、彼らがこれらの問題を私と同様に体系的に推論できるようにする必要があります。
ですので、あなたが言及した「モート・アンド・バーリア」は、確かに存在します。この市場が数年以内に1兆ドル規模になった場合、私たちはそのサプライチェーンを構築する能力を持っています。キャッシュフローと同様に、サプライチェーンにも流れと循環があります。ある事業のアーキテクチャが運転されない場合、そのサプライチェーンを構築する人はいません。私たちがこの規模を維持できるのは、下流の需要が非常に強力であり、誰もがそれを理解しているからです。
これが、私たちが現在のような規模でこれらのことを行うことができる理由です。
Dwarkesh Patel
私は、上流が追いつけるかどうかをより具体的に理解したいと考えています。過去数年間、あなたたちの収入は基本的に毎年倍増し、提供される世界の計算パワーの規模は3倍になりました。
Jensen Huang:
さらに、この規模で倍増し続けています。
Dwarkesh Patel
はい。ですので、論理チップを見てみると、例えばあなた方は TSMC の N3 プロセスの最大顧客の1人であり、N2 でも主要な顧客の1人です。
ある分析によると、今年 AI は N3 の生産能力の60%を占める可能性があり、来年には86%に達するかもしれません。
注:N3 とは TSMC の 3nm プロセスノードのことであり、台湾積体電路製造カンパニーの現行最先端チップ製造技術の1つと言えます
ですので、既にそのような大きな割合を占めている状況で、どのようにして倍増を続けることができるのか?そして、毎年倍増することができるのか?私たちは、AI コンピューティングの成長が上流の制限によって遅れざるを得ない段階に入ったのでしょうか?これらの制限を回避する方法はあるのでしょうか?毎年2倍のファブを建設することはどのように実現されるのでしょうか?
Jensen Huang:
特定の瞬間には、瞬時の需要が実際には全産業の供給を上回ることがあります。上流または下流にかかわらず。そして、状況によっては、私たちが実際には配管工の数に制限を受けることがあります — これは実際に起こったことです。
Dwarkesh Patel:
ですので、来年の GTC には配管工を招待すべきですね。
Jensen Huang:
はい、これは実際には良い現象です。市場において、瞬時の需要が産業全体の総供給を上回る状況にあることを望みます。逆の状況は良くありません。
両者の間の差が大きすぎると、特定の段階、特定のコンポーネントが明確なボトルネックとなり、業界全体がそれを解決するために殺到します。たとえば、私は最近 CoWoS についてはもはや議論されていないことに気付きました。その理由は、過去2年で、私たちがそれに対して大規模な投資と拡張を行い、数倍に増やしたからです。
現在、私は全体的な状況がかなり良い状態にあると考えています。台湾積体電路製造カンパニーも、CoWoS の供給が論理チップやメモリの需要の成長に遅れを取らないようにする必要があることに気付いています。したがって、彼らはCoWoSを拡張すると同時に、将来の先進的なパッケージング技術も拡張しており、それも論理チップと同じペースで拡大しています。
これは非常に重要です。過去、CoWoS やHBM メモリは専門特性のような存在でしたが、今ではそうではなくなりました。今や、それらはメインストリームの計算技術の一部であると認識されています。
同時に、私たちは現在、より広範囲のサプライチェーンに影響を与える力を持っています。過去、AI 革命が始まったばかりの時には、私が今話している判断は、実際には5年前に既に行われていました。
当時、一部分の人々が信じて投資しました、たとえばサンジェイ・チームの Micron。私は今でもあの会議を覚えています、当時は非常に明確に未来を語り、なぜそれが起こるのか、そして今日のこれらの結果の予測を行いました。彼らはそのとき大幅に拡大することを選択し、私たちは彼らとパートナーシップを築きました。LPDDR、HBMなど、,彼らはそれらに向けて投資を行い、それが彼らにとって大きなリターンをもたらしたことは明らかでした。後から追随した企業もありますが、今では皆がこの段階に到達しています。
なので、私は、すべてのテクノロジーの世代、すべてのボトルネックが大きな関心を集めるだろうと考えています。そして今、私たちは数年前にこれらのボトルネックを「プリフェッチ」しています。Lumentum、Coherent、およびシリコンフォトニクスエコシステム全体との協力を例に挙げましょう。過去数年間、私たちは実際にエコシステム全体やサプライチェーンを再構築しました。
シリコンフォトニクスにおいて、私たちは TSMCを中心に完全なサプライチェーンを構築し、彼らと協力して技術を開発し、多くの新技術を発明し、これらの特許をサプライチェーンにライセンス供与し、エコシステムをオープンに維持してきました。私たちは新技術、新しいワークフロー、新しいテスト機器(両面探索を含む)の発明、関連企業への投資、生産拡大支援を通じて、サプライチェーンを準備してきました。
ですので、私たちはエコシステムを積極的に形作り、サプライチェーンが将来のスケールに対応できるようにしています。
Dwarkesh Patel:
聞こえるのは他よりもいくつかのボトルネックが簡単に解決できるように思えます。例えば、CoWoSの拡張よりも困難なものに比べて
Jensen Huang:
実際には、私が挙げたのは最も困難な例でした。
Dwarkesh Patel:
どれですか?
Jensen Huang:
配管工。はい、本当のことです。私が挙げたのは最も難しいものですー配管工と電気技師。なぜなら、これが私をいくつかの「終末論者」の発言について少し懸念させます、彼らは常に仕事が消え、ポジションが置き換えられると話しています。そのために我々が人々にソフトウェアエンジニアにならないように勧告したら、未来には本当にソフトウェアエンジニアがいなくなります。
同様の予測は、10年前にも出されました。そのとき、人々は言いました、「何をしても放射線科医になるべきではありません」。あなたは今でもそのようなビデオをオンラインで見つけることができ、放射線科医は最初に排除される職業であり、世界はもはや放射線科医を必要としないでしょうと言っています。しかし、現実には、今私たちは放射線科医が不足しています。
Dwarkesh Patel:
そうです、では、先ほどの質問に戻ります:いくつかの点は拡大できますが、いくつかはできません。それで、具体的には、ロジックチップの生産能力をどのように倍増させますか?つまり、本当のボトルネックはここにあり、メモリとロジックの両方が制約要因です。EUV露光装置はどうですか?毎年その数を倍増する方法は?
Jensen Huang:
これらはすべて実現不可能なことではありません。実際、急速な生産拡大は簡単ではありませんが、これらのことを2〜3年のうちに実現することは実際には難しくありません。重要なのは、明確な需要サインがあることです。1台を製造できるとすぐに10台を製造できます。10台を製造できるようになると、100万台を製造できます。したがって、これらのものは本質的に複製が難しくありません。
Dwarkesh Patel:
それでは、この判断をサプライチェーンにどの程度伝えるつもりですか?例えば、ASMLに行って、「将来3年間を見据えて、NVIDIAの年間収益を20兆ドルにするためには、さらに多くのEUVリソグラフィ装置が必要ですか?」
Jensen Huang:
私は直接的に行うこともありますし、間接的に推進することもあります。台湾のTSMCを説得できれば、ASMLも自然に説得されます。したがって、私たちは重要なボトルネックポイントを特定する必要があります。ただし、TSMCがこのトレンドを信じていれば、数年後には十分なEUV装置を持つことになります。
つまり、どのボトルネックも2〜3年を超えることはないということです。一方で、私たちは計算効率も向上させています。HopperからBlackwellまで、約10倍から20倍の向上があり、場合によっては30倍から50倍に達することさえあります。また、新しいアルゴリズムを継続的に提案しています。CUDAが非常に柔軟であるため、さまざまな新しい手法を開発し、生産能力を拡大しつつ効率も向上させることができます。
したがって、これらのことは私を心配させることはありません。私が本当に心配しているのは、私たちの下流にあるエネルギー政策のような要因です。エネルギーがなければ、拡張することはできません。エネルギーがなければ、産業を構築することはできません。エネルギーがなければ、新しい製造業体系を構築することはできません。
現在、私たちはアメリカの再工業化を推進し、チップ製造、コンピュータ製造、パッケージングをアメリカに持ち帰り、同時に電気自動車、ロボットなどの新産業を構築したいと考えています。AI工場を構築する際には、これらすべてにエネルギーが不可欠であり、エネルギー関連の建設サイクルは非常に長いです。対照的に、チップの生産能力を増やすことは2〜3年の問題です。CoWoSの生産能力を増やすことも同様です。
Dwarkesh Patel:
興味深い話ですね。私がインタビューしたいくつかのゲストは、逆の判断を示しているように感じました。ただし、この問題に関しては、私には判断するための十分な技術的知識がないことは確かです。
Jensen Huang:
ただし、良いことは、今あなたは専門家と話をしているということです。
GoogleのTPUがNVIDIAの地位を揺るがすか?
Dwarkesh Patel:
はい、確かに。競合他社についてお聞きしたいです。TPUを見ると、現在世界のトップ3の大規模モデルのうち、2つ―Claude と Gemini―はTPUでトレーニングされています。これは NVIDIA の未来にどのような意味を持ちますか?
注:TPU(Tensor Processing Unit、テンソル処理ユニット)は、Google が人工知能(特にディープラーニング)向けに設計した一種の専用チップです。
Jensen Huang:
私たちがやっていることはまったく異なります。NVIDIA が構築しているのは「加速コンピューティング」であり、テンソル処理ユニット(TPU)ではありません。
加速コンピューティングは、分子動力学、量子クロミシス、データ処理、データフレームワーク、構造化データ、非構造化データ、流体力学、素粒子物理、そしてもちろんAIなど、さまざまなタスクに使用できます。したがって、加速コンピューティングの適用範囲ははるかに広いです。
現在、みんなの議論がAIに集中していますが、AIは確かに非常に重要で影響力がありますが、「計算」自体の範囲はAIよりも広いです。NVIDIA が行っているのは、汎用計算を加速コンピューティングに再発明することです。私たちの市場カバレッジは、どのTPUやその他の専用アクセラレータよりもずっと広範囲にわたります。
私たちのポジショニングを見ると、私たちはさまざまな種類のアプリケーションを加速できる唯一の企業です。私たちは巨大なエコシステムを持ち、さまざまなフレームワークとアルゴリズムがすべて NVIDIA プラットフォーム上で実行できます。さらに、私たちのコンピューターシステムは「他者が運用する」ことを前提として設計されています。どの運用者も、私たちのシステムを購入して使用できます。
ほとんどの自社開発システムは、他者が使用することを前提として設計されていません。基本的には自分で運用する必要があります。それらは最初から柔軟性が十分ではないため、他者が使用するために設計されたものではありません。私たちのシステムを誰もが運用できるため、私たちは Google、Amazon、Azure、OCIなどのすべての主要プラットフォームに参入しています。
システムをレンタルして運用するためには、多業種にわたる大規模な顧客エコシステムを持っている必要があります。システムを自分で使用するために運用する場合も、私たちはもちろんその手伝いをする能力を持っています。たとえば、Elon の xAI などです。
どのような産業、どのような企業の運用者であっても、私たちのシステムを使用できるようにすることができるため、Lilly のような企業が、科学研究や医薬品発見に使用する高性能コンピューターを構築できるように支援できます。彼らに彼ら自身のスーパーコンピューターを運用し、医薬品開発や生命科学のさまざまな応用分野に使用できるようにします。これらすべては私たちが加速できる領域です。
したがって、私たちはさまざまなアプリケーションシナリオをカバーすることができますが、TPU はそれを実現できません。 NVIDIA が構築した CUDA は、非常に優れたテンソル処理プラットフォームとして機能するだけでなく、データ処理、計算、AI など、全体のライフサイクルをカバーしています。したがって、私たちの市場機会ははるかに大きく、カバレッジも広範囲です。さらに、現在、ほぼすべての種類のアプリケーションを基本的にサポートしているため、どこでも NVIDIA システムを展開し、必ず顧客が使用することができると確信しています。
つまり、これは本質的に完全に異なるものです。
Dwarkesh Patel:
この質問は少し長くなります。
現在の収益は非常に驚異的であり、この収益の大部分は製薬または量子計算からではありません。あなたたちは製薬や量子計算ビジネスで毎四半期 600 億ドルを稼いでいるわけではありませんが、AI は前例のない技術であり、前例のない速さで進化しています。
ですので、問題は次のとおりです:AI の観点だけを考えると、最適なソリューションは何ですか?私自身はローレベルの専門家ではありませんが、AI の研究者と話をすると、TPU を使用すると、それは非常に大きなアレイであり、行列乗算に非常に適しています。一方、GPU はより柔軟であり、多くのブランチや不規則なメモリアクセスを処理するのに適しています。
しかし、AI を見ると、本質的には何度も繰り返され、非常に予測可能な行列乗算ではないでしょうか?その場合、ワープスケジューリング、スレッド切り替え、メモリバンクなどの機能にチップ領域を割り当てる必要はありません。そのため、TPU は現在の計算ニーズと収益成長において、主要なアプリケーションシナリオに対して高度に最適化されています。
この視点についてどうお考えですか?
Jensen Huang:
行列乗算は確かにAIの重要な部分ですが、AI全体ではありません。
新しい注意メカニズムを提案したり、異なる方法で計算を行ったりする場合;新しいハイブリッドSSMなどの新しいアーキテクチャを設計したい場合;拡散と自己回帰を融合させたモデルを構築したい場合 ─ 必要なのは汎用プログラム可能なアーキテクチャであり、私たちはあらゆることを実行できます。
これが私たちの優位性であり、新しいアルゴリズムの発明をはるかに容易にしています。これがプログラム可能なシステムであるため、新しいアルゴリズムを継続的に発明することが、AIがこのように迅速に進化する理由なのです。
TPU も他のすべてのハードウェアと同様に、ムーアの法則の影響を受けています。ムーアの法則はおよそ毎年25%の向上をもたらすことを知っています。ですので、10倍、100倍の飛躍を実現したい場合、算法とその計算方法を毎年根本的に変える以外に方法はありません。
これが NVIDIA のコア利点です。
Blackwell が Hopper に比べて大幅な改善を達成できたのは、私たちがそのときおおよそ35倍と言ったからです。Blackwell のエネルギー効率が Hopper を35倍上回ると初めて発表したとき、誰も信じませんでした。
後に Dylan が記事を書き、実際に私が控えめに話した、本当の改善は実際には50倍に近く、このような改善は単にムーアの法則だけでは実現できないと述べました。私たちはこの問題に取り組むために、新しいモデル構造を導入し、MoE のようなものを使用し、計算を並行化し、デカップリングし、分散処理を行い、その計算システム全体に拡張しました。これらは、CUDA を使用して新しい計算カーネルを開発する能力がなければ実現することが難しいものです。
注: Dylan Patel は、半導体およびAIインフラ領域で知られるアナリストであり、研究機関SemiAnalysisの創設者です。
したがって、私たちの利点は、アーキテクチャのプログラム可能性および NVIDIA の高度に共同設計された企業としての点にあります。私たちは、計算の一部を NVLink のような相互接続構造や Spectrum-X のようなネットワーク層にオフロードすることさえできます。つまり、私たちはプロセッサ、システム、インターコネクト、ソフトウェアライブラリ、アルゴリズムといったレベルで同時に変革を推進できます。これらすべてが同時に実行されています。これらすべてを支える CUDA がなければ、私は一体どこから始めればよいのかさえ分かりません。
Dwarkesh Patel:
これはまた、NVIDIA の顧客構造に関する問題を提起します:もしも60%の収益がこれらの5つの大規模ハイパースケーラーから得られている場合、過去の時代や異なるタイプの顧客に直面する場合、例えば実験を行う教授など、彼らはCUDA に非常に依存しています。彼らは他のアクセラレータを使用することはできず、PyTorch + CUDA を使用する必要があり、すべてが最適化されている必要があります。
しかし、それらの大規模ハイパースケーラーでは、自分たちでカーネルを書く能力があります。実際、彼らはそうする必要があり、最後の5%の性能を引き出すために。Anthropic や Google は多くの場合、独自のアクセラレータや TPU を使用してトレーニングを行っています。OpenAI でさえ、GPU を使用する場合、Triton を使用し、独自のカーネルが必要であると言います。したがって、彼らはCUDA C ++を直接書き、cuBLAS、NCCL などのライブラリを使用せず、独自のソフトウェアスタックを構築し、他のアクセラレータにコンパイルすることさえあります。
したがって、おそらくほとんどのお客様にとって、彼らは実際に CUDA を置き換えることができ、置き換えています。ところで、CUDA が最新の AI を推進する上で、いかにナビディアが依存する必要があるか、その度合いはどの程度ですか?
Jensen Huang:
まず、CUDA は非常に豊かなエコシステムです。どんなコンピューターでも開発する場合、CUDA から始めることは非常に賢明な選択です。このエコシステムは非常に豊富であり、私たちはすべての主要なフレームワークをサポートしています。
たとえば Triton のようなカスタムカーネルを書く必要がある場合、私たちは Triton のバックエンドに多くのナビディアのテクノロジーを貢献していますし、さまざまなフレームワークをより良くするお手伝いをすることにも非常に喜んでいます。現在には Triton や vLLM、SG Lang など、さまざまなフレームワークが存在します。
事後トレーニング(post-training)や強化学習の発展に伴い、この分野は急速に拡大しています。Vairal や NeMo RL など、新しい一連のフレームワークがあります。特定のアーキテクチャで開発する必要がある場合、CUDA から始めることが最も合理的な選択です。なぜなら、エコシステムが成熟していることを知っているからです。問題が発生した場合、それはあなた自身のコードの問題である可能性の方が高く、下にある大量のコードの問題ではありません。
これらのシステムには非常に大規模なコードベースが関与しています。システムに問題が発生した場合、問題があなたの側にあるのか、計算プラットフォーム自体にあるのかを知りたいと思うでしょう。
もちろん、問題が計算プラットフォームにあるよりも、自分の側にあることを望みます。もちろん、私たち自身にもたくさんのバグがありますが、システムは非常に成熟しており、少なくとも信頼できる基盤の上に構築を続けることができます。
第二に、インストールベースの規模です。あなたが開発者である場合、何をしているにしても、最も重要なことは「インストールベース」です。あなたはあなたのソフトウェアをできるだけ多くのコンピューターで実行したいと考えています。ソフトウェアを自分のためではなく、自分のクラスターや業界全体のために書いているのです。なぜなら、あなたはフレームワーク開発者だからです。
ナビディアの CUDA エコシステムは、本質的に私たちの最も重要な資産です。今や世界中で数十億の GPU があります。すべてのクラウドプロバイダーに V100、A100、H100、H200、L シリーズ、P シリーズなどさまざまな仕様があります。
そして、それらはさまざまな形で存在しています。たとえば、ロボット企業の場合、CUDA が直接ロボット本体で実行されることを望むでしょう。私たちはほぼどこにでもいます。
これは、ソフトウェアやモデルを開発したら、それがどこでも使用できるという意味です。したがって、インストールベースそのものの価値は非常に大きいです。
最後のポイントは、展開場所の柔軟性です。私たちはすべてのクラウドプラットフォームに存在しており、これが私たちのユニークさを生み出しています。AI企業または開発者として、最終的にどのクラウドベンダーと協力するか、システムがどこで実行されるかはわからないことがよくあります。しかし、私たちはすべての場所で実行できるため、ローカルデプロイメント(オンプレミス)も含まれます。
したがって、エコシステムの豊富さ、インストールベースの規模、および展開場所の柔軟性は、これら3つが組み合わさることで非常に価値があります。
Dwarkesh Patel:
それは理にかなっています。しかし、私が興味を持っているのは、これらの利点がおそらく主要な顧客にとって本当に重要なのかどうかです。これらの利点を享受する人はたくさんいますが、自分でソフトウェアスタックを構築できる人々、つまりあなたが収益の大部分を提供している人々、特にAIが「検証可能なフィードバックループ」のタスクでますます強力になっている世界では、強化学習シナリオ、注意やMLPのようなカーネル最適化は実際には非常に簡単に検証できるフィードバックループです。
ですので、これらの巨大なクラウドベンダーは、完全に自分でこれらのカーネルを記述できるのでしょうか?もちろん、彼らはまだコスト対効果を理由にNVIDIAを選択するかもしれません。しかし問題は、ほとんどの顧客が自分自身でソフトウェアスタックを構築できる場合、CUDAに依存しない利益率は維持されるのでしょうか?
Jensen Huang:
私たちのAI研究所に参加しているエンジニアたちの数は非常に驚くべきものであり、彼らと協力して技術スタック全体を最適化しています。その理由は、誰よりも私たちのアーキテクチャをよく理解している人間はいないからです。そして、このアーキテクチャはCPUのように汎用的ではありません。
CPUはある種「家庭用車両」のようで、それをクルーズコントロールで運転しやすい、あまり速く走ることはないが、誰もが十分に運転できるように設計されており、クルーズコントロールがあり、すべてが簡単です。しかし、NVIDIAのGPUアクセラレータは、F1レーシングカーのようなものです。誰でもそれを100マイル毎時まで加速させることができると想像できますが、それを本当に限界まで推進するには、かなりの専門知識が必要です。
そして、私たちは多くのAIを使用してこれらのカーネルを生成しています。私は非常に確信していますが、かなりの期間中、私たちは必要不可欠であると言えます。私たちの専門能力は、これらのAI研究所のパートナーが彼らのパフォーマンスを簡単に2倍に向上させるのを助けることができます。多くの場合、私たちが彼らの技術スタックや特定のカーネルを最適化した後、彼らのモデルは3倍、2倍、50%さらに高速化されることがあります。これは非常に大きな向上です、特に彼らが大規模なHopperやBlackwellクラスタを保有している場合を考えると。
パフォーマンスを倍にすると、収入も倍になります。これは直接的な収入に対応しています。 NVIDIA のコンピューティングスタックは、世界中で最適な総所有コスト(TCO)パフォーマンスを誇っており、競合他社はいません。どのプラットフォームが、パフォーマンス/TCO比でより優れているかを証明できる企業はありません。誰もいません。さらに、これらのベンチマークテストは公開されています。
Dylan が正しかったと言っています。Inference Max は公開されており、誰でも使用できます。しかし、TPU チームは彼らの推論コスト優位性を示すためにそれを使用することを望んでいません。これは非常に難しいことで、誰も立ち上がって証明しようとしません。
MLPerf も同様です。彼らが主張する40%の優位性を証明してもらいたいと思います。TPUのコスト優位性を証明してもらいたいです。私にとっては、これは意味がないと思います。基本的な原則からして成り立ちません。まったく成り立たないです。
したがって、私たちが成功している本当の理由は、我々のTCOが非常に優れているからだと考えています。
また、60%の顧客がトップ5の企業から来ていると言っていますが、その多くは実際には外部の顧客向けのビジネスです。たとえば、AWSでは、NVIDIAの計算リソースの大部分は外部の顧客向けに提供されており、AWS自体が使用しているわけではありません。Azureでは、ほとんどの顧客が外部の顧客です。OCIでも同様です。彼らが私たちを選んだ理由は、我々のカバレッジが非常に広範であるためです。
私たちは彼らに世界で最も品質の高い顧客を紹介することができ、その顧客自体がNVIDIAプラットフォーム上に構築されているからです。そして、これらの企業がNVIDIA上に構築されている理由は、私たちのカバレッジ範囲と柔軟性が非常に強力だからです。
したがって、私は、このビジネスがうまくいっているのは、インストールベース、アーキテクチャのプログラマビリティ、エコシステムの持続的な蓄積のためだと考えています。そして、今や世界中に何千ものAI企業が存在しています。あなたがそのうちの1つのAIスタートアップ企業なら、どのようなアーキテクチャを選択しますか?最も普及している、最もインストールベースの大きい、最も豊かなエコシステムのアーキテクチャを選択するでしょう。これがそのビジネスモデルの論理です。
したがって、その理由は以下の通りです:
・第一に、当社の単位コストパフォーマンスは非常に高く、したがってコストが最も低いです;
・第二に、当社の単位消費電力パフォーマンスは世界一です;パートナーが1GWのデータセンターを構築する場合、最も多くのトークン、つまり最も多くの収入を生み出さなければなりません。そして、当社のアーキテクチャは、消費電力単位で最も多くのトークンを生み出せます。
·第三、もし目標がハッシュレンタルであるなら、私たちは世界で最も多くの顧客を抱えています。
これがこのフライホイールが設立された理由です。
Dwarkesh Patel:
興味深いですね。問題の核心は、この市場構造が実際にどのようなものかです。多くの企業が存在していても、次のような状況が完全に起こり得ます:何千ものAI企業があり、彼らはおおよそ同じハッシュレートを共有しています。
しかし、実際の状況が、これらの超大手クラウドプロバイダーを介して、AnthropicやOpenAIのような基本的なモデル企業が実際にハッシュレートを利用している場合、さらにそれらがさまざまなアクセラレータを稼働させる能力を持っていることがあります。
Jensen Huang:
あなたの前提が間違っていると思います。
Dwarkesh Patel:
おそらくですね。では、別の角度から尋ねます。性能とコストに関するこれらの主張がすべて事実である場合、なぜAnthropicのような企業が、わずか数日前にBroadcomやGoogleと多ジガワット規模のTPU協力を発表したのですか?そして、それらのほとんどのハッシュレートはこれらのエコシステムから来ています。Googleにとっては、TPU自体が主要なハッシュレート供給源です。ですから、これらの大手AI企業を見ると、以前は完全にNVIDIAだけを使っていましたが、今はそうではありません。
これらのメリットが理論的に成り立つ場合、なぜ彼らは他のアクセラレータを選択するのでしょうか?
Jensen Huang:
Anthropicは比較的特別なケースです。Anthropicがなければ、TPUの成長はほぼ存在しませんでした。 TPUの成長のほとんどはAnthropicから来ています。同様に、Anthropicがなければ、トレーニング需要の成長もほぼ存在しませんでした。
これは非常に明確な事実です。多くの同様の機会が存在しているわけではなく、実際にはAnthropicしか存在しません。
Dwarkesh Patel:
しかし、OpenAIもAMDと提携しており、自社のTitanアクセラレータを開発しています。
注:AMD(Advanced Micro Devices)は、主に計算チップを設計するアメリカの半導体企業であり、NVIDIAやIntelの主要な競合他社です
Jensen Huang:
しかし、彼らのほとんどはまだNVIDIAを使用しています。私たちも引き続き大規模な提携を行います。他の解決策を試みない限り、私はそれを気にしません。彼らが他の解決策を試みない限り、私たちの解決策がどれほど優れているかをどうやって知ることができますか?
時々、この点を再確認するために比較が必要です。そして、私たちは現在の立場に相応しいことを常に証明しなければなりません。
市場には常にさまざまな意見があります。ASIC プロジェクトがいくつ取り消されたかを見てみてください。ASIC を始めたからといって、NVIDIA よりも優れた製品を作れるというわけではありません。
実際、それは簡単なことではありません。合理的な観点から見ても、それはあまり成り立たないとさえ言えます。英伟达(NVIDIA)が特定の点で重大なミスを com _(「犯す」)_ した場合を除いて。しかし、私たちの規模、私たちの速度を考えると — 私たちは毎年大幅な飛躍を達成する唯一のグローバル企業です。
Dwarkesh Patel:
彼らの論理は:NVIDIA よりも優れている必要はなく、NVIDIA の 70% 未満であれば問題ありません。なぜなら、あなたたちの利益率が 70% と彼らが考えているからです。
Jensen Huang:
しかし、ASIC であっても、実際には利益率はかなり高いです。NVIDIA の利益率はおよそ 60%–70% であり、ASIC の利益率もおそらく 65% です。では、本当にどれだけ節約できるのでしょうか?
いずれにしても、誰かにはお金を支払わなければなりません。ですので、私が見てきた状況からすると、これらの基盤(ASIC)ビジネスの利益率も非常に高く、彼ら自身もそう考えており、かなり自負心を持っています。
非常に以前、私たちは実際にはこのようなことを行う能力がありませんでした。正直に言って、OpenAI や Anthropic のような基本モデルラボを構築することがどれほど困難かを当時理解していませんでした。供給側からの大規模な投資支援が実際に必要であることにも完全に気づいていませんでした。
当時、私たちは Anthropic に私たちの計算能力を利用させるために数十億ドル規模の投資をする能力はありませんでした。しかし、Google と AWS は可能であり、最初から莫大な資金を投入し、その見返りに、Anthropic は彼らの計算能力を利用しました。
私たちはそのようなことをする能力がある訳ではありませんでした。私が言えるのは、これは私の誤りでした。リスク投資機関は、AI ラボを支援するために 50 億ドルや 100 億ドルを投資し、それが Anthropic に成長することを期待することはできないからです。
これは私の判断ミスでした。しかし、当時気づいていたとしても、私たちがその段階でそれを行う能力があるとは思っていませんでした。
ただし、同じ過ちは二度と繰り返しません。OpenAI に投資できて嬉しいですし、彼らの拡大を手伝えて嬉しいです。これが必要だと思います。後で Anthropic が私たちを訪ねてきた時、私も投資家になれて嬉しかったですし、彼らの発展を手助けできて嬉しかったです。
ただし、当初の時点では、私たちは実現できませんでした。もしやり直せるなら、もし当時 NVIDIA が今のように強力だったなら、私は非常に喜んでそれらのことをやるでしょう。
NVIDIA がなぜ「クラウド」をやらなかったのか?
Dwarkesh Patel:
これは非常に興味深いです。何年もの間、NVIDIA は AI 領域で「スコップを販売して利益を得る」会社であり、多くの利益を得てきました。そして今、あなたたちはそれらの利益を再投資し始めています。報道によると、300億ドルを OpenAI に投資し、100億ドルを Anthropic に投資しています。そして、これらの企業の評価額は継続的に上昇しています。
ですので、過去数年を振り返ると、あなたたちは彼らに計算リソースを提供し、トレンドを見ていましたが、その時、彼らの評価額は今の十分の一であり、1年前でも現在よりはるかに低かったかもしれません。そして、その当時、あなたたちはすでに多額の現金を持っていました。
実際、一つの可能性が存在しました:NVIDIA 自体が基本モデル企業になるか、またはより低い評価額で大規模な投資を行い、今日行っているようなことをより早く行うことでした。
ですので、私は本当に興味を持っています。なぜそれをもっと早くやらなかったのでしょうか?
Jensen Huang:
私たちは「できるときにする」ことをしたのです。そのときにできたなら、私はもっと早くやっていたでしょう。Anthropic が最初に私たちの支援が必要だと認識すると、私はやるでしょう。しかし、その時点で、私たちはその能力を持っていませんでした。
それは私たちの能力の範囲内にはなく、また私たちの決定の慣性にもなかったからです。
Dwarkesh Patel:
資金不足の問題だったんですか?
Jensen Huang:
そうです、投資スケールの問題でした。その当時、私たちはほとんど外部への投資の伝統がなかったし、そのようなスケールの投資なんてさらにありませんでした。そして、私たちはそれが必要だとは気づいていませんでした。
私の考えは、彼らは完全にリスク投資家を見つけることができる、他の企業と同じようにできるということでした。しかし、彼らがやろうとしていることは、実際にはリスク投資家が支援できないものでした。OpenAI がやろうとしていることは、リスク投資家がサポートできるものではありませんでした。
私が後で気付いたのは、それがちょうど彼らの賢さだったということです。彼らはその時点で、そのような道を歩む必要があると認識しました。私は、彼らがそうしたことをたいへん嬉しく思います。私たちは当時参加できなかったために、Anthropic が他のパートナーに移ったことでさえ、それは良いことだと考えています。Anthropic の存在は、世界全体にとって良いことであり、私はそのことを喜んでいます。何かしら後悔があるとしても、それは受け入れられることです。
Dwarkesh Patel:
その問題は最終的にこの点に帰着します:現在たくさんの現金を保有しており、さらに増加を続けているので、NVIDIAはこれらの資金をどのように活用すべきですか?
一つのアイデアは、中間層エコシステムが登場し、これらのAIラボがキャピタル支出(CAPEX)を運用支出(OPEX)に変換し、算力をリースしてもらえるようにするというものです。
GPUは非常に高価ですが、モデルの進歩に従い、それらはライフサイクル全体でより高い価値のトークンを持続的に生み出すことができます。そして、NVIDIA自体がこれらの初期のキャピタル支出を負担できる能力を持っています。例えば、CoreWeaveに対して最大63億ドルのサポートを提供し、20億ドルを投資したと報じられています。
では、NVIDIAがなぜ自らクラウドプロバイダーにならないのですか?なぜハイパースケーラーとならず、自社クラウドを構築して算力を貸し出さないのですか?結局、あなたたちはその現金力を持っています。
Jensen Huang:
これは企業の哲学の問題であり、そして私はこれが賢明な哲学であると考えています:私たちは「できるだけ多くの必要なことをし、同時にできるだけ少ないことをする」とすべきだと思います。
これは、計算プラットフォームを構築する際、私たちがそうでなければ絶対に達成されないと確信しているものを行うべきだということを意味します。
私たちがそれらのリスクを負担せず、NVLinkを構築せず、完全なソフトウェアスタックを構築せず、エコシステム全体を構築せず、20年かけてCUDAを作り上げず(そのほとんどは赤字ですらあった)、私たちがこれらのCUDA-X領域専用ライブラリを構築しなければ——それが光線追跡や画像生成、初期のAIモデル、データ処理、構造化データ、ベクトルデータ処理などであるとしても——私たちがそれらを行わないと、これらのものは存在しないでしょう。
私はこれに完全に確信しています。私たちはさらにリソグラフィー計算のためにcuLithoというライブラリを開発しましたが、これを我々が行わなければ他の誰もがやるわけではありません。
だから、計算の加速が今日のような段階に発展したのは、私たちがこれらのことを行ったからです。これが私たちが全力で進めるべき部分なのです。
しかし同時に、世界には既に多くのクラウドプロバイダーが存在しています。私たちがそうしなくても、誰かがそうするでしょう。だから、「必要なことをできるだけ多く行い、それ以外のことをできるだけ少なく行う」という原則に基づいて、この考え方は会社の中で常に存在しています。私が下すあらゆる決定は、この視点から行われます。
クラウド分野では、私たちが初めからCoreWeaveをサポートしなかった場合、これらの新しいタイプのAIクラウド(ネオクラウド)が存在しなかった可能性があります。彼らをサポートしなければ、彼らは今日の規模に成長することはありませんでした。NscaleやNebiusも同様で、私たちの支援がなければ、彼らは今日のような発展を遂げなかったでしょう。そして今、それらは非常に成功しています。
しかし、これは私たち自身が行うべきビジネスなのでしょうか?いいえ。私たちは依然として、その原則に従います:必要なことを行い、それ以外のことはできる限り少なくします。そのため、私たちはエコシステムに投資します。なぜなら私はエコシステム全体が繁栄することを望んでいるからです。私たちのアーキテクチャができるだけ多くの業界、できるだけ多くの国をつなぐことを望んでおり、AI が世界中で構築され、かつ米国のテクノロジースタックの上に構築されることを望んでいます。
これが私たちが推進しているビジョンです。
同時に、さっき言ったように、現在多くの優れた基本モデル企業が存在していますので、私たちは可能な限りそれらに投資します。
さらに一つ、私たちは「勝者を選別」しません。私たちは誰もがサポートされることを望んでいます。これは私たちのビジネスの必要性であり、したいことでもあります。したがって、私がある企業に投資する際、他の企業にも投資します。
Dwarkesh Patel:
なぜわざわざ勝者を選別しない選択をしたのですか?
Jensen Huang:
それは私たちの責務ではないからです。それが第一です。
第二に、英伟達が設立された当時、約60社のグラフィックス企業、3Dグラフィックスを手掛ける企業がありました。最終的に私たちだけが生き残りました。もし当時の60社の中から成功する企業を選ぶとしたら、英伟达はおそらく最も期待されていない企業だったかもしれません。
それはあなたの時代より前の話ですが、当時、英伟达のグラフィックスアーキテクチャは完全に間違っていました。少しのずれではなく、根本的に誤っていたのです。我々は、開発者がほとんどサポートできないアーキテクチャを設計し、本来成功するはずがありませんでした。我々は非常に合理的な第一原理に基づいて設計されたものの、最終的に誤った解に至りました。
誰もが私たちが成功することは不可能だと考えていましたが、最終的に私たちは生き残りました。ですので、私はそれを認めるだけの十分な謙虚さがあり、勝者を選別しないことを選んでいます。彼ら自身が発展するのを待つか、すべての人を支援するかのどちらかです。
Dwarkesh Patel:
理解できなかった点があります。あなたは新興クラウドベンダーを意図的に優先的にサポートするつもりはないと述べましたが、少なくとも英伟达が存在しなければ彼らも存在しないかもしれません。これらの2つはどうして成立するのですか?
Jensen Huang:
まず第一に、彼ら自身が存在したいと思い、私たちに積極的に助けを求めてくる必要があります。彼らが明確な意思、ビジネス計画、能力、情熱を持っている時—もちろん、彼ら自身も一定の能力を持っている必要があります—スタートアップ段階で投資支援が必要な場合、私たちはそこにいるでしょう。
しかし、重要なのは、彼らが自分自身のフライホイールを早く構築することです。あなたの質問は、私たちは資金調達ビジネスに参入したいと考えているかどうかでしたが、その答えはノーです。私たちは金融機関になりたくありません。市場には既に多くの資金調達を行う人々がいますので、私たちはそれらの金融機関と協力することを選びます。自ら資金調達を行うことは避けます。
したがって、私たちの目標は、自社の事業に焦点を当て、ビジネスモデルをできるだけシンプルにし、同時にエコシステム全体をサポートすることです。
Jensen Huang:
OpenAIのような企業がIPOの前に300億ドルもの資金を必要とするとき、そして私たちは彼らを非常に信頼しています——私自身、彼らがすでに非凡な企業であり、さらに優れた企業になると信じています。この世界は彼らの存在を必要とし、皆さんも彼らの存在を望んでおり、私も彼らの存在を望んでいます。彼らには勝利するためのすべての要素が備わっているので、私たちは彼らを支援し、成長を助けます。
したがって、この種の投資は行いますが、それは彼らが実際に私たちにそのような行動を取る必要があるからです。ただし、私たちの原則は「できるだけ多く行う」ではなく、「できるだけ少なく行う」ことです。
Dwarkesh Patel:
この質問は明らかですが、過去数年間、私たちは常にGPUの不足状態にあり、モデルが強力になるにつれ、この状況がさらに顕著になっています。
Jensen Huang:
はい、確かにGPUの不足は存在します。
Dwarkesh Patel:
そして、NVIDIAは、これらの希少リソースを割り当てる際に、単純に最高入札額にしたがっているわけではなく、新興クラウドプロバイダーが存在することを確認する必要があるなど、留意していると見なされています。CoreWeaveにはいくらか、Crusoeにはいくらか、Lambdaにはいくらかを提供するなど。
まず第一に、あなたはこの見解に同意していますか?第二に、これがNVIDIAにどのような利点がありますか?
Jensen Huang:
私はあなたの前提が間違っていると考えています。もちろん、私たちはこうしたことに非常に慎重に取り組んでいます。
まず最初に、発注書(PO)がなければ、どれだけ多くのコミュニケーションを行っても意味がありません。ですので、まず第一に、これらの製品の製造サイクルが長いため、データセンターの構築サイクルも長いため、需要予測を正確に行うために全顧客と協力します。これが最初に必要なことです。
次に、できるだけ多くの顧客と一緒に予測を行います。ただし、最終的には注文をしなければなりません。注文がない場合、私も手助けすることができません。したがって、ある時点で、「先着注文、先着サービス」です。
ただし、その他に、データセンターが準備できていないか、あるいはいくつかの重要なコンポーネントが準備できていないため、システムを展開できない状況であれば、他の顧客に優先的にサービスを提供するかもしれません。これは、私たちの工場全体のスループット効率を最大化するためのものです。
この場合を除いて、優先度の原則は「先着順」です。注文をしなければなりません。注文をしないとダメです。
もちろん、外部には多くの物語があります。例えば、Larry と Elon と私が食事をして GPU をリクエストしたという人もいますが、実際に一緒に食事をしたことはありますが、彼らは決して GPU を「リクエスト」していません。彼らは単に注文をすればいいのです。注文すると、私たちは最大限の生産能力を提供するよう努めます。事はそれほど複雑ではありません。
Dwarkesh Patel:
つまり、注文した時点やデータセンターの準備状況に応じて順番が決まる仕組みのようですが、それでも単なる「最高額提示者が得る」というわけではありませんよね?
Jensen Huang:
私たちは決してそういうことをしません。
Dwarkesh Patel:
最高額提示による割り当ては行っていないのですね?
Jensen Huang:
決してです。なぜなら、それは非常に悪いビジネス慣行だからです。
価格を設定し、顧客が購入するかどうかを決定します。需要が増えたとしても、価格を引き上げることはありません。これは私たちのやり方ではありません。顧客は私たちを信頼できます。私は信頼できる存在でありたいと考えています。業界の基盤となりたいのです。価格の変動を推測する必要はありません。
もし私が見積もりを出したら、それが最終価格です。需要が急増しても、それは変わりません。
Dwarkesh Patel:
それは、あなたと TSMC の関係が安定している理由の一つでもありますね?
Jensen Huang:
NVIDIA と TSMC はすでに約 30 年間協力しています。NVIDIA と TSMC の間には、正式な法的契約すらなく、お互いの間でほぼ公平な了解があります。時には私が正しいこともあれば、間違っていることもあります。時には良い条件を得ることもありますが、そうでないこともあります。しかし、全体として見れば、この関係は非常に素晴らしく、私は彼らを完全に信頼し、依存できます。
また、NVIDIA にとって確かなことは、今年 Rubin が非常に優れているだろうということ、来年には Vera Rubin Ultra が登場し、その次の年には Feynman が登場し、その次の年には――その名前はまだ公表していませんが――ということです。つまり、毎年、私たちを信頼できるということです。世界中を探しても、私たちのような ASIC チームを見つけるのは難しいでしょう。あなたが言えるのは、私は会社全体をリスクにさらしても、毎年ここで私をサポートしてくれると信じられる、ということです。
私のトークンのコストは毎年数量レベルで低下し、私はこのことを信じる時計のように信じることができます。私はさきほどTSMCについても同様のことを述べました。歴史上、どのウェハ工場もあなたがそう言えるようにしたことはありません。
しかし今日、あなたはNVIDIAに言えるようになりました。あなたは毎年私たちを信頼することができます。
10億ドルのAIファクトリの計算能力を購入したい場合、問題ありません。1億ドルを購入したい場合も問題ありません。1000万ドルを購入したい場合も、1つのラックだけを購入したい場合も問題ありません。1枚のグラフィックスカードを購入したい場合も問題ありません。次の1000億ドルのAIファクトリの注文をしたい場合も問題ありません。
今日、世界中で私たちだけがこう言える会社です。そして私はTSMCにもこう言えるでしょう:私は10億ドルを購入したい、問題ありません。私たちは一緒に計画を立て、進むべき流れを進み、成熟した企業が行うべきことを行うだけです。
ですので、私はNVIDIAが世界のAI産業の基盤となることができると考えています。この地位に至るまでには、膨大な投資と集中力が必要であり、会社の安定性と一貫性が非常に重要です。
なぜNVIDIAは「マルチレーン賭け」を拒否するのか
Dwarkesh Patel:
これは非常に興味深い問題を提起しています。以前にもTSMC、メモリについて話しました。今、もし以下のような状況に入るとします:あなたは既にN3の大部分の生産能力を占有しており、その後もN2の大部分を占有する可能性があります。古い工程ノード(たとえば7ナノメートル)の余剰生産能力を再利用する考えはありますか?
たとえばAIの需要が非常に高く、最先端の製造工程の拡張が追いつかない場合、今日の数値最適化、システム設計に関するすべての経験を活かして、HopperやAmpere版を新たに作ることを考えますか?2030年までにこのような状況が発生する可能性はあると思いますか?
Jensen Huang:
その必要はありません。理由は、各世代のアーキテクチャの進歩はトランジスタサイズの変化だけではありません。パッケージング、スタック、数値システム、システムアーキテクチャでも多くのエンジニアリング作業を行いました。ここまで進むと、古いノードのバージョンを作り直す必要がある場合、その研究開発の規模は誰もが負担できません。私たちは前進し続けることができますが、途中で引き返すことは負担できないと思います。
もちろん、思考実験をしてみます:もしいつか世界中が「先進的な生産能力はもう増やせない」と言ったら、私はすぐに7ナノメートルを利用しますか?もちろん、疑いようもありません。
ダワーケッシュ・パテル:
以前、私は別の人と次の問題について話していました:なぜNVIDIAは完全に異なる複数のチッププロジェクトを同時に進めないのですか?たとえば、CerebrasのようなワイヤグリッドアーキテクチャやDojoのような大規模パッケージング、そしてCUDAに依存しないものを作ることができます。
リソースもエンジニアリング人材も持っていますので、これらのことを並行して行えます。誰もがAIやアーキテクチャの将来がどのようになるかわからないので、なぜすべての卵を一つのかごに入れる必要があるのでしょうか?
ジェンセン・ファング:
もちろん、そうすることもできます。ただし、より良い解決策を見つけることができていません。これらのものはすべてシミュレートしてみましたが、おそらく実際よりも劣っています。したがって、私たちはそれを行いません。私たちが今行っていることは、本当にやりたいことであり、最も適切だと考えているプロジェクトなのです。
もちろん、将来的にワークロード自体が大きく変化する可能性がある場合は-私が言っているのはアルゴリズムの変更ではなく、実際にワークロードが変わった場合です- 私たちは他のタイプのアクセラレータを追加する可能性もあります。
たとえば、最近ではGrokを導入し、GrokをCUDAエコシステムに組み込んでいます。私たちは現在、この取り組みを行っています。これは、トークンの価値が非常に高くなったためで、同じモデルが異なる応答時間ベースで異なる価格層に対応する可能性があるからです。
数年前、トークンはほぼ無料であるか、あるいはほとんど無料に近い価格でした。しかし今では、異なる顧客が異なるトークンを要求しています。そして、これらの顧客自体がそれを通じて多くの利益を得ることができます。たとえば、ソフトウェアエンジニアにとって、より高速な応答トークンを提供して、彼らが今日よりも効率的に作業できるようにすることができれば、私はそのために支払いをする用意があります。
しかし、このような市場は実際には最近になって初めて現れたものです。したがって、今回初めて、同じモデルが異なる応答時間を基に異なる市場セグメントを形成する能力が本当にあります。
これが私たちがこのように行動する理由です。ただし、アーキテクチャ自体について語る場合、もっと資金があれば、その資金を既存のアーキテクチャに投資するでしょう。
ダワーケッシュ・パテル :
このような「非常に高い価格設定トークン」と推論マーケットレイヤリングのアイデアは非常に興味深いと思います。
最後の質問。ディープラーニング革命が起こらなかった場合、NVIDIA は今日、何をしていると思いますか?
Jensen Huang:
もちろん、ゲームは続けるでしょうが、それ以外にも計算を加速します。私たちが常に行っていることですし、元々の目的でもあります。
当社の基本的な前提は、ムーアの法則が鈍化するということです。汎用計算は多くの点で優れているものの、多くの計算タスクにとっては理想的なソリューションではありません。そのため、GPU というアーキテクチャと CPU を組み合わせ、GPU が CPU のワークロードを加速するようにします。異なるコードカーネルや異なるアルゴリズムを GPU にオフロードして実行できます。これにより、1つのアプリケーションを100倍から200倍加速することができます。
それがどこに使われるかと言うと?それはエンジニアリング、科学、物理学、データ処理、コンピュータグラフィックス、イメージ生成など、さまざまな分野です。
ですので、今日 AI が存在しなくても、NVIDIA は依然として非常に大きな企業になるでしょう。その理由は実は非常に根本的です:汎用計算の拡張能力はすでにほぼ限界に達しています。そして、パフォーマンスを向上させる一つの方法——唯一の方法ではありませんが、非常に重要な方法——が、ドメイン固有のアクセラレーションを行うことです。
最初に取り組んだのはコンピュータグラフィックスでしたが、他にも多くの分野があります。さまざまな科学計算、素粒子物理学、流体シミュレーション、構造化データ処理などがあり、さまざまな種類のアルゴリズムが CUDA から恩恵を受けます。
ですので、私たちの使命は常にこの世界にアクセラレーテッドコンピューティングをもたらし、汎用計算が達成できない、または十分な能力レベルにスケーリングできないアプリケーションが前進し続けるのを促進し、科学分野の突破を支援することです。最初のいくつかのアプリケーションは、分子動力学、エネルギー探査の地震処理、そして画像処理でした。
これらすべての分野で、汎用計算自体は効率が低すぎました。ですので、はい、AI がなければ残念に思うでしょう。しかし、私たちが計算上の進歩を遂げたことにより、私たちはディープラーニングを民主化しました。どんな研究者、科学者、学生であっても、どこにいても、PC 1台や GeForce グラフィックスカード1枚で、驚異的な科学研究を行うことができます。そして、この最も基本的な約束は一度も変わることがありません、少しも変わりません。
GTC をご覧になると、最初は AI とは全く関係のないコンテンツが多いことに気付くでしょう。コンピュータエッチング、量子化学、データ処理であるか、AI とは関係ありませんが、非常に重要です。AI は面白く、ワクワクするものですが。
それでも AI とは関係のない重要な作業をしている人々がまだたくさんいます。テンソルも彼らの唯一の計算方式ではありません。そして私たちは、そうしたすべての人々を支援したいと考えています。
ドワルケシュ・パテル:
Jensen、ありがとうございます。
ジェンセン・ファング:
どういたしまして、この対談をとても楽しんでいます。
[原文リンク]
BlockBeats の公式コミュニティに参加しよう:
Telegram 公式チャンネル:https://t.me/theblockbeats
Telegram 交流グループ:https://t.me/BlockBeats_App
Twitter 公式アカウント:https://twitter.com/BlockBeatsAsia
 関連記事