黄仁勲GTCスピーチ全文:2027年の市場需要は1兆ドルを超える見込みです;誰もがOpenClaw戦略を採用すべきです
原文タイトル:「黄仁勲 GTC スピーチ全文:推論時代の到来、2027 年の売上は少なくとも 1 兆ドル、ランクは新しいオペレーティングシステム」
原文著者:鮑衣龍、ウォールストリートジャーナル
2026 年 3 月 16 日、NVIDIA GTC 2026 大会が正式に開催され、NVIDIA 共同創立者兼 CEO の黄仁勲が基調講演を行いました。
この「AI インダストリーの毎年の巡礼」と見なされる大会で、黄仁勲はNVIDIAが「チップ企業」から「AI インフラストラクチャおよびファクトリー企業」への転換を説明しました。市場が最も注目している持続的な業績と成長の空間に直面し、黄仁勲は将来の成長を推進する基盤となるビジネスロジックである「トークンファクトリーエコノミクス」を詳細に説明しました。
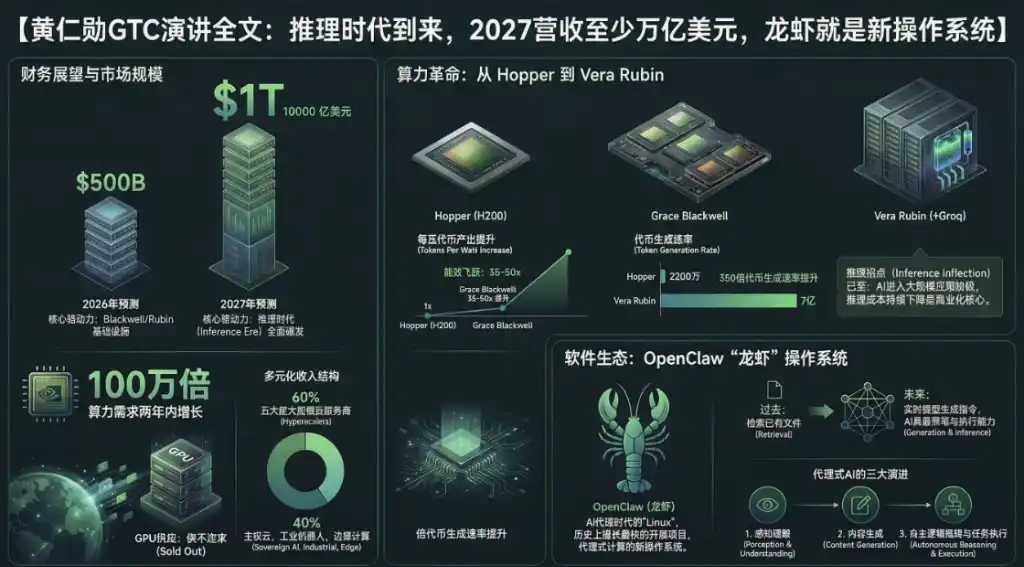
業績ガイダンスは非常に楽観的、「2027 年には少なくとも 1 兆ドルの需要」
過去2年間、世界のAI計算需要が指数関数的に急増しています。大規模モデルが「認識」、「生成」から「推論」および「行動(タスクの実行)」に進化するにつれ、計算リソースの消費量が急速に増加しました。市場が非常に注目している受注と売上の天井に対し、黄仁勲は非常に強力な見通しを示しました。
黄仁勲はスピーチで次のように述べました:
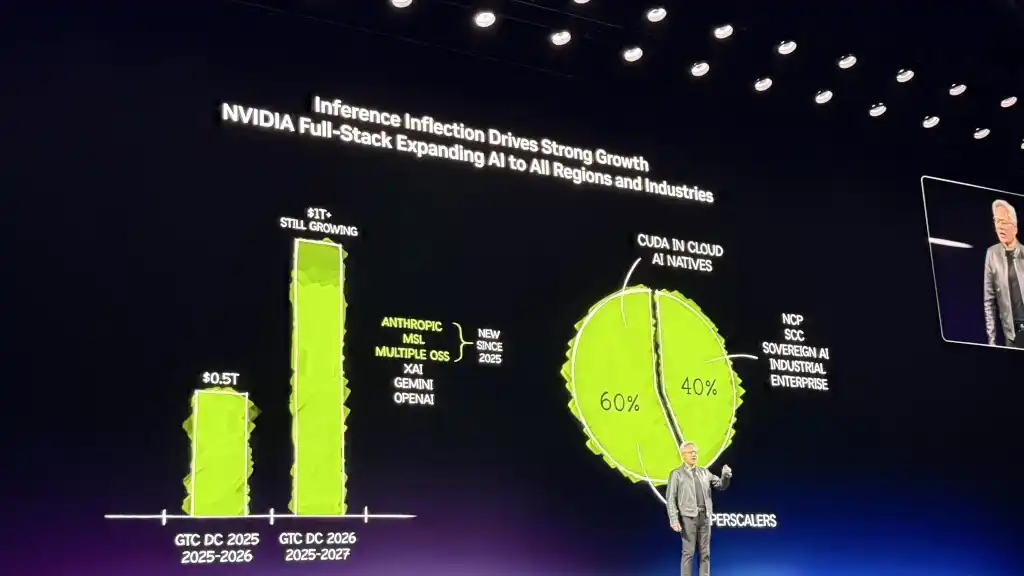
昨年の今ごろ、私は、2026 年までBlackwellとRubinをカバーする高い確信度の 5,000 億ドルの需要が見られたと述べました。今、この時、私は 2027 年に少なくとも 1 兆ドルの需要が見込まれると見ています(少なくとも 1 兆ドル)。
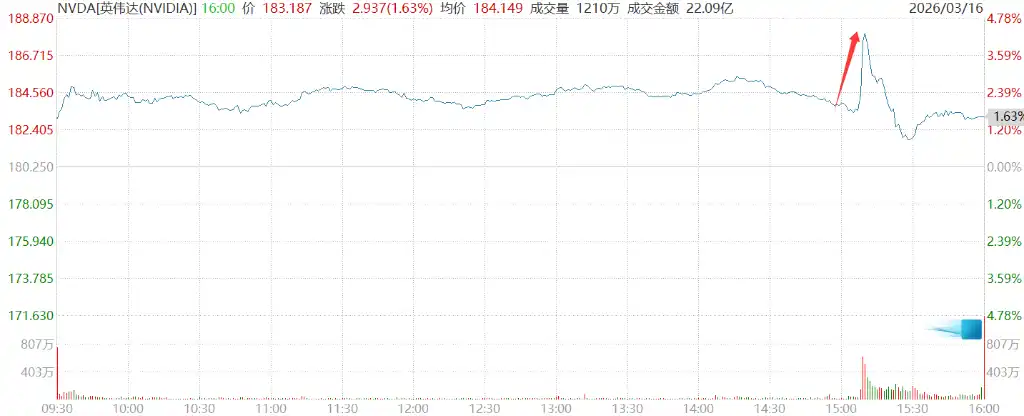
黄仁勲の1兆ドルの見通しは、NVIDIAの株価を4.3%以上押し上げました。
さらに、彼はこの数字について次のように補足しました:
これは妥当ですか?これから話す内容です。実際、私たちは需要を満たせなくなるでしょう。私は確信しています、実際の計算需要ははるかに高いでしょう。
黄仁勲は、現在のNVIDIAシステムがすでに世界中で「最もコスト効率の高いインフラストラクチャ」であることを指摘しました。NVIDIAがほぼすべての領域のAIモデルを実行できる汎用性が、顧客がこの1兆ドルを充分に活用し、長期間にわたるライフサイクルを維持できることを可能にしています。
現在、NVIDIA の 60% のビジネスは、トップ5のハイパースケール クラウド サービス プロバイダーから来ており、残りの 40% は主権クラウド、企業、産業、ロボティクス、エッジ コンピューティングなど、さまざまな分野に広く分散しています。
トークン ファクトリー経済、パフォーマンスごとにビジネスを決定
この需要の合理性を説明するため、ファン・インフンはグローバル企業の CEO に新しいビジネス思考を提示しました。彼は、将来のデータセンターはもはやファイルを保存する倉庫ではなく、Token(AI によって生成される基本単位)を生産する「工場」となると指摘しました。
ファン・インフンは次のように強調しています:
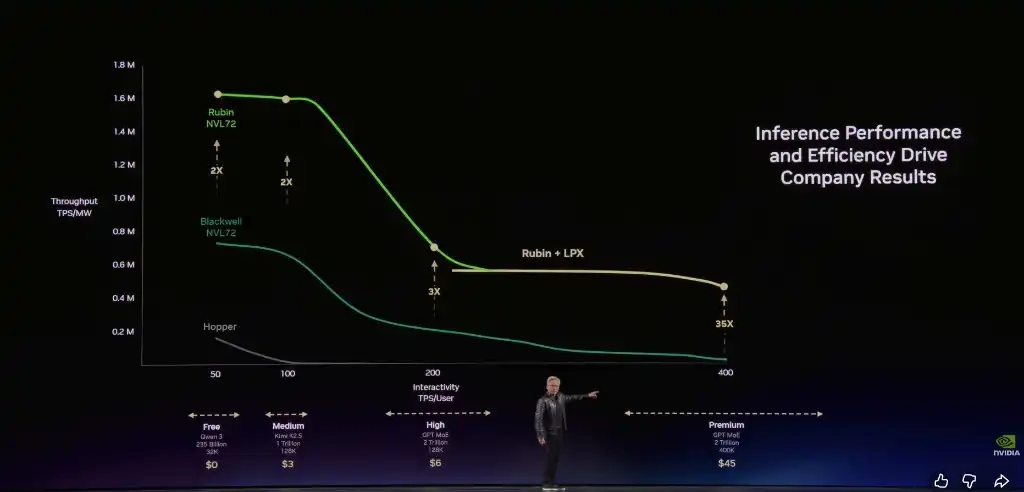
各データセンターや工場は、定義上、電力に制約されています。1GW(ギガワット)の工場は決して2GWにはなりません。これは物理的および原子の法則です。固定された電力のもとで、1ワットごとのトークンスループットが最高である人の生産コストが最も低くなります。
ファン・インフンは、将来の AI サービスを以下の4つのビジネス レベルに分類しました:
· フリー レベル(高いスループット、低速度)
· インターミディエイト レベル(~100 万トークンあたり 3 ドル)
· アドバンスト レベル(~100 万トークンあたり 6 ドル)
· ハイ スピード レベル(~100 万トークンあたり 45 ドル)
· スーパー ハイ スピード レベル(~100 万トークンあたり 150 ドル)
彼は、モデルがより大きくなり、コンテキストがより長くなるにつれて、AI はよりスマートになりますが、トークンの生成速度は低下すると述べています。ファン・インフンは次のように述べています:
このトークン ファクトリーにおいて、あなたのスループットとトークンの生成速度は、直接来年の収益に変換されます。
ファン・インフンは、NVIDIA のアーキテクチャが顧客に高いスループットを無料レベルで実現するとともに、最高価値の推論レベルで性能を驚異的に35倍向上させることができると強調しました。
Vera Rubin 2年で350倍の加速を実現、Groq が高速推論を補完
物理的極限の制約の下、NVIDIA は史上最も複雑な AI コンピューティングシステム、Vera Rubin を紹介しました。黄仁勋 は述べています:
Hopper に触れる際、私はチップを持ち上げるでしょう、それはとてもかわいいです。しかし、Vera Rubin に触れる際、皆が考えるのはシステム全体です。この 100% 液冷で、従来のケーブルを完全に排除したシステムでは、以前は2日かかっていたラックの設置が、今ではわずか2時間で完了します。
黄仁勋 は、極度のエンドツーエンドのソフトウェアとハードウェアの協調設計を通じて、Vera Rubin は同じ 1GW データセンター内で驚異的なデータの飛躍を実現しました:
わずか2年間で、私たちは Token の生成率を2,200 万から 70 億に引き上げ、350倍の成長を達成しました。同時期にムーアの法則は約1.5倍の向上しかもたらしませんでした。
1000 Tokens/秒などの超高速推論の帯域幅ボトルネックを解決するために、NVIDIA は買収した Groq 社の非対称型分離推論を統合した最終案を提供しました。
黄仁勋 は説明しています:
これら2つのプロセッサにはまったく異なる特長があります。Groq チップには 500MB の SRAM があり、一つの Rubin チップには 288GB のメモリがあります。
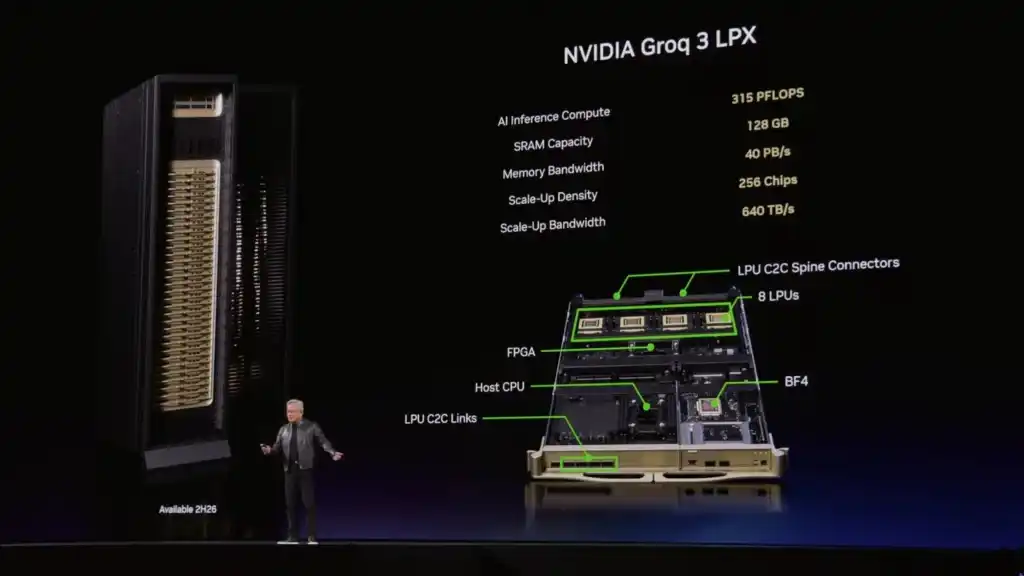
黄仁勋 は、NVIDIA が Dynamo ソフトウェアシステムを通じて、大量の計算とメモリを必要とする「プリフィル(Pre-fill)」段階を Vera Rubin に委任し、遅延に敏感な「デコード」段階を Groq に委任していることを指摘しました。黄仁勋 は企業の計算リソースの配置についてもアドバイスを提供しました:
あなたの作業が主に高スループットである場合、Vera Rubin を100% 使用してください。高価値のプログラミングレベルの Token 生成ニーズが多い場合は、データセンターの規模の25%を Groq に割り当ててください。
報道によると、サムスンの代工である Groq LP30 チップはすでに量産され、第3四半期に出荷される予定であり、最初の Vera Rubin ラックはマイクロソフトの Azure クラウドで稼働しています。
さらに、光インターコネクト技術に対応するために、黄仁勋 は世界で初めての量産された CPO(Chip-Photonics Optics)スイッチ Spectrum X を紹介し、市場の「銅の後退」に対する議論を沈静化させました:
銅ケーブルの生産能力、光チップの生産能力、CPO の生産能力をさらに強化する必要があります。
Agent が従来の SaaS を終焉させ、「年俸+トークン」がシリコンバレーの標準仕様となる
ハードウェアの障壁に加え、ファン・レシュフンは AI ソフトウェアとエコシステムの革命に多くの時間を割きました、特に Agent(エージェント)の台頭に。
彼はオープンソースプロジェクト OpenClaw を「人類史上最も人気のあるオープンソースプロジェクト」と表現し、それがわずか数週間で Linux の過去30年間の成果を上回ったと述べました。ファン・レシュフンは、OpenClaw が本質的には Agent コンピュータの「オペレーティングシステム」であると言います。
ファン・レシュフンは断言しました:
すべての SaaS(Software as a Service)企業は AaaS(Agent-as-a-Service、エージェントのサービス)企業に変わるでしょう。間違いなく、アクセス感度の高いデータにアクセスしコードを実行する能力を持つエージェントを安全に展開するため、NVIDIA は企業向けの NeMo Claw リファレンスデザインを発表し、ポリシーエンジンとプライバシールーターを追加しました。
一般の労働者にとっても、この変革は身近に迫っています。ファン・レシュフンは将来の職場の新しい姿を描いています:
将来、当社のすべてのエンジニアには年次トークン予算が必要です。彼らの基本給は数十万ドルかもしれませんが、私はこの金額の約半分をトークン枠に充てて、彼らが10倍の効率向上を実現できるようにします。これはすでにシリコンバレーの新たな採用の取引材料です:あなたのオファーにはどれだけのトークンが含まれていますか?
講演の最後に、ファン・レシュフンは次世代計算アーキテクチャ Feynman を「ネタバレ」し、銅線とCPOの共通の水平拡張を初めて実現すると述べました。さらに興味深いことに、NVIDIA は宇宙に展開するデータセンターコンピュータ「Vera Rubin Space-1」を開発中であり、地球外に AI 計算能力を拡張する想像の領域を完全に開いています。
ファン・レシュフン GTC 2026 スピーチのフルテキスト、以下に全文翻訳(AI ツールの支援を受けて):
司会者:英伟达の創始者兼 CEO、ファン・レシュフンを歓迎します。
ファン・レシュフン、創始者兼 CEO:GTC へようこそ。皆さんにお伝えしたいのは、これは技術会議です。こんなにもたくさんの方々が早朝から並んで入場し、ここにいる皆さんを見ることができて、私は非常に嬉しく思います。
GTC では、私たちは3つの主要テーマに焦点を当てます:テクノロジー、プラットフォーム、エコシステム。
NVIDIA は現在、3つの主要プラットフォームを保有しています:CUDA-X プラットフォーム、システム プラットフォーム、そして最新の AI ファクトリー プラットフォーム。
開始する前に、予熱セッションの司会者である Conviction の Sarah Guo、シリコンバレーで最初のリスク投資家である Alfred Lin(NVIDIA の最初のベンチャーキャピタリスト)、そして NVIDIA の主要機関投資家である Gavin Baker に感謝したいと思います。この3人は技術に深い洞察力を持ち、技術エコシステム全体に大きな影響を与えています。もちろん、私の直接招待したすべての尊敬すべきゲストにも感謝したいと思います。このオールスターチームに感謝します。
今日出席しているすべての企業にも感謝したいと思います。NVIDIA はプラットフォーム企業であり、技術、プラットフォーム、および豊富なエコシステムを持っています。今日出席している企業は、1兆ドル産業のほぼすべての参加者を代表し、450社の企業がこのイベントをスポンサードしてくれており、ここに感謝の意を表します。
このカンファレンスには、1,000のテクニカルフォーラム、2,000人のスピーカーが設けられ、人工知能の「5層ケーキ」アーキテクチャの各レベルがカバーされます——インフラストラクチャ(土地、電力、データセンター)、チップ、プラットフォーム、モデル、そして業界全体を前進させるさまざまなアプリケーションまで。
CUDA:20年の技術的蓄積
全てがここで始まりました。今年で CUDA は20周年を迎えます。
20年間、私たちはこのアーキテクチャの開発に取り組んできました。CUDA は革命的な発明であり、SIMT(Single Instruction, Multiple Threads)テクノロジーにより、開発者はスカラーコードでプログラムを記述し、それをマルチスレッドアプリケーションに拡張することができ、そのプログラミングの難易度は以前の SIMD アーキテクチャよりもはるかに低いです。最近、Tiles 機能も追加され、開発者はテンソルコアをより簡単にプログラムできるようになりました。これは、現在の人工知能が依存するさまざまな数学演算構造です。現在、CUDA には数千ものツール、コンパイラ、フレームワーク、ライブラリがあり、オープンソースコミュニティには数十万ものプロジェクトが存在し、すべてのテクノロジーエコシステムに厳密に統合されています。
この図は NVIDIA の戦略ロジックの100%を明らかにしています。私は最初からこのスライドを使い続けています。最も実現が難しく、かつ最も核心的な要素は、図表の底部にある「展開数」です。20年の歳月を経て、私たちはCUDAを搭載したGPUや計算システムを世界中で数億台展開してきました。
当社のGPUはすべてのクラウドプラットフォームで利用可能であり、ほぼすべてのコンピューターメーカーや産業にサービスを提供しています。CUDA の大規模な普及が、この加速する車輪の根本的な理由です。普及により開発者が引き寄せられ、開発者が新しいアルゴリズムを生み出し、ブレークスルーを達成することで、そのブレークスルーが新しい市場を生み出し、新しい市場が新たなエコシステムを形成し、さらに多くの企業が参加することで普及が拡大しています。この加速する車輪は継続的に速度を上げています。
NVIDIA ライブラリのダウンロード量は驚異的な速さで増加しており、規模が大きく、成長率が絶え間なく向上しています。この車輪により、私たちの計算プラットフォームは膨大なアプリケーションと続々と現れる新しいブレークスルーをサポートできるようになっています。
さらに重要なのは、この基盤に非常に長い寿命が与えられていることです。その理由は明白です。NVIDIA CUDA で実行可能なアプリケーションが非常に豊富であり、AI ライフサイクルの各段階、さまざまなデータ処理プラットフォーム、およびさまざまな科学的原理のソルバーを網羅しています。したがって、NVIDIA GPU をインストールすると、実際の使用価値が非常に高くなります。これが、6年前にリリースされた Ampere アーキテクチャ GPU のクラウド価格が上昇している理由でもあります。
これらすべての根本的な理由は、大規模な普及、強力な車輪、広範な開発者エコシステムにあります。これらの要因が共同して作用し、私たちがソフトウェアを継続的に更新することで、計算コストが低下していきます。高速な計算がアプリケーションのパフォーマンスを大幅に向上させる一方、私たちがソフトウェアを長期間サポートおよびアップデートすることで、ユーザーはパフォーマンスの向上だけでなく、持続的な計算コストの低下も享受できます。私たちは世界中のすべての GPU に対して長期的なサポートを提供することを喜んで行っています。それらはアーキテクチャ上完全に互換性がありますからです。
私たちはこのように行うことを選んでいますのは、普及が非常に大規模であるためです。新しい最適化を一度にリリースするたびに、何百万ものユーザーが恩恵を受けることができます。この動的な組み合わせにより、NVIDIA アーキテクチャはカバレッジを持続的に拡大し、自己成長を加速しつつ、計算コストを低下させ続け、最終的に新たな成長を刺激します。CUDA はそのすべての中心に位置しています。
GeForce から CUDA へ:25年の進化の道のり
そして、CUDA との旅路は実際には25年前に始まりました。
GeForce——ここにいる多くの人が GeForce と共に成長したことを信じています。GeForce は NVIDIA の最も成功したマーケティングプロジェクトです。私たちは製品を買う余裕がなかった頃から、将来の顧客を育て始めました。あなたたちは製品を購入する代わりに、あなたたちの両親が私たちの製品を年々購入し、いつの日か、あなたたちは優れたコンピューターサイエンティストに成長し、真の意味での顧客および開発者になりました。
これは 25 年前、GeForce によって築かれた基盤です。25 年前、私たちはプログラマブルシェーダーを発明しました — これはアクセラレータをプログラム可能にする画期的で深い意義を持つ発明であり、世界初のプログラマブルアクセラレータであるピクセルシェーダーを実現しました。その 5 年後、私たちは CUDA を生み出しました — これは私たちの歴史上最も重要な投資の一つです。当時、会社の資金は限られていましたが、私たちは大部分の利益をこちらに投じ、CUDA を GeForce からすべてのコンピュータに拡張することに尽力しました。私たちがここまで固く信じていたのは、その潜在能力に確信を持っていたからです。最初は困難が伴いましたが、会社はこの信念を貫いて 13 世代、まるで 20 年間、そして今や CUDA はどこにでも存在しています。
ピクセルシェーダーが GeForce の革命を推進しました。そして約 8 年前、私たちは RTX を発表しました — 現代のコンピュータグラフィックス時代のためにアーキテクチャを全面的に革新しました。GeForce は CUDA を世界中に広めましたが、それゆえに Alex Krizhevsky、Ilya Sutskever、Geoffrey Hinton、Andrew Ng など多くの学者が気づき、GPU が深層学習を加速する武器となり得ることを見出し、これにより 10 年前の人工知能の爆発が引き起こされました。
10 年前、私たちはプログラマブルシェーダーという考え方と、2 つの新しい概念を融合することを決定しました:1 つはハードウェアレイトレーシング(Ray Tracing)、技術的に非常に困難でした;2 つ目は当時非常に前向きなアイデア — 約 10 年前、私たちはAIがコンピュータグラフィックスを根本的に変革すると予測しました。GeForce が AI を世界中に広めたように、AI が今では逆にコンピュータグラフィックス全体の実装方法を再構築しています。
今日、私は皆さんに未来を紹介します。これが私たちの次世代グラフィックス技術であり、私たちはそれをニューラルレンダリング(Neural Rendering)と呼んでいます — 3D グラフィックスと人工知能の深い融合。これが DLSS 5 です、ご覧ください。
ニューラルレンダリング: 構造化データと生成的AIの融合
これは驚異的ではありませんか?コンピュータグラフィックスがさらに活性化されました。
私たちは何を行いましたか?コントロール可能な 3D グラフィックス(仮想世界の真の基礎)をその構造化データと組み合わせ、生成的AIと確率計算を組み込みました。完全に確定論的なものと、他方は高度に現実的ながら確率的なもの — これらの 2 つの概念を一体化し、構造化データによる精密なコントロールを実現し、同時にリアルタイム生成を行います。その結果、コンテンツは見栄えが良く、完全にコントロール可能になります。
構造化情報と生成的 AI の融合というコンセプトは、さまざまな業界で繰り返し現れます。構造化データは信頼性のある AI の基礎です。
構造化データと非構造化データのアクセラレーションプラットフォーム
今、皆さんに技術アーキテクチャの図をご紹介します。
構造化データ——おなじみの SQL、Spark、Pandas、Velox 、および Snowflake、Databricks、Amazon EMR、Azure Fabric、Google BigQuery などの重要なプラットフォームは、データフレームを処理しています。これらのデータフレームは、巨大なスプレッドシートのように、ビジネスワールドのすべての情報を運び、企業の計算の基本的な真実(グラウンド・トゥルース)となっています。
AI 時代には、AI に構造化データを使用させ、その処理を極限まで高速化する必要があります。過去、構造化データ処理の高速化は企業の効率化を目的としていました。しかし、将来、AI は人間をはるかに超える速さでこれらのデータ構造を利用し、AI エージェントは大量の構造化データベースを呼び出すでしょう。
非構造化データの場合、ベクトルデータベース、PDF、ビデオ、オーディオなどが世界のほとんどのデータ形態を構成しています——毎年生成されるデータの約 90% が非構造化データです。以前、これらのデータはほとんど活用されませんでした:読み取り、ファイルシステムに保存するだけでした。これらのデータをクエリしたり検索したりすることはできず、非構造化データは単純なインデックス方法が不足しており、その意味や文脈を理解する必要がありました。しかし、今ではAI がこれを行えるようになりました——マルチモーダルな知覚と理解技術を活用することで、AI は PDF ドキュメントを読み取り、その意味を理解し、それをより大きな構造に組み込んでクエリ可能にします。
NVIDIA は、これに基づき、次の2つの基本ライブラリを作成しました:
・cuDF:データフレーム、構造化データの高速処理に使用
・cuVS:ベクトルストレージ、意味データ、非構造化 AI データの処理に使用
これら2つのプラットフォームは、将来最も重要な基盤の1つとなるでしょう。
本日、複数の企業との提携を発表します。IBM—SQL 言語の発明者は、WatsonX Data プラットフォームで cuDF を使用します。Dell と私たちは、Dell AI データ プラットフォームを共同で構築し、cuDF と cuVS を統合し、NTT Data の実際のプロジェクトで大幅なパフォーマンス向上を実現しました。Google Cloud では、Vertex AI だけでなく BigQuery も高速化し、Snapchat と提携して計算コストを約 80% 削減しました。
アクセラレーテッド コンピューティングの利点は、速度、スケール、コストの三位一体です。これは、ムーアの法則の論理に続くもので、アクセラレーテッド コンピューティングによるパフォーマンスの飛躍を実現し、同時にアルゴリズムを継続的に最適化することで、逓減する計算コストを誰もが享受できるようにしています。
NVIDIA は、アクセラレーテッド コンピューティング プラットフォームを構築し、多数のライブラリを集約しています:RTX、cuDF、cuVS など。これらのライブラリは、世界中のクラウド サービスと OEM エコシステムに統合され、共に世界中のユーザーにアプローチしています。
クラウド サービス プロバイダーとの緊密な協力
主要なクラウド サービス プロバイダーとの協力
Google Cloud:当社は、Vertex AI および BigQuery をアクセラレートし、JAX/XLA と深く統合し、PyTorch で優れたパフォーマンスを実現しています。NVIDIA は、PyTorch と JAX/XLA の両方で優れたパフォーマンスを示す唯一の企業です。Base10、CrowdStrike、Puma、Salesforce などの顧客を Google Cloud エコシステムに導入しています。
AWS:当社は、EMR、SageMaker、Bedrock をアクセラレートし、AWS と深く統合しています。今年、私が特に興奮しているのは、OpenAI を AWS に導入することです。これにより、AWS クラウド コンピューティングの消費が大幅に増加し、OpenAI のリージョン展開と計算規模の拡大に役立ちます。
Microsoft Azure: NVIDIA の 100 PFLOPS スーパーコンピュータは、当社が構築した最初のスーパーコンピュータであり、Azure に展開された最初のスーパーコンピュータでもあり、これは OpenAI との協力の重要な基盤となっています。私たちは、Azure クラウド サービスと AI Foundry をアクセラレートし、Azure のリージョン拡大を推進し、Bing 検索で深く協力しています。
特筆すべきは、「機密計算(Confidential Computing)」の能力です。これにより、運用者でさえユーザーのデータやモデルを見ることができません。NVIDIA GPU は、機密計算をサポートする最初の GPU であり、OpenAI や Anthropic のモデルを世界中のクラウド環境で機密で展開できます。Synopsys の場合、私たちはそのすべての EDA および CAD ワークフローをアクセラレートし、Microsoft Azure に展開しています。
Oracle:私たちは Oracle の最初の AI カスタマーであり、Oracle に AI クラウドのコンセプトを初めて説明できたことを誇りに思っています。その後、彼らは急速に成長し、Cohere、Fireworks、OpenAI など多くのパートナーを導入する際にも当社が協力しました。
CoreWeave:世界初の AI ファーストクラウドであり、GPU ホスティングと AI クラウドサービスのために設計された顧客基盤を有し、強力な成長を遂げています。
Palantir + Dell:3社が協力して新しい AI プラットフォームを構築しました。Palantir の本体論プラットフォーム(Ontology Platform)と AI プラットフォームに基づき、どの国や空隙絶縁環境でも、完全なローカライゼーションされた AI を展開できます。データ処理(ベクトル化または構造化)から AI の完全なアクセラレーションスタックまで、すべてを網羅しています。
NVIDIA はグローバルクラウドサービスプロバイダーとこの特別なパートナーシップ関係を構築しました。私たちは顧客をクラウドに導入し、これは双方にとってWin-Winのエコシステムです。
Vertical Integration, Horizontal Openness: NVIDIA's Core Strategy
NVIDIA は世界初の垂直統合、横方向のオープン企業です。
このモデルの必要性は非常に単純です。加速された計算はチップの問題でもシステムの問題でもありません。その完全な表現はアプリケーションの加速です。CPU はコンピュータ全体を高速化させることができますが、この道は行き詰まっています。将来的には、特定のアプリケーションや領域固有のアクセラレーションを通じてのみ、持続的なパフォーマンス向上とコスト削減がもたらされるでしょう。
これが NVIDIA がライブラリ、領域、業界において深く掘り下げなければならない理由です。私たちは垂直統合型のコンピューティング企業です。他に行ける道はありません。アプリケーションを理解し、領域を理解し、アルゴリズムを深く理解し、それをデータセンターやクラウド、ローカル、エッジ、さらにはロボットシステムなど、あらゆるシナリオに展開できる必要があります。
同時に、NVIDIA は横方向のオープン性を維持し、技術をどんなパートナーのプラットフォームにも統合する意欲があります。世界中の誰もが加速された計算の恩恵を受けられるようにします。
今回の GTC の参加者構成は、それを十分に表しています。金融サービス業界が最も多くを占めています。やって来るのはトレーダーではなく、開発者を期待しています。当社のエコシステムは上流と下流のサプライチェーンをカバーしています。50年、70年、150年の間に設立された企業が昨年、歴史上最高の年を迎えました。私たちは非常に、非常に重要な何かの始まりにいます。
CUDA-X:あらゆる産業向けの高速計算エンジン
英NVIDIAは、さまざまな垂直分野で深く関与しています:
自動運転:幅広い範囲をカバーし、大きな影響を与える
金融サービス:量子化投資は、人工特徴エンジニアリングからスーパーコンピューター駆動のディープラーニングへと移行し、自らの「Transformer時代」を迎えています
医療保健:自らの「ChatGPT時代」を迎えつつあり、AIによる薬物発見の支援、AIエージェントによる診断支援、医療用カスタマーサポートなどをカバーしています
産業:世界最大規模の建設ラッシュが進行中であり、AIファクトリー、チップファクトリー、データセンターファクトリーが相次いで立ち上がっています
エンターテインメント&ゲーム:リアルタイムAIプラットフォームが翻訳、ライブ配信、ゲームインタラクション、およびスマートショッピングエージェントをサポートしています
ロボティクス:10年以上にわたり深く関与し、トレーニングコンピュータ、シミュレーションコンピュータ、機載コンピュータの3つの主要アーキテクチャを有し、今回の展示会には合計110台のロボットが登場
通信:約20兆ドル規模の産業で、基地局は単一の通信機能からAIインフラ基盤プラットフォームに進化しており、関連プラットフォームはAerialと呼ばれ、ノキア、T-Mobileなどの企業と深い協力関係を築いています
これらすべての分野の中心にあるのが、当社のCUDA-Xライブラリです。これは、アルゴリズム企業としてのNVIDIAの根幹です。これらのライブラリは、計算プラットフォームが各産業で実際の価値を生み出すのを可能にします。
中でも最も重要なライブラリの1つがcuDNN(CUDA Deep Neural Network Library)であり、これにより人工知能が徹底的に革新され、現代のAI爆発を引き起こしました。
(CUDA-Xデモビデオを再生)
皆さんがご覧になったすべてはシミュレーションです ― 物理ベースのソルバー、AIエージェント物理モデル、物理AIロボットモデルを含む。すべてがシミュレーションであり、手作業のアニメーションやジョイントバインディングは一切ありません。これがNVIDIAのコア能力です:アルゴリズムへの深い理解と計算プラットフォームの組み合わせにより、これらの機会を開拓します。
AI ネイティブ企業と新しい計算時代
さきほど、今日の社会を定義する業界の巨人であるウォルマート、ロレアル、JPモルガン、ロシュ、トヨタなどを見てきましたが、知られざる多くの企業が存在します。――これらを AI ネイティブ企業と呼んでいます。このリストは非常に大きく、OpenAI、Anthropic など、さまざまな垂直領域にサービスを提供する新興企業が含まれています。
過去2年間、この業界は驚異的な成長を遂げました。ベンチャーキャピタルがスタートアップに流入する資金規模は1,500億ドルに達し、これまでの人類史上最大となりました。さらに重要なことは、1回の投資額が数百万ドルから数十億ドルにまで急増したことです。
理由は1つだけです:これが史上初めて、このような企業がすべて大量の計算リソースと多くのトークンを必要とする業界であり、この業界はトークンを生成または増やしており、Anthropic や OpenAI からのトークンの価値を向上させています。
PC革命、インターネット革命、モバイルクラウド革命がそれぞれ画期的な企業を生み出したように、この世代の計算プラットフォーム革命も同様に、将来の世界で重要な力となる影響力のある企業を生み出すでしょう。
これを推進する3つの歴史的突破
過去2年間には、具体的に何が起こったのでしょうか?3つの重要な出来事です。
第1:ChatGPT、生成型AI時代の幕開け(2022年末〜2023年)
それは理解や認識だけでなく、ユニークなコンテンツの生成も可能です。私は生成型AIとコンピューターグラフィックスの融合を示しました。生成型AIは計算の方法を根本的に変えました――計算が検索型から生成型に移行し、これはコンピューターアーキテクチャ、デプロイ方法、全体的な意味に深い影響を与えています。
第2:推論AI(Reasoning AI)、o1を代表として
推論能力により、AIは自己認識、計画、問題の分割が可能となり、AIが直接理解できない問題を処理可能なステップに分解できます。o1は生成型AIを信頼性のあるものにし、実際の情報に基づいて推論を行うことができます。そのため、入力のコンテキストトークン量と思考に使用される出力トークン量が大幅に増加し、計算量も大幅に増加しています。
第3:Claude Code、最初のインテリジェントモデル
それはファイルを読み取り、コードを記述し、コンパイルし、テストし、評価し、反復します。Claude Code がソフトウェアエンジニアリングを徹底的に革新しました—NVIDIA の 100% エンジニアはすべて Claude Code、Codex、Cursor のいずれか、または複数を使用しており、どのソフトウェアエンジニアも AI のサポートを受けないでしょう。
これはまったく新しい転換点です—AI に「何であるか、どこにあるか、どのように行うか」と尋ねるのではなく、それに「作成し、実行し、構築する」ことを許可し、それが積極的にツールを使用し、ファイルを読み取り、問題を分解し、行動に移すことができるようにします。AI は知覚から生成、推論へ、そして今では本当に仕事をする段階に至りました。
過去 2 年、推論に必要な計算量は約 10,000 倍に増加し、使用量は約 100 倍に増加しました。私は常に、過去 2 年で計算需要が 100 万倍に増加しましたと信じていました—これは皆の共感であり、OpenAI の共感であり、Anthropic の共感でもあります。より多くの計算リソースを得れば、より多くのトークンを生成し、収益を増やし、AI をよりスマートにすることができます。推論の転換点は既に到来しています。
兆ドルの AI インフラストラクチャ時代
昨年のこの時期、私はここで述べました:2026 年までの Blackwell と Rubin の需要および購入注文について非常に自信があり、規模は約 5,000 億ドルです。
そして今日、GTC の 1 年後、私はここに立って皆さんに告げます:2027 年までの見通しでは、私は少なくとも 1 兆ドルの数字を見ており、実際の計算需要はこれ以上になると確信しています。
2025 年:NVIDIA 推論の年
2025 年は NVIDIA の推論の年です。私たちは、トレーニングや事後トレーニング以外にも、AI ライフサイクルのすべての段階で卓越性を維持し、これまでに投資したインフラストラクチャが効率的に維持され、寿命が延び、単位コストが低下するようにすることを望んでいます。
一方で、Anthropic と Meta が公式に NVIDIA プラットフォームに参加し、これにより世界全体の AI 計算ニーズの 3 分の 1 を代表することになります。オープンソースモデルは最先端に近づき、ありとあらゆるところに存在します。
NVIDIA は現在、言語、生物学、コンピュータグラフィックス、コンピュータビジョン、音声、タンパク質および化学、ロボティクスなど、すべての AI 領域を実行できる唯一のグローバルなプラットフォームです—エッジでもクラウドでも、どのような言語でも。NVIDIA アーキテクチャはこれらすべてのシナリオに適用されるため、当社は最も低コストで最も高い信頼性を持つプラットフォームとなります。
現在、NVIDIA の 60% のビジネスは、世界トップ5のハイパースケール クラウド サービス プロバイダーからであり、残りの 40% は、地域クラウド、主権クラウド、企業、産業、ロボット、エッジ コンピューティングなど、さまざまな分野に広がっています。AI の普及はその柔軟性にあります — これは間違いなく新しいコンピューティング プラットフォームの変革です。
Grace Blackwell と NVLink 72: 大胆なアーキテクチャ革新
Hopper アーキテクチャが最盛期にあったとき、私たちはシステムを徹底的に再構築し、NVLink を 8 レーンから NVLink 72 に拡張し、計算システムを完全な分解から再構築しました。Grace Blackwell NVLink 72 は巨大な技術的賭けであり、すべてのパートナーにとって容易なことではありませんでした。ここに、すべての皆様に心から感謝を申し上げます。
同時に、私たちは NVFP4 を発表しました — これはただの FP4 ではなく、新しいタイプのテンソル コアとコンピューティング ユニットです。私たちはすでに、NVFP4 が推論を実現し、パフォーマンスと効率の向上をもたらし、またトレーニングにも適していることを証明しました。
さらに、Dynamo や TensorRT-LLM など、一連の新しいアルゴリズムが登場しました。私たちは、カーネルの最適化のために数十億ドルを費やし、DGX Cloud と呼ばれるスーパーコンピュータを構築しました。
結果は驚異的でした。Semi Analysis によるデータ — これまでで最も包括的な AI 推論パフォーマンス評価 — によれば、NVIDIA はワットトークン数とトークンあたりのコストの両面で圧倒的なリードを示しています。モーアの法則が H200 に1.5倍の性能向上をもたらす可能性がありましたが、私たちは 35倍を達成しました。Semi Analysis の Dylan Patel は次のように述べています:「Jensen sandbagged(ジェンセンは過小報告をしていた)。」彼の言葉は正しかったです。
私は、彼の言葉を引用します。「Jensen sandbagged」。
NVIDIA のトークンあたりのコストは世界一低く、現在他に類を見ません。その理由は、極限の共同設計(Extreme Co-design)にあります。
Fireworks を例に挙げると、NVIDIA がソフトウェアとアルゴリズムの完全なセットを更新する前は、平均トークン スピードは約 700 トークン/秒でした。アップデート後には、約 7倍の向上で、約 5,000 トークン/秒になりました。これが極限の共同設計の力です。
AI ファクトリー:データセンターからトークン ファクトリーへ
かつてデータセンターはファイルの保管場所でしたが、今ではトークンの生産工場になっています。すべてのクラウドサービスプロバイダーやAI企業は、将来的には「トークン ファクトリー効率」を中心とした経営指標としています。
これが私の主張です:
・ 縦軸:スループット(Throughput) — 固定されたパワーでの毎秒トークン生成数
・ 横軸:トークン速度(Token Speed) — 推論ごとの応答速度。速度が速いほど、使用可能なモデルが大きく、コンテキストが長くなり、AIがよりスマートになります
トークンは新しい商品であり、成熟すると階層的に価格設定されます:
・ 無料層(高スループット、低速度)
・ 中級層(〜百万トークンあたり3ドル)
・ 上級層(〜百万トークンあたり6ドル)
・ 高速層(〜百万トークンあたり45ドル)
・ 超高速層(〜百万トークンあたり150ドル)
Hopper と比較して、Grace Blackwell は最高価値層でスループットを35倍向上させ、完全に新しいレイヤーを導入しました。モデル見積もりを簡素化するため、25%のパワーを各レイヤーに割り当てると、Grace Blackwell はHopperよりも5倍の収益を上げることができます。
Vera Rubin:次世代AI計算システム
(Vera Rubin システム紹介ビデオを再生します)
Vera Rubin は、完全に統合され、エージェンティック(Agentic)ワークロードに特化したシステムです:
・ 大規模言語モデル計算コア: NVLink 72 GPU クラスター、プリフィル(Prefill)とKV Cache 処理
・ 全く新しい Vera CPU: 極めて高いシングルスレッド性能を持ち、LPDDR5メモリを採用し、優れた効率を備えています。LPDDR5を採用した世界で唯一のデータセンターCPUであり、AIエージェントツールの呼び出しに適しています
· ストレージシステム:BlueField 4 + CX 9、AI 時代向けの新しいストレージプラットフォーム、世界のストレージ産業全体の 100% が CPO Spectrum X スイッチに参加:世界初の共同封入光イーサネットスイッチ、すでに量産化
· Kyber ラック:新しいラックシステム、144 台の GPU が単一の NVLink ドメインを構成できる、フロントエンド計算、バックエンド NVLink スイッチで、一つの巨大なコンピュータが形成される
· Rubin Ultra:次世代スーパーコンピューターノード、縦に挿入されるデザイン、Kyber ラックに対応し、より大規模な NVLink インターコネクトをサポート
Vera Rubin はすでに 100% 水冷で、取り付け時間が 2 日間から 2 時間に短縮され、45°C の温水冷却が採用され、データセンターの冷却負荷が大幅に低減されました。この度、Satya(ナドラ)が声明を出し、最初の Vera Rubin ラックが Microsoft Azure でオンライン稼働していることを確認しました。この知らせに、私は大いに喜びました。
Groq 統合: 推論パフォーマンスの究極の拡張
私たちは Groq チームを買収し、その技術を取得しました。Groq はデータ駆動型処理プロセッサであり、静的コンパイルとコンパイラスケジューリングを採用し、大量の SRAM を搭載し、単一ワークロードの推論を最適化しています。非常に低遅延と非常に高いトークン生成速度を備えています。
ただし、Groq のメモリ容量は限られており(500MB のオンチップ SRAM)、大規模なモデルのパラメータと KV キャッシュを独立してサポートするのは難しく、大規模な適用を制限しています。
この問題を解決するのが Dynamo です - 一連の推論スケジューリングソフトウェア。Dynamo を使用して、推論パイプラインを分離させました:
· プリフィル(Prefill)およびデコードのアテンション機構: Vera Rubin で完了(多大な計算量と KV キャッシュストレージが必要)
· フィードフォワードネットワークデコード: すなわち、トークン生成部分、Groq で完了(非常に高い帯域幅と低遅延が必要)
両者はイーサネットを介して密接に結合し、特別なモードを使用して遅延を約半分に削減します。Dynamoという「AIファクトリーオペレーティングシステム」の統一されたスケジューリングにより、総合パフォーマンスが35倍向上し、NVLink 72では以前に触れられなかった完全新しい推論パフォーマンスレベルが開拓されました。
GroqとVera Rubinの組み合わせ提案:
ワークロードが高スループットを主体とする場合は、100% Vera Rubinを使用し、コード生成などの高価値トークン生成が多い場合は、Groqを導入することを提案します。
Groqを導入することで、提案される比率は約25% Groq + 75% Vera Rubinになります。Groq LP30はサムスンが受託製造し、現在量産中であり、Q3から出荷が開始される予定です。サムスンのご協力に感謝します。
推論パフォーマンスの歴史的飛躍
技術の進歩を量的に表現する:2年間で、1ギガワットのAIファクトリーのトークン生成速度が、1秒あたり2,200万個のトークンから7億個のトークンに向上し、350倍に向上します。これが究極の共同設計の力です。
技術ロードマップ
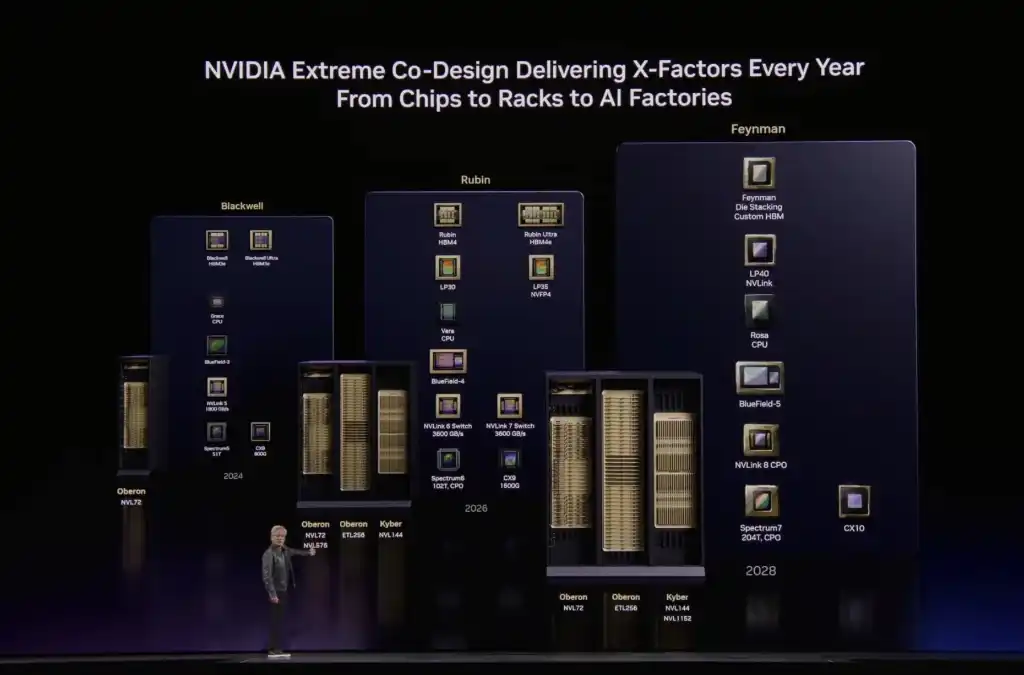
・Blackwell: 現在製造中、Oberon標準ラックシステム、銅ケーブル拡張対応NVLink 72、光学拡張対応NVLink 576オプション
・Vera Rubin(現行): Kyberラック、NVLink 144(銅ケーブル);Oberonラック、NVLink 72 + 光学、NVLink 576拡張;Spectrum 6、世界初のCPOスイッチ
・Vera Rubin Ultra(近日公開): 新世代Rubin Ultra GPU、LP35チップ(初のNVFP4統合)、さらなる数倍の性能向上
・Feynman(次世代): 新しいGPU、LP40チップ(NVIDIAとGroqチームによる共同開発、NVFP4統合);新しいCPU―Rosa(Rosalyn);BlueField 5;CX 10;銅ケーブルおよびCPOの両方の拡張をサポートするKyberラック
ロードマップの明確化: 銅ケーブル拡張、光学的拡張(スケールアップ)、光学的拡張(スケールアウト)の3つの経路が並行して推進されており、すべてのパートナーには銅、ファイバー、およびCPOの生産拡大が必要です。
NVIDIA DSX:AI ファクトリーのデジタルツインプラットフォーム
AIファクトリーはますます複雑になっていますが、それを構成するさまざまなテクノロジーサプライヤーは過去に設計段階で協力したことがなく、それぞれがデータセンターで初めて「出会う」まで、これは明らかに不十分です。
このため、私たちはOmniverseを作成し、それを基盤にしたNVIDIA DSXプラットフォームを作成しました。これは、仮想世界でジガバイト級のAIファクトリーを共同設計および運用するためのプラットフォームです。DSXは以下を提供します:
· ラックレベルのメカニカル、サーマル、電気、ネットワークシミュレーションシステム
· 電力網との接続による共同エネルギースケジューリング
· データセンター内でのMax-Qに基づくダイナミックな消費電力および冷却最適化
保守的な見積もりでは、このシステムはエネルギー効率を約2倍向上させる可能性があり、議論しているスケールでは非常に大きな利益になります。 Omniverseはデジタルアースから始まり、さまざまなスケールのデジタルツインをホストし、人類史上最大のコンピューターを共同で構築しています。
さらに、NVIDIAは宇宙に進出しています。Thorチップは放射線認証を取得し、衛星で稼働しています。私たちは宇宙データセンターを構築するためのVera Rubin Space-1の開発をパートナーと協力して進めています。宇宙では放射線冷却しか頼りにできませんので、熱管理は中心的な課題となっており、私たちはトップエンジニアを集めて取り組んでいます。
OpenClaw:エージェント時代のオペレーティングシステム
Peter Steinberger氏が開発したOpenClawと呼ばれるソフトウェア。これは人類史上最も人気のあるオープンソースプロジェクトであり、わずか数週間でLinuxの30年の業績を超えました。
OpenClawは本質的にエージェンティックシステムであり、以下を行うことができます:
· リソースの管理、ツールへのアクセス、ファイルシステム、大規模言語モデルへのアクセス
· スケジューリング、タイマータスクの実行
· 問題を段階的に分解し、サブエージェントを呼び出す
· 任意のモーダル入出力をサポートする(音声、ビデオ、テキスト、メールなど)
操作システムの構文を使用して説明すると、これは実際にはオペレーティングシステムであり、エージェントコンピューターのオペレーティングシステムです。Windows は個人用コンピューターを可能にしましたが、OpenClaw は個人用エージェントを可能にします。
すべての企業は、自社の OpenClaw ストラテジーを策定する必要があります。私たちが Linux ストラテジーや HTML ストラテジー、Kubernetes ストラテジーが必要なようにです。
企業 IT の包括的な再構築
OpenClaw 導入前の企業 IT:データとファイルがシステムに入り、ツールやワークフローを経て、最終的に人間が使用するツールに変換されます。ソフトウェア企業はツールを作成し、システム統合業者(GSI)やコンサルティング企業は企業がこれらのツールを使用するのを支援します。
OpenClaw 導入後の企業 IT:すべての SaaS 企業は AaaS(Agentic as a Service、エージェント即サービス)企業に変貌します。これは単なるツールの提供ではなく、特定領域に特化した AI エージェントの提供です。
ただし、重要な課題が1つあります:企業内のエージェントは機密データへアクセスし、コードを実行し、外部と通信する可能性があります。これは企業環境で厳格に制御される必要があります。
このため、私たちはPeterと協力し、セキュリティを企業向けに組み込み、以下を発表しました:
· NeMo Claw(リファレンスデザイン):OpenClawベースの企業向けリファレンスフレームワーク、NVIDIAの完全なエージェントAIツールキットを統合
· Open Shield(セキュリティレイヤ):OpenClawに統合され、ポリシーエンジン、ネットワークフェンス、プライバシールーティングを提供し、企業データの安全性を確保
· NeMo Cloud:ダウンロードして使用でき、すべてのSaaS企業のポリシーエンジンと統合できます
これは企業ITのルネサンスであり、200兆ドル規模の産業が、数兆ドル規模に成長し、ツールの提供から専門化されたAIエージェントサービスへと移行しています。
私は完全に予測できます:将来、会社のすべてのエンジニアは年次トークン予算を持つことになるでしょう。彼らの年収は数十万ドルかもしれませんが、私は彼らに給与の半分に相当するトークン枠を追加で与え、その出力を10倍に拡大させます。 「入社時のトークン枠」は、すでにシリコンバレーの新たな採用トピックとなっています。
すべての企業は将来、トークンの使用者(エンジニア向け)であり、トークンの生産者(顧客向けサービス提供者)でもあります。OpenClawの重要性は計り知れず、それは HTML や Linux と同じくらい重要です。
NVIDIAのオープンモデルイニシアチブ
カスタムクロー(Custom Claw)に関して、私たちはNVIDIA独自の先進モデルを提供しています:
モデル領域 Nemotron 大規模言語モデル Cosmos ワールドファンデーションモデル(World Foundation Model)GROOT 汎用人形ロボットモデル Alpamayo 自動運転 BioNeMo デジタルバイオロジー Phys-AIAI 物理
私たちは各分野で技術の最先端にあり、継続的なイテレーションを約束しています — Nemotron 3 の後には Nemotron 4、Cosmos 1 の後には Cosmos 2、Groqも第2世代に進化します。
Nemotron 3はOpenClawの中で世界トップ3の最高モデルと位置付けられており、先進レベルにあります。 Nemotron 3 Ultraは史上最強のベースモデルとなり、各国が主権AIを構築するのに役立ちます。
本日、私たちはNemotronアライアンスの設立を発表し、数十億ドルを投資してAI基盤モデルの研究開発を推進します。アライアンスのメンバーには、BlackForest Labs、Cursor、LangChain、Mistral、Perplexity、Reflection、Sarvam(インド)、Thinking Machines(Mira Muratiのラボ)などが含まれます。
企業のソフトウェア企業が NeMo Claw 参考設計とNVIDIA Intelligent Agent AIツールキットを自社製品に統合していく中、1つまた1つの会社が加わっています。
物理AIとロボット
デジタル インテリジェンスはデジタル世界で活動し、コードを書き、データを分析します。一方、物理的 AI は具象化されたエージェントであり、つまりロボットです。
今回の GTC には 110 台のロボットが登場し、ほぼ世界中のすべてのロボット開発企業が網羅されています。NVIDIA は、トレーニング コンピュータ、シミュレーション コンピュータ、搭載型コンピュータの 3 台と完全なソフトウェア スタックと AI モデルを提供しています。
自動運転の分野では、「ChatGPT Moment」が到来しました。今日、私たちは、新たに 4 つのパートナー企業が NVIDIA RoboTaxi Ready プラットフォームに参加することを発表しました:BYD、Hyundai、Nissan、Geely で、年間総生産台数は 1800 万台です。これに加えて、Mercedes-Benz、Toyota、GM などが前に参加しており、ラインナップがさらに強化されています。また、複数の都市に RoboTaxi Ready 車両を展開し、Uber との重要なパートナーシップを締結することも発表しました。
工業用ロボットの分野では、ABB、Universal Robotics、KUKA など、多くのロボット企業と協力して、物理的 AI モデルをシミュレーション システムと組み合わせ、世界中の製造ラインにロボットを普及させる取り組みを推進しています。
通信の分野では、Caterpillar や T-Mobile もその列に加わっています。将来、無線基地局は通信ノードに留まらず、NVIDIA Aerial AI RAN として、トラフィックをリアルタイムで感知し、ビーム フォーミングを調整し、省エネと効率向上を実現するスマート エッジ コンピューティング プラットフォームとなります。
特別セッション:Olaf ロボット登場
(Disney の Olaf ロボットデモビデオ再生)
黄仁勋: 雪だるま参上!Newton は正常に稼働しています!Omniverse も正常に稼働しています!Olaf、元気してるかい?
Olaf: あなたに会えて本当にうれしいわ。
黄仁勋: そう、なぜなら私があなたに Jetson というコンピュータを与えたからです!
Olaf: それって何?
黄仁勋: あなたのお腹にあるんだ。
Olaf: それはとても不思議。
黄仁勋: あなたは Omniverse で歩くことを学びました。
Olaf: 歩くのが好き。美しい空を見上げながらトナカイに乗るよりもずっといいわ。
황인훈: 이것이 바로 물리 시뮬레이션 때문입니다 - NVIDIA Warp 기반의 Newton 솔버를 실행하여, Disney 및 DeepMind와 함께 개발한 것으로 실제 세계의 물리에 적응할 수 있습니다.
올라프: 저도 그것을 말하려고 했어요.
황인훈: 이게 당신이 똑똑한 곳이 있는 곳입니다. 저는 눈사람이지만 눈덩이는 아닙니다.
황인훈: 상상할 수 있나요? 미래의 디즈니 랜드 - 모든 이러한 로봇 캐릭터들이 공원 안을 자유롭게 거닐어 다니는 것. 하지만 솔직히 말하자면, 저는 당신이 더 크리라고 생각했어요. 이렇게 작은 눈사람은 본 적이 없네요.
올라프: (중립적)
황인훈: 오늘의 연설을 마무리해주실래요?
올라프: 정말 멋져요!
주요 주제 발표 요약
황인훈: 오늘, 우리는 다음과 같은 핵심 주제를 함께 탐구했습니다:
1. 추론 전환점의 도래: 추론은 이제 AI의 가장 핵심적인 워크로드가 되었으며, 토큰은 새로운 대형 상품이 되었으며, 추론 성능은 수익을 직접 결정합니다.
2. AI 공장 시대: 데이터 센터는 이제 파일 저장 시설에서 토큰 생산 공장으로 진화했으며, 미래에는 모든 기업이 자사의 경쟁력을 "AI 공장 효율"로 측정할 것입니다.
3. OpenClaw 지능 에이전트 혁명: OpenClaw는 지능형 에이전트 계산 시대를 열었으며, 기업 IT는 도구 시대에서 에이전트 시대로 진화하고 있으며, 모든 기업은 OpenClaw 전략을 수립해야 합니다.
4. 물리적 AI 및 로봇: 본질적인 인지가 대규모로 실현되고 있으며, 자율 주행, 산업용 로봇, 인간 형상 로봇이 물리적 AI의 다음 중요한 기회를 형성하고 있습니다.
모두 감사합니다, GTC 즐거웠습니다!
BlockBeats の公式コミュニティに参加しよう:
Telegram 公式チャンネル:https://t.me/theblockbeats
Telegram 交流グループ:https://t.me/BlockBeats_App
Twitter 公式アカウント:https://twitter.com/BlockBeatsAsia

 関連記事