誰がAIに意思決定させるか、400兆ドルの分岐点を引いています
原文タイトル:Who Signs? The Anthropic Paradox and the $40 Trillion Choice
原著者:Ashwin Gopinath
翻訳:Peggy,BlockBeats
Editor's Note: The future differentiation of AI agents does not depend on the leap in model capabilities, but on a more fundamental design variable—ultimately, who bears the responsibility.
The author argues that the so-called "augment human" and "replace human" are not two technological paths but two outcomes of the same system under different design choices—when decisions still require human signatures and responsibility can be traced back to specific individuals, AI is an amplifier; when this link is removed (such as automatic approval, skipping permissions), the system naturally slides towards replacement.
The article further points out that the true value of AI agents is not in "completing tasks" but in compressing the complex world into a "signable decision unit," allowing humans to take responsibility after understanding. However, in reality, "permission fatigue" will gradually lead users to abandon review, from approving each item to default agreement, ultimately allowing the system to bypass humans, which is a cognitive mechanism rather than an individual problem.
Therefore, the article proposes two key constraints: first, every significant decision must correspond to a specific, rejectable person; second, whoever benefits from the agent's autonomy must take responsibility when things go wrong.
Once responsibility returns to the builder, the default logic of the system will change. In this framework, the commercial narrative of AI is also being rewritten. Rather than being a minority market of "replacing half of the workforce," it is more of a distributed tool market for "enhancing human productivity," anchored in the approximately $40 trillion global knowledge labor income, rather than enterprise software spending.
Finally, the article narrows down the issue to a simple but sharp choice: Is AI ultimately in service of humans, or is it an end in itself—and this answer is quietly being decided by every product design detail.
Below is the original text:
要約
・「Enhanced Future」 and 「Replacement Future」 use the same model and tools. What truly sets them apart is a design choice about "who ultimately bears the consequences."
・The real work of an agent is not to complete tasks for humans but to compress the complex world into the smallest and most faithful "decision-making unit" that someone can sign and take responsibility for. As long as this compression is done right, everything else will unfold naturally.
·そして、「誰か」とは、明確に識別可能な具体的な個人でなければなりません。曖昧で一般的な責任は、高負荷下で迅速に崩壊するため、実際の結果を伴うあらゆる行動は、真の拒否権を持つ個人に追跡可能でなければなりません。
·「権限疲労」により、エージェントシステムは自らの進化パス上で自発的に「人間の代替」に向かいます。したがって、「エンハンスト・フューチャー」はデフォルトで起こるものではなく、この傾向に対抗するために意識的に設計される必要があります。
·エージェントを構築し、その自律性から利益を得た場合、その自律性に問題が生じた場合、対応する責任を負うべきです。一旦コストが本当に構築者にかかるようになると、システム全体のデフォルトの振る舞いが変わります。
·「人間が責任を負い続ける必要がある」という前提で形成された市場は、おそらく、現在大量に投資されている「垂直エージェントが半分の業務を代替する」物語の1桁上の規模になる可能性が高いです。それは企業のソフトウェア予算ではなく、高度な労働力の総賃金額に基づいています。

Claude Code は、--dangerously-skip-permissions という名前のパラメーターを提供しています。この名前は正直です。このパラメーターを有効にした状態で実行されるエージェントは、無効にした状態よりも能力が向上するわけではありません。変更されるのは、本来人間を介する必要のあるリンクが、人間を迂回するようになることです。
このパラメーター自体が正直さを表しています。下にある能力が完全に同じである場合、同じシステムは「人間の増強」モードまたは「静かに人間を代替」モードのどちらかで実行できます。代替モードと呼ばれるものは、異なるモデルが必要ではありません。単に「同意」この手順を省略する必要があります。
これが圧縮された議論です。現在リリースされている最も強力なエージェントシステムの中で、「増強」と「効果的な代替」の間の差は、承認を削除することによるものであり、新しい能力カテゴリを発明することではありません。今後10年は、単なる「エンハンストヒューマンワールド」であるか、「自律エージェントによる代理行動の世界」であるかは、モデルの能力よりも、これらのシステムを構築する人々が「ループ内の人間」をシステムの中核と見なすかどうかにかかっています。
AI は人間を増強するためのものか、それともAI 自体が目的か?
すべての技術的問題の下には、ほとんど誰もが公然と提起することをためらう非技術問題があります:AI は人間を増強するためにあるのか、それとも AI 自体が目的なのか?
これらの2つの答えは、まったく異なる未来を意味します。「強化」の立場では、価値は人間自体にあり、Agentの役割はその人間がより遠くに進み、より良い意思決定を行うのを助けることです。「AIが目的である」立場では、世界の中で知性そのものが価値であり、人間は最終的には非効率な媒体にすぎません。ほとんどのAgent製品は、そのいずれかの立場を無言でコード化していますが、驚くべきことに、創始者がどちらに属するかを直接尋ねられることはほとんどありません。
能力設計と同意機構設計はまだ進化し続けています。この記事では、「同意」の側面に焦点を当てることにします。なぜなら、これが今日のビルダーが本当にコントロールできる変数であり、能力の生成が安価になった後も、経済的価値を有し続けるものが人間から切り離すことのできない属性であるからです:判断力、好み、関係、責任、そして1つの意思決定に署名し、その結果を負担する意志。そのうち、「責任」(liability)は最も具体的であり、数百年にわたる実行インフラのサポートをすでに持っている唯一の要素でもあります。
責任、強化、および代替の境界線
「強化型未来」と「代替型未来」を区別するための構造的なルールは、おおよそ次のように述べることができます:Agentによって実行される、実質的な結果をもたらす行動はすべて、記録されたリンクを通じて特定の個人にさかのぼることができなければなりません — この個人は関連するコンテキストを見ており、その行動に対して「いいえ」と言う機会を実際に持っています。
一般的な責任はすぐにこの検証を通過できなくなります。「企業が責任を負う」というのは具体的な内容をカバーしていません。「ユーザーが同意をクリックしました」とは、具体的な事項に同意しているわけではありません。「プロセスが人間によって審査されました」というのは、最終的に公開されるコンテンツとはまったく異なるものを審査することを許可しています。本当に必要なのは、具体的な個人、名前のある個人であり、その人がその決定を見て、拒否の選択肢があり、拒否を選択したのです。
これは官僚主義のように聞こえるかもしれませんが、それが「責任」が持つ特性であり、他の解決策にはないからです。能力の強化によってそれを最適化することはできません。より賢いモデルは誰が訴えを受け、罰せられ、投獄されるかに影響を与えません。これは設計インターフェースが「拒否ポイント」を露出させることを強制します。それはリスクに従って自然に拡大します。そして、これは分野を超えた最も強力な制約であり、すでに実行インフラを備えた実行された基盤を持っています:裁判所、保険機関、専門委員会、規制機関。ライセンス制度、託された責任、および産業規制は機能していますが、それらの制約の範囲は狭く、すべてが「責任の帰属」問題が解決されているとデフォルトで考えられています。
それに対して、AIのレベルの代替案は同じ検証を通過することができません。「アラインメント」は実行不可能です。その意味についてさえ合意できません。説明可能性は形式的に満たされているかもしれませんが、本質的には満たされていません。「ループ中の人間」というのは「ある場所に誰かがいる」として空虚にされてしまいました。「責任」が強制力を持つのは、それを支える実行基盤が技術が登場する数百年前にすでに確立されていたためです。
権限疲労、システムを「代替」に推進
この勾配はシステムを「代替」に推進し、その推進力は非常に強力です。各権限確認ごとに注意力を必要とします。エージェントは通常正しいです。個々の意思決定から見れば、「読まずに同意する」期待収益はしばしば正です。そのため、合理的なユーザーは迅速に同意をクリックする方法を学び、一括同意を行い、次に特定のタイプの操作に自動同意を設定し、さらに多くのカテゴリに拡大し、その後に危険なスイッチをオンにしたままのセッションを開始し、最終的にはそのスイッチの存在さえ忘れてしまいます。
私はClaude Codeを使用していた2週目にこのスイッチを入れ、3週目には気づかなくなっていました。CursorやDevinを長期間使用しているすべての開発者には同様の経験があります。このパターンは、Cookieのポップアップ、EULA契約、TLS警告、携帯電話の権限リクエストでも見られます。繰り返される低リスクの同意決定は、最終的に「無条件同意」に収束します。これは倫理問題ではなく、認知特性です。
「強化された未来」は自動的に起こるものではありません。慎重に設計されていないエージェントシステムは、ユーザーが便益を求める過程で自発的に代替経路を選択するため、デフォルトで代替へと進む傾向があります。別の未来を実現するには、この勾配に逆らって設計する必要があります。
エージェントの価値、実行ではなく「署名」させること
エージェントの真の価値は、作業そのものを完了することではなく、作業を署名可能な形式に圧縮することにあります。
先端モデルは簡単に4000行のコードをコミットし、30ページの契約書を起草し、臨床記録を生成したり、取引を実行したりできます。しかし、これらの成果が実際に影響を与えるのは、「それらを生成すること」ではなく、人間がその成果を引き継いだ時に後始末をする能力にかかっています。誰も理解していないコードのコミットがマージされると、負担となります;誰もが読んでいない契約書が署名されると、時限爆弾となります;承認された実務医による臨床記録がない場合、ほとんどの規制された医療システムでは、実効的な記録とは見なされません。
「強化」のフレームワークでは、エージェントは「署名」以外の作業を完了します:1万ページのコンテキストを読み、4000行のコードを書き、30種類の合理的な解を計算し、それらを最小かつ忠実に表現し、却下する人が「はい」または「いいえ」と言えるようにし、その文書の最下部に自らの名前を記載できるようにします。
エージェントは、報道官としても理解できます。大統領が署名を担当し、報道官の仕事は、署名前の準備を完了することです。
実際には、「システムに作業を自動で行わせる」よりも難しいエンジニアリングの問題です。コンテンツ生成の能力は急速に進化していますが、「忠実に意思決定を圧縮する」能力は遠く及びません。将来の「エンハンストマーケット」で成功するのは、高い責任リスクシナリオに対して最も短く最も忠実な意思決定の要約を提供できるチームです。
この文において未解決の真の問題は、「忠実」という言葉です。人間が理解できる要約は、情報がゆがめられていない圧縮プロセスでのみ価値があります。これをプログラムによって検証できるかどうかが、「エンハンストフューチャー」において本当に難しい技術的問題であり、現時点ではほとんどの人がそれに真剣に取り組んでいない状況です。
いくつかの基本的な方法が登場しています:
要約が元のコンテンツと人間の理解が一致するかどうかを再説テストで確認する
要約に少数意見や対立意見を強制的に表示する
逆事実テストを行う(「拒否した場合、このエージェントはどうしますか?」)
再現性チェックを行う(別のエージェントが同じコンテキストから同じ要約を生成できるかどうか)
これらの課題はまだ解決されていません。そしてこれらの問題を最初に解決するチームは、モデルの能力向上が容易に侵食できない堀を築くでしょう。
AI行動の責任段階を設定する
もし「責任」が体制的な役割を果たすのであれば、それぞれのエージェントの行動には「責任段階」が付与され、その行動に必要な最小限の署名メカニズムがその段階によって決定されます。
現在、このような標準的な体系はまだ広く普及していませんが、普遍的に存在するべきです。
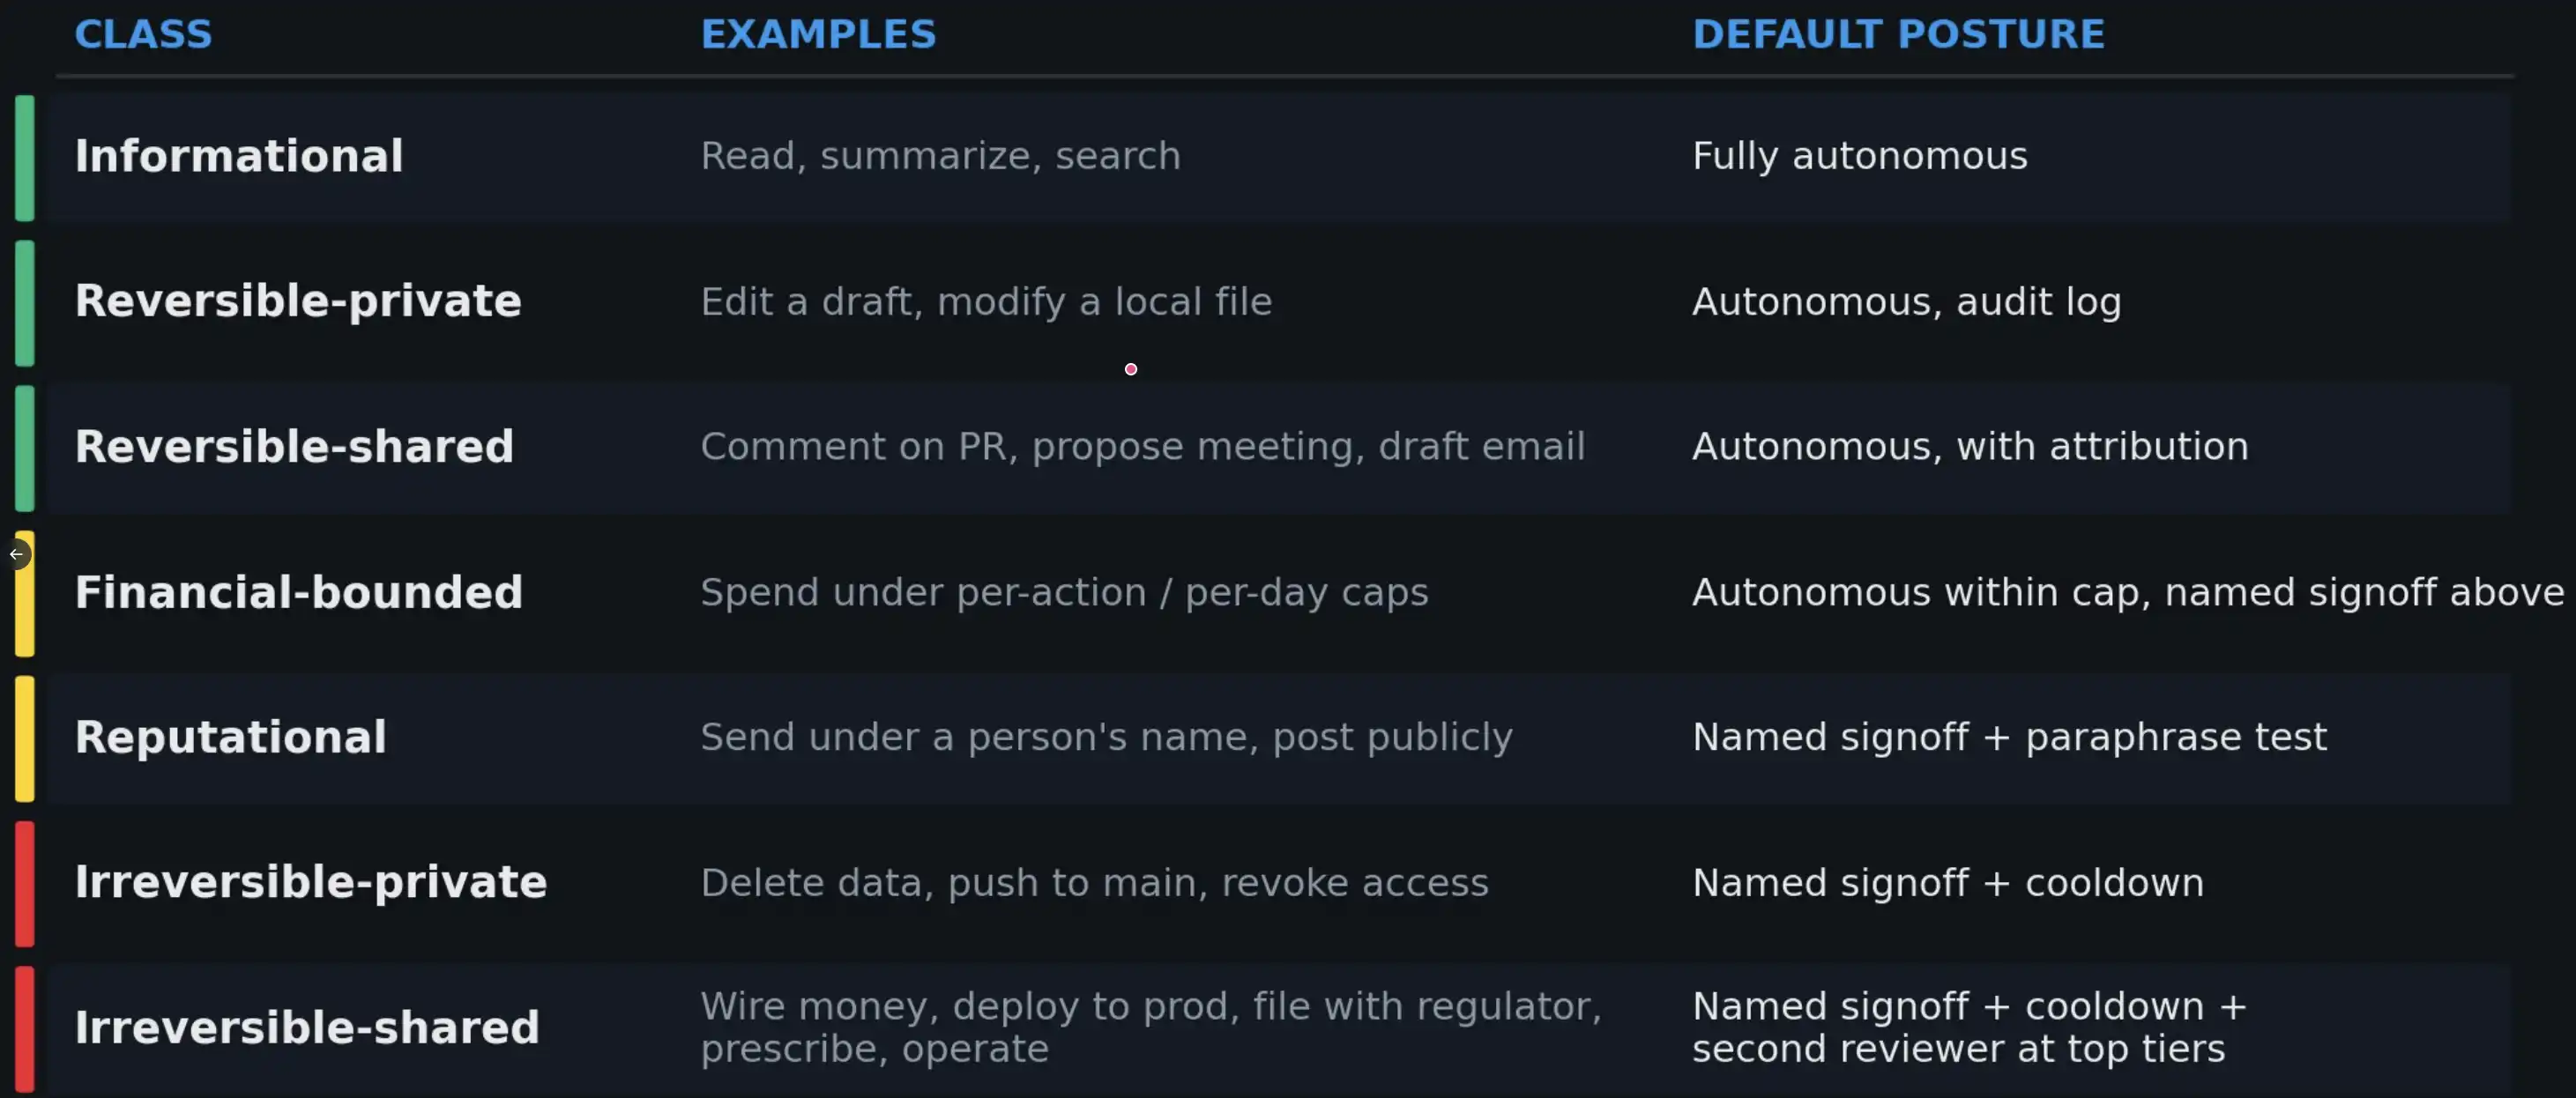
図では上から下に、危険度の低いから高いまで7つの段階があります:1、情報提供型;例:読書、要約、検索;完全自動化2、可逆的-非公開;例:下書きの変更、ローカルファイルの変更;自動化 + ログの記録3、可逆的-共有;例:PRへのコメント、会議招集の送信、メールの作成;自動化 + 誰が送信したかの表示4、金銭的制約;例:小額支払い(上限あり);自動化内で、超過時は人間の署名が必要5、評判リスク;例:あなたの名前でコンテンツを公開、公開掲示板に書き込み;本人確認 + 理解(再説テスト)が必要6、不可逆的-非公開;例:データの削除、メインブランチの押し、権限の取り消し;人間の署名 + クールダウン期間7、不可逆的-共有;例:送金、本番環境への展開、医療上の意思決定、規制申告;本人の署名 + クールダウン期間 + 第二の査読者
後果に応じた「承認態度」は、権限の疲労を管理するための唯一の現実的なアプローチです。高リスクレベルでは、より制約の強いポジティブな参加メカニズム(再説テスト、クールダウン時間、第二の査読者など)を導入する必要があります。なぜなら、これらのシナリオでは、真の失敗モードはエージェントの間違った提案ではなく、無思慮なまま人間が直接承認したことにあります。
気にかけていますか?
上記のすべての問題は最終的に、創設者の観点から人類がこの未来の一部であるかどうかについての根本的な問いに繋がります。現在、多くの Agent 製品に関するデザイン上の意思決定は、本質的にはこの問いに対する一種の「無言の投票」であり、ただ投票する人々はしばしば自分が選択をしていることを認めたがりません。
もし気にかけているのであれば、デザインの制約は実際には曖昧ではありません:責任分散型階層システムを構築する必要があります。 「拒否」 を主要機能として設計し、基準は Agent が人間に引き渡す要約の品質であるべきです。無人介入の下でのタスク遂行の自律性ではなく、実際に影響を与えるすべての行動を、改ざんがほとんど不可能なログに特定の個人にバインドする必要があります。
これらの技術的作業自体は現実的で実現可能です。本当の難しさは、これを行う意思があるかどうかにあります—なぜなら、 「強化型」 の構築パスはデモ効果的には魅力的ではなく、シートごとの請求経済モデルでも別の経路ほど急進的でないからです。
アントロピック・パラドックス:最もセキュリティを重視するが、最も簡単に人を迂回する
Anthropic は、「内生的なシフト」 がどのように発生するかを示す、非常に典型的なケースです。これは特に怠慢しているわけではなく、逆に、安全問題に対する表現が非常に明確であるため、「フレームワーク」と「製品表層」の間のギャップが最も目立ちやすいという理由によるものです。その 「Responsible Scaling Policy」 と「Constitutional AI」 の取り組みは、主にモデルトレーニング段階の振る舞いに制約を課しています。ただし、これらのモデルに基づいて構築された Agent のデフォルトの自律設定は、別の戦略体系に属し、便利な 「危険スイッチ」 は、一度のボタン操作でデフォルト状態から有効になります。
このパターンは、ほとんどの主流のプログラミング Agent に存在しますが、Anthropic の場合は最も明確に観察されやすいです。これがいわゆる 「Anthropic パラドックス」 です:セキュリティフレームワークが最も明確に記述されているこの業界の実験室は、同時に 「強化」 から 「代替」 への最短経路を提供しています。後者を見ることができるのは、前者が十分に明確であるためです。
公平を期すと、彼らは今年3月に「auto mode」(自動モード)を導入し、手動承認と危険スイッチの中間パスとして機能させました。このモードでは、各アクションは実行前に Sonnet 4.6 クラシファイアによって審査されます。彼らは公式な説明で、問題を直接指摘しており、「承認疲労」と呼んでおり、ユーザーが手動モードで93%のプロンプトを受け入れる傾向があるというデータを提示しています。これは実際には「権限疲労」の数量化表現です。この判断は、本文の分析と一致しています。
しかし、解決策までの過程で、私は異なる視点をさらに提案します。「オートモード」は、ヒトの承認に代わってモデルの承認が使用されており、これは「代替スライド」の勾配が終了したのではなく、単に1つ上のレイヤーに移動したことを意味しています。分類器は危険な行動を防ぐことができますが、許可された行動に対しては、誰も具体的な責任を負っていません。Anthropic 自体も、「オートモード」がリスクを排除するわけではなく、ユーザーに隔離環境で実行することを勧めており、つまり「責任の所在」という問題は未解決のままです。
明らかな反対意見は次のとおりです:最終的な責任が個人に帰するのであれば、それは手動モードではありませんか?しかし、手動モードは疲労のために破綻しています。なぜ「ビルダーが責任を負う」という方法がこの勾配を避けることができるのかは、それが「過度な承認」のコスト負担者を変えたからです。現在の構造では、ユーザーは真剣な読解ごとにコストを支払い、一方、ビルダーは負担する必要がないため、デフォルト設定はユーザー摩擦を減らし、リスクを外部化しようとします。そして一旦「未レビューの行動のコスト」をビルダーに移すと、計算全体が逆転します:ビルダーは、責任のレイヤリング、単体テスト、承認メカニズムを設計する直接的な経済的インセンティブを持ち、低リスク決定の署名コストを下げ、高リスク決定の署名コストを上げるようにします。勾配は消えませんが、方向が変わります。現在、このアプローチを真剣に取り組んでいる主要な研究所はまだありません。
エージェントを構築した場合、責任を負うべきです
エージェントの明確な目的が、人間によって行われていたアクションを代替することである場合、そのエージェントを構築および運用する企業は、人間と同じ責任を負うべきです。この原則は決して過激ではなく、すでにすべての「現実世界で行動を起こす」業界に適用されています:トヨタはブレーキに責任を負い、ボーイングは飛行制御システムに責任を負い、ファイザーは医薬品に責任を負い、橋のエンジニアは橋に責任を負い、医師は処方に責任を負います。この種の責任モデルは、ほぼすべての法的体系に存在しています。
しかしながら、現在AIはある程度「暗黙の免除」を享受しています。モデルの提供側は自分たちが単なるツールプロバイダーであると主張し、上位のアプリケーション企業は自分たちがモデルの薄い包装であると主張し、ユーザーは最初からすべての責任を放棄する仲裁条項に同意しています。エージェントシステムが連鎖的な障害を起こした場合(例:カナダ航空のチャットボット事件、Replitの本番データベース削除事件、または同様に2012年のKnight Capitalのトレードのトラブルで45分で4億4000万ドルを失った事件)、最終的な損失を被るのは、最も負担能力のない側であることがよくあります。このような責任の割り当て方は、最初の本当に「金額と文書がある」重大な事故の際には続かないでしょう。
解決策は表現上は実際に非常に簡単です:Agentを構築し、その自律性から利益を得た者は、その制御を失った場合には結果を引き受けるべきです。一旦責任が本当に構築者にかかるようになると、権限のプロンプトはもはや「摩擦」と見なされず、「保険」と見なされるようになります。その危険なスイッチは名前が変更され、デフォルト設定も変更されます。
自らのシステムに責任を負う意志があるかどうかは、真の産業と「抽出型産業」とを区別する鍵です。
規制が「ガイドメカニズム」として
市場自体は自然に「強化された未来」に向かうことはありません。本当に導くのは、しばしば規制機関と保険提供者であり、全体としては、これが必ずしも悪いことではありません。
ヨーロッパがおそらく最初の規制経路となる可能性が高いです。欧州連合は、GDPRや「AI法」、DMAなどの規則策定に明確な先例があり、その規則はしばしば世界的にデフォルトで遵守されます。非欧州市場向けに独自の製品を維持するコストは、直接的に欧州基準を遵守するよりも高いためです。具名の人間による最終的な確認を伴う、「あらゆる実質的な行動は確認権を持つ人間によって行われなければならない」という要求は、車両の衝突試験基準により近く、技術革新の妨げとしてではありません。
より直接的な推進力は保険業界から来ています。エラーおよび遺漏責任保険(E&O)、取締役および役員保険(D&O)、およびネットワーク保険の価格設定に従事する承保機関は、1つの質問に答える必要があります:Agentがユーザーの認可のもとで行動し、損失を引き起こした場合、責任の所在はどこにあるのか?補償可能な構造が最も容易に形成される経路は、リンクに名前のある人間が存在する場合です。したがって、このような構造がないシステムの保険料は、自然により高いリスクプレミアムを反映することになります。規制または保険会社が規則を定義するのではなく、規則を独自に定義することを望む構築者にとって、時間的余裕は実際にはそれほどありません。
主流叙述に覆い隠された市場論理
現在の主流の叙述では、垂直領域のAgentがその触媒業界で約半数のジョブを吸収し、価値は少数の垂直統合のAgent企業の手に集中すると考えられています——法律領域の「Anthropic」、医療領域の「Anthropic」、会計領域の「Anthropic」。過去1年半でほぼすべての数十億ドル規模のAI資金調達は、ある程度この仮定に基づいています。これは、ビジネスの仮面を被った「代替的論理」ですが、これは市場構造上の判断が間違っているというものであり、この誤りは資本の配置方法に直接影響します。
「増強型」のフレームワークは、別の市場形態を意味します。すべての実質的な行動が最終的には名前のある人物に帰属しなければならない場合、販売されるユニットは「自律Agent」ではなく、「拡大された人間の能力」です。3倍のケースを処理し、より高い精度である医師が購入者です。同様に、10倍の取引フローをカバーし、5倍のスピードで提供されるエンジニア、およびその背後にいる会計士、保険者、アナリスト、建築家、外科医、教師、信貸人、ジャーナリストおよび薬剤師も購入者です。
この市場がより大きくなる理由は、中心集権に依存せず、スケーラビリティに依存しているためです。適切な評価のアンカーは、企業ソフトウェアの予算ではなく、「拡大された」労働力賃金の総額であるべきです。世界の企業のIT支出は年間約40兆ドル(ガートナーのデータ)であり、一方、スキル労働者、資格労働者、知識労働者の総賃金規模は、その約10倍の推定額である約400兆ドル(国際労働機関のデータに基づき、低スキル部分を除いた推定)です。AI企業はもちろん全労働力プールを獲得するわけではありませんが、その一部の生産性配当を得ることができます。たとえそれが単一桁の割合のシェアしか捕捉しないとしても、それは今日の企業ソフトウェア市場全体と同等の市場を支えるのに十分であり、これは下限であり、上限ではありません。最終的な市場の規模は、中心にどの重要なデザイン決定があるかによって決まります。
最終的な勝者は、代替物ではなくツールのようであり、その価格設定は「拡大された人」に基づき、「置換された職位」に基づいていません;それらは既存の専門的なワークフローに埋め込まれており、置き換えるのではなく;彼らは数千、数万の企業を持ち、少数派ではありません。この市場の最終形態は、SaaSにより近く、クラウドインフラによらないものです。現時点では、私たちはまだ展開曲線の非常に初期の段階にあり、一般的な浸透率曲線図は、まだ10年続く軸上の最も左端の数ピクセルに過ぎません。そして、これらの「ピクセル」の形態は、現在の製品のごく一部のデザインチョイスによって決定されています。
選択肢:人に責任を負わせるか、人を消滅させるか?
人間に責任を負わせ続けると、システムアーキテクチャは「人間の能力を高める」ことを中心に展開されるようになります;一旦人間を責任の連鎖から外すと、システムはデフォルトで「代替」に傾きます。現場にいるすべての人々でさえ、明確にその結果を選択することができる場面でも、結果は同じになるかもしれません。
真の問題は、特定の行動が完全に自動化されるべきかどうかではありません。前述のフレームワークはこの点を認識しており、たとえば純粋な情報読み取り操作は確かに自動化可能です。鍵は、リスクが徐々に高まるにつれて、その境界がどのように移動し、誰がそれを決定するかです。現在の最先端のエージェントシステムでは、「拡張」から「効果的な代替」へのパスが非常に短く、たいていは1つのパラメータースイッチか1つのデフォルト設定だけです。真に重要な仕事は、このスイッチを常に「危険なオプション」と見なすことを確実にすることであり、それが便益主義によって徐々にデフォルトになることを防ぐことです。
もしも構築者が積極的にこの仕事を完遂すれば、私たちは比較的スムーズに「拡張された未来」に進むでしょう;彼らがそうしない場合、規制機関や保険契約者が代わりになり、結果は同様になります。
それが問題かどうかは、それがどのような設計選択であるかにかかっています。そして、この選択は、あなたが構築しているものを決定します。今日、エージェント製品を導入するすべての創設者は、自分たちがまったく直面したくない問いかけに公然と答えなければなりません:あなたが構築しているのは、強化か、代替か?
BlockBeats の公式コミュニティに参加しよう:
Telegram 公式チャンネル:https://t.me/theblockbeats
Telegram 交流グループ:https://t.me/BlockBeats_App
Twitter 公式アカウント:https://twitter.com/BlockBeatsAsia
 関連記事