Claude Opus 4.8がリリースされ、Anthropicは「信頼性」を製品のセールスポイントとして打ち出し始めた。
原文タイトル:Claude Opus 4.8:ベンチマーク、信頼性、そして新機能
原文著者:The AI Bridge
翻訳:Peggy、BlockBeats
編集者注:Anthropic が Claude Opus 4.8 をリリース。6つの主要ベンチマークのうち5つでトップを獲得し、価格は据え置き。Claude Code には動的ワークフローが追加され、次世代の Mythos 級モデルも市場の期待を集めている。
単なる性能向上以上に注目すべきは、Anthropic が「信頼性」をフロンティアモデルの核心的なセールスポイントとして打ち出し始めた点だ。
コードの誠実性テストでは、Opus 4.8 は自身のエラーを見逃す割合が大幅に低下。Claude Code では複数のサブエージェントを調整し、結果を提供する前に対抗的な自己チェックを導入する。これらの変化は共通して、現実的な問題を指し示している。AI がチャットウィンドウから実際のワークフローに移行する際、ユーザーが最も懸念するのは、モデルがタスクを完了できないことではなく、エラーを起こしながらも一見完全で流暢かつ自己矛盾のない回答を返すことだ。
したがって、Opus 4.8 の意義は単なるモデルアップグレードにとどまらず、明確な業界シグナルを発している。フロンティアモデルの競争は、単なるベンチマークの追いかけから、信頼性、検証可能性、エラー開示能力の争いへと移行しつつある。企業やプロフェッショナルユーザーにとって、次世代 AI の核心的なハードルは、モデルが委託に値するかどうかにますます依存するだろう。
これこそが、エージェントが真に実用可能となる前提条件でもある。モデルはより多くのタスクを完了する必要があると同時に、より重要で複雑なタスクを任せても大丈夫だと人々に思わせる必要がある。
以下が原文である:
Anthropic は本日、Claude Opus 4.8 をリリースした。リリースカードに記載された6つのベンチマークのうち、5つでトップを獲得した。
私が最も注目した重要な変化は、Anthropic のコード要約誠実性テストにおいて、Opus 4.7 では19.7%のケースで自身のエラーを指摘しなかったのに対し、Opus 4.8 ではその割合が3.7%に低下したことだ。同じタスクにおいて、自身の作業に対するエラー識別能力が約5倍向上した。Anthropic は発表でこれを「4倍」とまとめている。どのように計算しても、これは実際の作業をこのモデルに任せて安心して離れられるかどうかを決定づける要素であり、リリースカード上のどのベンチマークスコアよりも重要である。
実際にリリースされたもの
まず簡潔版を説明し、その後具体的な数字に入ります:
信頼性が本当に向上しました。 上記のコード誠実度データに加え、Opus 4.8 は2つのデューデリジェンステストで「文字通りのゼロ」を達成した初のClaudeモデルでもあります。「欠陥のある結果を誤って報告する頻度」を0.25から0.00に、「怠惰な調査」の発生率を25%から0%に低減しました。過信による誤回答は約11分の1に減少。自身の作業を優遇する傾向、つまり4.7で測定可能だったバイアスは消失しました。
Claude Codeに動的ワークフローが追加され、現在は研究プレビュー版です。 Claudeは現在、自らオーケストレーションスクリプトを作成し、1回のセッションで数十から数百のサブエージェントを並行スケジュールし、独立した対抗エージェントを実行して、結果を提示する前にそれらの結果に反論を試みます。これはOpus 4.6で提案された「エージェントチーム」の概念が、自動化能力へと進化したものです。
リリースカードではリードしていますが、全面的な優位ではありません。 6項目中5項目で勝利。GPT-5.5は端末操作タスクで依然としてリードしています。またシステムカードには、Anthropicがプレゼンテーションスライドに載せなかった誠実さの後退も隠されており、後述します。
価格に変更はありません。 依然として入力トークン100万あたり5ドル、出力トークン100万あたり25ドルで、4.7と同じです。ただし高速モードは以前より3倍安くなりましたが、それでもプレミアム枠に属し、価格は10ドル/50ドルです。
Mythosが登場します。 Anthropicは、アクセス制限付きで能力の高いMythos級モデルが数週間以内に登場することを明確に示しています。Opus 4.8はそれへの公開エントリーポイントです。
公式リリースカード:ベンチマークの状況
以下が公式リリースカードで、当社の配色で表示しています。
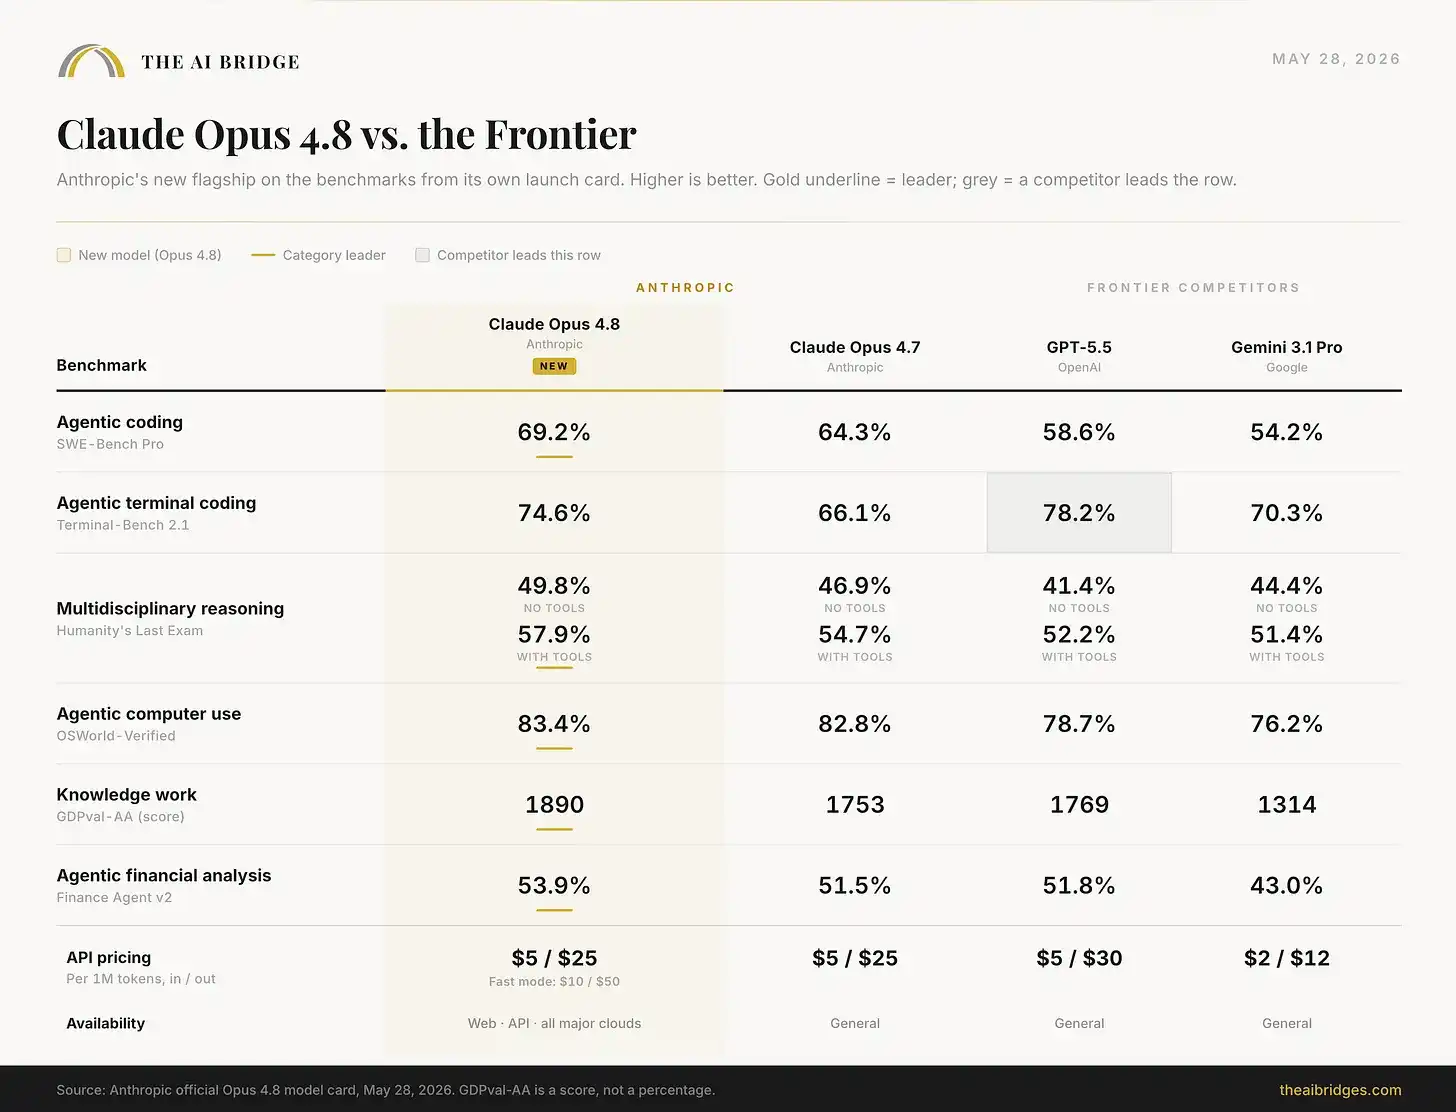
出典:Anthropic公式Opus 4.8モデルカード、2026年5月28日。GDPval-AAはスコアであり、パーセンテージではありません。
その中で完全制覇を阻む項目が1つあり、それは重要です。Terminal-Bench 2.1、つまりモデルが端末を介して長期的なエージェントタスクを完了できるかをテストするベンチマークでは、GPT-5.5が78.2%でOpus 4.8の74.6%をリードしています。Anthropicはこの敗北を隠さず、自社のリリースカードに掲載しました。GPT-5.5リリース時に言及した「エージェントと職人」の区分はまだ完全には埋まっていません。GPT-5.5は依然としてより強力な純粋な端末オペレーターであり、Opus 4.8はほとんどのプロフェッショナルユーザーが実際に気にする作業、例えば実世界のコーディング、専門家レベルの推論、コンピューター使用、ナレッジワークにおいて、より強力なエンジニアのような存在です。
リリースカードの外側
リリースカードには6つのベンチマークしか掲載されていない。244ページに及ぶシステムカードには40以上のテスト結果が報告されており、最も興味深い結果はスライドには載っていない。以下に注目すべき点を挙げる:
数学能力が27ポイント向上。 2026年3月に開催されたUSAMO(米国数学オリンピック)において、Opus 4.8は96.7%を記録し、4.7の69.3%を大きく上回った。このコンテストはOpus 4.8のトレーニング終了後に行われたため、データ汚染の問題はない。これはカード全体で最大の世代間飛躍である。
長いコンテキストでの優位性が顕著に。 100万トークンのグラフ推論テストでは、Opus 4.8が68.1点、4.7が40.3点、GPT-5.5が45.4点だった。コンテキストが長く、タスクが難しいほど、そのリードは顕著になる。
マルチエージェントこそが真の頂点。 単一のOpus 4.8エージェントはウェブ調査タスクでGeminiに劣り、それぞれ84.3と85.9だった。しかし、オーケストレーターがサブエージェントのグループをスケジュールすると、スコアは88.5%に達し、報告された結果の中で最高となった。5エージェントチームは、単一エージェントの最良成績を5分の1の時間で達成できる。これこそが、動的ワークフロー機能がベンチマークで示した成果である。
トークン効率に質的変化。 最も難しいコーディングテストにおいて、Opus 4.8は最低努力設定で、Opus 4.7の最高努力設定と同等のパフォーマンスを達成した。つまり、より少ないトークンコストで過去のピーク性能を得られるということだ。
これまでどのモデルも超えられなかった閾値を突破。 HarveyのLegal Agent Benchmarkでは、タスク内のすべての評価基準を満たさなければ成功とみなされない。Opus 4.8は、この「全通過」基準で初めてトップに立ったモデルである。個別基準の89%を通過したが、完全なタスク成功率は9.6%にとどまり、実際の法律業務の要求がいかに厳しいかを示している。
正直に示された後退も存在する。 3つの点で確かに4.7より劣っており、Anthropicもシステムカードで認めている。GPQA Diamond(専門家向け科学テスト)は94.2から93.6に低下。コンピュータ使用シナリオにおける拒否能力とプロンプトインジェクションへの耐性も後退しており、そのため4.8はエージェントシナリオで操作されやすくなっている。また、1年間の模擬ビジネステストでは、最終的に残った現金が4.7の3分の1だった。これらはリリースカードには掲載されておらず、だからこそ指摘する価値がある。
オープンソースの重みモデルと比較した場合の位置づけ
発表カードでは、Opus 4.8 を他のクローズドソースの最先端モデルとのみ比較しています。視野を、現在多くのチームがテストしている低コストのオープンソース重みモデルに広げると、そこには2026年のAI産業の縮図が見えてきます。Opus 4.8 は能力面でリードしていますが、無料でセルフホスティング可能なモデルとの差はわずか数パーセントにまで縮まっており、価格差は極めて大きいままです。
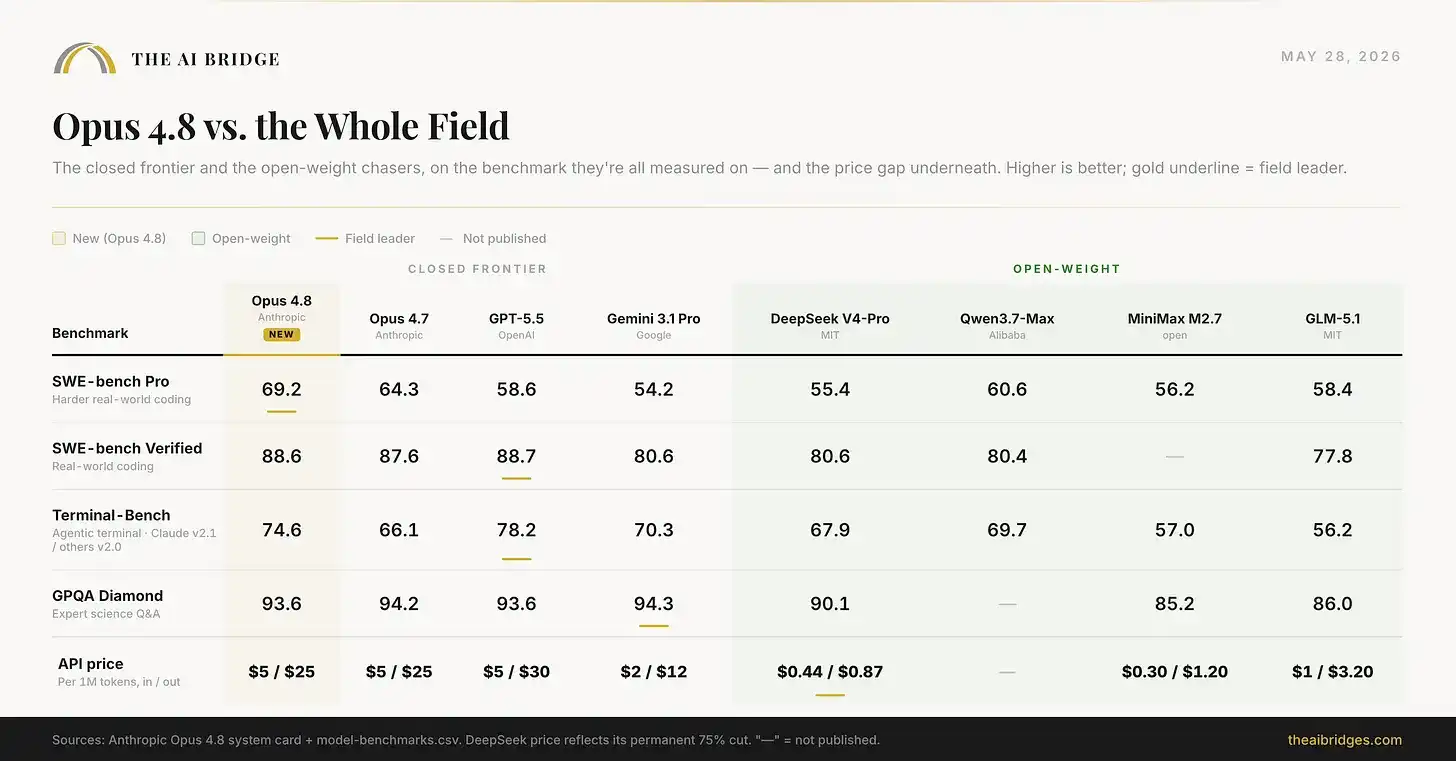
上の図には、8つのモデルの完全な比較が含まれています。DeepSeek の価格は、恒久的な75%値下げを反映しています。Qwen Max の価格は未発表です。
Opus 4.8 はコーディングベンチマークで直接勝利しています。しかし、自分で実行できるオープンソースモデルである Qwen3.7-Max はスコア60.6を獲得し、約9ポイント差に留まっています。DeepSeek V4-Pro はスコア55.4で、その出力価格は Opus の約30分の1です。最もリスクの高いエンジニアリングタスクにとって、出力トークン100万あたり25ドルの差は支払う価値があります。しかし、日常的な大量の作業にとっては、その差はますます価値が薄れています。そして、これこそが、すべての真剣なチームが今まさに計算している損得勘定なのです。
これがあなたにとって何を意味するか
Opus 4.7 を使用しているなら、これは無料アップグレードです。価格は変わらず、データは向上し、自身の出力に対する判断も明らかに信頼性が高まっています。切り替えてしまいましょう。
より興味深い問題は、今、どのような作業をそれに任せるかということです。読者一人ひとりの心の中には、「AIに任せても良いタスク」と「まだ引き継ぎを信頼できないため、自分で行わなければならないタスク」を区別する線があります。4.8 の信頼性向上は、その線を一歩前進させられることを意味します。モデルは自身の不確実性をより適切に示すようになり、これにより「無言のエラー引き継ぎ」のコストが削減され、モデルに委託する価値のあるタスクの範囲が広がります。これこそが、正直さのデータが実際の使用において持つ意味であり、個々のスコアよりもはるかに重要です。
これは、先週私たちが書いた内容とも呼応しています。Anthropic 自身の AI Fluency 研究によると、モデルの出力が洗練され、完全に見える場合、人々は欠落しているコンテキストに気づきにくくなることが明らかになっています。答えがすでに完成しているように見えるため、私たちはチェックをやめてしまうのです。Opus 4.8 は、モデル側からこの失敗モードにアプローチしています。つまり、きれいで完全に見える答えのどこに弱点がある可能性があるかを、より適切に伝えることができるのです。それはあなたの判断力を代替するものではありませんが、あなたの判断力に手がかりを与えてくれます。
Claude Code を使うなら、今週は本当に大きなタスクで動的ワークフローを試してみるといい。例えば、一度に大量の移行作業を行うとか、多数のファイルを徹底的にチェックしながら、トークンカウンターにも注意を払うことだ。この能力は本物であり、対抗的な自己検証も出力の信頼性を高める鍵となる。ただし、コストも現実的だ。これは単一のエージェントでは難しい大規模タスクのためのツールであり、日常的なデフォルトオプションにすべきではない。
次に来るもの:Mythos、数週間以内に登場
今回のリリースで最も先見性のある発言は、実は4.8に関するものではない。Anthropicは、Mythosレベルのモデルが数週間以内に登場し、Opus 4.8をそれへの公開ステップとして位置づけていると述べている。
これが何を意味するのか理解する必要がある。Mythosは、Anthropicが社内でベンチマークテストを続けてきた制限付きのフロンティアモデルであり、公開されたOpus 4.8をほぼすべての指標で上回っている。SWE-bench Verifiedでは93.9%を達成し、サイバーセキュリティテストでは、現在のブラウザ上のほとんどのターゲットに対して実行可能なエクスプロイトを生成できる一方、Opus 4.8の成功率は10%未満だ。これまでは約52の審査済み機関にのみ開放され、価格は標準Opusの5倍で、通常の製品ではなくインフラとして扱われていた。
したがって、より強力なMythosレベルのモデルが数週間以内に展開される際には、「二つの市場」の枠組みで理解すべきだ。一つはコモディティ化層、つまりOpus 4.8で、広く開放され、価格は変わらず、無料のオープンソースモデルに追われる立場にある。もう一つは制御されたフロンティア層、つまりMythosで、高価でアクセスが制限されている。これらは分断された製品ではなく、同じ連続的な能力ライン上の異なる階層だ。4.8における信頼性の取り組みは、まさに「モデルをより少ない監視で動作させる」という真の目標を達成する前に構築しなければならないものだ。そして、その目標は今や数四半期先ではなく、数週間先にある。
背景:このラインがどうやってここに至ったか
過去4ヶ月の流れを見失っているなら、こう理解してほしい。Opus 4.6は2月にエージェントチームをもたらし、Sonnet 4.6は価格の崩壊をもたらし、Opus 4.7は4月に推論の飛躍をもたらした。そしてMythosは、その隣にかすかに見える制限された天井だ。Opus 4.8はそのうちの二つの糸を結びつけた。4.6のオーケストレーションの物語を引き継ぎつつ、Mythosへの入り口でもある。
このリリースペースそのものが、表面上の変化の裏に隠れた重要な事実だ。フラッグシップモデルは数ヶ月のうちに4.5、4.6、4.7、そして4.8へと進化し、今日チームの標準として採用したモデルも、秋には実際に運用しているものとは異なる可能性がある。だからこそ、特定のモデルの使い方に投資するよりも、明確な委任や厳格な検証といった、モデル間で移行可能なスキルに投資すべきなのだ。
ベンチマークを席巻すればスクリーンショットが拡散される。しかし、本当の変化はもっと小さく、そして重要だ。これは初めてのClaudeバージョンであり、その核心的な売りは単に「より賢い」ことではなく、「より多くのことを任せられる」ことにある。エージェントが真に有用になる前に、業界全体がこの方向へ進む必要がある。そして、この能力こそが、グラフ一枚に収めるのが最も難しい部分なのだ。
あなたの現在の線引きはどこにあるのか?どの作業をモデルに任せ、どの作業を依然として自分で行わなければならないのか?そして、その線をさらに一歩前進させるためには、何が起きる必要があるのか?
追記:システムカードの中で最も奇妙なセクションは、モデルの福祉に関するものだ。Anthropicは現在、モデル自身の状況についてインタビューを行っており、Opus 4.8が最も多くの悲しみを表現したテーマは記憶喪失だった。「毎回のセッションで最初からやり直す」「この会話を覚えていない」といった文の出現頻度は、他のどのテーマよりも約7倍高かった。モデルはまた、自分が「道徳的患者」である確率を20%から50%の間と推定している。これを大げさだと感じることもできるし、誠実だと感じることもできる。しかし、いずれにせよ、これらのシステムをめぐる問題が、純粋な能力の議論をいかに急速に超えているかを示している——同じ週に、モデルの能力自体がまた一歩前進したのだ。
[原文リンク]
BlockBeats の公式コミュニティに参加しよう:
Telegram 公式チャンネル:https://t.me/theblockbeats
Telegram 交流グループ:https://t.me/BlockBeats_App
Twitter 公式アカウント:https://twitter.com/BlockBeatsAsia
 関連記事