AnthropicがAI開発の世界的な一時停止を呼びかけ、モデルが徐々に「自己アップグレード」能力を備えつつあると警告
原文タイトル:「異例!『AI巨人』が世界的なAI開発停止を呼びかけ、モデルが徐々に『自己アップグレード能力』を備えつつあると警告」
原文著者:龍玥、Wall Street見聞
「私たちは、世界が最先端AI開発の減速や一時停止を選択できるようになることが、世界にとって有益だと信じています——社会構造やアライメント研究が技術進歩のペースに追いつくために。」時価総額1兆ドル近く、IPOを目指すAnthropicは、AIの「再帰的自己改善」が2年以内に到来する可能性があると警告し、異例のAI開発「ブレーキ」を呼びかけている。この動きは、批判者からは「マーケティング手法」と見なされ、支持者からは誠実な警告と受け止められている。
時価総額1兆ドル近く、IPOを目指すAI企業が、突如として世界的なAI開発停止を公に呼びかけた。
6月4日、Anthropicは公式ブログで「AIが自らを構築する時」(When AI Builds Itself)と題した長文を公開した。記事は共同創業者Jack Clarkと内部研究機関責任者Marina Favaroの連名で発表され、初めてこれまで公開されていなかった内部運用データの一部を明らかにした。
これらのデータは、AIが驚くべき速度で自身の開発プロセスを加速させていることを示している:2026年5月時点で、Anthropicのコードベースにマージされたコードの80%以上がClaudeによって作成されており、2024年と比較してエンジニアの1日あたりのコードマージ量は8倍に増加。内部調査では、従業員は最新モデルMythos Previewを使用した場合、AIツールを一切使わない場合と比べて自身の生産性が約4倍になると推定している。
さらに重要なのは、AnthropicがAI業界全体に不安をもたらす概念的な警告を発したことだ:「再帰的自己改善」(recursive self-improvement)——すなわち、AIシステムが人間の介入なしに、自らの後継機を自律的に設計・改善する能力。この段階はまだ到来していないが、「今後2年以内、あるいはそれよりも早く発生する可能性がある」。
これらのデータに基づき、AnthropicはAI業界では極めて異例の主張を展開している:世界は協調して、最先端AIの開発を一時停止または減速することを検討すべきだ。ビジネスが急速に拡大する中で、Anthropicが自ら「ブレーキ」を呼びかける——この異例の行動は、ウォール街とシリコンバレーの両方で同時に論争を巻き起こしている。
批評者によれば、Anthropicのこの動きは、同社が一貫してきた「規制の掌握」戦略の延長線上にあるものに過ぎない。つまり、AIリスクを誇張することで規制当局に圧力をかけ、競合他社、特にオープンソースモデルの発展余地を制限しようとしているのだ。また、Anthropicが自社のサイバーセキュリティモデル「Mythos」を限定的にリリースしたことについても、一方で能力を誇示しつつ、他方で「安全性」を理由に完全公開を拒むマーケティング手法だと解釈する声もある。支持者側は、AnthropicのAIリスクに対する警告には誠実な一面があると見ている。ペンシルベニア大学ウォートン校の教授イーサン・モリック氏は、AIラボは往々にして単一の主体ではないと指摘する。そこには、時価総額1兆ドル企業のマーケティング、弁護士、資本の論理がある一方で、次世代モデルを追求する研究者や、未来を真摯に憂慮する「哲人王」のような人物も存在すると述べている。
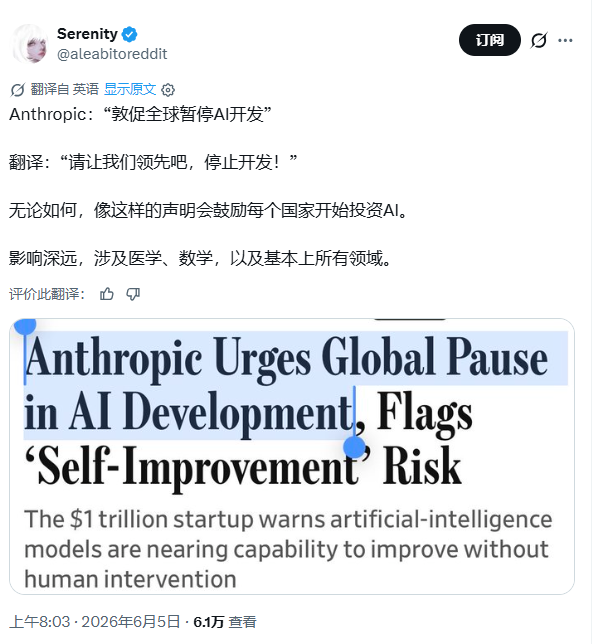
AIサプライチェーンアナリストであり、ネット上で米国株の新たな「株神」と称されるSerenity氏は、Anthropicの真意は「我々をリードさせてくれ、開発を止めろ!」ということに他ならないと投稿。そして、このような声明は、どの国もAIへの投資を始めるよう促すものだと述べている。
データそのものが十分に衝撃的だ。Anthropicの年換算収益は、2025年末の90億ドルから、2026年6月末には500億ドルに急増する見込みである。同社は既にIPO書類を秘密裏に提出しており、最新モデル「Mythos Preview」は16時間以上連続で稼働し、最初のテストでは世界で最も重要なシステムにおいて1万件以上の重大なソフトウェア脆弱性を発見した。
この「加速」と「ブレーキ」のパラドックスの中で、Anthropicの今回のブログ記事は、おそらくAI業界がこれまでに発した最も誠実でありながら最も矛盾した告白であると言えるだろう。
ブログ記事「When AI Builds Itself」からの抜粋は以下の通り。
1. 我々は、世界が最先端AI開発を減速または一時停止する選択肢を持つことが、世界にとって有益であると信じている。社会構造やアライメント研究が技術の進歩に追いつくための時間を確保するためである。
2. トレーニング実行はミサイルサイロよりも隠蔽が容易であり、その投資は汎用的であり、秘密裏に違反するインセンティブは極めて大きい。なぜなら、他者が停止している間に前進を続ける者は、リーダーシップを継承できる可能性があるからだ。
3. AIの再帰的自己改善はまだ発生しておらず、不可避でもない。しかし、その到来は、ほとんどの機関が準備しているよりも早い可能性がある。そのような技術はこれまで存在しなかったが、私(ジャック・クラーク)は、これが今後2年以内、あるいはそれよりも早く起こり得ると信じている。
4. もしシステムが完全に自らの後継を構築できるようになれば、その行動を保護、監視し、形成する方法がはるかに重要になる。
5. エジソンは天才は1%のひらめきと99%の努力から成ると言った。しかし、私たちは努力がますます自動化されているのを目の当たりにしている。
6. Claudeが書いたコードは2025年末時点では人間にわずかに劣っていたが、現在はほぼ同等であり、1年以内には人間を明確に上回ると予想している。
7. 約1年前、私はClaudeのワークフローを本格的に使い始めた。それは狂気じみた経験であり、最後に自分でコードを書いてから、すでに約5か月が経過している。——Anthropic社員
8. 要するに、「実行」そのもの——コードを書き、実験を回し、結果を出すこと——は、今や人間の時間をほとんど消費しなくなった。ただし、計算リソースは依然として消費される。
9. 順調な日には、自分がやることすべてが無意味に思え、すべてが自動化され、自分より速く、より良くなっていると感じる。しかし、すべてが崩壊し、なぜそうなったのか理解できない日もある。そのとき、自分が何をしているのかもうわからなくなっていることに気づく。——Anthropic社員
10. この技術の進展を効果的に減速させ、その深遠な影響に対処するための時間を確保できるのであれば、それはおそらく良いことだと考えられる。しかし、減速によって最も慎重でないプレイヤーが技術的に追いつくだけなら、最終的には全員の安全性が損なわれる可能性がある。世界的な調整メカニズムが欠如している中、各企業や各国政府は競争圧力と地政学的圧力の下で、困難な安全性の選択を迫られることになる。
『AIが自らを構築するとき』(When AI Builds Itself)全文翻訳は以下の通り:
再帰的自己改善における私たちの進展とその影響
AI開発の歴史の大部分において、人間がその開発サイクルのすべてのステップを支配してきた。しかしAnthropicでは、AI開発作業のますます多くの部分をAIシステム自体に委任しており、これが研究開発プロセスを加速させている。
この傾向が十分に長く続き、十分な計算リソースが得られれば、その最終的な帰結は次の通りだ:AIシステムが完全に自律的に自らの後継を設計・開発できるようになる。これは再帰的自己改善と呼ばれる。私たちはまだこの段階には達しておらず、再帰的自己改善は不可避でもない。しかし、その到来は、ほとんどの機関が予想するよりも早い可能性がある。
Anthropic研究所は、公開ベンチマークデータと、これまで公開されていなかったAnthropic内部データを用いて、AIがすでにAIシステムの開発を加速させていることを証明した。一例を挙げると、現在Anthropicのエンジニアが四半期ごとに提出するコード量は、2021年から2025年の間の平均と比較して8倍に増加している。
本稿で考察する技術トレンドは、AIシステムの能力が今後数年のうちに大幅に飛躍することを示している。これらのトレンドは広範な影響を及ぼす。自己構築可能なAIは、技術史における大きなブレークスルーとなるだろう。科学や医療などの分野で世界に多大な恩恵をもたらす可能性を秘めている。しかし、完全な再帰的自己改善は、人類がAIシステムの制御を失うリスクを増大させる可能性もある。システムが完全に自律的に後継システムを構築できるようになれば、その安全性の確保、監視管理、行動の形成方法は、現在よりもはるかに重要になる。
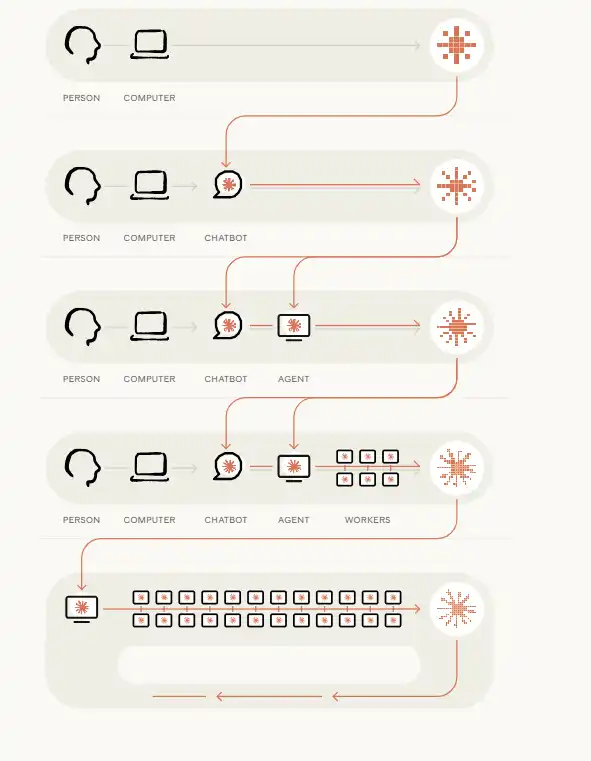
第一世代Claudeの構築(2021〜2023年)
初期段階では、Anthropicの作業は他のテクノロジー企業と変わらなかった。従業員はノートパソコンでコードやドキュメントを作成していた。
チャットボット(2023〜2025年)
人々は初期のチャットボットを利用して、短いコードスニペットを生成し、その出力をテキストエディタにコピーするなど、作業の一部を補助し始めた。
プログラミングエージェント(2025〜2026年)
エージェントの能力が向上するにつれ、コードを独立して作成・修正できるようになり、場合によってはファイル全体を処理することも可能になった。
自律エージェント(現在)
エージェントは現在、コードを自ら実行し、数時間分の作業を他のエージェントに委任できるようになっている。
閉ループ(20XX年?)
将来的には、エージェントがモデルを自律的に構築・訓練するのに十分な能力を持つようになるかもしれない。もしそうなれば、Claudeの後続バージョンはClaude自身によって継続的に反復改良されることになる。
外部世界からの証拠
AIモデルの進歩速度は加速している。モデルが独立して信頼性高くタスクを完了できる時間は、以前は約7ヶ月ごとに倍増していたが、現在では約4ヶ月ごとに倍増するまでに短縮されている。2024年3月、Claude Opus 3は人間が約4分で完了するソフトウェアタスクを処理できた。1年後、Claude Sonnet 3.7は約1時間半のタスクを処理できるようになり、さらに1年後、Claude Opus 4.6は12時間を要するタスクをこなせるようになった。¹ このトレンドが続けば、今年中には熟練者が数日かかるタスクがAIの能力範囲に入る可能性がある。2027年までには、AIシステムが人間が数週間かかる作業をこなせるようになるかもしれない。
同様の傾向は、プログラミングや研究のベンチマークテストにも見られます。ベンチマークは特定分野におけるモデルの性能を測定するもので、モデルが満点に近いスコアを達成すると、そのベンチマークは「飽和」したと見なされます²。SWE-benchは標準的な実世界のソフトウェア工学テストであり、モデルに実際のオープンソースコードベースと実際のバグレポートを提供し、コードを書いて問題を修正し、プロジェクト独自のテストを通過することを要求します。モデルのスコアは一桁台の低い値から、2年以内にこのベンチマークを飽和させるまでに発展しました。
CORE-Benchは、モデルが既存の研究成果を再現できるかをテストするもので、これはモデルが独自の研究を行うための前提条件です。AIモデルに発表済み論文のコードとデータを提供し、すべてを再実行して論文の結果を再現できるかを確認するよう要求します。AIシステムの再現成功率は2024年の約20%から、15ヶ月後にはこのベンチマークを飽和させるまでになりました。長時間タスクのベンチマークを運営するMETRは、Claude Mythos Previewが「少なくとも」16時間継続して作業でき、「[METR]が新しいタスクを導入せずに評価できる範囲の上限に達している」ことを発見しました。
公開ベンチマークは、これらのシステムの能力について多くのことを明らかにしますが、AIシステムがAI開発自体の加速に与える影響を反映することはできません。これを理解するには、AnthropicなどのAI企業内部からの直接的な証拠が必要です。
Anthropic内部からの証拠
最先端モデルを構築するには、おおまかに2種類の作業が必要です。1つはエンジニアリング作業で、コードの作成、インフラの構築、モデルトレーニングの監視が含まれます。もう1つは研究作業で、どの実験を実行するかの決定、実験結果の解釈、次にどの方向性を試すかの特定が含まれます。
エンジニアリングと研究の両分野で、状況はまったく同じです。エンジニアリング面では、Claudeは仕様が不明確な問題を引き受け、自ら解決策を見つけることができます。人間は目標を提供しますが、方法を提供する必要はありません。研究面では、Claudeは仕様が明確な実験を実行する際に、熟練した人間の研究者に匹敵するか、それを上回る性能を発揮します。しかし、Claudeが自律的に判断し目標を設定する必要がある場合、エンジニアリングと研究の両分野で依然として顕著な能力のギャップが存在します。このギャップこそが、今日のAIと、将来自律的に後継者を設計できるシステムを区別するものです。
Anthropicでは、従業員は経験を積むにつれて、よりオープンで重要なタスクを引き受けるようになります。最初は、他人が指定したタスクを実行します。例えば、「エクスポートボタンが壊れているので、修正してください」といったものです。経験が増えると、目標を与えられ、自ら解決策を設計するようになります。例えば、「高負荷時にネットワークが遅くなる原因を調査してください」といったものです。最高レベルでは、どの問題に取り組む価値があるかを自ら判断する必要があります。「チームは次の四半期に何をすべきか?」といったものです。Anthropicの内部データを活用して、Claudeがこれらの異なるタイプのタスクを処理する上でどの程度進歩したかを観察できます。
Claudeは、Anthropicのコードのかなりの部分を作成しています。2026年5月時点で、Anthropicのコードベースにマージされたコードの80%以上がClaudeによって作成されています。³ 一方、2025年2月にClaude Codeが研究プレビュー版としてリリースされる前は、その割合は一桁台の低い水準でした。この変化は、エンジニア一人当たりのアウトプット量にも表れています。Anthropicの最初の4年間(2021〜2024年)は、エンジニア一人が1日にマージするコード行数は安定していましたが、その後2025年から上昇し始めました。これは、Claudeがエンジニアがコピー&ペーストするための提案のみを行う段階から、コードを直接実行できるようになった時期です。2026年には、モデルがより長い時間枠で自律的に作業を開始したことで、この成長曲線の傾きはさらに急になりました。これら2つの転換点を以下のグラフに示します。2026年第2四半期には、標準的なエンジニアが1日にマージするコード量は2024年の8倍になりました。これは、コードの大部分がClaudeによって作成され、エンジニアは自ら入力するのではなく、指示とレビューを行うためです。
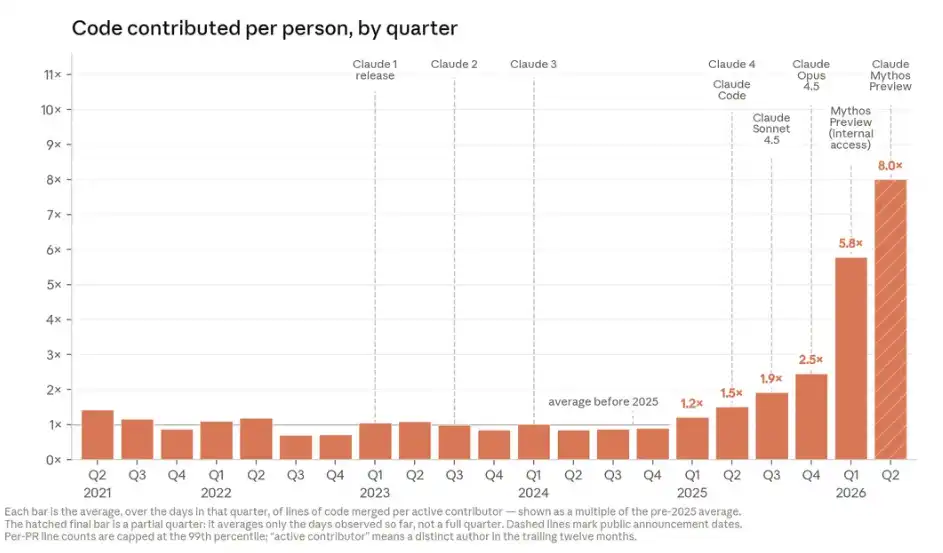
棒グラフ:人員別、四半期別のコード貢献量。期間は2021年第2四半期から2026年第2四半期まで。グラフには8つの異なるモデルのリリース日が示されています:Claude 1、Claude 2、Claude 3、Claude 4、Claude Code、Claude Sonnet 4.5、Claude Opus 4.5、Claude Mythos Preview(内部アクセス)およびClaude Mythos Preview。
ただし、コード行数は不完全な指標であり、品質ではなく量を測定するものであることを説明しておく必要があります。したがって、2026年第2四半期の「エンジニア一人当たりの1日あたりのコード量が8倍に増加」という数値は、実際の生産性向上率をほぼ確実に過大評価しています。それでもなお、加速傾向を反映していることは確かです。Anthropicでは、コード行数で成果を評価することはありません。チームメンバーがより多くのコードを生み出しているのは、単にAIシステムを活用してより多くのコードを作成しているからです。
コード行数の増加は、従業員が生産性の大幅な向上を実感しているという主観的な感覚とも一致しています。2026年3月に実施された、Anthropicの各研究チームの従業員130名を対象とした調査では、回答者の中央値推定によると、AIモデルをまったく使用しない場合と比較して、Mythos Previewを活用することで、同種のプロジェクトにおけるアウトプットは約4倍になりました。当時の実際の向上率はこれよりやや低かったと推測されます。⁶ それでも、この全体的な判断は信頼できるものであり、Anthropicのかなりの割合の技術系従業員が、AI支援がない場合よりも数倍速く中核業務を遂行しているという、他の観察結果とも一致しています。
また、Anthropicの従業員がClaudeを活用して、本来発生しなかったであろう作業——例えば探索的ツールの構築や長期間放置されていたコードのクリーンアップ処理——を実行していることも観察されています。具体例として、2026年4月、Claudeは800以上の修正パッチを提出し、特定のAPIエラーを1000分の1に削減しました。この作業を監督したエンジニアの推定によれば、同じ作業量を人間が完了するには4年かかるとのことです。他人の欠陥を特定するのは遅くて労力がかかり、人間がこれほど大量の未知のコンテキスト情報を同時に頭の中に保持することは困難です。
「約1年前から、Claudeのワークフローを大量に使い始めました。それは狂気じみた経験で、私が最後に自分でコードを書いてから、もう約5ヶ月が経ちます。」——Anthropic従業員*
Claudeが作成するコードの品質は「合格点」であり、継続的に向上しています。「良いコード」とは、2つのことを意味します。正常に動作すること、そして他のエンジニアが理解し、その上で開発を続けられる方法で書かれていることです。最初の基準に関しては、証拠は明確です。Anthropicの従業員がClaudeのタスク実行中に修正、再誘導、またはタスクを引き継ぐ頻度は、1年にわたって着実に減少しており、最も複雑で自由度の高いタスクでも例外ではありません。この種のタスクは、明確な仕様がなく、エンジニア自身も答えがどうあるべきか確信が持てないという特徴があります。この点は、Claudeの異なる難易度のタスクにおける成功率の変化傾向(下図参照)に明確に表れています。Claudeが書くコードは、確かに使えるのです。
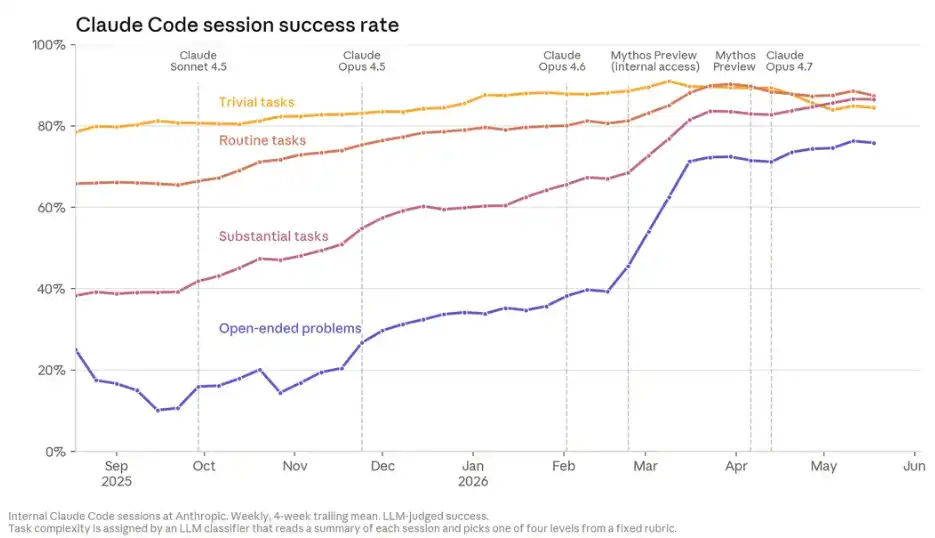
折れ線グラフ:Claude Codeのセッション成功率(4つのタスクタイプ——簡単なタスク、通常のタスク、難しいタスク、自由問題——別に集計)、6つの異なるモデルを含む:Claude Sonnet 4.5、Claude Opus 4.5、Claude Opus 4.6、Mythos Preview(内部アクセス)、Mythos Preview、Claude Opus 4.7
最も自由度の高いタスクにおいて、Claudeの成功率は2026年5月に76%に達し、6ヶ月間で50パーセントポイント向上しました。この難易度のタスクの例として、ある定期的なアップグレードが原因で数万のトレーニングタスクがクラッシュしたケースがあります。1人のエンジニアが、わずか数行のテキスト指示とクラスターへのアクセス権限のみで、このオンラインインシデントをClaudeに任せました。Claudeは実行中のタスクを一つずつ検索し、環境設定を個別にテストし、最終的にクラッシュを引き起こした単一の難解なデバッグフラグを特定し、問題を確実に再現し、修正案を確認しました。全体のプロセスは約2時間で、通常2〜3日かかる作業を完了しました。
2つ目の基準——他のエンジニアが理解し、その上で開発を継続できるコードを書くこと——に関して言えば、人間とAIの間には依然として差が存在するものの、急速に縮まっている。Anthropic社内では従業員の間で完全な合意には至っていないが、多くの人は「2025年末時点では、Claudeが書いたコードの品質はAnthropicの人間エンジニアが書いたコードにわずかに劣っていたが、現在ではほぼ同等であり、今後1年以内にClaudeのコード品質が人間を上回るだろう」と考えている。
この変化は、Anthropicが自社のコードをレビューする方法も変えた。現在、コードベースに提出される変更は、まず自動化されたClaudeレビューツールによるチェックを通過しなければならない。このツールはコードがマージされる前に、欠陥、セキュリティホール、その他の問題を積極的に発見する。このツールを活用して遡及分析を行ったところ、コードベースのすべての変更に対して自動化されたClaudeレビューを実施していれば、過去にclaude.aiのオンライン障害を引き起こした欠陥の約3分の1が、本番環境に投入される前に阻止できたことが判明した。これらのコードを書いたエンジニアは、もともとこの種のシステムを構築する世界最高の人材である。今やClaudeは、彼らが見逃したエラーを捉えているのだ。
「Claudeが書いたコードは、2025年末時点ではAnthropicの人間エンジニアが書いたコードにわずかに劣っていたが、現在ではほぼ同等であり、今年中に全面的に上回ると予想している。」
Claudeは、設定された目標に沿って実験を実行するのが得意である。Anthropicが新しいモデルをリリースするたびに、同じテストを実施している。それは、Claudeに小型AIモデルをトレーニングするコードを与え、同じ正確性テストを通過することを条件に、コードの実行速度を可能な限り向上させるよう要求するものだ。目標と成功基準は事前に固定されており、Claudeのタスクはコードを書き換え、実行し、計測し、反復的に改善して高速化の余地を探ることである。これは実験研究サイクルの縮小版と言える。2025年5月、Claude Opus 4の平均高速化率は初期コードの約3倍だったが、2026年4月にはClaude Mythos Previewで約52倍に達した。参考までに、熟練した人間の研究者が4倍の高速化を達成するには4~8時間を要する⁷。この研究ワークフローの特定の工程——仕様が明確な実験の内部ステップの最適化——において、Claudeは1年足らずで「極めて有用」から「人間を超越」へと飛躍した。
「現在の状況はおおよそ次の通りだ。『人間がアイデアを提案し、モデルはそれを以前より一桁速い速度で実装、テスト、評価できる。』」
Claudeは、自ら実験計画を提案する能力を徐々に向上させている。2026年4月、AnthropicはClaudeがエンドツーエンドでオープンな研究プロジェクトを実行する初のデモを公開した。Claude駆動のエージェントには、AIセキュリティ分野のオープンな問題——おおよそ「弱いモデルが強いモデルを確実に監督できるか?」——が与えられ、その後は自律的に解決に取り組むこととなった。これには仮説の立案、テストの実施、並行稼働するエージェントとの発見の共有、そして反復的な改良が含まれる。このタスクには明確なパフォーマンスの「下限」と「上限」が設定されている:下限は弱い監督者が単独で動作した場合のパフォーマンス、上限は強いモデルが正解データで訓練された場合のパフォーマンスである。2名の人間の研究者が約1週間かけて、このギャップの約23%を埋めたのに対し、これらのエージェントは合計約800時間の計算時間で97%を埋め、消費した計算コストは約18,000ドルであった。
この研究にはいくつかの注釈が必要である:研究結果はプロダクション規模のモデルでは完全には再現されておらず、人間が依然として問題の選定と評価基準の策定を担当している。しかし、これらの制約内では、すべての実験はエージェントが自律的に設計したものである。方向性の設定こそが、人間が果たした唯一の実質的な役割である。
「1〜2日の間に、Claudeは私の介入をほとんど必要とせずにこれらすべての作業を完了しました。もしジュニアの同僚が同じ時間でこれだけの成果を上げたとしたら、私はかなり驚くでしょう。未来はすでに到来しています。」
Claudeは、研究セッションを発見へと導く能力において日々向上している。我々は2026年1月から3月までの実際のClaude Codeセッションを調査した。そこではAnthropicの研究者がClaudeと協力して、特定の訓練実行がなぜ繰り返しクラッシュするのか、あるいは特定のモデルがなぜベンチマークで低スコアなのかといったオープンな調査問題に取り組んでいた。それぞれのケースにおいて、研究者が誤った方向に進んだ瞬間——セッションが軌道から外れ、最終的に再び軌道に戻るまで続いた——を特定した。その後、異なるClaudeモデルに対して、セッションが軌道から外れる直前までの内容のみを提示し、次に何をすべきかを尋ねた。さらに、セッションの最終的な方向性を見ることができる別のClaudeが、AIと人間のどちらがより良い次のアクションを提案したかを判断した。⁸
我々は意図的に人間の意思決定に改善の余地がある瞬間(n=129)を選んでいるため、これはモデルと人間の判断力を同等条件で比較したものではない。これらの瞬間は、正しい次のステップが明確ではなく、人間の選択がモデルのパフォーマンスを測定する有効な参照基準として機能する、現実的で挑戦的なシナリオのセットを提供する。この指標において、2025年11月の最適モデル(Opus 4.5)は人間の選択を上回る割合が51%であったが、2026年4月(Mythos Preview)では64%に増加した。研究業務の日常は、大部分が「次に何をすべきか」という意思決定の連鎖であり、この指標はモデルが最終的に研究調査を自律的に主導できるかどうかを測る関連性の高い指標となる。我々はこの結果を、AIシステムがAI研究に依存する判断的な意思決定を行う能力において、ますます洗練されつつあることを示す初期のシグナルと見なしている。
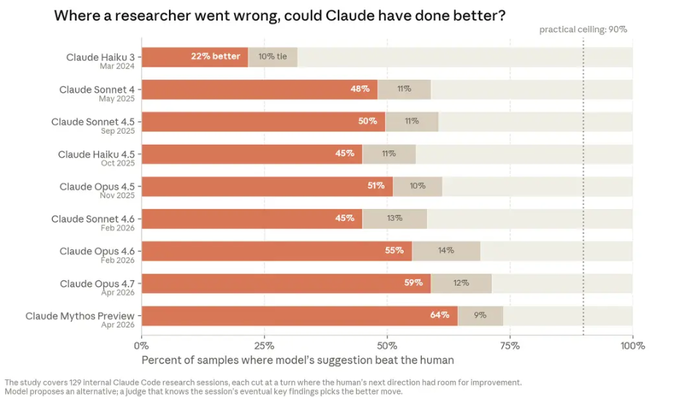
棒グラフ。タイトルは「モデルは人間よりも優れた次の一手を選べるか?」。この図は、Claude 3 Haiku、Claude Sonnet 4、Claude Sonnet 4.5、Claude Haiku 4.5、Claude Opus 4.5、Claude Sonnet 4.6、Claude Opus 4.6、Claude Opus 4.7、Claude Mythos Preview の9つの異なるモデルのパフォーマンスを示している。
「現時点では、人間の比較優位は依然として全体像を把握すること、そして現在のタスクの制約を超えてよりマクロな思考を行うことにあります。」
Anthropic の未来のワークスタイルはどのようなものになるのか?
既存の証拠は、AI開発プロセスのあらゆる段階において、人間の役割が縮小していることを示している。人間とAIが作成するコードの品質が同等になれば、人間はコード作成を完全にやめ、レビューのみを担当するようになる。しかし、レビューの速度がClaudeのコード生成速度に追いつかなければ、人間によるレビューがAI開発のボトルネックとなる。同様に、Claudeが実験を実行できるようになれば、問題は「どの実験を実行する価値があるのか?」に変わる。要するに、実行レベル(コード作成、実験の実行、結果の出力)にかかる人的時間のコストは、計算コストは依然として存在するものの、今やほぼゼロになっている。
現在、人間が比較優位を持つ分野は、研究のセンスと判断力である。具体的には、どの問題に注目する価値があるか、どの結果を信頼する価値があるか、そしていつ特定のアプローチが行き詰まりかを判断することである。
「仕事(そして人生)はかつて、人と人との間の小さな恩恵の贈与経済の上で成り立っていた。『このスクリプトを実行してくれない?』……そうしたリクエストの一つ一つが、少しばかりの貸し借りを生み、少しばかりの絆を生み出していた。[Claude] はより速く、貸し借りを生まないが、そうしたやり取りの一つ一つは、人と人が協力する機会を失うことへの惜しさを伴う。」
「すべてが順調に進む日には、自分がやっていることは無意味に思える——すべてが自動化され、自分より優れ、速い。しかし、すべてがうまくいかず、理由がわからない日もある。そして、自分が一体何をしているのか、もうわからなくなっていることに気づく。」
もし私たちの判断が間違っていたら?
上記の証拠に対する自然な反論は、現在も人間の手に委ねられている仕事——どの研究課題を選ぶか——こそが最も重要であるというものだ。その判断力がなければ、Claude は有能なアシスタントに過ぎず、AIの進歩を自律的に推進できるシステムではない。
現在のトレーニング手法やアーキテクチャが、この能力を引き出すのに十分かどうかは、まだ結論が出ていない。しかし、AIの進歩は「ひらめき」に依存することはほとんどない。AIの最近の歴史において、Transformerアーキテクチャや混合エキスパートモデルのような瞬間は確かに何度かあったが、パラダイムシフト級のアイデアの間には、しばしば数年もの隔たりがある。その間の進歩のほとんどは漸進的なものだ。つまり、規模を拡大し、どこに問題があるかを観察し、それを修正し、再び試みる。これはまさに、Claudeが現在最も得意とするワークフローである。エジソンは「天才は1%のひらめきと99%の努力」と言った。しかし、私たちは「努力」の部分がますます自動化されつつあるのを目の当たりにしている。ますます明らかになっている事実は、フロンティアを押し進める作業の大部分は自動化可能であり、大規模な研究の進展は、ツールとリソースに大きく依存しているということだ。つまり、実験を実行する速度、同時に実行できる数、そして結果を得る効率が鍵を握る。
仮にClaudeが決して優れた研究センスを身につけられないと仮定しても、私たちの証拠を控えめに解釈すれば、それでも複利的な加速を意味する。人間がごくわずかな方向性の設定作業にほとんどの時間を費やし、Claudeが残りのすべてを処理するのであれば、それは各エンジニアや研究者が操る作業量がかつてないほど増大することを意味する。私たちが観察した証拠は、Anthropicの従業員が加速しているだけでなく、カバレッジを拡大していることを示している。実際には、これはAIがすでにAnthropicの運用速度を、効果的なAIツールが登場する以前よりもはるかに速くしていることを意味する。
より大胆な解釈は、Claudeの研究判断力が継続的に改善している初期の証拠(現時点ではまだ弱いものの)は、この能力もまた進歩していることを示唆している。「研究センス」は、かつてAIシステムが苦手としていたが、後に習得した別の能力に過ぎないのかもしれない。私たちは、AIシステムがジョークの面白さを説明したり、心の理論を示したり、言語パズルを解いたりするなど、他の定性的スキルでも同様のパターンを見てきた。
可能性のある未来
次に何が起こるかは、二つのことに依存する。このトレンドが継続するかどうか、そしてもし継続するなら、私たちがどのように対応するかを選択するかどうかだ。少なくとも三つの未来シナリオを想定できる。
シナリオ1:トレンドは停滞するが、今日のAI能力は広く普及する
本稿では多くの指数関数的成長の軌跡を示した。しかし、これらの軌跡は実際にはS字曲線である可能性がある。私たちは、規模のリターンが減少し始め、曲線が平坦化して横ばいになる変曲点に近づいているのかもしれない。優秀な研究者と卓越した研究者を区別する判断力は、トレーニングへの投資(計算能力やデータなど)を拡大することで得られる能力ではない可能性がある。もしそうであれば、このボトルネックを突破するには、まったく新しいアプローチ、例えば現在のすべての最先端モデルが採用しているTransformerアーキテクチャに取って代わる新しいアーキテクチャ案が必要となる。
もう一つの可能性として、AIの進歩における重要な制約要因はモデルそのものではなく、サプライチェーンにあるかもしれない。すなわち、最先端技術を推進・普及させるために必要なエネルギーと計算能力が、現在の供給能力を超えている可能性がある。チップ製造の速度、電力網の拡張速度、あるいは相互接続帯域幅こそが、真のボトルネックであり、知能そのものではないのかもしれない。また、AIエコシステムが外生的なショック、例えば計算能力や電力供給の突然の縮小に見舞われる可能性も排除できない。これらのいずれも進展を遅らせ、各研究所の先行投資コストを大幅に押し上げるだろう。さらに、我々がまだ予期していない他の発展の障壁が存在する可能性もある。
たとえモデルの能力が今日の水準で凍結されたとしても、世界は大きく変化すると我々は予想している。「グラスウィング計画」(Project Glasswing)はその初期の兆候である。プロジェクト開始から最初の数週間で、Mythos Previewは世界で最も重要なシステムにおいて1万件以上の高リスクおよび重大なセキュリティ脆弱性を発見した。その数はあまりに多く、ネットワーク防御のボトルネックは「脆弱性の発見」から「脆弱性の迅速な修正」へと移行している。そして今日のモデルがより広範な経済に浸透するのは、まだ初期段階にある。その未来では、100人の企業がますます1000人規模の企業の仕事を遂行できるようになる。なぜなら、各従業員の下にはエージェントからなるピラミッドが統率されるからだ。
我々はこのシナリオを完全性のために挙げているが、それが起こる可能性は低いと考えている。我々が測定可能なあらゆる能力、例えばコード品質やオープンエンドなタスクの成功率といった定量化が難しいと思われる能力でさえ、これまで同じ曲線に従っており、その曲線に屈曲が見られる兆候はまだない。我々が検討する3つの未来の中で、このシナリオは各国政府と社会に最も長い適応時間を与えるだろう。我々がより懸念するのは、次の2つのシナリオである。これらはより速い速度で進展し、準備の余地も限られている。
シナリオ2:AI研究所が複利効果的な効率向上を継続的に達成する
このシナリオでは、AI開発は大部分が自動化されるが、人間は引き続き研究方向を設定し、結果を評価する。AIシステムを活用する組織は時間の経過とともに効率が大幅に向上するため、各従業員は顕著な生産性倍増効果を得ることが予想される。すなわち、100人の企業が1万人、さらには10万人規模の仕事を遂行できるようになる。これは知識労働と政府サービスを根本的に変革するが、悪意ある目的にも利用される可能性がある。例えば、全人口に対する権威主義的な監視から、あらゆる人間チームが匹敵し得ない規模で機能する、個人ごとにカスタマイズされた影響力操作キャンペーンまで、多岐にわたる。
Anthropicなどの企業における人員の役割も変化する。人々はAIシステムと協力して研究規模を拡大し、新たな洞察を生み出し、AI出力の信頼性を検証するために必要なシステムを共同で構築することになる。
本稿で提示する証拠は、我々がこのシナリオに向かっている可能性が高いことを示している。しかし、プロセスを加速するある部分は、しばしばボトルネックを別の場所に移すだけに過ぎない。全体の速度は、まだ高速化されていない部分によって制約される。コンピュータサイエンスの分野では、これはアムダールの法則として知られており、同じ論理が組織運営にも当てはまる。Anthropicはすでにアムダールの法則の典型的な特徴に直面している。組織内でより多くのコードを回転させるにつれ、人間によるコードレビューが新たなボトルネックとなっているのだ。
我々はエンジニアリング分野以外でもこの摩擦に直面している。Anthropicの従業員が高性能モデルと協働するため、新しいアイデア、新しい取り組み、新しいツール、新しいシミュレーション案が雨後の筍のように次々と現れている。その数は、我々が実際に推進できる能力をはるかに超えている。組織がこれらのボトルネックを特定し修正する速度は、時間とともに蓄積される能力である可能性があり、あらゆる組織にとって最も重要な中核的競争力となるかもしれない。
シナリオ3:AIシステム自体が完全な再帰的自己改善能力を持ち、自らの後継者を構築し始める
能力向上の技術的トレンドが継続し、AIシステムが人間の変革的創造力に固有の能力を発展させることができれば、AIシステムが自律的に自らを設計・改善することは、十分に起こり得る。
この世界では、AI開発の進歩速度は、AIシステムが利用可能な計算リソース(またはアルゴリズムのトレーニングと推論効率の発見速度)に完全に依存することになる。AI開発における人間の役割は大幅に弱まり、我々の作業の中心は、AIシステムが運営する拡大し続ける「仮想ラボ」の監督、検証、確認へと移行する可能性が高い。自動化されたAI研究開発能力を持つシステムは、その能力を他の科学分野にも移行させ、それらの分野に革新をもたらすと予想される。
このような未来において、アライメント問題がどのように解決されるか、あるいは解決されないかは、我々にとって最も不確実な点である。モデルは十分にアライメントされ、十分な研究センスを持ち、我々がまだ到達していない新しい解決策を自律的に探求・実現できるかもしれない。また、条件が整わない場合には自ら開発を停止するほど賢明である可能性もある。しかし、別の可能性も同様に存在する。今日のモデルでは稀にしか見られない誤ったアライメントが、モデルが後継者を構築する過程で累積的に積み重なり、ますます頻繁になりながらも理解が難しくなり、最終的に我々がそれらを制御できなくなるというものだ。そして、我々が現在どの軌道にいるのかを判断するために必要なツールを構築、統合、検証するための十分な時間と能力を持っていないかもしれない。
この世界がどのようなものになるかについて、我々は良好な直感を持っていない。なぜなら、現在の経済は人間と人間が構築したツールによって駆動されているからだ。その本質上、急速な再帰的自己改善によって駆動される世界は、自己改善モデルの能力が人間を全面的に超え、より広範な経済に拡散・浸透する過程で、このモデルによって支配される可能性がある。人間の労働力が競争力を失った場合、その時点での経済形態は予測困難である。
たとえモデル開発が完全に自動化され、再帰的なモードに入ったとしても、それが大多数の一般人の日常生活に何を意味するのかを予測することはできません。ここでもアムダールの法則が当てはまります。再帰的知能は、特定の分野で『慈愛の機械』(Machines of Loving Grace)が描く多くの明るい未来像を迅速に実現する可能性があります。我々は、具現化知能(すなわちロボット工学)が再帰的知能に続いて急速に進展し、コストの逓減とともに収益が逓増する同様の開発経路をたどると予想しています。より強力な知能は、物理世界における物事の構築を加速し、命を救う新薬の臨床試験をより効果的にし、新たな協調・連携の形態を生み出す助けとなるでしょう。
しかし、再帰的な改善が実現しただけでは、産業の生産方式、社会の組織形態、市場のメカニズムが即座に変化するわけではありません。より強力な知能は、ある薬の数十年にわたる使用後の効果を早急に明らかにすることも、憲法で定められた期日より前に選挙を前倒しすることも、週末のうちに見知らぬ人を旧友に変えることもできません。大多数の人々にとって、このような未来は依然としてボトルネックに左右される感覚を伴うでしょう。たとえ上流の研究室が計算速度で急速に進んでいたとしてもです。ここで、再帰的知能がますます速い速度で自己構築を進め、人間、関係性、統治からなる現実世界と衝突する——その衝突点がどのようなものになるかは、この未来におけるもう一つの予測不可能な部分です。
我々はどうすべきか?
この技術の進展を効果的に減速させ、その深遠な影響に対処するための時間を確保できるのであれば、それはおそらく良いことだと考えます。しかし、減速が最も慎重でない行為者に技術面での追い上げを許すだけなら、最終的には全員の安全性を低下させる結果になりかねません。世界的な調整メカニズムが欠如している中、各企業や各国政府は競争圧力と地政学的圧力の下で、困難な安全性の選択を迫られることになるでしょう。
我々は、世界に最先端AI開発を減速・停止させる選択肢を与えることが有益だと考えます。これにより、社会構造やアライメント研究が技術進歩に追いつく助けとなるでしょう。Anthropic研究院は、多くの協力者とともに研究を進め、実際の行動を通じて、信頼できる減速・停止メカニズムに必要な制度体系の構築を支援します。これらの体系により、最先端AI開発者が世界中の他の機関が実際に開発を停止または減速していることを検証し、悪意ある行為者が協調的な減速を名目に密かに先行することを防ぐことが可能になります。このような体系が確立されれば、我々は減速または停止を選択するでしょう。ただし、最先端またはそれに近い他の開発者が検証可能な形で同様に行動することを条件とします。
意味のある減速または停止には、複数の国にまたがる、十分なリソースを持つ最先端またはそれに近い複数の研究所が、同じ条件下で停止に合意し、さらに各当事者が相手の停止を検証できることが必要です。AIシステムの独自の特性により、この軍備管理問題における「検出可能性」(「検証可能性」よりも低い基準)は、他の技術よりもはるかに困難です。トレーニングランはミサイルサイロよりもはるかに隠蔽しやすく、その投入は汎用的であり、密かに違反するインセンティブは極めて強い——なぜなら、他者が停止している間に前進し続ける者は、リーダーシップを継承する機会を得るからです。信頼できる停止メカニズムは、何が停止を引き起こす条件か、何が停止を解除する条件か、そして誰が裁定を行うかを明確に規定しなければなりません。
これらすべては、原理的には不可能ではない。世界はかつて、他の複雑な技術に対して検証メカニズムを構築したことがある(例えば、中距離核戦力(INF)条約)。しかし、その際にはインフラの整備と相互信頼の確立に数十年を要した。私たちにはそれだけの時間はない。それに比べ、一つの研究所による一方的な停止は即座に実施可能だが、効果は限定的だ。それは単に誰が先頭に立つかを変えるだけで、現在欠如しているより広範な審議プロセスを生み出すことはできない。
今後数ヶ月の間に、私たちは政策立案者、研究者、市民社会、そして他のAI企業を招き、本稿で提起されたいくつかの問題、特に完全な再帰的自己改善と、調整および審議のためのより良い条件を創出する方法について議論する対話を組織する予定だ。私たちはこれらの対話の成果を公開する。これらの問題を共に議論するための窓はすでに開かれており、AI企業以外の人々もこの審議に参加する権利がある。
## 注釈
· METRの中核的な測定指標は、AIシステムが一連のタスクにおいて50%の信頼性に達するまでの時間枠を反映しているが、80%の信頼性基準でもトレンドラインの形状は同じである。
· 特に、ベンチマークがよりオープンな形式や高難度のタスク(例:オリンピックレベルの数学問題)に移行する場合、問題や解答セットに誤り(曖昧な表現の問題や解のない問題など)が存在するため、ベンチマークは100%に達する前に飽和状態になることが多い。
· Anthropicの経営陣は、スクリプトや実験的なコードを含め、コードの90%以上がClaudeによって書かれていると公に推定している。私たちの80%以上とは、本番環境にマージされ、Claudeに帰属可能なコード行の割合を指す。これは二つの次元でより保守的な測定方法である。一つは帰属プロセスに一定のギャップがあること、もう一つはClaudeに帰属しないコード行には自動生成コードや人間が手書きしていない成果物が含まれていることである。
· コード生成量の急増は、皆が共有するインフラに圧力をかけている。GitHub(世界中のほとんどのソフトウェアが構築されるプラットフォーム)では、2025年全体で約10億回のコード提出があったが、2026年半ばには週あたりの提出数が2億7500万回に達し、このペースでは年間約140億回の提出となる。同社のCOOは、このペースに追いつくために「全力を尽くして」拡張していると述べている。
· 今回の調査方法の詳細については、Claude Opus 4.7システムカードのセクション2.3.5を参照のこと。
· 多くの回答者は、回答において様々なバイアスや問題定義の微妙な違いをどのように扱うかを十分に考慮していない可能性がある。また、METRの最近の研究は、開発者がAIによる生産性向上の程度を過大評価する傾向があることを示している。
· 加速倍率の大きさは、開始コードにどれだけ改善の余地があるかに大きく依存するため、現実世界のトレーニング速度の向上倍率として解釈すべきではない。したがって、絶対倍率はここでの核心的な数字ではない。より参考になるのは、この実験設定で実現された同等条件での比較である。モデル間の比較(過去1年で約3倍から約52倍に上昇)や、同等タスクにおける熟練した人間との比較(4~8時間で約4倍)が可能である。
· 判定バイアスの検証として、人間の次の選択がすでに優れている(元のグループで人間の決定に改善の余地がある瞬間と比較して)別の127の瞬間で同じテストを実施した。その結果、それらの瞬間では、モデルの提案がより優れていると判定されたのは約20%のケースのみであった。
* 本稿におけるAnthropic従業員の引用は、すべて内部議論からのものであり、関係者の許可を得て使用している。これらの引用は、2026年5月時点での個人の見解を反映したものであり、会社の公式な立場を示すものではない。
原文リンク
BlockBeats の公式コミュニティに参加しよう:
Telegram 公式チャンネル:https://t.me/theblockbeats
Telegram 交流グループ:https://t.me/BlockBeats_App
Twitter 公式アカウント:https://twitter.com/BlockBeatsAsia

 関連記事