プロンプト作成は時代遅れ?AIプログラミングはループエンジニアリングへと移行中
原文标题:Loop Engineering.
原文作者:Addy Osmani
编译:Peggy,BlockBeats
編集者注:AI コーディングエージェントの使用方法は、「人間が手動でプロンプトを書き、タスクを段階的に進める」方式から、「人間がループを設計し、システムが継続的にエージェントをスケジュールする」方式へと移行しつつある。Addy Osmani が提唱する Loop Engineering(ループエンジニアリング)の核心は、タスクを自動的に発見し、割り当て、結果を確認し、進捗を記録し、次のステップを決定するワークフローを構築することにある。
このループは、おおむね5つのモジュールで構成される:Automations(定期的なタスク発見とトリアージ)、Worktrees(複数の並行開発環境の分離)、Skills(プロジェクト知識とチーム慣行の蓄積)、Plugins/Connectors(GitHub、Linear、Slack、データベースなどの実ツールへの接続)、Sub-agents(実行者とレビューアの分離)。さらに、Markdown ファイルや Linear ボードなどの外部記憶層を追加し、状態と進捗を保存する。
記事は、Loop Engineering の意義は単に「AI に何度もループを回させる」ことではなく、エンジニアの判断力をシステム設計の段階に前置きすることにあると指摘する。ループは開発者の作業レバレッジを大幅に拡大できるが、検証、理解、判断を代替するものではない。真のリスクはループを使用すること自体ではなく、ループをコードやシステムの理解を回避する言い訳にすることにある。今後、AI とのコーディング協働における重要な能力は、優れたプロンプトを書くことではなく、信頼性が高く、検証可能で、持続可能なエージェントワークフローを設計することにあるかもしれない。
以下が原文である:
Loop engineering(ループエンジニアリング)は、あなたが「エージェントにプロンプトを書く人」としての役割を置き換えつつある。あなたは、そのシステムが代わりにエージェントにプロンプトを送るようなシステムを設計する。ここでの loop(ループ)は、再帰的な目標として理解できる:あなたが目的を定義すると、AI はタスクが完了するまで繰り返し反復する。それはおおむね5つの構成要素から成り、Claude Code と Codex は現在、これら5つの構成要素をすべて備えている。
私は、これが将来、コーディングエージェントと協働する方法になる可能性があると信じている。ただし、これはまだ初期段階であり、私は懐疑的な立場も保っている。トークンコストには細心の注意を払う必要がある。なぜなら、使用パターンによってコストの差が非常に大きくなる可能性があり、特に「トークンが豊富」か「トークンが不足している」かによって異なるからだ。また、品質が低下しないようにするための何らかのメカニズムも必要だ。「AI ゴミ出力」(slop)に関する懸念も正当である。とはいえ、これが一体どういうことなのか見てみよう。
@steipete が最近こんなことを言っていました。「もうコーディングエージェントにプロンプトを書くべきじゃない。エージェントにプロンプトを送るようなループを設計すべきだ。」同様に、Anthropic の Claude Code 責任者 @bcherny もこう言っています。「もう Claude にプロンプトを送るのはやめた。たくさんのループを動かしていて、それが Claude にプロンプトを送り、次のアクションを自分で判断している。私の仕事はループを書くことだ。」
では、これは一体どういう意味でしょうか?
ここ2年ほど、コーディングエージェントに何かをさせる基本的な方法は、良いプロンプトを書き、十分なコンテキストを提供することでした。一文を入力し、返ってきた結果を読み、次の一文を入力する。エージェントはツールであり、あなたはそれを握りしめ、ラウンドごとに動かしていました。この段階はある意味で終わりました。少なくとも、終わりに近づいていると考える人もいます。
今、あなたが構築しているのは小さなシステムです。それは自分で仕事を見つけ、タスクを割り振り、結果をチェックし、完了を記録し、次に何をすべきかを決定します。つまり、あなた自身が何度もプロンプトを送るのではなく、システムにエージェントを動かさせるのです。私は以前、その「近縁」について書きました——agent harness engineering(エージェント実行フレームワークエンジニアリング)、つまり単一のエージェントの実行環境を構築すること、そして factory model(ファクトリーモデル)、つまりソフトウェアを構築するシステムです。Loop engineering は harness のさらに上の層にあります。harness に似ていますが、タイマーで動作し、小さなアシスタントを生成し、自己給餌を行います。
驚いたことに、これはもはや「ツールレベルの問題」ではありません。1年前、ループが必要なら、大量の bash スクリプトを書き、それを永遠にメンテナンスしなければなりませんでした。それはあなた自身のものであり、あなただけのものでした。今では、これらのコンポーネントは製品に直接組み込まれています。Steinberger が挙げた能力は、ほぼそのまま Codex アプリに対応し、Claude Code にもほぼ同様に対応します。それらの形が同じだと気づけば、どのツールを使うべきかで悩むことはなくなり、ループを設計するようになります。どのツールに座っていても、それが動き続けるように。
5つの構成要素と、いくつかの説明
ループには5つのものが必要で、さらに情報を記憶するための場所が必要です。まずリストアップし、それから一つずつ対応させていきます。
第一に、Automations(自動化タスク):スケジュールに従ってトリガーされ、自動的に発見と振り分けを行います。
第二に、Worktrees(ワークツリー):並行して作業する2つのエージェントが互いのファイルを上書きしないようにする。
第三に、Skills(スキル):プロジェクトの知識を文書化し、エージェントが毎回推測に頼るのを防ぐ。
第四に、Plugins and connectors(プラグインとコネクター):エージェントが既に使用しているツールにアクセスできるようにする。
第五に、Sub-agents(サブエージェント):1つが提案を出し、もう1つがその提案をチェックする。
そして6つ目は、memory(メモリ)だ。これはMarkdownファイルでも、Linearのボードでも、あるいは単一の会話から独立して「完了したタスク」と「次のタスク」を保存できる場所なら何でも構わない。単純すぎて重要に思えないかもしれないが、これはすべての長期稼働エージェントが依存している同じテクニックだ。long-running agentsについても詳しく書いたが、モデルは実行のたびに忘れるため、メモリはコンテキスト内ではなくディスク上に置く必要がある。エージェントは忘れるが、コードリポジトリは忘れない。
現在、両方の製品はこれら5つの構成要素を備えている。
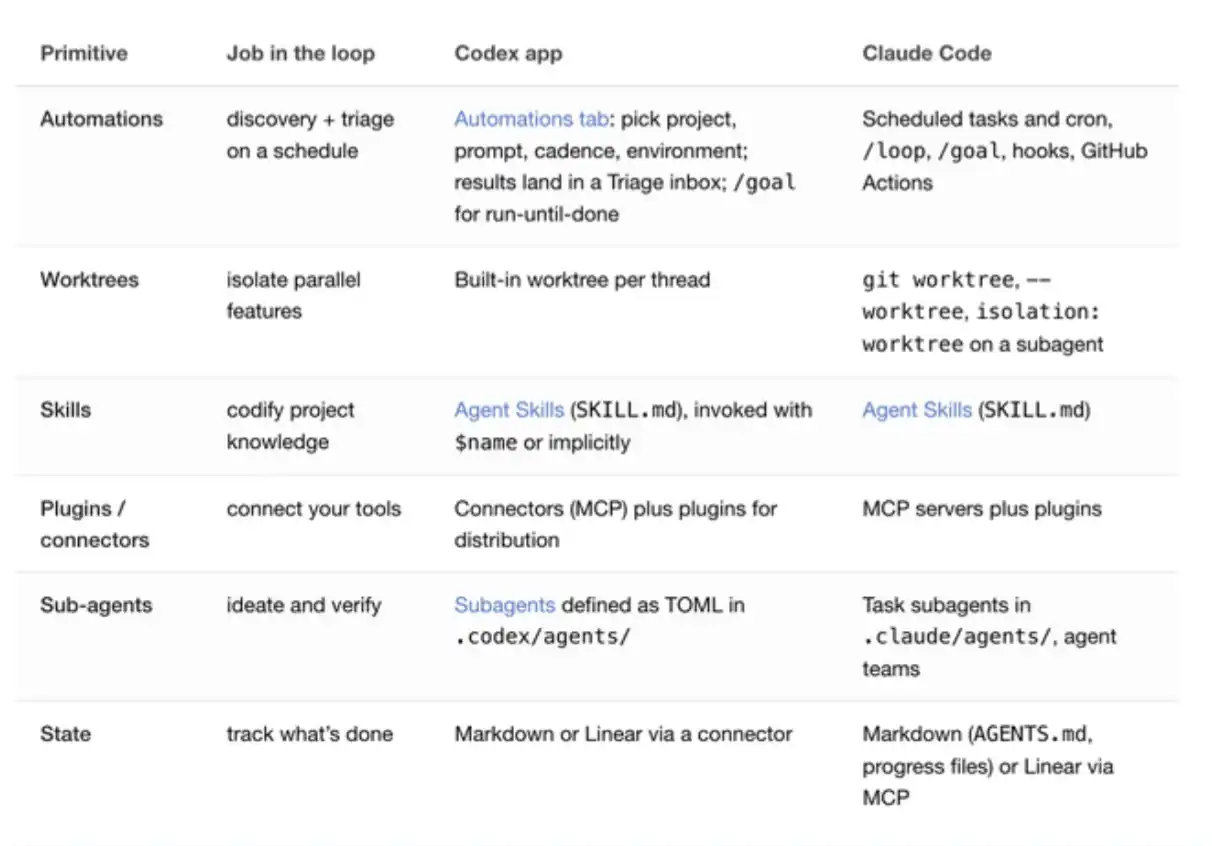
命名は一部異なるが、能力は本質的に同じだ。以下で一つずつ説明する。なぜなら、正直なところ、ループが最終的に安定して回るか、それとも静かにあちこちで漏れ出すかは、細部にかかっているからだ。
Automations:ループの心臓部
Automationsは、ループを単なる一度きりの手動タスクではなく、真のループにするものだ。Codexアプリでは、Automationsタブで自動化タスクを作成し、プロジェクト、実行するプロンプト、実行頻度、ローカルチェックアウトで実行するかバックグラウンドのワークツリーで実行するかを選択できる。問題を発見した実行結果はTriage inbox(トリアージ受信箱)に送られ、問題がなかった実行結果は自動的にアーカイブされる。これは良い機能だ。OpenAI内部でも、毎日のイシュートリアージ、CI失敗の要約、コミットレポートの作成、先週誰かが導入したバグの追跡など、退屈だが必須のタスクにこれを使用している。自動化タスクはスキルを呼び出すこともできるため、繰り返し実行するタスクを保守可能に保つことができる。つまり、後で誰も更新しないスケジュールタスクに長々とした説明文を貼り付ける代わりに、$skill-nameをトリガーすれば良いのだ。
Claude Codeでも同様の効果が得られますが、アプローチが異なります。スケジューリングとフックを利用する方法です。/loopで一定間隔ごとにプロンプトやコマンドを実行したり、cronジョブを設定したり、エージェントのライフサイクルの特定のノードでフックを使ってシェルコマンドをトリガーすることも可能です。ノートパソコンを閉じた後も動作を続けたい場合は、全体をGitHub Actionsにプッシュすることもできます。考え方はまったく同じです。自律的なタスクを定義し、それにリズムを与え、自分で確認しに行くのではなく、発見結果があなたの元に届くようにするのです。
また、この記事の核心にさらに近い、セッション内のプリミティブについても知っておく価値があります。/loopは一定のリズムで繰り返し実行されます。/goalは、あなたが記述した特定の条件が実際に成立するまで継続的に実行されます。各ラウンドの後、タスクが完了したかどうかは別の小さなモデルが判断するため、コードを書くエージェント自身が自分を評価することはありません。「test/auth内のすべてのテストがパスし、lintがクリーンである」といった条件を与えて、その場を離れることができます。Codexにも同じ機能があり、同様に/goalと呼ばれています。検証可能な停止条件が成立するまでラウンドをまたいで継続的に動作し、一時停止、再開、クリアもサポートしています。同じプリミティブが両方のツールに存在します。これが、この記事で繰り返し登場するパターンです。
つまり、Automationsは作業を表面化させる役割を担います。loopの残りの部分は、それらの作業を処理します。
Worktrees:並列処理を混乱させないために
複数のエージェントを実行し始めると、ファイルの競合が失敗の原因になります。2つのエージェントが同時に同じファイルに書き込むことは、本質的に2人のエンジニアがコミュニケーションなしに同じコード行を変更するのと同じくらい厄介です。git worktreeはこの問題を解決します。これは独立したブランチ上の別個の作業ディレクトリですが、同じリポジトリ履歴を共有するため、あるエージェントの変更が物理的に別のエージェントのチェックアウトに干渉することはありません。
Codexにはworktreeサポートが直接組み込まれているため、複数のスレッドが同じリポジトリを同時に処理しても衝突しません。Claude Codeでもgit worktreeを使用して同様の分離を実現できます。--worktreeフラグを使って独立したチェックアウトでセッションを開いたり、サブエージェントにisolation: worktreeを設定して、各サブエージェントが新しいチェックアウトを取得し、終了後に自動的にクリーンアップするようにできます。私はthe orchestration taxでこの人間側の側面について書きました。worktreesは機械的なレベルの競合を排除しますが、あなた自身が上限となります。同時に実行できるエージェントの数を実際に決定するのはツールではなく、あなたのレビューバンド幅(review bandwidth)なのです。
スキル:毎回プロジェクトを再説明する必要がなくなる仕組み
スキルとは、毎回のセッションで金魚のように同じプロジェクトのコンテキストを再説明する手間を省く仕組みです。両ツールで使用されるフォーマットは同じで、フォルダ内にSKILL.mdを配置し、説明やメタデータを保存します。さらに、オプションのスクリプト、参考資料、リソースファイルも含めることができます。Codexは、$や/skillsで呼び出したときにスキルを実行し、タスクがスキルの説明に一致した場合も自動的に実行します。そのため、凝った派手な説明よりも、簡潔で素朴な説明の方が効果的なのです。Claude Codeも同様のアプローチを採用しており、私はagent skillsでこのパターンについて書いています。
スキルはまた、意図を毎回消費させないための仕組みでもあります。intent debtで述べたように、エージェントはセッション開始時に常にコールドスタートであり、あなたの意図に空白があれば、自信満々の推測でその空白を埋めてしまいます。スキルは、その意図を外部に書き出す場所です。プロジェクトの規約、ビルド手順、「以前あの事故があったからこれはやらない」といったことなどを、エージェントが実行されるたびに読み込む場所に一度に書き込んでおきます。スキルがなければ、ループは毎回ゼロからプロジェクト全体を推測し直す必要があります。スキルがあれば、それは複利で成長するようなものです。
一つ区別すべき点があります。スキルは記述フォーマットであり、プラグインは配布方法です。複数のコードリポジトリ間でスキルを共有したり、複数のスキルをまとめてパッケージ化したい場合、それらをプラグインとしてカプセル化します。CodexもClaude Codeも同様です。
プラグインとコネクター:ループを実際のツールに接続する
ファイルシステムしか見えないループは、非常に小さなループです。コネクターはMCPに基づいて構築されており、エージェントがissueトラッカーを読み取ったり、データベースにクエリを実行したり、ステージングAPIを呼び出したり、Slackでメッセージを送信したりすることを可能にします。CodexとClaude CodeはどちらもMCPをサポートしているため、一方のために書いたコネクターは、通常もう一方でも使用できます。プラグインは、コネクターとスキルをパッケージ化し、チームメイトが記憶に頼って一式を再構築するのではなく、一度のインストールで完全な設定を利用できるようにします。
これが、「エージェントが『これが修正案です』と教えてくれる」状態と、「ループが自らPRを開き、Linearチケットを関連付け、CIが通った後にチャンネルに通知する」状態の違いです。コネクターが重要なのは、ループが「できればそうするのに」と教えてくれるだけでなく、実際の環境で行動できるようにするからです。
Sub-agents:メーカーとチェッカーの分離
ループ内で最も有用な構造的設計は、「書く人」と「チェックする人」を分離することです。コードを書くモデルは、自分の作業に自己採点する際に甘くなりがちです。異なる指示を持ち、時には異なるモデルを使用する別のエージェントが、最初のエージェントが自己説得した後に見逃した問題を捉えることができます。
Codex は要求された場合にのみ sub-agents を生成し、それらは並行して実行され、結果を一つの回答に統合します。.codex/agents/ 内で TOML ファイルを使用して独自のエージェントを定義できます。各エージェントには名前、説明、指示、そしてオプションでモデルと推論強度を設定できます。そのため、セキュリティレビュー担当者には高推論強度の強力なモデルを、探索者には高速で読み取り専用の軽量モデルを割り当てることができます。Claude Code も .claude/agents/ 内の sub-agents と agent teams を通じて同様の機能を実現し、複数のエージェントが互いに作業を引き継ぎます。両方で最も一般的な役割分担は、探索エージェント、実装エージェント、仕様に基づく検証エージェントです。
この考えは、code agent orchestra と adversarial code review の二度にわたって説明しました。ループ内で特に重要なのは、ループが監視なしで動作するため、真に信頼できる verifier(検証者)がいることが、あなたが離れる唯一の理由となるからです。Sub-agents は確かに多くのトークンを消費します。各エージェントが独自のモデル呼び出しとツール呼び出しを行うためです。そのため、「第二の意見にコストを払う価値がある」場面で使用すべきです。これは基本的に Claude Code の /goal が内部で行っていることでもあります。ループが完了したかどうかを、作業を完了したモデルではなく、新しいモデルが判断します。つまり、「メーカー」と「チェッカー」の分離を停止条件そのものに適用しているのです。
ループの実際の姿
これらを組み合わせると、単一のスレッドが小さなコントロールパネルになります。以下は私がよく使用する構造です。
毎朝、コードリポジトリ上で automation が実行されます。そのプロンプトは triage skill を呼び出し、昨日の CI の失敗、オープン中の issues、最近のコミットを読み取り、結果を Markdown ファイルまたは Linear ボードに書き込みます。処理する価値のある問題ごとに、スレッドは隔離された worktree を開き、sub-agent を派遣して修正案を起草させ、さらに別の sub-agent を派遣してプロジェクトの skills と既存のテストに基づいてその案をレビューします。
Connectors により、このループは自らPRをオープンし、チケットを更新できるようになります。ループで処理できないものはすべてトリアージ受信箱に入り、私が対応します。ステータスファイルはシステム全体の背骨です。何を試みたか、何が成功したか、何が未完了かを記憶しています。そのため、翌朝の実行は今日中断したところから再開されます。
あなたが実際にやったことを考えてみてください。あなたは設計を一度行っただけです。そのステップを一つ一つ自分でプロンプトで指示したわけではありません。これこそがSteinbergerの言葉の現実版です。そして、同じループはCodexでもClaude Codeでも動作します。なぜなら、構成要素自体が同じだからです。
ループが代わりにやってくれないこと
ループは働き方を変えますが、あなたを仕事から排除するわけではありません。実際、ループが強力になるにつれて、三つの問題はより簡単になるどころか、より深刻になります。
検証は依然としてあなた次第です。無人で動作するループは、無人でミスを犯す可能性もあります。verifierサブエージェントとmakerを分離しているのは、ループが「完了」と言うことに多少の意味を持たせるためです。それでも、「完了」は主張であって証明ではありません。私は「AI時代のコードレビュー」で同じことを繰り返し言っています。あなたの責務は、有効だと確信したコードを納品することです。
放置すれば、あなた自身の理解はやはり腐敗します。ループがあなたが自ら書いていないコードを迅速に納品すればするほど、あなたが実際に理解していることとシステム内に実際に存在することのギャップは大きくなります。これがcomprehension debt(理解負債)です。ループの成果物を読まなければ、スムーズなループはこの負債をより速く増大させます。
そして、そうです。最も快適な姿勢が、最も危険な姿勢である可能性が高いのです。ループが自律的に動作するようになると、あなたは自分の判断を形成するのをやめ、ループが返すものを受け入れるだけになりがちです。私はこれをcognitive surrender(認知降伏)と呼んでいます。判断力を持ってループを設計すれば、それは解毒剤になります。思考を避けるためにループを設計すれば、それは加速剤になります。同じ動作が、まったく逆の結果をもたらすのです。
ループを構築しつつ、エンジニアであり続ける
これは、私たちの将来の仕事の進化の方向性を示していると思います。とはいえ、私が自らコードをレビューしなかったり、自動化ループに完全に依存してコードを修正させたりすれば、私の製品品質は損なわれます。おそらく、どんどん深い穴に自分を掘り下げていくような下降スパイラルに陥るでしょう。
だから、もちろん自分でループを構築することはできるが、エージェントに直接プロンプトを与える方法も依然として有効であることを忘れてはいけない。鍵は適切なバランスを見つけることにある。
ループの結果も人によって異なる。二人がまったく同じループを構築しても、全く逆の結果を得ることがある。一人はそれを自分が深く理解している作業の効率化に使い、もう一人は作業そのものを理解することを避けるために使う。ループはその違いを知らない。あなたは知っている。
だからこそ、ループデザインはプロンプトエンジニアリングよりも難しく、簡単ではないのだ。Cherny が言っているのは、作業が楽になるということではなく、レバレッジポイントが移行したということだ。
ループを構築せよ。しかし、まだエンジニアとして働くつもりの人間のように構築するのだ。「開始」ボタンを押すだけの担当者のようにではなく。
[原文リンク]
BlockBeats の公式コミュニティに参加しよう:
Telegram 公式チャンネル:https://t.me/theblockbeats
Telegram 交流グループ:https://t.me/BlockBeats_App
Twitter 公式アカウント:https://twitter.com/BlockBeatsAsia
 関連記事