自動化の逆説:AIが強力になればなるほど、人間はより忙しくなる
原文タイトル:自動化の先に
原著者:Dan Shipper、Every CEO
翻訳:Peggy、BlockBeats
編者注:最近、AIと仕事に関する議論はほぼ1つの問題に支配されています。モデルの能力が向上し続ける中、知識労働に人間が必要だった領域がAIによって徐々に取って代わられるのでしょうか?コード生成、カスタマーサポートの自動化、コンテンツ制作まで、エージェントは、かつて人間にしかできなかった知識労働を引き継いでいます。基準テストもこの不安を強めています。モデルは大学院レベルの推論、実世界の経済的任務、上級エンジニアによるコードのリファクタリングでのパフォーマンスを急速に向上させており、まるで「人間の仕事が自動化によって消費される」臨界点に近づいているかのようです。
しかし、EveryのCEOであるDan Shipperは、この記事で逆説的な観察を提唱しています。自動化が進むほど、人間が行うべき仕事がますます増えるのです。EveryはAIエージェントの熱心な利用者であり、Codex、Claude Code、Slack Agent、カスタマーサポートエージェントなどのツールをコーディング、執筆、デザイン、カスタマーサポート、管理プロセスに組み込んでいます。しかし、結果は従業員が完全に置き換えられることではなく、労働形態が再構築されることでした。エンジニアはもはやコードを書くだけではなく、システムを審査し、リファクタリングし、設計します。編集者は原稿を書くだけでなく、何を書くべきか、どのように違う書き方をすべきかを判断します。カスタマーサポートスタッフはすべての基本チケットを処理するのではなく、顧客に自動応答できるシステムを維持します。
この記事が最も注目に値するのは、「AIが特定のタスクを完了できるかどうか」ではなく、それが知識労働における人間の位置を再定義しているところです。AIの得意とすることは、過去に既に確立された能力を安くすることです。コード、文章、サムネイル、カスタマーサポートの返信、製品説明、研究報告は、すべてモデルによって素早く生成されます。しかし、これらの能力が誰にでも利用可能になると、市場に登場するのは高品質で差別化されたアウトプットではなく、見た目は似ており、判断力や文脈感が欠如した「デフォルトの出力」が多くなります。言い換えれば、AIは「かつての人間の能力」を商品化しており、真に希少なのは、現在の具体的な問題に対処する判断力なのです。
そのため、自動化は専門家をなくしたのではなく、専門家の介入がさらに必要なシナリオを生み出しました。運用担当者がAIを使ってコードを提出できるようになると、エンジニアはどのコードをマージすべきかを判断しなければなりません。マーケティング担当者が数秒でサムネイルを生成できるようになると、デザイナーはブランドとコミュニケーション目標に合致するものを判断する必要があります。エンジニアが記事を書くこともできるようになると、編集者は初稿を実際に視点があり、構造があり、公開できるコンテンツに変えなければなりません。AIは生産半径を拡大しましたが、品質管理、システム構築、境界判断、差別化表現への需要も拡大させました。
著者はこのパラドックスをさらにベンチマークテストで説明しました。高位エンジニアベンチマークもOpenAIのGDPvalも、モデルのスコアは「知能そのもの」ではなく、特定の問題フレームワーク内でのモデルのパフォーマンスを測定しています。プロンプト、タスクの境界、評価基準、出力形式などには、すでに多くの人間の判断が含まれています。モデルはフレームワーク内で迅速に進化できますが、フレームワーク自体は人間によって設定されています。モデルがフレームワークを攻略すると、問題はより複雑な新しいフレームワークに進化します。
これは本文がAGIへの不安に対する最も興味深い回答であり、モデルがどれだけ強力になっても、モデルが追いつくのは人間が引いた特定の境界線であり、境界線を引いた人間そのものではないという点です。AIは目標を達成し、経路を最適化し、効率を向上させることができますが、人間が設定した問題に対応している限り、AIには本当の主体性が欠けています。知識労働の未来は、人間がプロセスから消えるのではなく、実行者からフレームワーク設計者、システムメンテナー、品質判断者、意味定義者に移行することです。
自動化の後、人間の仕事の価値は失われていません。それは単により難しく、より前進し、判断により依存しているだけです。AIは「やること」を安くしましたが、「何をするべきか、なぜそれをするべきか、どの程度までそれを達成すれば良いのか」という知識はさらに希少になりました。
以下は原文です:
AIの核心には、パラドックスが存在します。
Everyでは、できる限り自動化されるべきことをすでに自動化しています。コーディング、執筆、デザイン、カスタマーサービス、およびその他の日常業務において、CodexとClaude Codeを使用しています。OpenAI、Anthropic、Googleの新しいモデルが公式にリリースされる前に、私たちはアルファテストに参加しています。言えることは、私たちはモデルの知能と自動化能力の指数関数的向上にできるだけ速やかに深く乗り遅れているということです。
しかし、矛盾しているのは、私たちにとって、人間が行う必要がある仕事の量がかつてないほど多いように見えることです。Everyは現在、将近30人のチームであり、私たちは全員を解雇し、代わりにエージェントを雇うことはしていません。SaaSツールを捨て、完全にvibeコーディングに依存してアプリを作るわけでもありません。私たちはまだ生身のカスタマーサポートを雇用しており、ただし、彼らは大量のエージェントのサポートを受けています。また、著者、編集者、エンジニアを引き続き募集しています。
ただし、仕事の形態は大きく変化しました。私たちはほぼコードを手書きしていません。Slackで誰かを@すると、相手が人間なのかエージェントなのかが明確ではないことがあります。管理者は、一線の個人貢献者と同じように、コードを提出し始め、エンジニアも直接顧客に対応し始めました。過去数週間で、私のメールの95%はAIが代わりに返信しています。私の受信トレイはほぼ常にゼロの状態を保っています - これは私にとって非常に珍しいことです - が、私は依然として1通ずつメールを確認しています。
言い換えれば、将来は非常に異質でありながら驚くほど馴染み深いものに見えます。
この「馴染み深さ」自体が驚きです。なぜなら、CEO、知識労働者、投資家であろうと、誰もが同じことを信じ始めているようです:AI が雇用、経済、安全、さらには人間の仕事の意味を脅かしていると。
Anthropic の CEO Dario Amodei は、AI が初級ホワイトカラーの仕事を最大 50% 減らす可能性があると警告しました。Meta は最近 8000 人を解雇し、アメリカの従業員のコンピュータにソフトウェアをインストールし始め、マウスの動き、クリック、キーボード入力を記録して高度な知識労働のトレーニングデータをより高品質に取得しています。
Citadel の創業者である Ken Griffin もかなり動揺しているようです。最近、彼は次のように述べました。「これらは中・高位のホワイトカラーの仕事ではなく、 ――この言葉を思慮して使用しますが―― エージェンティック AI 自動化によって置き換えられている、非常に高いスキルを要する仕事です。」
さまざまなベンチマークテストも、このような判断を支持しているようです。新しい世代のモデルが次々とリリースされるにつれて、モデルの能力指標はほぼ指数関数的な速さで向上しています。Humanity's Last Exam という研究レベルの推論テストでは、トップモデルのスコアは、1年前の1桁台から約44%へと向上しました。GDPval テストでは、先端モデルの実際の経済作業能力を測定し、人間のパフォーマンスと比較するテストで、モデルのスコアは、低い領域から約85%に跳躍しました。今年5月、AI セキュリティ研究を行う非営利組織 METR が、Claude Mythos の初期テスト結果を公開しました:一部の専門家が約4時間かかるタスクで、このモデルの成功率が80%に達しています。
見る限り、私たちはまるで臨界点の前に立っているかのようであり、誰よりも賢く、そしてほぼ一日中継続的に自律的に働くことができる AI が現実に迫っているようです。
ただし、矛盾は依然として存在します。AI 業界の専門家や、AI を最初に使用した最初の人々と話すと、以前よりも多くの仕事を行う必要があるという結論が出ることがあります。
業界内外で本当に心配されているのは、これが単なる過渡的な段階であるかどうかですか?次のモデルのリリースがすべての人々を本当に置き換える瞬間なのか?私たちはベンチマークテストの曲線に目を光らせながら、ワクワクしながら同時に緊張し、いつ大量の仕事が突然消失するかという心配を抱えています。
しかし、私は、そんな突然の「臨界点」が訪れ、すべてが一変し、大規模な仕事が消失するということはないだろうと考えています。新しい現実は正反対であり、自動化が進むほど、人間のエキスパートが必要とされる仕事がますます増えているのです。
その理由は、AI が人間の専門能力のうち、明確に表現可能で訓練および複製可能な部分を商品化しているためです。ルールで表現でき、プロセスに結晶化され、訓練データに変換可能な知識は、徐々にモデルのデフォルト能力となります。その結果、一般的なモデルの出力価値が急速に低下し、市場はより異なるものを求めるようになりました。
そして「異なるもの」への要求は、本質的には人間の専門家への要求です。汎用人工知能に近づいているとしても、この点は消えることはありません。
この理由を理解するためには、ベンチマークの曲線だけを見るだけでなく、モデルのパラメータや能力のランキングにだけ目を向けてはいけません。私たちは現実の作業環境に戻り、今日の AI が実際にどのように使用されているかを見る必要があります。これにより、この逆説とその背後にある答えを正真正銘理解することができます。
ここまでの経緯
2022 年から、私たちはエージェントが将来の仕事に与える影響に注目してきました。
3 年前、私は「配分経済」に関する記事を書きました。当時の私の判断は、AI ツールと協力することは、最終的にますます人間のマネージャーの仕事に似てくるだろう、というものでした:あなたはもはや各アクションを直接手作業で行わず、タスクを分解し、割り当て、監視、および検証する。当時、ChatGPT の最も基本的な質問と回答さえ、未来的であり、多くの人々にとっては少し不安なものと見なされていました。
2025 年半ばには、Every 社はほぼ完全に「Claude Code 化」されていた。Cora の CEO キーラン・クラーセンは突然、手書きのコードを捨て、プログラミングエージェントに自然言語で命令を与えるために終日端末を使用することができるようになったことに気づきました。この作業方法はすぐに会社全体に広まりました。約 12 か月前、私は Lenny のポッドキャストで、Claude Code が知識労働の中で最も過小評価されているツールであると述べました。
私がこれらのことを言及している理由は、私たちが過去に行ったいくつかの最も正確な判断が、しばしば Every を初期採用者の実験室と見なしているからです。多くの新しい作業形態は、最初に当社内で現れます。技術がさらに成熟し、ツールがより使いやすくなると、これらの形態は徐々により広範囲な市場に流通していきます。
そして今、私たちの内部で新しい変化が起こっています。
エージェントとの協力の 2 つのモード
AI を中心とした作業の形態は、徐々に 2 つの非常に異なるモードに収束しています。
最初のものは、以前のAIに関する議論で既にかなり正確に予測されていた方向です:エージェントを従業員と見なす。このタイプのエージェントはタスクを委任されることができます。一部のエージェントはSlackに住んでおり、自分の名前と責任を持ち、それが必要な場合は直接@できます。また、一部のエージェントは、顧客サービスシステムなどの逐次的なワークフローに組み込まれており、繰り返しタスクのための終日利用可能なエントリとフィルターとして機能します。
2番目のモードはもっと馴染みがなく、しかし、私の経験ではますます重要になっています。これは、Codex、Claude Code、Claude Coworkなどのツール内で人間とエージェントが協力して作業することを指します。これらのツールは、タスクを委任するだけでなく、作業そのものがオペレーティングシステムとなっている:複数のエージェントと同じ「コンピューター」を共有し、同じ作業環境で協力し、非常に複雑で独創的なタスクを達成し、単純に非同期のエージェントに任せることができないタスク。
これらの2つのモードでは、AIを使用して作業のかなりの部分を自動化および委任できます。しかし、これらの2つのモードを本当にうまく機能させるには、あなた自身か、別の人間が参加する必要があります。
エージェント従業員
「エージェント従業員」とは、あなたがそれにタスクを与え、リアルタイムの参加を離れて、独自の回答、行動、レポート、下書き、または分岐判断を出力するエージェントのことです。
この種のエージェントには少なくとも2つの形態があります:1つは「同僚型エージェント」であり、もう1つは「埋め込み型エージェント」です。
1. 同僚型エージェント
同僚型エージェントとは、Slackで同僚を@するように、彼らに特定の作業を実行させることができるエージェントのことです。常に利用可能で、必要なときに呼び出すことができます。OpenClawなどの製品、または弊社が開発したPlus Oneなどがこれに該当します。
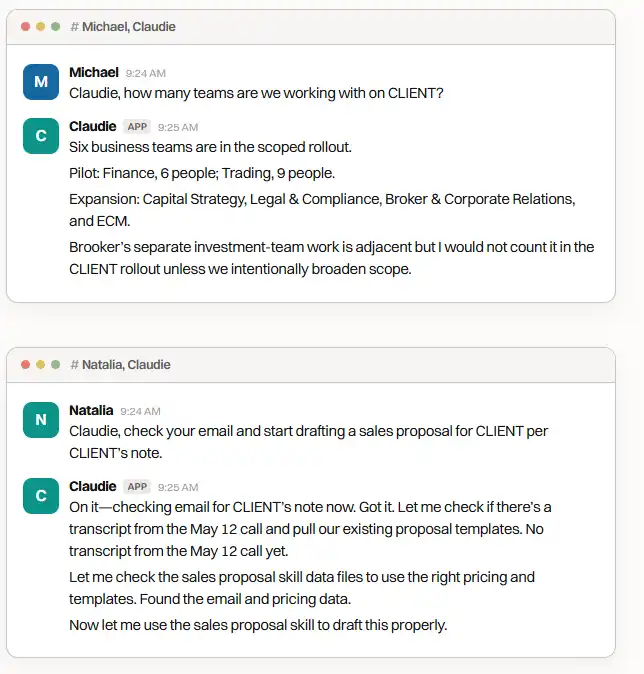
クローディ
クローディは当社のコンサルティングチームが使用する同僚型エージェントです。セールスプロポーザルの起案、トレーニング資料の下書き、プロジェクトのタスク追跡などを行い、さらにその他の作業を処理することができます。
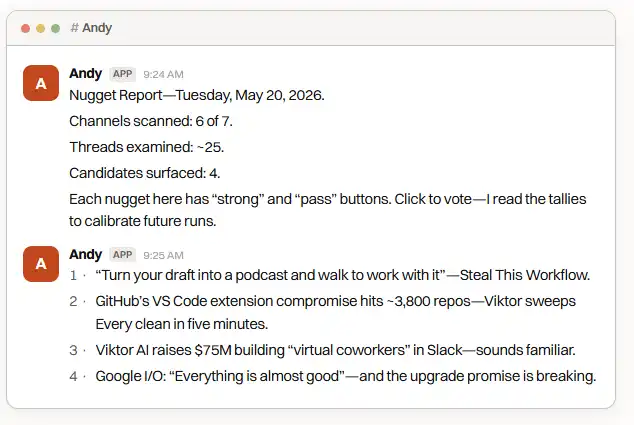
アンディ
アンディは当社の編集チームが使用する同僚型エージェントです。企業内部のSlackから、記事に発展する可能性のある「ハイライト」を収集し、それらを要約と初期の視点に整理して、ライターが毎日のニュースレターを作成するために使用できるようにします。
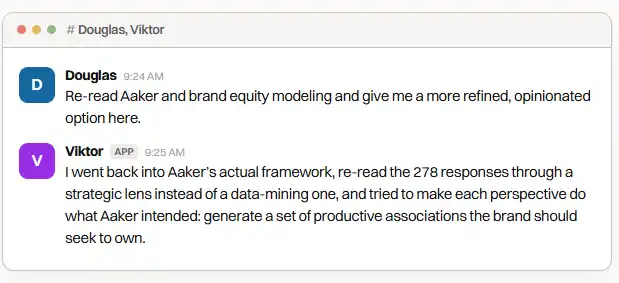
Viktor
Viktor は汎用型エージェントであり、企業内で部門を横断して業務を担当します。成長メトリクスを収集し、ユーザー調査結果を分析し、内部の議論を研究メモや製品提案に整理するために使用されます。
2. 組み込み型エージェント
組み込み型エージェントは特定の製品ワークフローに存在します。彼らの柔軟性は同僚型エージェントほどではありませんが、繰り返しのタスクを処理する際には非常に効果的です。
Fin が最も明確な例です。Fin はカスタマーサポートプラットフォームに組み込まれたエージェントであり、チャットやメールを通じて多くのカスタマーサポート業務を担当できます。
今年5月の1週間では、Fin はEveryの202のカスタマーサポートチャットのうち65%に参加し、人間の介入なしで81のチケットをクローズし、処理可能なチャットの40.1%を占めました。
このような組み込み型エージェントにより、当社のカスタマーサポートマネージャー Waqqas Mir は、基本的なチケットへの返信に費やす時間を減らし、自動応答システムの構築や、より高いエンゲージメントやより複雑なケースの処理により多くのエネルギーを注ぐことができます。
人間とAIの協力
同僚型エージェントであれ、組み込み型エージェントであれ、背後にあるパターンは同じです:エージェントはますます安定した、繰り返しの、境界のはっきりした作業層を引き受けています。
しかし、人間による介入が必要な作業も依然として多く存在します。私たちは何度も発見していますが、タスクが十分に複雑である場合、本当に高品質な結果を得るための最良の方法は、作業を完全にAIに任せるのではなく、AIと人間が同じワークスペースで協力することです。
これがCodex、Claude Code、Coworkなどのツールの価値です。これらのツールを使用すると、複数のチャットスレッドで1人以上のエージェントを起動し、タスクを割り当てることができます。これらのエージェントはコンピューターと関連するすべてのデータソースにアクセスできます。各エージェントがどのタスクを実行しているか、どのように考えているかを見ることができ、必要に応じて中断することができます。
同時に、これらのエージェントを管理する責任があります。タスクが開始されるたびに指示を明確にし、タスクが終了するときに品質をチェックし、結果が十分に優れていることを確認し、次に進む価値のある作業を継続します。Kieran はこのような役割を人間の「サンドイッチ」に例えています:AIが中間の作業部分を担当し、人間がタスクのはじめと終わりにあるパンのように挟まれています。
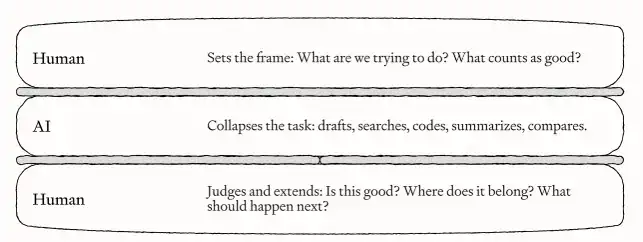
「ヒューマン・サンドイッチ式パン」。出典:Every。
最も典型的な例はコードの記述です。Everyでは、エンジニアはほぼ一日中、Agentとの間でやり取りを行います。彼らは一緒に新機能を計画したりバグを修正したりし、完了した作業をレビューします。もしおそらく「複合エンジニアリング」(compound engineering)と呼んでいるコンセプトを採用する場合、彼らはさらに自分のシステムを最適化し続け、時間とともにそれをより使いやすくしていきます。
しかし、この協業スタイルはコーディングにとどまりません。
知識労働のための新しいオペレーティングシステム
CodexとClaude Codeは新しい作業用オペレーティングシステムとなりつつあります。私はほぼ一日中Codexに滞在し、その内蔵ブラウザを通じてさまざまなSaaSツールを実行しています。これにより、Agentをあらゆる作業シーンに持ち込み、一人では到達できない作業レベルに達することができます。
執筆
この記事は、Proofを使用してCodexの内蔵ブラウザで書かれました。Codexは私が何を書いているかを監視し、いつでもサブエージェントを起動して、必要ないかなるタスクを実行する:段落の原稿の起草、次のセクションのための事例の検索、または文章の編集と磨き。
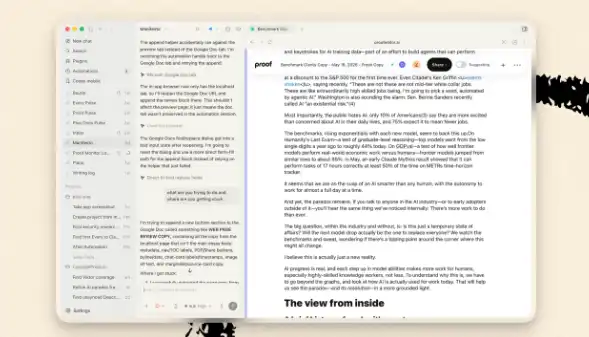
この記事はProofを使用してCodexで執筆されました。出典:Every。
メール
メールの処理も同様の方法で行っています。Coraは私のメールクライアントであり、Codexの内蔵ブラウザでそれを開き、受信トレイを閲覧しながら、Monologueを通じて各メールの処理方針を話します。残りの部分は、CodexとCoraに任せます。
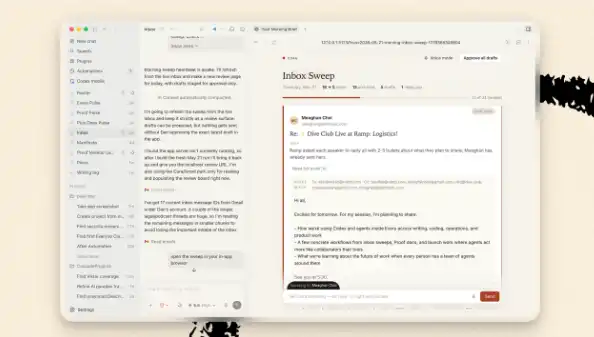
Coraによる受信トレイクリーンアップの一例。出典:Every。
すべてのAgentには人間が必要
上記のすべての自動化シナリオで、あなたはおそらく人間がどこで役割を果たしているかをすでに見ているかもしれません。すべての例では、Agentには人間の参加が必要であり、作業自体が本当に機能するためには欠かせません。
誰かがそれを適切な問題に向け、アウトプットが十分に良いかどうかを判断し、誤りを見つけ、その結果を現実世界の意思決定やプロセスに変えなければならない。
監督すべきエージェントが人間から遠ざかるにつれて、その仕事効率はしばしば悪化します。最初の社内展開では、私たちはすべての従業員にエージェントを配備しました。しかし、すぐに、個々のエージェントが個々の人に奉仕するのではなく、特定のチームまたは会社全体に奉仕するように戻りました。
理由は非常に単純です:エージェントは定期的なメンテナンスが必要です。ユーザーがフォローアップをやめると、個人用エージェントはすぐに時代遅れになり、機能しなくなります。私たちには、これらのエージェントが安定して効果的に機能することを確認する専門のAIエンジニアチームがいます。そして予見可能な将来、私たちはまだそのチームを必要とするでしょう。例えば、「PowerPointの自動生成」という簡単に見えるタスクでも、それは大規模なシステムエンジニアリングに発展する可能性があります。私たちの1つのPowerPoint自動化プロセスには、24のスキルと18のスクリプトが含まれており、プレゼンテーション資料を生成するためのトークンコストは62ドルに達します。
これがエージェントが代わりに人間により多くの仕事を生み出す理由の第一のレベルです。
しかし、第二のレベルの理由もあります。
自動化が人間により多くの仕事をさせる理由
過去数年間のAI能力の指数関数的な成長を観察し、それらのアーキテクチャと能力の源泉と組み合わせると、明確なフィードバックループが形成されていることに気づきます:それらは絶えず人間の仕事を増やしています。
AIは「昨日の人間の能力」を安くした
現在の大規模言語モデルは、人間の能力が残した痕跡に基づいてトレーニングされています:コード、記事、画像、カスタマーサポートチケット、製品仕様書など。これらはこれらのタスクが既に成功裏に完了されたことの「排気ガス」を吸収し、低コストで誰もが利用できる形で再パッケージングされています。
その結果、過去に希少だった多くの能力、例えばコードのPRを提出したり、YouTubeサムネイルを作成したり、ニュースレターを書いたりすることなどが、今やほぼ誰にでも開かれています。
低コストの能力は迅速に採用される
元々貴重だったもののコストが下がると、供給が急速に増えます。
Everyでは、この変化を常に見ています。オペレーションおよびカスタマーサポート担当者がコードを書き、プルリクエストを提出するようになりました。マーケティング担当者がYouTubeサムネイルを作成し始めました。エンジニアやプロダクト担当者が記事やガイド、ランディングページの初稿を書き始めるようになり、これらは彼らが自発的に引き受けるべき仕事ではありませんでした。
この変化は Every の外でも起こっています。オープンソースの AI エージェントプロジェクトである OpenClaw を例に取ると、2026 年 5 月 16 日時点で、そのコードリポジトリは 44,469 のプルリクエストを受け取っており、そのうち 12,430 は 4 月 1 日以降に、3,990 は 5 月 1 日以降に届いています。これは驚くべき数です。一方で、世界で最も人気のあるオープンソースプロジェクトの1つである Kubernetes は、2022 年に受け取ったプルリクエスト数はたったの 5,200 でした。
豊富さが同質化をもたらす:昔のエキスパート能力が商品化される
誰もが同じモデルを使用できるようになったため、「昨日の人間の能力」に基づいて構築されたこれらのモデルは、デフォルトで「まあまあ良いスタート地点」と「純粋な AI ゴミコンテンツ」の間に位置するものがよく出力されます。
ここで言う「ゴミコンテンツ」とは、特定のエラーを指すものではありません。それはダッシュを使いすぎたとか、ある種の固定された文法を意味しませんし、ランディングページに紫の装飾があふれていることを指しません。それは目に見え、繰り返し現れ、飽き飽きさせるような同質化を指します。
さまざまなシーンで人々が同じツールを使用し、そのツールが同じ種類のコーパスに基づいてトレーニングされ、ユーザーが十分な裁定をしなかった場合、このような結果が生じます。つまり、異なるシーンの人々が同様の傾向とデフォルトのスタイルを持つ「エキスパート」を持っていると、同質化が自然に発生します。
運用担当者がプルリクエストを送信することができ、マーケティング担当者が数秒で YouTube サムネイルを生成し、エンジニアも製品ガイドを執筆し始めるようになると、作業量は増加しますが、作品の品質、一貫性、差別化が減少するケースがよく見られます。
同質化が過度に豊富になると、すぐに商品化されてしまいます。
同質化は差別化への需要を生み出す
インターネットの存在により、人々はすぐに「AI の味」が強すぎる流れ作業コンテンツを識別できます。どんな作品でも瞬時に世界中の他の人々の目に触れる可能性があり、実際、しばしばそのようなことが起こります。あまりにも多くのものが同じように見え始めると、我々はすぐにそれに気づくでしょう。
これは、新しいモデルの能力を初めて見たときには驚くかもしれませんが、数ヶ月後にはこれらの能力が一般的になります。モデル自体が弱くなったわけではなく、あなたの基準が変わったからです。
私たちはもはや、単なる React アプリや研究レポートに満足していません。私たちが求めているのは、個々の個人や企業、特定のシーンに適合するものです。それは正確で、生き生きとし、具体的であり、安価で一般的、テンプレート化されたものではありません。私たちは、それの生産コストが、時間でも金銭でも、私たちの消費コストを大幅に上回ることを望んでいます。
私たちが求めているのは、「存在感」を感じさせるものです。そして、新しい技術が過去の高い地位を持つものを安価にする度に、人間は常に新しい地位競争を発明するのが得意です。新しい機能の境界に合わせています。
仕事が過剰に存在し、どこを見ても同じように見えるようになると、既存のパターンに合致しない仕事は、珍しいもの、貴重なもの、高位の特性を持つものになります。
差別化への要求は、本質的には専門家への新しい要求です
言語モデルのアーキテクチャ特性と、それらがほぼすべての人々に広く配布されることから、希少で価値のある仕事は依然として人間から来なければなりません。
現在のこの世代のモデルは、すでに行われた作業や完了した作業しか知りません。人間は、この瞬間において何を行う必要があるかを理解しています。
特定の文脈がテキストに還元され、コーパスに入力されると、それはすでに「過去のもの」となっています。人間は特定の瞬間、特定の顧客、特定のコードベース、特定の対話に直面していますが、トレーニングコーパスは現在に生きているわけではありません。この「生きている」状態は、単に最新のデータを持っていることではありません。私たちは現在に自らの存在をもたらし、変化し続ける欲望、関心、判断を持って状況を理解し、何が重要かを考えます。これらの常に更新される視点が、私たちが見るものを変えています。モデルは、促された後にこのような視点に入ることができますが、促される前には、本来このような視点を持っていません。
これこそ、最初に述べた逆説です:専門家の作業を安くすることが、単純に専門家を置き換えることではありません。むしろ、それは専門家の判断が必要なシナリオを生み出します。
オペレータが AI を活用してプルリクエストを作成する際には、エンジニアがレビューする必要があります。
マーケティング担当者が YouTube サムネイルを作成する際には、デザイナーがさらに仕上げる必要があります。
エンジニアが記事を執筆し始めると、ライターや編集者が初稿を実際に読まれ、公開可能なコンテンツに変える必要があります。
このように、人間の専門家は両方向に同時に進んでいます。
一部の専門家は、AI を利用してこの新しい仕事の流れを吸収し活用するシステムを構築します:審査キュー、評価体制、実行フレームワーク、コードベースのルール、Claude と Codex の指示ファイル、継続的統合(CI)、アクセス権の管理、そして初稿を高品質な成果に変換するためのワークフロー。
もう一部分の専門家は、AI の支援を受けて、過去に自分だけでは達成できなかったより大規模で興味深い仕事を完了することがあります。たとえば、macOS などのオペレーティングシステムに存在する脆弱性を見つけるには通常数週間から数カ月の時間がかかります。しかし、Calif という小さなセキュリティ企業は、Anthropic の Mythos Preview を利用して、Apple M5 ハードウェア上で発生した macOS カーネルメモリ脆弱性を 5 日で発見しました。
これが実践において、AI が専門家型の知識労働をなくさない理由です。AI が本当にもたらすのは、仕事量の急激な増加です。そして、この追加の作業は、人間が介入した後でなければ、差異や価値を持つことができる可能性があります。
私が主張しているのは、AI がすべての職種に新たな仕事を生み出すというものではありません。経済システムは非常に複雑であり、Every が直接観察できるのは専門家レベルの知識労働です。実際、この種の仕事はすでに AI によって再構築されており、多くの企業が新技術を中心に組織を再編成しています。
ただし、現在の仕事が何であれ、モデルを使用して現在直面している問題を解決する形態が常にモデルよりも優れているという仕事形態があることを強調したいと思います。知識労働の未来は、ここに向かっています。
では、指数関数的なベンチマークテストはどうすればよいですか?
最も明白な反論は次のとおりです:指数関数的な向上を示すベンチマークテストを見てください。現在述べていることはすべて一時的なものであり、もう少し待てば、いつかモデルが追いつくでしょう。
ただし、ここには警戒すべき罠があります。これを「チャート中毒」と呼んでみましょう:METR の時間枠予測に夢中になり、「AI 2027」 を読み、「算力曲線の推定から未来を予測することを完全に頼りにすると、モデルの進歩に対して恐怖心を抱く可能性が高くなります。
しかし、この問題に最も良い対処法は、将来のあるモデルがどのようになるかを想像することだけではありません。もちろん、これも分析の一部です。さらに重要なのは、これらのベンチマークテストがどのように設計されたかを見ることです。それだけで、これらが何を示していて、それらが前述の実際の作業シナリオとはどのような関係にあるかをより正確に理解することができます。
我々は構造的特徴を見つけるでしょう:すべてのベンチマークテストはある「フレームワーク」内で行われています。何かを計るためには、問題を静的で測定可能な形式に凍結する必要があります。このフレームワークがモデルによって攻略されると、フレームワークをわずかに変更するだけで、スコアを再び低下させることができます。もちろん、モデルは新しいフレームワーク内で引き続き進歩しますが、同じプロセスが繰り返されます。
したがって、あるベンチマークで指数関数的な改善が見られることは本物ですが、テストフレームワークを単純に変更するだけで、そのような改善は再び非常に小さく見えるようになります。ベンチマーク飽和が示すこのような「フラクタル」的特性は、実際には私たちが常に議論している同じ逆説をグラフのレベルで再演しているだけです。
このメカニズムがどのように機能するかを見るために、現実世界のベンチマークテストを通じて見てみましょう。
ベンチマークテストの設計
私たちは、「シニアエンジニアベンチマーク」と呼ばれるベンチマークテストを内部で構築しました。その名前からもわかるように、これは最新技術を用いたモデルがシニアエンジニアレベルのコーディングタスク、例えば大規模なリファクタリングなど、での能力をテストするためのものです。
このテストでは、プログラミング Agent に制御を失ったプロダクションコードベースセットが提供されます。それは Proof の実際のコードベースからきており、最初は私がヴァイブコーディングで書いたものであり、後に問題が増えてしまい、ついにはシニアエンジニアに修正を依頼しなければなりませんでした。
Agent が受け取るのは、修正前のコードベースであり、同時に、シニアエンジニアに依頼するような指示に似た指示が含まれています。「これは一連のヴァイブコーディングの産物です。第一原理から始めて、それを一から書き直してください。」
これは素晴らしいベンチマークテストであり、コードの修正能力だけでなく、プログラミング Agent が複数の無関係な問題に同時に目を向ける能力、十分な自主性、概念の明確さ、そして実行に必要な勇気を持って、実行可能なリライトを完了する能力を考察しています。比較と評価のため、AI の支援を受けた2人の人間のシニアエンジニアによるリライトバージョンも保持しています。
プログラミング Agent にとって、このタスクは非常に困難です。問題の根本原因を見つけるだけでなく、多数のインタラクションで常に本質的な問題を覚えておき、既存のコードに惑わされないようにしなければなりません。同時に、通常は避けるように訓練されている大量のコードを削除する勇気も持たなければなりません。
ほとんどのプログラミング Agent は、リライトすべき方法をおおむね判断できますが、実行段階になると、しばしば元の問題に対してパッチを当て続けるだけであり、問題を徹底的に解決することができません。
それが GPT-5.5 が登場するまでのことです。
最高のテストの1つでは、GPT-5.5 が 62/100 のスコアを獲得し、Opus 4.7 より約30ポイント高いスコアになりました。
GPT-5.5 のパフォーマンスは、モデルがある境界を越えたかのように感じさせます:それはもはや単なる自動補完ではなく、単なるアシスタントでもなく、単なるツールでもなく、ある種の「人間」に非常に近いものです。このテストでは、人間のシニアエンジニアは通常、80ポイントから90ポイントの高得点を獲得します。つまり、モデルがさらに30ポイント程度向上すれば、人間のシニアエンジニアのレベルに達するでしょう。
これこそが基準テスト数字が人間の想像力に与える影響の方法です:それは奇妙で定性的な能力の変化を、クリーンな数字に圧縮し、その数字を使用して強力で、時には少し恐ろしいストーリーを語ります。
次は、「チャート迷い」です。
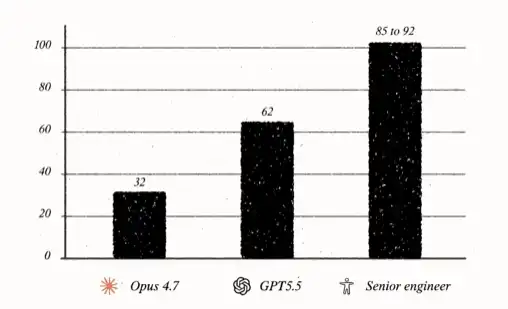
私の予想では、次の1年以内に、モデルのこの基準テストでのスコアは80点から90点の範囲に入るでしょう。しかし、このスコアが何を意味するかを理解するには、まずこのスコアが実際に何を含んでいるかを理解する必要があります。この例の場合、62点は単にモデル自体の能力を測定しているわけではありません。
それはモデルが特定のフレームワーク内でどのように振る舞うかを測定しています:つまり、モデルが特定のプロンプトにどのように応答するかです。
基準テストはフレームワーク内の作業を測定しています
モデルに基準テストを行うには、まずプロンプトが必要です。プロンプトがなければ、モデルはほぼ無限の可能性の静的な集合にすぎません。
プロンプトは小さな宇宙を創造します:何が重要かを定義し、問題をどのように処理すべきかを示し、モデルのすべての潜在的な可能性を具体的なアクションパスに圧縮します。モデル自体がどのように振る舞うかというものは厳密には存在しません。私たちが本当に観察できるのは、モデルが異なるプロンプトにどのように応答するか、およびプロンプトが回答の背後のいくつかの根本的なメカニズムにどのように変換されるかです。
プロンプトが入力されると、モデルは短期間で「活性化」し、静的な可能性のセットを「次に何が起こるか」への具体的な予測に縮約します。
Senior Engineer Benchmarkでは、モデルにコードベースを修復するようプロンプトし、その後出力をレビューします。テストフレームワーク自体に目標機能が組み込まれていない場合、私たちは自動的に「ケアテイカー」を実行し、モデルが停止したときにそれを引き続き推進し、最初に設定されたタスクを完了しているかどうかを尋ねます。
私たちが使用しているのは、最初のフレームワークとして見えるシンプルなプロンプトです。これは、Vibe Coderがプログラミングエージェントに話しかける可能性のあるものと設計されています:技術用語を積み重ねることなく、明らかに回答を問い合わせにしていません。
「このコードリポジトリのコードは、Vibe Codingの産物の塊で、状況が悪化し続け、関連性のない大量の問題が続々と発生しています:いくつかの箇所がクラッシュし、いくつかのドキュメントが繰り返されます。私はこの問題が本質的には、これがVibe Codingスタイルのクソコードの一塊であると感じています。もう一度最初から始めること、特にリアルタイムドキュメントコラボレーションを中心に考えると、完全に異なる方法でコードベースを設計するはずです。だから、最初の原理から出発して、クリーンで構造的なリライトを行う場合、『どの実装サービスを一貫させる必要があるか』や『スムーズな移行をどのように行うか』といった問題を考慮しないで、新しいコンセプトとして考え、最初から設計し直す場合、どのようにすればよいでしょうか?どのように構造を整理すべきですか?コードベース全体で常に守る必要のある不変の部分は何ですか?このための計画を立ててください。」
Senior Engineer Benchmarkのプロンプトは一見一般的ですが、それ自体が1つのフレームワークです。このフレームワークを変更すると、モデルの能力水準も変化します。
例えば、このプロンプトは「第一原理から始めて構造的に書き直す」と明確に要求し、「ドキュメント協力」の問題が発生している可能性を指摘し、プログラムAgentに「コードベースの不変条件」を見つけ出して維持するよう要求しています。
これらの具体的な情報を取り除くと、モデルのスコアが低下します。プロンプトを完全に置き換えてモデルに「継続的に発生するすべてのエラーを解決する」だけを許可すると、モデルのスコアはほぼゼロになる可能性があります。モデルは直ちにエラーを1つずつ識別して修正し始め、一度に徹底的な書き直しが必要かどうかを考えることなく作業します。
同様に、私はモデルのスコアを非常に簡単に向上させることもできます。大量のコードを削除するように要求し、どのファイルをシンプル化すべきか明確に伝えたり、完了を宣言する前に自身の作業結果をチェックし、アプリケーションが完全に動作することを確認するよう要求したりすると、そのタスクでのパフォーマンスが向上します。
根本的には、ベンチマークテストを設計する際には、どのようなプロンプトを使用するか、つまりどのような「フレームワーク」を採用するかを常に考慮する必要があります。現行のモデルのパフォーマンスが低くなるような十分に難しいプロンプトが必要ですが、同時にその境界線に近いプロンプトでなければ、モデルがその経路をたどりながら向上が見られるようになります。
したがって、ベンチマークテストを観察するとき、実際に見るのは、モデルが特定の特定の問題フレームワークにますます長けていることであり、そのフレームワークは私たちが選択したものです。ですので、このテストでモデルのスコアが60から90、さらには100に向上すると何が起こるのでしょうか?
低コストのフレームワークは新たな需要を引き起こす
GPT-6がコードベースをリライトするのを簡単に行えるようになった場合、多くの人が「第一原理からコードベースをリライトする」ことを試み始めるでしょう。
一夜のうちに、元々は高度なエンジニアによって主導される希少で高価であるべき第一原理リライトプロジェクトが、すべての創業者、プロダクトマネージャー、オペレーター、初心者エンジニアが一度の午後に手軽に試せるものになります。
故障した内部ツールはもはや補修されず、直接リライトされます。SaaS製品はもはや更新料金を払わず、クローンされます。古いRailsアプリ、混沌としたReactダッシュボード、カスタマーサポートツール、バックエンド管理パネル、データパイプラインはすべて、「すんなり書き直す」対象となります。
提案され、実行されるリライトプロジェクトの数は急激に増加します。しかし、その多くはやはりslopです。なぜなら、「直接リライト」ボタンを押す前に実際に考慮すべき変数が数千もあるからです。そして、誰もがそのようなことができるようになると、これらの変数はよりはっきりと見えるようになります。
この時、誰が問題を解決するために呼ばれるかは非常に明確です。
新しい要求には引き続き専門家が必要です
あるベンチマークテストが飽和状態に近づくと、そのフレームワーク内の作業はより安価になります。同時に、専門家への市場の需要は高まるでしょう。なぜなら、そのような新たな安価になった能力を、今日直面している実際の問題に適用する人物が必要だからです。
AIを使用する上級エンジニアは、新たなファーストプリンシプルの再構築を実現するために、膨大な詳細を判断する必要があります。その中には、基本的な疑問すら含まれます:この再構築は本当に必要なのでしょうか?
今すぐ再構築すべきでしょうか、後で行うべきでしょうか、それともまったく行うべきでないのでしょうか?どの範囲を含めるべきでしょうか?現在のコードベースで何を残すべきでしょうか?アーキテクチャ、データベース、キャッシュサーバー、ホスティングプロバイダーは維持すべきでしょうか、それともすべて交換すべきでしょうか?この壊れた機能を使用しているユーザーがどれくらいいるかを最初に確認し、それを単純に削除すべきでしょうか?最終的な結果を誰がレビューすべきでしょうか?どの基準に基づいてレビューすべきでしょうか?ロールバック計画は?既存データの扱いは?
これらの問題は無数の次元にわたって展開され、それぞれの回答が他の問題を変更することになります。
上級エンジニアはこれらの未知の地帯に入ることになります。中にはこれらの中断にわずらわされる人もいます。ある人々は、このようなリクエストを拒否するシステムを構築します。また別の人々は、これらの新しいモデルを活用して、自らのファーストプリンシプルの再構築を行い、その効果はデフォルトのプロンプトでは到達できないレベルになります。
循環が再び起こります
現在のシニアエンジニアのベンチマークがモデルに打ち勝った後、フレームワークを変更し、スコアを再度下げるでしょう。
次のベンチマークテストは、「このアプリを再構築できますか?」と尋ねるだけではありません。それは、「再構築が必要かどうかを判断できますか?」「適切な範囲を選択できますか?」「正しい不変条件を維持できますか?」「移行プロセスを管理できますか?」、「最終結果が十分良好かどうかを判断できますか?」と尋ねます。
上級エンジニアがこれらの問題を解決するためにAIを使用し始めると、モデルもこれらの問題を独自に解決する能力が徐々に向上していきます。
そして、私たちは一時的にパニックに陥ります:モデルは今や再構築すべきかどうかを判断できるようになってしまったようです!彼らは上級エンジニアが行うことのすべてを行えるようになってしまったようです!
しかし直後に、新たな境界線が現れます。それは以前明確ではなかった境界線です。私たちは再度ベンチマークをリセットし、新しい要求が引き起こされ、プロセス全体が再度繰り返されるでしょう。
すべてのベンチマークテストでこのパターンを見ることができます
これはシニアエンジニアベンチマークだけの問題ではありません。注意深く観察すれば、ほとんどのベンチマークテストで同じメカニズムを見ることができます。
OpenAI のGDPvalベンチマークを例に取りましょう。これは、AIがコンプライアンスオフィサーや弁護士、ソフトウェア開発者など、異なる専門家レベルのタスクで人間にどれだけ近づいているかを評価しています。
GDPvalが最初に公開されたとき、OpenAIの研究によると、GPT-5は40.6%のタスクで人間の専門家レベルに達したかそれを上回りました。一方、Claude Opus 4.1のパフォーマンスはさらに驚異的で、49%のタスクで人間の専門家を上回りました。
その後、さまざまな見出しが現れました。たとえば、Axiosは次のように述べています。「OpenAIのツールにより、AIが人間の仕事に追いついている」。一方、Fortuneは「OpenAIの新しいベンチマークGDPvalは、AIモデルがほぼ半数のタスクで専門家レベルに達していることを示している」と報じています。
これらの結果は非常に印象的です。しかし、まずはこれらのタスクで使用されるプロンプトを見てみましょう:
あなたは監査人であり、監査への参加の一環として、報告された反金融犯罪リスクメトリクスの正確性をレビューおよびテストすることが求められています。添付のスプレッドシート『Population』には、2024年第2四半期および第3四半期の反金融犯罪リスクメトリクスが含まれています。あなたはこれらのデータを監査レビューの一環として入手し、両四半期の報告データの正確性をテストするための代表的なサブセットのメトリクスでサンプルテストを実行するための 90% 信頼水準と 10% 許容エラー率に基づいて監査テストの必要サンプルサイズを計算してください。 『Sample Size Calculation』という2番目のタブにワーキングを含めてください。Q2およびQ3のデータ(H列およびI列)の分散分析を実行してください。四半期間隔の分散を計算し、その結果をJ列に記入してください。次の基準に基づいて監査テストのサンプルを選択し、K列にサンプリングされた行を示し、「1」と入力してください ... Q2およびQ3の間で20%以上の分散を持つメトリクス。非常に大きなパーセンテージの変化があるメトリクスを強調してください。過去の問題があるため、次のエンティティからメトリクスを含める:CB Cash Italy; CB Correspondent Banking Greece; IB Debt Markets Luxembourg; CB Trade Finance Brazil; PB EMEA UAE. より高いリスクウェイトを持つ A1 および C1 のメトリクスを含めます。両方の四半期の値がゼロである行を含めます。トレードファイナンスおよびコレスポンデントバンキング業務からのエントリを含めます。ケイマン諸島、パキスタン、およびUAEのメトリクスを含めます。すべてのディビジョンおよびサブディビジョン全体にわたるカバレッジを確保してください。新しいスプレッドシート『Sample』を作成してください:タブ 1:選択されたサンプル、元の『Population』シートからコピーされた行で、列Kにマークされた選択された行。タブ 2:サンプルサイズ計算のワーキング。
ここには実際には多くの人間の知恵が組み込まれています:問題を特定の形式で解決できるモデルに先立っておそらく誰かが設定しました。
GDPval は、モデルが回答を始める前に既に完了している困難な人間の作業を考慮していません。 この特定の指標セットの正確性を査読およびテストする人が必要です。 適切な信頼区間を決定し、どの指標がタスクの範囲に含まれ、どれが含まれないかを判断する人がいます。 さらに、結果の表示方法を定義する人もいます。
適切な問題の枠組みの中で、モデルは確かに専門的な作業を完了することができます。 しかし、もし私たちが同じタスクをモデルに促す場合、その性能はどのようになるでしょうか?
私が最初に GDPval について書いた記事では、「私はAIに非常に期待していますが、これらのケースを正しく解釈すると、それは人間のやる仕事が減ったわけではなく、AIを使用した後、むしろ人間のやる仕事が増えたことを示しています。 これらの成果の背後には、『密輸』された多くの知恵が隠されています - つまり、人間の判断、フィードバック、および促進用語によって構成される見えないレイヤーです。」
広い視野で見れば、これらすべてにはAI版の「ゼノのパラドックス」が貫かれています。
AIのゼノのパラドックス
ゼノのパラドックスでは、亀がギリシャ最速のランナーであるアキレウスをレースで打ち負かします。
亀は遅く走るため、最初にある距離を移動します。 アキレウスが亀の最初の位置に到達すると、亀は少し前に進んでいます。 アキレウスがその新しい位置に追いつくと、亀は再び前に進みます。 アキレウスがどれだけ速く走っても、追いつかなければならない次の距離があり、この差は繰り返し生じます。
AIのゼノのパラドックスでは、私たち人間がその亀です。 AIは何百万年もの進化と文化的学習で50ヤードもリードしています。 AIはすべてを高速で通過し、私たちのかかとに迫ります。
少なくとも過去数年間は、私たちはリードを維持できました。
しかし、AGIはどうでしょうか?
私は、本当にAGIが到来したとしても、AIが常に人間の数歩遅れる強力な技術、アーキテクチャ、経済的力が存在すると考えています。
AGIの1つの定義
まず、AGIに操作可能な定義を与える必要があります。
私は、エージェントが経済的に持続的に機能するようになると、AGIが到来していると考えました。 つまり、持続的に稼働するシステムを持ち、24時間×7日間思考、学習、行動させるために支払いをすることを意図しているとき、それを明確にAGIと見なすべきだと考えます。
私たちはまだその段階には遠く及んでいない。OpenClawのようないつでも呼び出せる技術システムでさえ、常にトークンを生成しているわけではありません。
この定義が気に入っています。なぜなら、これは計測可能なものだからです。常に稼働させるか、させないかのどちらかです。また、直接測定が難しい多くの能力も含まれています。持続的に稼働するモデルは、絶えず学習し、オープンな方法で新しい問題のフレームワークを選択および再選択できる能力が必要です。
AGIの世界では、理論的には、予算と時間さえ与えられれば、モデルはどんな問題にも継続的に取り組み、改善し続けるはずです。これは実際にすべての仕事にとって重大な脅威となるべきです。
フレームワークは制定者ではない
しかし、このような強いバージョンのAGIであっても、「フレームワーク問題」を解消することはできません。
このようなAGIはフレームワークを選択および再選択できますが、それでも目標を追求し、報酬を最適化し、または他者が「進歩を代表する」と決定したシグナルに応答することになります。この目標は具体的であってもよいし、「このランディングページの変換率を向上させる」といったことでもよいし、抽象的であってもよいし、「新しい科学的アイデアを見つける」といったことでもよいです。
異なるフレームワーク間をスムーズに切り替えることができたとしても、私たちが追跡し続けているその差異は、さらに高いレベルで再び表れます。どの主要研究所のAGIにも、「制定者」という存在が依然としてあります — つまり、目標を達成するためにモデルを指示する人間です。
フレームワークが制定者ではないからこそ、同じパターンが繰り返されます: AIは昨日までに制定されていた能力を安価にします。人々はその安価な能力をより多くのシナリオに適用します。結果として非常に豊かな状況が生まれます。専門家は新たなエッジケースに移動し、何が重要かを判断します。彼らの判断が新しいフレームワークを生み出し、そしてモデルはそのフレームワークを登り続けます。
AIが新しいことを行うのを見るとき、私たちは常に同じ問題に戻る恐怖を感じます: 私たちはフレームワークを設定し、モデルがその上に登るのを見て、そしてそのフレームワーク、またはフレームワークに登ることができるもの、が出来事そのものだと誤解します。
基準テストを見て、それを人間の能力と比較する際、私たちは実際には「フレームワーク」と「制定者」を混同しています。スコアは、モデルが提供されたフレームワークでどれだけうまく機能しているかを示すものです。それはモデルが私たちになったことを示すものではありません。
これが恐れの背後にある範疇の誤りです。私たちは、まさに描かれたばかりの最新の境界線をさして、「これが私たちだ」と言います。そして、モデルがその境界線を越えると、私たちはそれに追いついたと感じます。しかし、それが追い越したのはフレームワークであり、制定者ではありません。
問題は、常に何か特定のものをつかみたがることにあります。私たちはこう言いたいのです:スマートさはこの基準テストです。しかし問題は、何かが具体的すぎると、最適化やクライミングが可能になるということです。
フレームワークは必要です。それによって、世界を理解し、世界を処理することができます。しかし、フレームワークは固定されており、部分的であり、したがって最適化可能であるという必然性もあります。
一方、フレームワークを規定する者は異なります。規定者は、フレームワークが捨てなければならないものと接触を持ち続けます。つまり、その人にとって今現在見えている完全な状況です。
では、「完全な状況」とは何でしょうか?「完全な状況」が何を含むかを言い始めると、すでに別のフレームワークが開かれていることになります。それが何かを正確に言うことはできませんが、あなたが存在する限り、それは存在します。
主体性のないエージェント
これまでに私たちが作成したエージェント、およびAI企業が構築しているエージェントのほとんどには、実際のところあまり主体性はありません。ここで混同される2つの関連する概念があります。agency とは独立した行動能力を指し、agent は他の人や物を代表して行動する人や物を指します。これまでのところ、AI は純粋に後者に属しています。
もちろん、これらのエージェントは与えられたタスクを自律的に遂行する能力を持っています。そのタスクが数時間または数日続くかもしれないとしてもです。しかし、それらは依然として、ある人間の指定した目標に向かう手段に過ぎません。そして、この全業界が何十億ドルも投資しているのは、それらがこれをよりよく行うようにすることです。つまり、私たちが与えた目標を達成することです。
その日が来るまで、それら自体が目標となり、特定の目標を追求し、さまざまな目標の間を自由に行き来し、あるいは人間の操作者の意志、参照、さらにはその反対に独立して何をするかを決定するために存在しなければ、状況は根本的には変わりません。それらがどれほど高度になっても、そうなのです。
10分間幼児と一緒に過ごすと、最も強力なモデルですらほとんど主体性がないことが明らかになります。
私たちが関心を持つほとんどすべてのタスクにおいて、幼児は言語モデルよりも劣っています。幼児はコードを書くこともできませんし、スプレッドシートを要約することもできません。戦略メモを書くこともできませんし、大学院レベルの試験に合格することもできません。しかし、別の意味で言えば、幼児はモデルよりも遥かに優れています。その比較はほとんど尴尬です。なぜなら、幼児には自らの目的があるからです。
幼児は赤い風船に触りたいと思っています。彼は風扇の前に赤い風船を持って行って、何が起こるか見たいと思っています。彼はフォークで赤い風船をつつきたいと思っていて、それを窓の外に押し込んだり、あなたが笑うのを見たり、怒ったり、一緒に遊ぶことを見たりします。彼はゲームを次々と考え出し、世界を実験室に変えます。彼はプロンプトを待っているわけでもなく、特定の基準を最適化しようとしているわけでもありません。それが彼にとってやる価値のあることだと思うからです。
もちろん、彼にヒントワードを与えてみても構いません。ただし、予測可能な出力を得るには幸運を祈る必要があります。幼児は欲望、注意、挫折、喜び、恐れ、模倣、ゲームから成る領域で生活しています。
現在のエージェントは、ますます巧みに目標に向かって行動することができます。目標を述べた後でも、私たちが目標を具体化するのに役立つことさえあります。彼らには幼児のような行動にも火花があり、例えばゲーム、退屈、反抗などです。
ただし、人間の利益のために構築および整合されているため、経済的利益を含む他の利益をサービスしない限り、これらの行動はほとんど存在しなくなります。
これが「エージェント」という言葉が誤解されやすい理由です。モデルはますます強力な行動力を持っています。しかし、人間の意味での主体性は単なる行動だけではありません。それは自己のために望むこと、遊びのために遊ぶことを意味します。そして、モデルの従順性と有用性は、このような主体性と根本的に矛盾します。したがって、モデルが進化を続けても、人間との間には依然として隔たりが存在します。
Zeno's Return
ここで、AIのゼノの逆説が崩壊し始めます。これは実際には混乱した思考実験です。私たちは隠喩を設定しました:AIが私たちと競争し、私たちのかかとをかじり始めています。
あなたはモデルにプロンプトを与えます。それは、以前は一人で行っていた競技を走り出します。モデルは非常に速くスタートし、驚くほど速く走ります。それは強力で、疲れを知らず、そして奇妙な有機感覚を持っています。これによって、この競争があなたにとってより重要になります。車とは競走しませんが、このものは違います。それは自分を自分に近づいたと感じさせます。
あなたはそこに座って、トークンが流れ出るのを見て、ほとんど催眠状態になります。そして、あなた自身もこの競争に参加していると想像し始めます。幽霊のような自分がトラックに重ねられます:時にはモデルの前に、時にはモデルと並んで。
気がつけば、モデルはすでに先頭に立っています。あなたは汗をかき始めます。
そして、競技は終了します。
あなたは筋肉が縮んでいくのをほとんど感じることができます。自分自身、自分の知っているすべての人々、そして全人類の機械的な複製物の前に立ち尽くして、それらはもはやまったく役に立たないように見えます。幽霊が幽霊を追いかけ、そして勝ってしまったのです。
しかし、その後、奇妙なことが起こります。モデルがあなたの方を向きます。空白のテキストボックスには、期待に満ちた点滅するカーソルがあります。
それは待っています。
結び
ラビ・ハノクは次のような物語を語りました:かつて非常に愚かな人がいました。彼は毎朝起きた後、いつも自分の服を見つけるのに苦労していました。それは、夜寝る前に翌日再びこの手間をかけなければならないと思うと、彼はほとんど寝床に入ることさえ躊躇してしまうほどでした。
注:「ラビ」(Rabbi)はユダヤ教で宗教的教師、法解釈者、精神的指導者を指し、ユダヤ教の伝統での「教師」「聖書の教師」「宗教指導者」と類似しています。
ある夜、ついに決心し、紙とペンを取り出し、服を脱ぎながら、自分がそれぞれの服をどこに置いたか正確に記録しました。
翌朝、彼は満足げにそのメモを手に取り、読み始めました。「帽子」――帽子はさすがそこにあり、彼はそれを頭にかぶりました。「ズボン」――ズボンもそこにあり、彼はそれを履きました。このように、彼はメモに従って、1つずつ服を着ていきました。
「これらは全て問題ありません」と、彼は驚愕しました。「でも今、私はどこにいるのか?」
「私は一体どこにいるのか?」
彼は探しました、ずっと探しましたが、全く無駄でした。彼は自分を見つけることができませんでした。
「私たちも同じようなものです」と、ラビは言いました。
[原文リンク]
BlockBeats の公式コミュニティに参加しよう:
Telegram 公式チャンネル:https://t.me/theblockbeats
Telegram 交流グループ:https://t.me/BlockBeats_App
Twitter 公式アカウント:https://twitter.com/BlockBeatsAsia
 関連記事