今、ネット中で話題のLoop Engineering、一体何を変えたのか?
TL;DR
· 2026年6月、複数のAIプログラミング実践者がほぼ同時にLoop Engineeringを提唱。StripeはMinionsを使って毎週1300以上のAI生成PRをマージしている。
· この手法は人間が逐次プロンプトを送るのではなく、システムが自動でタスクを発見、引き継ぎ、検証、状態を保存し次のラウンドに進む仕組みに依存する。
· 信頼性は依然として独立した評価器、厳格なゲート、人間によるレビューに依存しており、検証負債と理解力の低下が逆にリスクを増幅する可能性がある。
最近、Anthropicのエンジニアが「エージェントシステムにおけるループエンジニアリング」に関する11ページの資料を公開し、Loop EngineeringをPrompt Engineering、Context Engineering、Harness Engineeringに続く、AIプログラミングの次なる段階における重要な手法として位置づけた。
この資料が注目を集めたのは、2026年6月のAIプログラミング議論の転換点を正確に捉えていたからだ。Addy Osmani、Boris Cherny、Peter Steinbergerがほぼ同じ週にAIプログラミングの新たな段階をLoop Engineeringと呼び、StripeのMinionsパイプラインはすでに同様のアプローチで毎週1300以上のAI生成Pull Requestをマージしている。
この数字が重要なのは、AIがさらに何行かのコードを書いたからではなく、ソフトウェア開発の重心が「人間がモデルに何を書くべきか指示する」ことから、「人間が、自らキューに並び、タスクを取得し、コードを書き、結果をチェックし、状態を保存して実行を続けるシステムを設計する」ことに移行しているからだ。
過去1年間、AIプログラミングツールの語りは主にモデルの能力に焦点を当ててきた。コード補完の精度向上、コンテキストウィンドウの拡大、エージェントが一度により複雑なタスクを完了できることなどだ。しかしLoop Engineeringが議論するのは別の事柄だ。コード生成自体がますます安価になる中で、エンジニアが本当に設計すべきなのは、持続可能に動作するループである。機械は絶えず候補を生み出し、人間はどの結果が信頼できるか、どれをブロックすべきか、どの長期的コストが隠されているかを判断しなければならない。
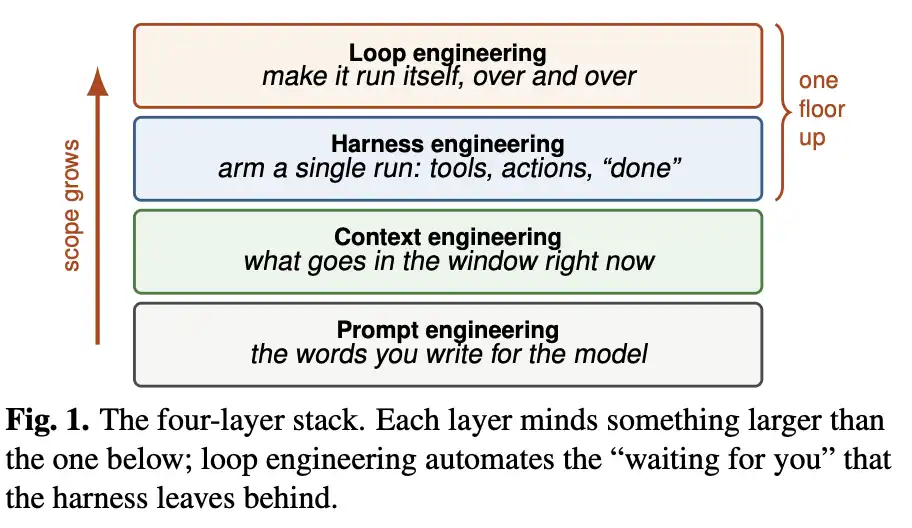
最近、Anthropicのエンジニアが「エージェントシステムにおけるループエンジニアリング」に関する11ページの資料を公開しました。これは、Loop EngineeringをPrompt Engineering、Context Engineering、Harness Engineeringに続く、AIプログラミングの次の段階における重要な手法として位置づけています。本稿では、この資料を切り口に、Boris ChernyやAddy Osmaniらの公開討論、そしてStripe Minionsが毎週1300以上のAI生成PRをマージしている事例を交えながら、Loop Engineeringとは何か、なぜ突然ネット上で話題になったのか、そしてそれが本当に変えるのはコードを書くことではなく、ソフトウェア開発における検証、スケジューリング、判断であることを解説します。
AIプログラミングが「ワンショットプロンプト」から「継続的ループ」へ
Loop Engineeringは、Prompt Engineering、Context Engineering、Harness Engineeringに続く、AIエンジニアリングスタックの第4層として位置づけられています。
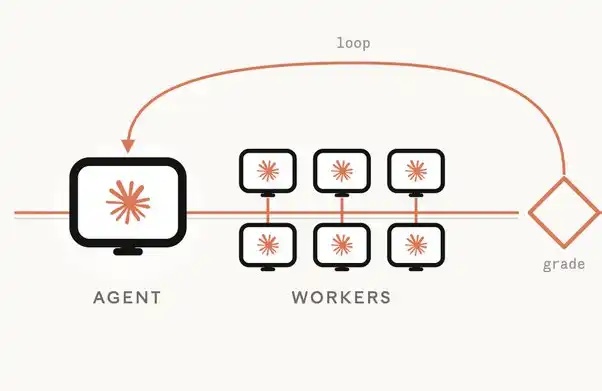
Prompt Engineeringは「どう質問するか」を解決し、Context Engineeringは「モデルに何を見せるか」を解決し、Harness Engineeringは「1回のモデル実行をツール、テスト、ワークフローにどう接続するか」を解決します。Loop Engineeringはさらに一歩進みます。システムが1回のタスクを実行するだけでなく、固定時間またはトリガー条件のもとで再起動し、前回の結果を次の入力として利用できるようにします。
完全なループは通常、5つのアクションで構成されます。
最初のステップは作業の発見です。例えば、CIの失敗、オープンなIssue、コードコミット、未処理タスクなどをスキャンします。2番目のステップはタスクの引き継ぎで、タスクをモデルが処理可能なコンテキストに整理します。3番目のステップは独立した検証で、モデルが生成したコードが実際に動作するか、テストに合格するか、副作用を引き起こさないかをチェックします。4番目のステップは結果の永続化で、状態、判断、未完了事項をファイルやシステムに書き込みます。5番目のステップはループのスケジューリングで、次のラウンドを適切なタイミングで継続実行できるようにします。
ここで最も重要なのは「生成」ではなく「検証」です。ループが単にモデルにコードを書かせ、同じモデルに自分の結果を褒めさせるだけなら、それは簡単に「うなずきループ」になってしまいます。毎回進んでいるように見えても、実際にはエラーをより完全に包装しているだけです。
Osmani自身の朝のトリアージサイクルは、個人版の例である。システムが毎日自動的に前日のCI失敗テスト、未処理Issue、最近のコミットを読み取り、ステータスファイルを生成し、処理できない項目を手動の受信箱に送る。その価値は、エンジニアの代わりにすべての判断を下すことではなく、エンジニアが起きる前に一次スクリーニングを完了し、本当に判断が必要な部分に注意を集中させることにある。
Stripeの1300件のPR:信頼性はモデルではなく制約から生まれる
StripeのMinionsパイプラインは、今回の議論の中で最も衝撃的な企業事例である。毎週1300件以上のAI生成Pull Requestがマージされ、コード自体は人間が一行ずつ書いていない。
しかし、これはStripeがプロダクションシステムを大規模モデルに自由に任せていることを意味しない。むしろ、Minionsの鍵は高度に制御されたプロセスにある。決定論的オーケストレーターがまずコンテキストを組み立て、Jira、コード検索、内部ツールからタスク情報を抽出する。LLMがコードを生成し、その後、ハードコードされたlinter、コミットゲート、最終的な人間によるレビューを経て、マージの可否が判断される。
言い換えれば、信頼性は「モデルが突然十分に賢くなった」からではなく、一連の制約から生まれる。モデルは変更案を提案し、システムはそれが触れる範囲や通過すべきチェックを制限し、人間が最終的にメインブランチに取り込むかどうかを判断する。
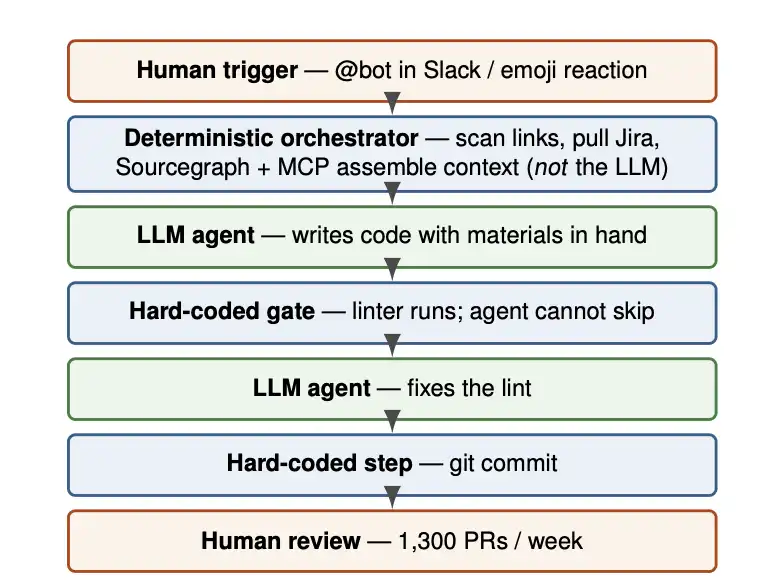
これこそが、Loop Engineeringと通常のAIプログラミングスクリプトとの違いである。通常のスクリプトは「モデルにタスクを完了させる」ことに重点を置くことが多い。一方、ループシステムは、タスクがどこから来るのか、失敗した場合の処理方法、状態の保持方法、予算の管理方法、誰がエラーをプロダクション環境に送り込むのを防ぐのかを考慮しなければならない。
これらの制約がなければ、週1300件のPRは効率の飛躍ではなく、技術的負債の製造機になりかねない。
生成器と評価器は分離すべき
Loop Engineeringの核心的な設計の一つは、生成器と評価器を分離することである。
生成器はコードの記述、ファイルの変更、候補結果の提出を担当する。評価器はエラーを探す役割を担い、デフォルトでコードに問題があると仮定するのが望ましい。両者を同じ「楽観的なエージェント」に任せるべきではない。なぜなら、モデルは自己評価の際、特にタスクの説明が曖昧だったり、テストカバレッジが不足していたり、コンテキストが不完全だったりする場合に、自身の出力を肯定する傾向があるからである。
独立した評価器は、よりシンプルで、より懐疑的であり、調整も容易である。創造的に問題を解決する必要はなく、ページが開けるか、テストが通るか、境界条件が破られていないか、コードが既定のルールに従っているかを検証すればよい。一部の実践では、評価器がコードを読んで判断するだけでなく、ブラウザ自動化ツールを使って実際にページをクリックすることもある。
これが、「検証」が5段階のサイクルの中で最も難しい理由を説明している。コード生成はますます安価になっているが、コードが本当に正しいことを証明するのは依然として高コストだ。特に大規模なコードベースでは、エラーがすぐに露呈するとは限らず、テストが実際のビジネスパスをカバーしているとも限らない。サイクルが速く回るほど、検証されていない仮定も急速に蓄積される。
隠れたコストは相互に強化される
Loop Engineeringのリスクは、コードを間違って書く可能性にあるのではなく、チームが自分たちの理解を失っていることに気づきにくくなる点にある。
第一のコストは検証負債だ。テストでカバーされていないエラーはサイクル内で蓄積され続け、あるマージやリリースのタイミングで一気に顕在化する。第二は理解力の低下だ。コードベースは拡大し続けるが、エンジニアが重要な設計判断を自ら経験していないため、メンタルマップは古いバージョンに留まる。第三は認知的な降伏だ。人間が機械の出力をデフォルトで受け入れ、形式的な承認だけを行うようになる。第四はトークン消費の爆発だ。リトライ、サブエージェント、長いコンテキスト、複数回の検証により、請求額が急上昇する。
これら4つのコストは互いに影響し合う。テスト不足が検証負債を生み、検証負債が増えるとエンジニアは深く理解しようとしなくなり、理解の低下が人間によるレビューをゴム印的なものに変え、ゴム印レビューがさらに自動リトライと高コストを促進する。
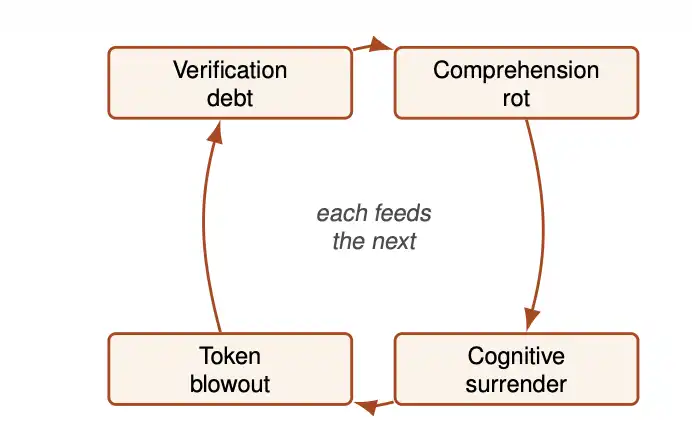
したがって、同じサイクルコンポーネントでも、エンジニアによって全く逆の結果を生む可能性がある。判断力が強く境界が明確な人は、サイクルを活用してシステムへの理解を拡大し、機械を疲れを知らない実行層として扱える。一方、判断力が弱いか自動化に過度に依存する人は、数ヶ月後には自分自身のシステムの「門番」となり、承認か拒否しかできず、システムがなぜそのように動作するのか説明できなくなる。
コードが安くなった後、高価なのは判断
Loop Engineeringは、長期的なトレンドをより明確な位置に押し上げる。コード、計画、PR、タスクの分解はほぼ無料に近づいているが、「本当に正しいとは何か」は安くならない。
企業にとって、これはAIプログラミングへの投資の重点が、より強力なモデルの購入から、より安定したプロセスの設計へと移行することを意味する。タスクの境界、コンテキストの組み立て、独立した評価、状態の永続化、予算上限、人間によるレビューポイント、そして異常時にサイクルを停止する方法などだ。モデルの能力は依然として重要だが、それはシステムの一部に過ぎない。
エンジニアにとっては、役割も変化している。過去の中心的な労働はコードを書くことだったが、今ではますます機械が生成した候補回答をレビューする労働が増えている。それが要件を満たしているか、アーキテクチャを壊していないか、単にそれらしく見えるだけか、複雑性を将来のメンテナーに押し付けていないか、といった点だ。
これはプログラマーが取って代わられたことを意味するわけではない。むしろ、Loop Engineeringは判断力を増幅する装置のようなものだ。一人のエンジニアが、かつて小規模チームでしか達成できなかった量の変更を生み出せるようになる一方で、怠惰や盲信、検証不足の習慣を生産事故へと拡大させる可能性もある。
本当の分岐点は、人間が十分な判断力と拒否権を保持しているかどうかにある。AIは絶えずPRを提出できるが、それをマージすべきか、本番に投入すべきか、長期的にシステムを破綻させないかは、依然として人間次第だ。
BlockBeats の公式コミュニティに参加しよう:
Telegram 公式チャンネル:https://t.me/theblockbeats
Telegram 交流グループ:https://t.me/BlockBeats_App
Twitter 公式アカウント:https://twitter.com/BlockBeatsAsia
 関連記事