

モルガン・スタンレー解読:AIチップの急加速、電力は追いつけるか?2027年の暗黙的需要は約38GW
TL;DR
・モルガン・スタンレーは約1900万個のGPU/ASIC、平均2kW TDPで試算し、2027年のチップ暗黙電力需要は約38GW、うちNVIDIAが約16GWを占める。
・38GWはデータセンターの総電力使用量や既に建設された電力容量ではなく、インフラがチップ出荷に対応できるかを検証するストレステストである。
・レポートでは2027年のAI HBM需要は約486億Gb、CoWoS需要は約266万~269万枚と試算されるが、Rubin Ultraの階層型メモリ方案は未確定である。
・Google TPU出荷は2026年の370万個から2027年の735万個に増加し、KYECなどのテストサプライチェーン受注を牽引する。
モルガン・スタンレーの最新アジアサプライチェーン調査は、AI拡大をより直感的な電力数値に換算した。2027年の約1900万個のCoWoS暗黙GPUおよびASIC、平均2kW TDPに基づき、これらのチップに対応する電力容量は約38GWとなる。
うち、NVIDIAが約16GW、Googleが約9GW、AMDが約7GW、AWSが約2GW、Microsoft、Metaおよびその他メーカーが各約1GWを占める。
強調すべき点として、38GWは当時のグローバルAIデータセンターの総電力使用量でも、既に確保された電力容量でもない。CPU、ネットワーク、ストレージ、冷却およびその他の付帯設備の電力を完全には含んでおらず、チップ出荷量から導出されたストレステストに近い。2027年にAIアクセラレータがサプライチェーンモデル通りに増産された場合、電力インフラはこれらのチップを同時に受け入れられるか?
これは、AIコンピューティング拡大の制約が「GPUを生産できるか」から、HBM、CoWoS、テスト、ラック納品、電力接続が同時に整うかにまで延伸していることを意味する。
38GWストレステスト、AIボトルネックを電力へ押し上げる
モルガン・スタンレーの今回の試算は、2つの核心的な仮定に基づく。2027年のCoWoS対応GPUおよびASICチップ量は約1900万個、各チップの平均TDPは2kWとし、これにより約38GWのチップ暗黙電力需要が得られる。
2kWは総量を推定するための平均仮定であり、すべてのGPUおよびASICが同じ消費電力を持つことを意味しない。38GWはデータセンターの実際の稼働負荷にも等しくない。チップは常にフル稼働するわけではなく、サーバー内のCPU、ネットワーク、ストレージ、冷却システムが追加の電力を消費するためである。
しかし、この数字には依然として参考価値がある。過去2年間、AIサプライチェーンに関する議論は主にGPUの生産計画、HBM供給、CoWoS生産能力に集中してきた。チップ出荷が引き続き増加する中、系統接続、変電所建設、データセンターの立地選定、長期電力購入契約が、チップが実際に利用可能な計算能力に転換できるかどうかに直接影響を与える可能性がある。
チップ納品は第一歩に過ぎない。GPUやASICがデータセンターに入った後も、サーバー、ラック、ネットワーク、冷却、電力、運用保守システムの整備が必要となる。インフラ建設がチップ出荷より遅れれば、市場には「チップは届いたが、データセンターと電力が整っていない」というミスマッチが生じる可能性がある。
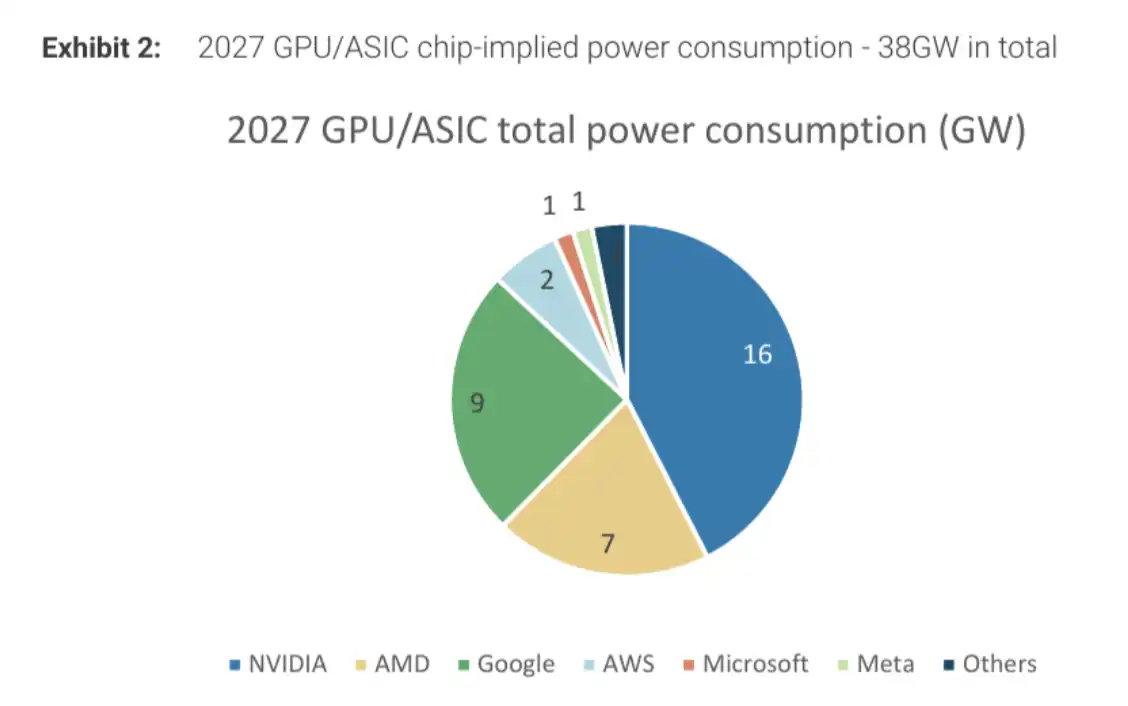
2027年のGPU/ASICチップの暗黙的電力需要は約38GWで、うちNVIDIAが16GW、Googleが9GW、AMDが7GW。
NVIDIAにとって、16GWの暗黙的需要は、同社が単一ラックのGPU密度を継続的に引き上げている理由も説明している。報告書によると、NVIDIAは長期的にscale-upアーキテクチャを通じてより多くのGPUを接続し、ラックレベルの計算能力と性能を向上させることを目指している。
しかし、第一世代のRubin UltraラックのKyberソリューションは依然としてPCBと冷却の課題に直面しており、Oberon NVL72設計を継続し、CPOまたはNPO相互接続を通じてNVL576規模に拡張する可能性がある。ラック密度の向上は電力需要を排除するものではなく、むしろ給電、冷却、相互接続の負荷をより高仕様のデータセンター設計に集中させることになる。
HBMとCoWoSの同時拡大、Rubin Ultra仕様は未確定
電力以外にも、HBMと先端パッケージングは2027年前後のAIチップ拡大における主要な制約要因であり続けている。
モルガン・スタンレーのサプライチェーンモデルによると、2027年のAIチップに対応するHBM需要は約486.18億Gbとなる。Exhibit 3に記載されたCoWoS構成量は約266.4万枚のウェハーで、Exhibit 5が示す世界のCoWoS需要は約269.4万枚であり、両者は統計範囲の違いにより若干の差異がある。
報告書は同時に、2027年のAI計算チップに対応するウェハー収入市場規模が少なくとも588億ドルに達すると試算している。NVIDIAは依然としてCoWoSの最大需要元であり、約122.2万枚を占めると予想される。AMDとBroadcomはそれぞれ約53万枚と48.4万枚となる。
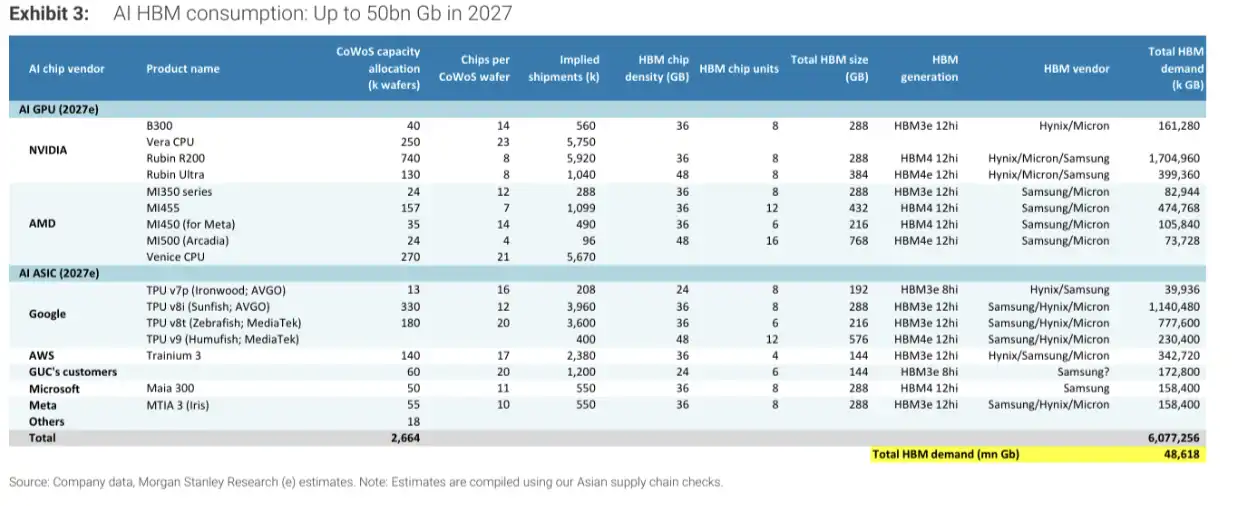
2027年のAI HBM需要は約486億Gb、および異なるGPU・ASICのCoWoS構成とHBM需要。
需要予測には依然として重要な変数が1つ存在する:Rubin UltraのHBM構成がまだ最終決定されていない。
サプライチェーン調査によると、Rubin Ultraは階層仕様を採用する可能性があり、高仕様版はHBM4e 8Hi、低仕様版はHBM4 12Hiまたは8Hiを採用する可能性がある。モルガン・スタンレーは、エヌビディアが2026年第3四半期末までに最終決定を下すと予想している。
この調整は主に3つの圧力を反映している:HBM生産能力の不足、メモリコストの上昇、および異なるAIワークロードにおける容量と帯域幅の需要が同一ではないこと。レポートでは、HBM構成の引き下げがデコードワークロードに与える影響はプリフィルよりも大きい可能性があり、特に長文脈の大規模モデルにおいて顕著であると指摘している。
注意すべき点として、Exhibit 3は依然としてRubin UltraにHBM4e 12Hi、単体総容量384GBを構成した場合で試算している。したがって、486億GbのHBM需要は潜在的な階層仕様引き下げ案を完全には反映していない。最終構成が引き下げられた場合、単体チップのHBM使用量は減少する可能性があるが、より低いメモリコストがチップ出荷の増加を促進し、単体使用量減少の影響を部分的に相殺する可能性もある。
マイクロンの公開情報によると、同社のHBM4は大量出荷段階に入っており、HBM4Eは2027年に量産開始が見込まれている。供給側は新製品を推進しているが、Rubin Ultraが最終的にどの構成を採用するかは、エヌビディアの性能・コスト・供給保証の総合的なバランス判断に依存している。
Rubinシリーズの出荷ペースは依然として積極的である。レポートでは、2027年のRubinとRubin Ultraの合計出荷は約700万個に近づき、うちRubinは約592万個、Rubin Ultraは約104万個と予測;Rubin NVL72ラックの出荷は約9万台に達する可能性がある。
Rubinは2026年第3四半期から生産を開始し、第4四半期にラック出荷を開始する見込みである。レポートではまた、以前市場が懸念していたBlackwellの「在庫」は主にサプライチェーンのバッファ在庫であり、2026年までに完全に消化されると予想している。
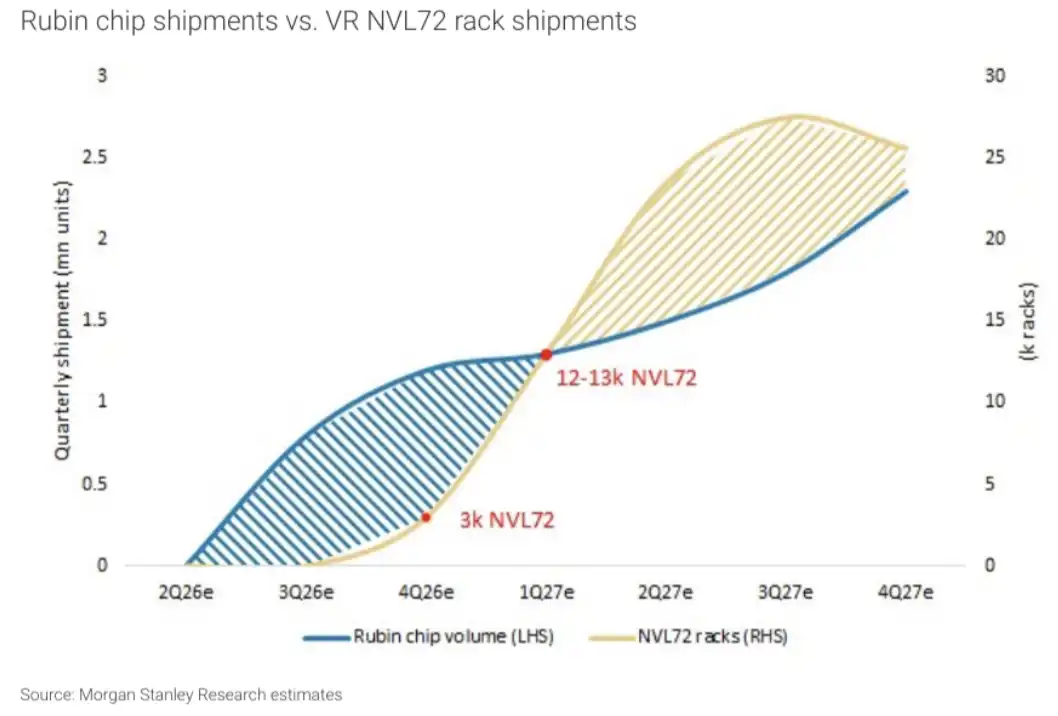
RubinおよびRubin Ultraチップの出荷、ならびにRubin NVL72ラックの出荷予測。
これは、2026年下半期から2027年にかけて、NVIDIAのサプライチェーンがBlackwellの在庫消化、Rubinの立ち上げ、HBM仕様の切り替え、ラック納品を同時に完了する必要があることを意味します。いずれかのプロセスが遅延すれば、最終的に納品可能な計算能力規模に影響を及ぼす可能性があります。
Google TPUが735万個に増加、注文がテストチェーンに波及
NVIDIA以外にも、Google TPUはレポート内で明確な成長トレンドを示すもう一つの柱です。
モルガン・スタンレーの予測によると、Google TPUの出荷量は2026年の370万個から2027年には735万個に増加します。そのうち、Broadcomが関与するv8iは400万個、MediaTekが関与するv8tは300万個、v9は約15万個、残りの約20万個はv7によるものと見込まれています。
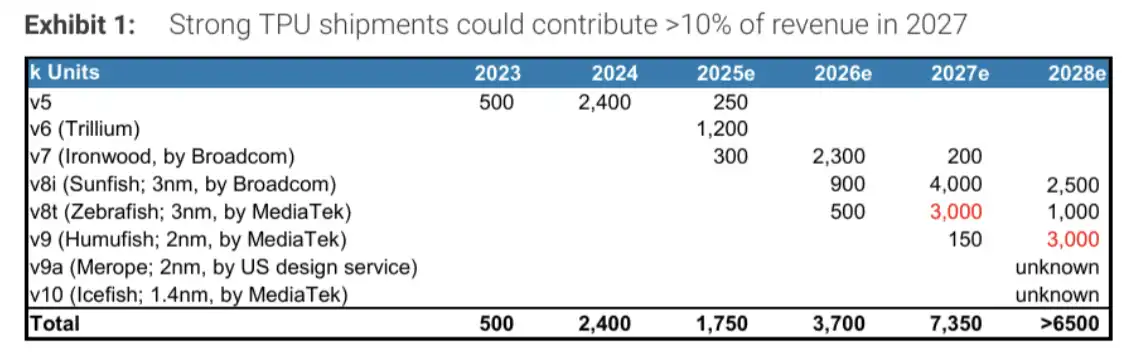
Google各世代TPUの出荷予測と、KYEC収益への潜在的な貢献。
TPUの量産拡大により、注文はチップ設計、ウェハー製造、先進パッケージング、テスト工程へと波及します。レポートでは、TPU関連事業がKYECの2026年収益の7%から8%を占め、2027年には10%強に達すると予測しており、最終テストと一部のウェハープロービング収益が含まれます。
GoogleのCPU、TPU、最終テスト、一部のウェハープロービング事業をすべて含めた場合、Google関連の需要はKYECの2027年収益の10%から15%を占めると見込まれ、2026年の8%から10%を上回ります。
テスト需要もより複雑化しています。レポートによると、MediaTekが関与する3nm TPUは、AIチップの性能安定性と信頼性を高めるためバーンインテストを採用する見込みです。また、Google CPUプロジェクトでもバーンインおよびシステムレベルテストが必要です。
より複雑なテストプロセスと長期化するテストサイクルはテストファウンドリの受注を増加させますが、テスト生産能力がボトルネックになるかどうかは、チップ単体のテスト時間と全体出荷量の変化に依存します。レポートは同時に、一部のテスト時間短縮が短期的な生産能力圧力を緩和する可能性があるため、テスト需要の増加を単純に生産能力不足と同一視すべきではないと指摘しています。
38GWは需要の終着点ではなく、供給能力のテストである
このサプライチェーン調査で最も注目すべき点は、単にAIチップの出荷台数をさらに示したことではなく、2027年の主要な拡張制約を同じモデルに組み込んだことにある。エヌビディアはGPU密度を引き上げ続け、グーグルのTPUは急速に生産を拡大し、HBMとCoWoSの需要は同時に上昇し、チップに内在する電力需要は38GWにまで押し上げられている。
これらの数字は依然として複数の前提に依存している。Rubin Ultraの階層型HBM構成はまだ最終決定されておらず、メモリ構成を削減した場合の長いコンテキストのデコード性能への影響は検証が必要だ。CoWoSとHBMの生産能力は計画通りに拡張される必要があり、サーバー、ラック、電力、冷却設備の整備もチップの納入に追いつかなければならない。
インターコネクトの方式も差異をもたらす可能性がある。報告書によると、国内のファウンドリプロセス上の制約により、中国のAI GPUメーカーのSerDes速度は依然としてチャネルあたり100Gb/sに留まる可能性があり、そのためスーパーノードアーキテクチャではNPOインターコネクトの採用が進んでいる一方、エヌビディアは長期的にCPOを重視している。異なるアプローチはスーパーノードの設計、導入コスト、システム効率に影響を与えるだろう。
したがって、38GWは2027年の実際の電力消費量の正確な予測ではなく、チップ出荷側から導き出されたストレステストである。これはAIチップの需要が依然として強いことを示すと同時に、市場に次のことを思い出させる。AIコンピューティング能力が実現できるかどうかは、もはやGPUの生産計画だけではなく、HBM、CoWoS、テスト、ラック、電力が同時に整うかどうかにかかっているのだ。
BlockBeats の公式コミュニティに参加しよう:
Telegram 公式チャンネル:https://t.me/theblockbeats
Telegram 交流グループ:https://t.me/BlockBeats_App
Twitter 公式アカウント:https://twitter.com/BlockBeatsAsia






