SemiAnalysisの解説:Rubin Ultraのビデオメモリが192GBに減少、NVIDIAもHBMに妥協するのか?

TL;DR
· SemiAnalysisによると、NVIDIAは主要顧客向けにスペックを引き下げたRubin Ultraをプレビューしており、メインラインのメモリは192GB。
· この情報はNVIDIA公式の確認ではなく、主要なトレードオフはHBM供給、消費電力、NVL576システム展開にある。
· スペック引き下げはAI需要のピークアウトを意味するものではなく、高消費電力版が残る可能性はあるが、データセンターの電力とサプライチェーンが依然として制約となる。
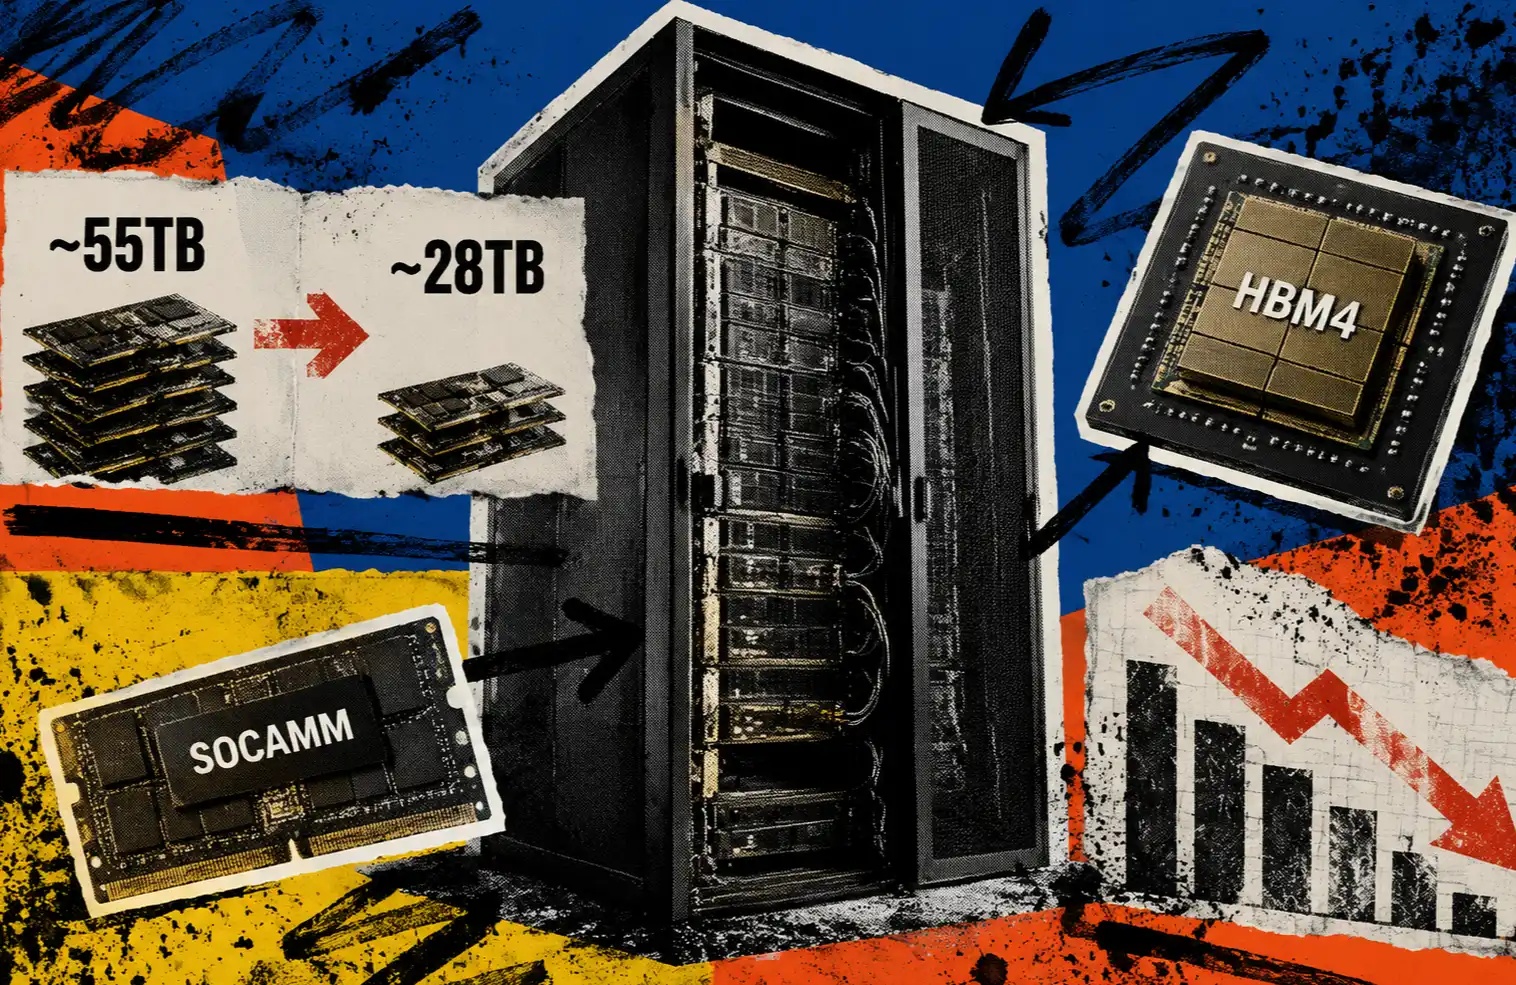
SemiAnalysisが7月29日に発表したレポートによると、NVIDIAは主要顧客向けに調整後のRubin Ultraをプレビューしている。顧客向けプレビューの情報によると、メインラインSKUは8-Hi HBM4を採用し、メモリ容量は192GBで、市場がRubin Ultraに対して期待していたより積極的な構成を下回る。
これはNVIDIA公式が確認した最終製品仕様ではない。NVIDIAが7月21日の技術ブログで開示したRubin GPUは、デュアルコンピュートダイ、HBM4採用、最大288GB、22TB/s帯域幅、50 PFLOPS NVFP4性能を備えており、「Rubinが次世代の重要製品である」という基本判断を支えるが、Rubin Ultraの192GBメインライン版はSemiAnalysisが開示した顧客向けプレビュー情報として捉えるべきである。
AIデータセンター顧客にとって、メモリ、HBM供給、単一カードの消費電力、ラック展開の難易度は、トレーニングおよび推論システムの構築方法、構築速度、コストに直接影響する。Rubin Ultraがメインラインメモリを192GBに抑えるのは、NVIDIAが限られたHBMと電力条件下で、単一GPUのパラメータを最大限に引き上げるのではなく、大規模な納品が容易なバージョンを優先的に選択していることを示す。
192GBメモリは初期期待を下回る、メインライン版は展開可能性を優先
これまでのGTC 2025および複数の証券会社、メディア資料では、Rubin Ultraはより高いメモリ、より高い消費電力、より複雑なパッケージングを備えた次世代製品として説明されることが多く、HBM4E、1TB、NVL576などのより積極的な構想が含まれていた。
SemiAnalysisが今回示した顧客向けプレビュー情報は明らかに保守的で、メインライン版は8-Hi HBM4、192GBメモリである。この変更は、NVIDIAが何らかの仕様を正式に発表した後に撤回したのではなく、これまでの市場期待および初期ロードマップからの引き下げとして理解すべきである。
メモリは独立したパラメータではない。大規模言語モデルのトレーニングと長文脈推論にはより多くの高速メモリが必要であり、メモリが大きいほど、単一GPUが処理できるモデルシャーディング、キャッシュ、データが増える。しかし、HBMは現在のAIハードウェアにおいて最も逼迫し、最も高価な部品の一つでもある。メインライン版でHBMを少なく使用することで、NVIDIAは限られた供給をより多くのGPUとシステムに割り当てることができる可能性がある。
これも「スペックダウン」が誤解されやすい点だ。既存の情報は、これを直接AI需要の減速と書くことを支持していない。より合理的な解釈は、HBMと電力の両方が逼迫する環境下で、主力製品は性能、コスト、供給、導入の間でバランスを取る必要があるということだ。
算力のストーリーはNVL576へシフト、顧客が買うのはシステム全体
SemiAnalysisによると、Rubin Ultraの主力バージョンのピーク理論FLOPsは概ね維持され、調整の中心はメモリ容量、消費電力、システム形態にあり、単純な計算能力の削減ではないという。
この路線の重点はNVL576にある。簡単に言えば、NVIDIAは引き続きより多くのGPUを高速インターコネクトで接続し、より大きな統一コンピューティングドメインを構築しており、顧客を単一カードのパラメータからラック全体、クラスタ全体のシステム能力へとシフトさせている。同レポートによると、計画中のシステム形態の1つは、8つの72-GPUラックを相互接続してNVL576規模を構成するものだ。
これはクラウドベンダーや大規模AIラボにとってより現実的だ。トレーニングクラスタの拡張を制約するのは、単一GPUの性能だけでなく、ラックの消費電力、冷却、電源、ネットワーク、HBM供給、納品ペース、データセンターの建設工事も含まれる。単一カードのメモリ容量が大きいことは価値があるが、より高い消費電力、より高いBOMコスト、導入が難しいラックをもたらすなら、顧客は使い切れない可能性がある。
Rubin Ultraの主力バージョンの変更は、計算性能とシステム拡張を維持しつつ、メモリ容量と消費電力を、量産・供給・導入が容易な範囲に抑えることに近い。
1800Wが主力の基準に、電力が限界構成を抑える
消費電力は今回の路線変更におけるもう一つの重要な数字だ。
SemiAnalysisによると、Rubin Ultraの主力バージョンのチップレベル消費電力は約1800Wで、以前のRubin 1800W Max-Q構成に近く、市場で議論されていた2300Wバージョンより低い。同レポートはまた、NVIDIAが2600Wから2800WのMax-P高消費電力バージョンを提供する可能性があり、トークンデコードなど低い計算負荷向けの1200W SKUも存在する可能性があると述べている。
これらの詳細はまだNVIDIAから公式に確認されておらず、レポートの内容として見るべきだ。しかし、それらは同じ現実的な問題を指し示している。チップ自体がより高い消費電力で動作できたとしても、顧客のデータセンターが安定して受け入れられるとは限らない。
単一GPUの消費電力が高くなるほど、ラックの電源供給と冷却要件は高くなる。多くの顧客が直面する問題は「より強いGPUを買いたいかどうか」ではなく、既存のキャンパス、電力接続、冷却システムが対応できるかどうかだ。SemiAnalysisの以前の公開記事でも、Rubinには2300W Max-Pと1800W Max-Qの2つの消費電力構成があり、Max-Qはワットあたりの性能を重視し、顧客は電力制約により低い消費電力で運用することを選択すると述べられていた。
電力が制約される環境では、1800W版の方がむしろ量産展開しやすい可能性がある。極限的な構成を一部犠牲にするが、給電と放熱の負荷を軽減でき、顧客が比較的迅速に導入できる形態に近づく。
HBMは依然としてボトルネック、仕様引き下げは需要の天井を意味しない
HBMの供給逼迫は、メモリ容量を192GBに引き下げるもう一つの主要因である。
SemiAnalysisの説明によると、HBMはTSMCの前工程製造能力と比較してより逼迫している。NVIDIAは単一GPUあたりのHBM使用量を削減することで、限られた供給をより多くの製品に配分でき、将来のHBM価格上昇によるコスト圧力をヘッジできる。この判断もレポートの見解を踏襲する必要があるが、現在のAIハードウェアサプライチェーンの逼迫状況と一致している。
これはサプライチェーンに直接的な影響を与える。主力GPUの単一カードあたりのHBM容量が市場の従来予想を下回る場合、HBMサプライヤーのユニット需要予測、クラウド事業者の調達モデル、サーバーBOMがすべて変化する。しかし、これはHBMが逼迫していないことを意味しない。むしろ、HBMの供給が逼迫しているからこそ、NVIDIAは主力プランをHBM消費を抑え、量産展開しやすい形態に調整する動機がある。
Rubin Ultraも必ずしも一つのバージョンだけとは限らない。SemiAnalysisの見解によれば、高消費電力のMax-Pバージョンは特定の顧客や極限的なシナリオ向けに残る可能性があるが、最も広く展開される主力SKUにはならないかもしれない。
今回の開示は、AIコンピューティング能力の拡大がエンジニアリング上の制約段階に入った後の産物と言える。NVIDIAはより大規模なシステムへの推進を止めていないが、次世代GPUが順調に量産展開できるかどうかは、単一チップの仕様だけでなく、HBM供給、データセンターの電力、顧客の実際の導入能力にますます依存している。
BlockBeats の公式コミュニティに参加しよう:
Telegram 公式チャンネル:https://t.me/theblockbeats
Telegram 交流グループ:https://t.me/BlockBeats_App
Twitter 公式アカウント:https://twitter.com/BlockBeatsAsia
 関連記事