DeepSeek の 1 兆ドルの道のり:オープンソースを活用した 1 兆ドルのハードウェアエコシステム
原文タイトル:DeepSeek の 10 兆米ドルの大戦略
原著者:@bookwormengr
翻訳:Peggy,BlockBeats
編集者注:過去1年間、DeepSeek に関する議論は主にモデルのパフォーマンス、オープンソース戦略、価格競争に集中してきました。しかし、DeepSeek を「サブスクリプションを販売するか」「マルチモーダルを持っているか」「コーディング エージェントを作るか」という観点から理解するだけでは、DeepSeek が本当に変えたいと考えていることを過小評価しているかもしれません。
本文では、より積極的な見解が提案されています:DeepSeek の目標は、短期的なアプリケーションレイヤーでの売り上げではなく、一連の基盤革新を通じて、AI のトレーニングと推論のコスト構造を再構築し、間接的に新しいハードウェアエコシステムの形成を推進することです。MoE、MLA から DSA、CSA、mHC、Engram まで、Dual Path と TileLang まで、DeepSeek の技術ロードマップは常に、HBM、先進製程、パッケージング、CUDA エコシステムの制約の中で、より少ないハイエンド計算リソースでより強力なモデルを実行する方法を中心に展開されています。
注目すべき点は、「DeepSeek が API またはサブスクリプションで何十億ドルも稼ぐことができるか」という点ではなく、モデルの能力やメモリシステムが国産ハードウェアエコシステムと結びついているかどうかです。KV キャッシュの圧縮により、HBM への依存が低減し、NAND と SSD は長時間キャッシュを扱うことができ、LPDDR はウェイトのストリームロードと Engram ストレージに使用され、TileLang は CUDA の砦を削ろうとしています。これらのイノベーションが継続的に浸透すれば、利益を得るのは DeepSeek 自体だけでなく、ストレージ、ASIC、GPU、ネットワークチップ、およびAIインフラ全体のリンクでしょう。
もちろん、記事で言及されている「10兆米ドルの産業エコシステム」と「1兆米ドルの評価」には、まだ推測が交えられています。しかし、これは DeepSeek を理解するための重要な進展です:オープンソースは常に商業化を放棄することを意味するわけではなく、低価格はただ市場をサポートするだけでない場合もあります。DeepSeek にとって、本当のビジネスはアプリケーションレイヤーにあるわけではなく、より多くのハードウェアを利用可能にし、低コストでのAI供給を実現することかもしれません。つまり、売るものはモデルそのものではなく、次世代のAIインフラの実現可能性です。
以下はオリジナルの記事です:
DeepSeek がどのようにしてお金を稼ぎ、しかもたくさん稼ぐかを考えたことがありますか?
GLM、MoonShot、およびMiniMax のような競争力のあるプログラム登録プランを立ち上げていません。また、多形態、音声、ビデオモデルもありません。これまでに、独自のハーネスも持っていません。これは、モデル呼び出し、ツールの統合、およびタスク実行に使用される外部ランタイムフレームワークです。ただし、最近、関連職種の採用活動を始め、このシステムを構築する準備をしています。
一方、DeepSeek は、長い間オープンソースの立場を堅持し、自らの「秘密」を公開することに喜んでいます。これは狂気ではありませんか?ムダにお金を使っていませんか?100 億ドルを投資しようとしている人々は、お金を水の中に捨てているのでしょうか?
個人的には、その答えはまったく逆です。
次に、DeepSeek がこれまでに行ってきたことに基づいて、いくつかの観察を提出し、彼らが従っているように見える戦略について分析します。DeepSeek の CEO、梁文鋒の目標は、おそらく単なるモデル競争を超えています。彼が狙っているのは、もっと大きな賞です。DeepSeek は、1 兆ドルの評価額を目指し、同時に 10 兆ドル規模の新産業の形成を推進するチャンスを持っています。
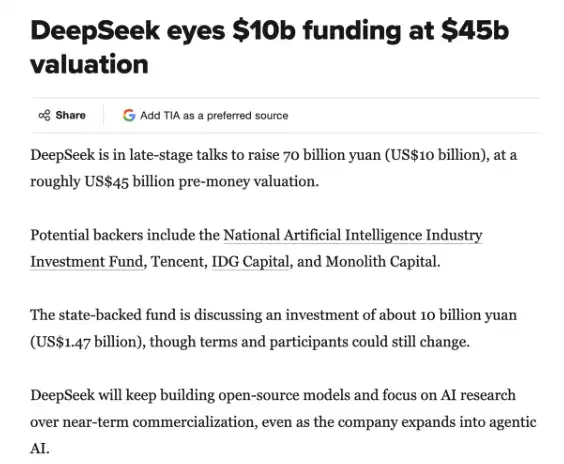
DeepSeek の最新ラウンドファンディングに関する TechInAsia の記事
DeepSeek の「英雄の旅」を再訪する
DeepSeek は常に逆風の中を歩んできました。彼らは、わずかに強力なモデルを継続的に展開し、それらを即座に収益化可能なアプリケーションとして急いで提供するという選択をしませんでした。2025 年 1 月 27 日、私は広く共有されたツイートを投稿し、DeepSeek の「英雄の旅」を紹介しました。そして今、その物語はさらに興味深くなりました。
他の人が密集したモデルを構築しようとしている間、DeepSeek はより難しい専門家ミックスモデル(MoE)を選択しました。
彼らは「ファーストプリンシプル」アプローチを採用し、当時の主流であるが実装コストが高い PPO 強化学習アルゴリズムを代替する新しい GRPO アルゴリズムを発明しました。
彼らは、検証済み報酬に基づく強化学習(RLVR)が、モデルの推論能力を向上させるための鍵となる戦略であることを発見しました。
彼らはさらに、「マルチトークン予測」(Multi Token Prediction)を通じて、簡単な予測デコーディング戦略を提案し、同時にトレーニングシグナルをより密にしました。
彼らは「ゼロバブル」(ZERO bubble)パイプラインを改良し、限られたGPUリソースの利用効率を向上させました。
彼らは、MoEモデルをより簡単に展開できるように専門家負荷分散器をリリースしました。特に、「広い専門家並列」(Wide Expert Parallel)戦略を通じて、モデルはより大きなバッチでサービスを提供できるため、推論コストを大幅に削減できます。
彼らは、KVキャッシュの需要を削減し、コンテキスト長さの増加に伴う計算ニーズができるだけ一定に近づくようにするために、MLA、DSA、CSA、HCAなどのメカニズムを考案しました。
彼らはエングラムを発明し、メモリを使用して計算効率を向上させました。
彼らはまた、mHCを発明し、モデルのスケーリング時にも安定したトレーニングを実現しました。同様の例は他にもたくさんあります。
最も一般的な物語構造である「英雄の旅」において、英雄は決して最初から自らの旅路がどこに通じるのかを決定することはありません。彼は途中で学びながら、徐々に自らの真の偉大な使命を見つけ、さまざまな妨げの中でそれを果たします。彼は多くの疑問を持つ者に出会いますが、それらを無視することを選択します。彼はまた、多くの悪意ある行動者に出会います。彼には明らかな欠点や弱点がありますが、最終的にはこれらの問題を克服し、自らの使命を果たします。彼は乗り越えるのが困難と思われる挑戦に直面しますが、同盟を見つけ方を見つけ、限られた貴重なリソースを賢く活用する方法を学びます。これが観客が英雄を応援したくなる理由です。これが、DeepSeek がフォロワーを獲得し、世界的な尊敬を獲得し、反対者を持つ理由でもあります。
私が以下で詳細に説明するように、DeepSeek はこの道を長い間歩んでおり、徐々に自らの究極の運命を見出しました:その目標は、プログラミングサブスクリプションプランを販売することではなく、中国のAIハードウェアエコシステムを1兆ドル規模に推進し、自己の企業価値を1兆ドルに達成することです。この過程で、西洋のハードウェアエコシステムに多くの新参者に機会を提供します。
いくつかの興味深いKVキャッシュ計算から始めましょう
最近の@SemiAnalysis_のタイムリーなツイートをご覧ください:
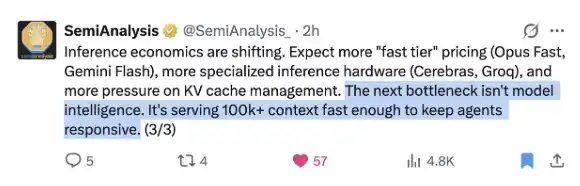
DeepSeek はこの問題を他の誰よりも上手く解決してきました!
まずは少し面白い KV キャッシュの計算をしてみましょう。数学が苦手でも大丈夫です。最近リリースされた KV キャッシュ計算機を使用して、DeepSeek V4 Pro がどれだけの KV キャッシュを節約できるかを見て、最新の GLM と Qwen モデルと比較してみましょう。
ここでは、100 万のコンテキスト長を使用して計算し、KV の精度を 8 ビット、インデクサの精度を 16 ビットと仮定しています。以下の計算機で試すこともできます:https://kvcache.ai/tools/kv-cache-calculator/
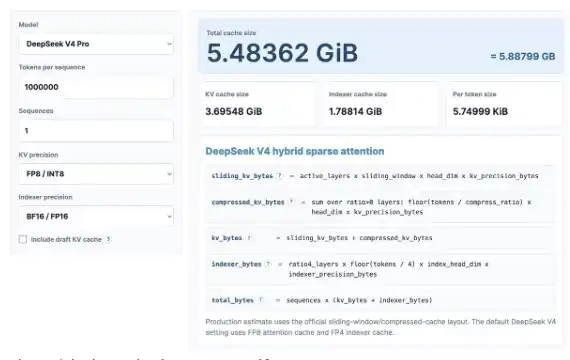
計算機で試してみることもできます!
100 万のコンテキスト長で:
・DeepSeek V4 は 5.48GB の HBM しか必要としません;
・GLM-5 は 60GB の HBM が必要です;
・Qwen3-235B-A22B は最大 89GB の HBM が必要です。
注意すべき点:
・DeepSeek は 1.6 兆のパラメータモデルです;
・GLM-5 は約 7000 億のパラメータを持ち、既に DeepSeek の MLA と DSA を採用していますが、最新の圧縮アテンションメカニズムはまだ使用されていません;
・Qwen3-235B-A22B は約 2350 億のパラメータを持ち、GQA アテンションメカニズムを採用しています。
DeepSeek はメモリー圧力の緩和において基本的な貢献をしています。このようなイノベーションが広く採用されると、長時間のエージェントの実行コストが大幅に削減され、新しいアプリケーションシナリオが開拓されるでしょう。
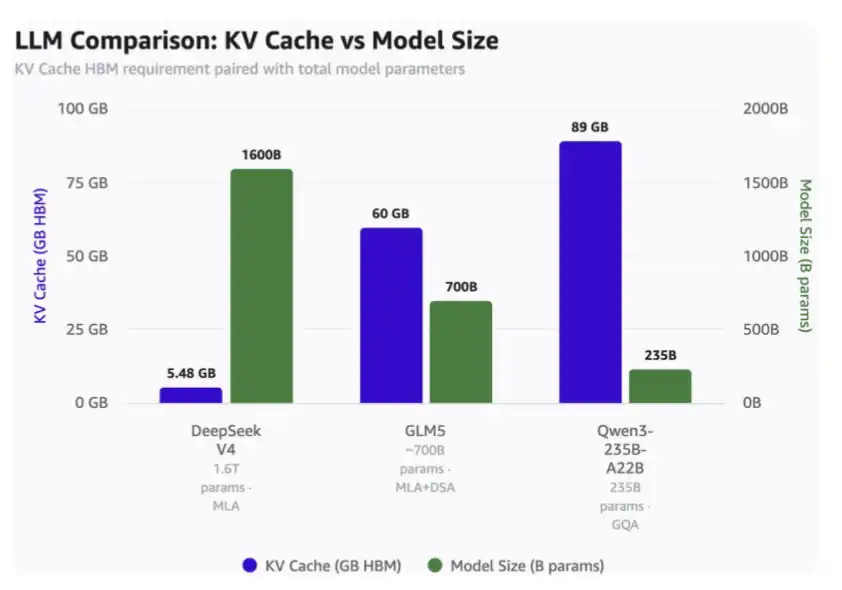
100 万 Token のコンテキストとモデル規模における KV キャッシュの比較
「狂気」の背後にある方法論
KV キャッシュのサイズがこれほど小さく、同時にモデルの品質を犠牲にしない理由は、DeepSeek が非常に低価格で長時間キャッシュを提供できるからです — その価格は Sonnet 4.6 キャッシュヒット価格の 3% にも満たず、しかも DeepSeek はキャッシュを数時間保持できます。
長期的タスクに対して、より小さな KV キャッシュは、それをより経済的に SSD にアンロードし、必要に応じて再ロードすることができることを意味します。これにより、HBM への依存が減少します。中国の AI ハードウェア産業の立場から見ると、HBM は供給が緊張しているだけでなく、最も製造が難しいメモリの1つです。
さらに、DeepSeek は、SSD からより速く KV キャッシュをロードする技術を開発しており、これはその Dual Path 論文で既に説明されています。
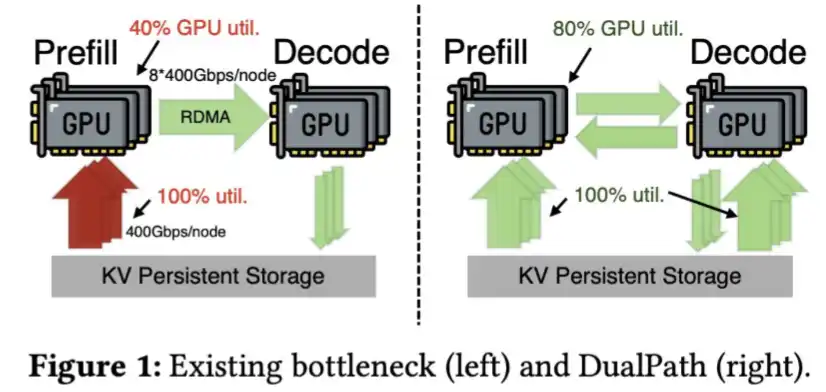
DeepSeek V4 は、KV キャッシュの圧縮率が非常に大きいため、このステップすら必要なくなる可能性さえあります。
では、KV キャッシュの圧縮の最も直接的な恩恵を受けるのは誰でしょうか?
SSD を大規模に供給しているのは誰でしょうか? YMTC(長江ストレージ)を忘れないでください。彼らは 3D NAND 分野で巨大な存在に成長しています。NAND は DeepSeek が KV を再計算するのを避けるのに役立ちます。その逆もまた然りで、DeepSeek は NAND と SSD に巨大な市場を作り出しました。これは長江ストレージだけでなく、他の関連企業も恩恵を受けさせるでしょう。
しかし、これは NAND と SSD にかかわる問題だけではありません。
LPDDR メモリにも巨大な潜在能力があります。それはモデルのウェイトを保存する場所として機能し、必要に応じてこれらのウェイトを HBM にストリーミング転送することで、HBM への需要圧力を緩和できます。SGLang チームは、この問題について素晴らしいブログを公開しています。以下の図は、この提案の動作原理を示しています。
DeepSeek はこの提案に特に設計を施してはいませんが、その MoE アーキテクチャ、多数のエキスパートモデルを保有していること、および 4 bit ウェイトの特性により、この提案の実装が容易になりました。
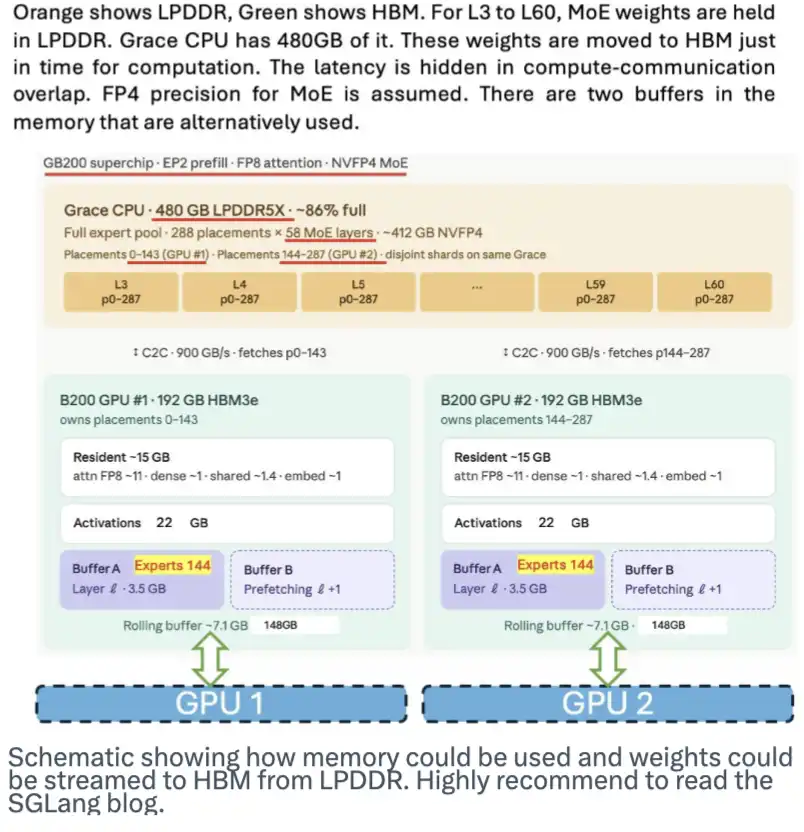
この図は、メモリがどのように使用され、モデルの重みが LPDDR から HBM にストリーム転送されるかを示しています。 SGLang のブログを読むことを強くお勧めします。
この革新が非常にコンパクトでかつロスのない KV キャッシュと組み合わされると、HBM への需要が大幅に低減します。
では、中国では誰が LPDDR を生産していますか? 答えは CXMT、つまり長鑫ストレージです。彼らは LPDDR の速度で約半世代、密度で1世代だけ遅れており、それほど大きな差はありません。
十分な NAND に加えて、中国の AI エコシステムは近い将来、十分な LPDDR 供給も手に入れるでしょう。これは計算能力のプレッシャーを和らげることができるでしょうか? 答えは:はい。以下を読み進めてください。
メモリのスマートな使用は、GPU / ASIC のプレッシャーも軽減できます
KV キャッシュを保存するために NAND を使用することの効果は実際には非常に理解しやすいものです:それにより、KV キャッシュを長く保持し、HBM に対するプレッシャーを軽減し、同時に重複計算を避けることで、GPU と ASIC の計算負荷を軽減できます。
それでは、LPDDR も同様の方法で機能することができるでしょうか?「必要に応じて即座に」重みを HBM にストリーミング転送するための場所としての役割だけでなく、さらに計算プレッシャーを軽減することができるのでしょうか?
答えは:はい。
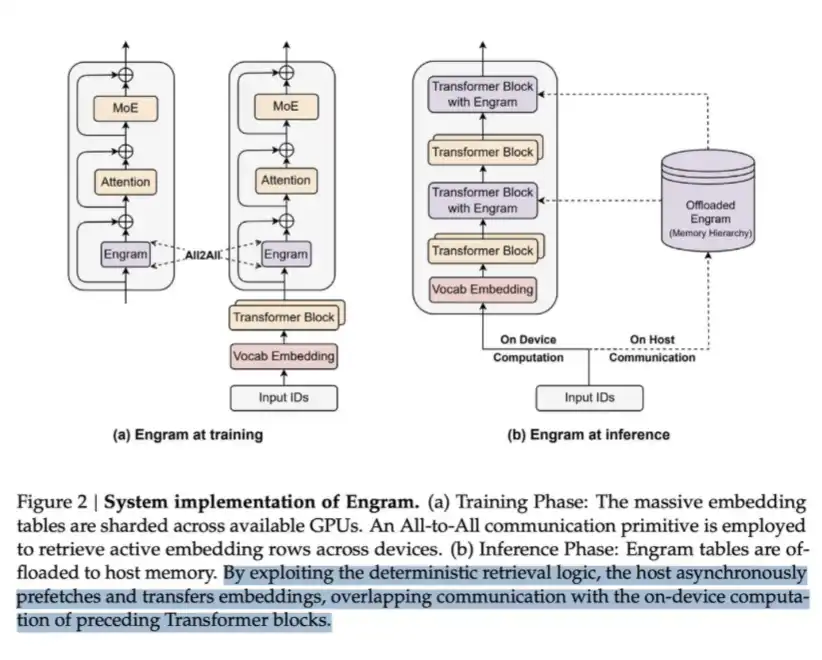
LPDDR は Engram と呼ばれる多くの内容を格納するために使用できます。DeepSeek の Engram 論文では、MoE が条件付き計算を使用してモデルの容量を拡張できると述べられていますが、Transformer 自体には「知識検索」のネイティブ機構が欠如しています。したがって、Transformer はしばしば、検索プロセスを低効率にシミュレートするために計算を使用しなければなりません。
この問題を解決するために、DeepSeek は Engram モジュールを提案しています。これは、従来の N-gram 埋め込みを現代化し、ハッシュベースの O(1) 検索メカニズムに改造して、条件付きメモリ(conditional memory)と呼ばれる補完的なスパース化パスを作成しました。
この方法は計算を節約できますが、埋め込みテーブルを保持するためにメモリが必要であり、そのテーブル自体が非常に大きい可能性があります。
基本的に、これは「メモリを使って計算を交換する」典型的な方法です。しかし、その重要な洞察は、ビットごとのデータ読み取りコストから見て、「メモリ」側がはるかに安価であるということです—LPDDR の一度の検索は、データを完全なトランスフォーマーの多層前向き計算を通過させるよりもはるかに安価です。したがって、大規模なシナリオでは、これは非常にコスト効果の高い取引です。
これが DeepSeek が一部のメモリを犠牲にして、計算を節約する方法です。
取捨する価値
同等水準のチップトランジスタ密度も EUV もないため、中国の GPU と ASIC は初期の FLOPs 計算力において、長期的には西洋の GPU に大きく遅れる可能性が高いです。さらに、彼らは先進的なパッケージングでも明らかな差をつけています。そのため、中国が NAND と LPDDR メモリを大量生産できるという前提において、このような取捨は非常に価値があります。
DeepSeek の長期戦略を振り返る
これらの革新から見ると、DeepSeek の目標は現時点で数十億ドルの利益を上げることではないようです。これまでの多くの選択肢は、この点を示しています:モーダルはまだ多様性がありませんし、音声モデルもなく、ビデオモデルはまったくありません。
DeepSeek が本当に取り組んでいるのは、忍耐強く、規模が最大で 10 兆ドルに達する可能性のある長期的なゲームです:代替の AI ハードウェアエコシステムの形成を推進することです。
これは、中国のメモリメーカーが中国や世界の AI ハードウェア市場で主要なプレイヤーになるためだけでなく、リソース要件を根本的に低減し、AI モデルのトレーニングとサービスをよりコスト効率に優れたものにすることを意味しています。これにより、多くの GPU、ASIC メーカー、およびネットワークチップメーカーが選択肢として浮上する可能性があります。
同時に、これらの革新は西洋のオープンソースエコシステムや新世代のハードウェアメーカーにも恩恵をもたらします。
すべての兆候は実際に出現しています。DeepSeek がこれまでに提示してきたこれらの革新を詳しく振り返ってみましょう:
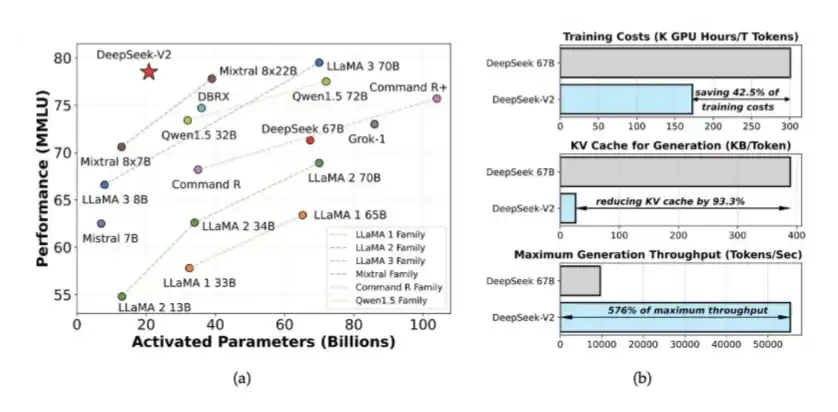
1、DeepSeek V2 で導入されたエキスパート混合モデル(MoE)と MLA
DeepSeek は V2 で MoE と MLA を導入しました。MoE により、高度なモデルのトレーニングに必要な計算量が約 40% から 50% 減少しました。MLA により、KV キャッシュを 90% 減少させることができました。
これにより、KV キャッシュを SSD にアンロードすることが非常に効率的になりました。
これらのアイデアは、最初に DeepSeek が2024年5月に発表した DeepSeek V2 論文で初めて見られました。その後、これらは DeepSeek V3 のトレーニングの基盤となりました。当時、DeepSeek は性能の低下した H800 GPU をわずか 2048 枚しか使用せずに、クローズドソースモデルとほぼ同等の性能を持つシステムをトレーニングしました。
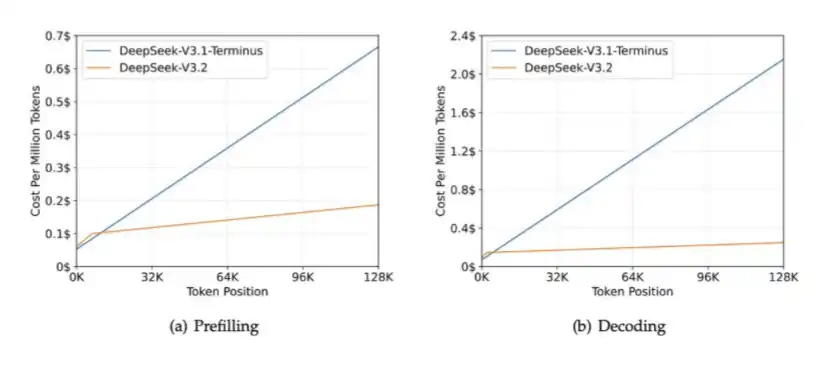
2、DSA:DeepSeek V3.2 Exp で導入され、長いコンテキストシナリオにおける計算コストを削減し、同時に HBM 帯域幅の負荷を軽減するためのものです。
DSA の主な役割は、コンテキスト長が増加しても計算量が持続的に増加しないことを保証することです。次のグラフを見るとわかります:コンテキスト長が増加するにつれて、DeepSeek-V3.2 の処理時間がほぼ一定に保たれています。
3、mHC:DeepSeek は 2025 年 12 月に論文「mHC: Manifold-Constrained Hyper-Connections」で提案されました。
mHC は、DeepSeek がマクロアーキテクチャレベルで行った革新であり、Transformer 層間の情報フローを再設計しています。
過去、ResNet から、モデルは通常、標準の残差接続、つまり x + F(x) を使用してきました。一方、mHC のアプローチは、残差フローを複数の並列情報チャネルに拡張し、モデルがこれらのチャネル間で学習可能な混合を行うことを許可します。重要な点は、それが混合行列を双対ランダム行列として制約し、それを Birkhoff 多面体に制限するために Sinkhorn-Knopp 投影を使用することです。これにより、数学的には、モデルをどれだけ深くスタックしても、シグナルの振幅が安定したままであることが保証されます。
これにより、以前の非制約 Hyper-Connections が直面していた壊滅的な不安定性の問題が解決されました。Hyper-Connections は元々バイトダンスによって提案されましたが、制約のない状態では、信号の増幅が 270 億パラメータの規模で 3000 倍に急増し、最終的にトレーニングが完全に崩壊しました。
mHC の計算コストは非常に低いです:実際のトレーニング時間に約 6.7% のオーバーヘッドしかもたらさず、それは注意層や FFN 層の FLOPs を変えるのではなく、これらの層の出力の層間ルーティング方法を変更しているだけです。
ただし、その性能向上は非常に顕著です:270 億のパラメータ規模で、mHC は BIG-Bench Hard 推論タスクで 7.2 ポイント、DROP で 3.2 ポイント、GSM8K 数学タスクで 2.8 ポイント、MMLU 汎用知識タスクで 1.4 ポイント向上させました。これらの向上はすべて、同じモデル規模、ほぼ同じ計算予算で達成されました。
本質的に、mHC はネットワークにより豊かで表現力豊かなクロスレイヤ情報ルーティングトポロジーを提供することにより、追加の FLOPs をほとんど増やさずに、より高い単位パラメータインテリジェンスを実現しています。
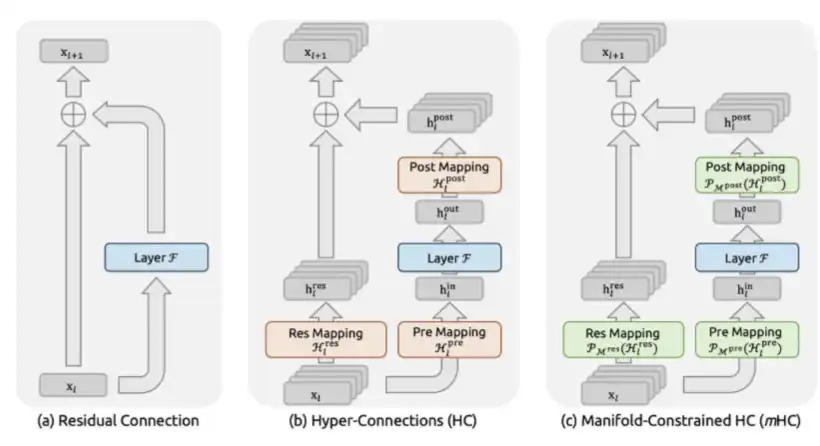
mHC は複雑なアーキテクチャ設計ですが、より安定したトレーニングプロセスと高い単位パラメータインテリジェンスをもたらすことができます。
4、CSA、HSA: DeepSeek は2026年4月のV4で導入されました。
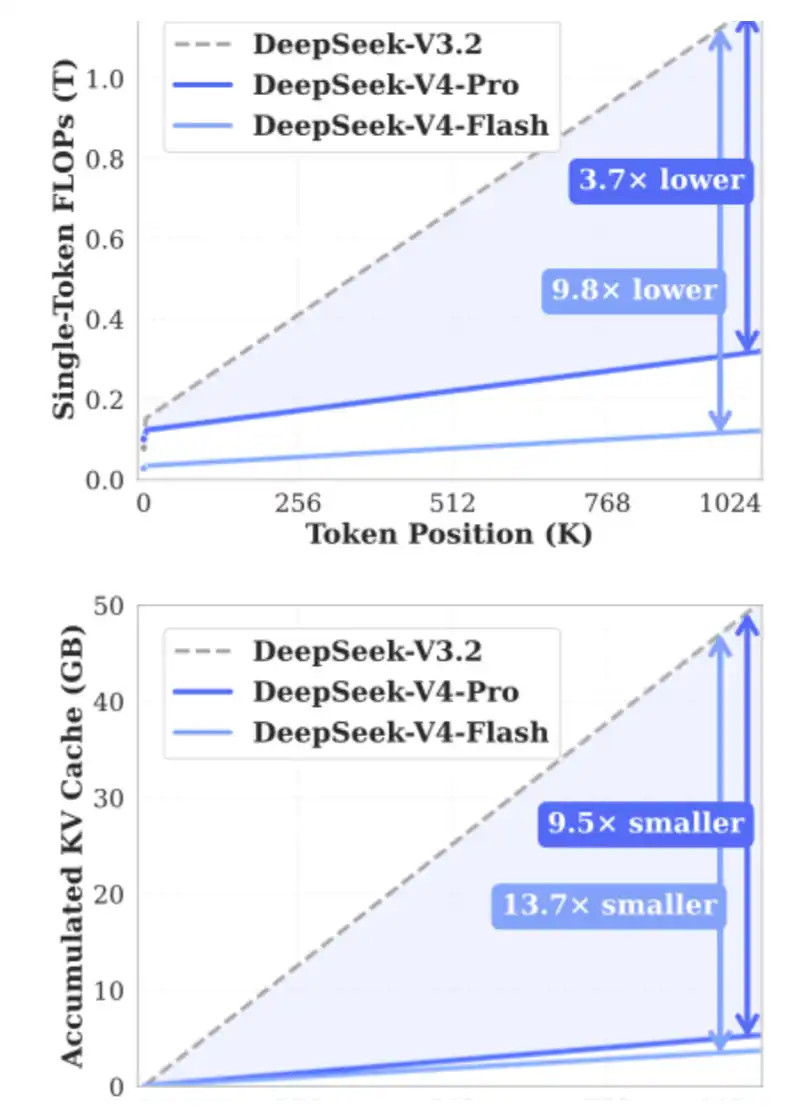
CSA と HSA の目標は、KV トークンを圧縮することで、KV キャッシュ要件を90%削減し、必要な FLOP 数を大幅に減らし、それによって HBM および GPU / ASIC の負荷を同時に緩和することです。
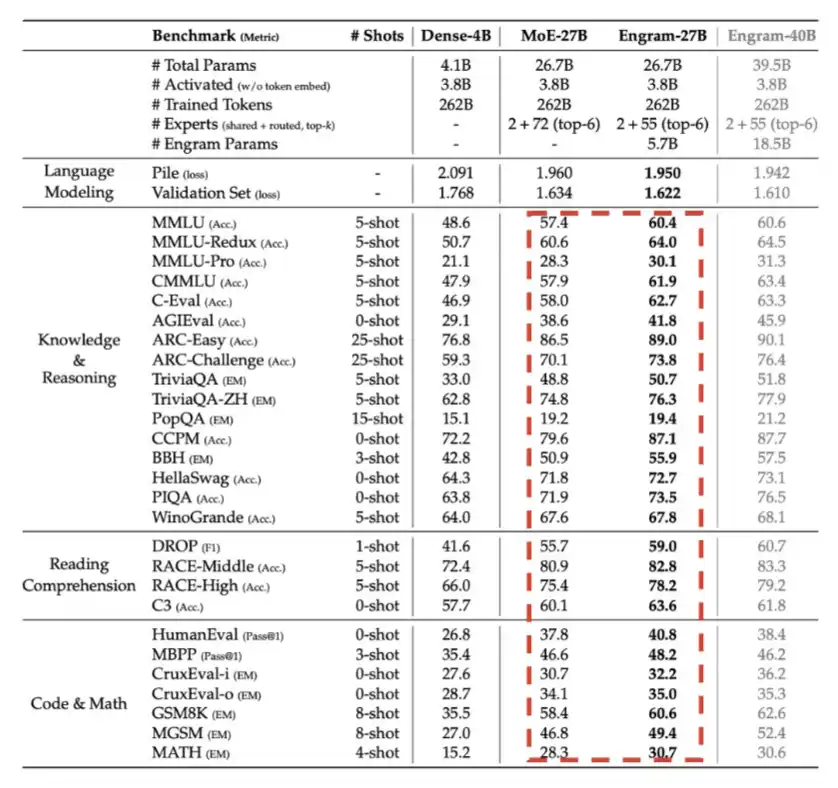
5、エングラム:DeepSeek は2026年第1四半期に導入され、本質的にはある種のメモリ、つまりLPDDRメモリをある程度使用して計算効率を犠牲にします。
以下の詳細なチャートに示すように、総パラメータ予算が同じ場合、エングラムは明らかなパフォーマンス向上をもたらしました。
6、エングラム:DeepSeek は2026年第1四半期に導入され、本質的にはある種のメモリ、つまりLPDDRメモリをある程度使用して計算効率を犠牲にします。
以下の詳細なチャートに示すように、総パラメータ予算が同じ場合、エングラムは明らかなパフォーマンス向上をもたらしました。
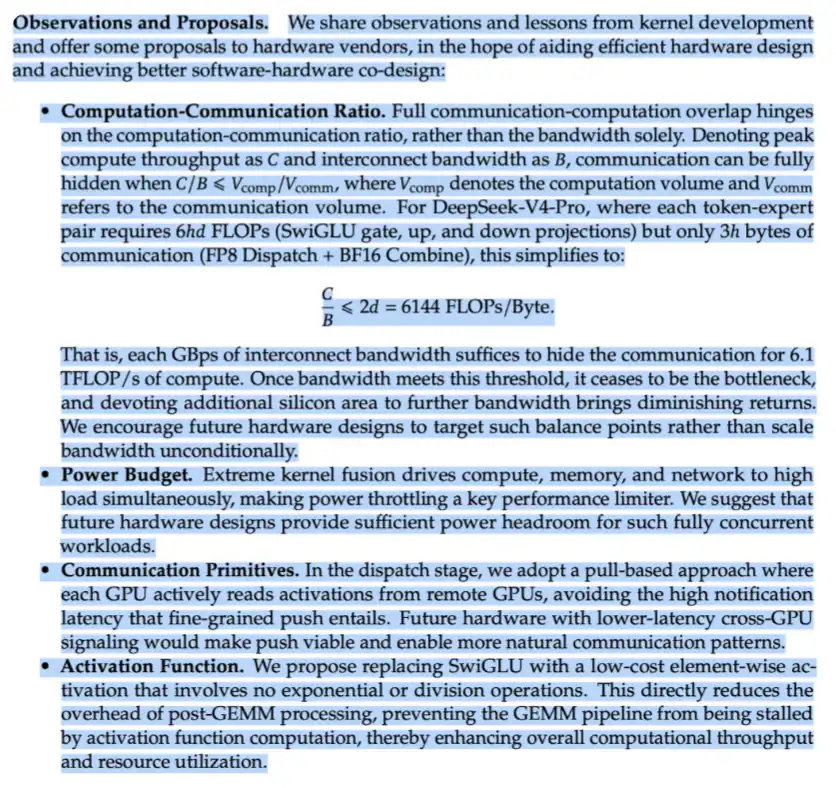
これは DeepSeek がV4論文でハードウェアメーカーに共有した提案です。私は、直接のフィードバックがさらに多くなるだけだと確信しています。
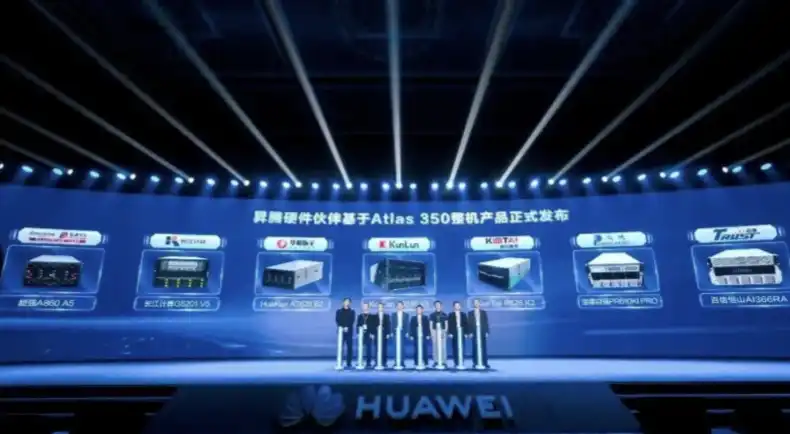
7、TileLang への投資も同じ方向を指しています:DeepSeek は自らの計算力のボトルネックだけでなく、中国のハードウェアエコシステムが西洋の生態系と競争する能力を持つことを推進しています。
TileLang を活用することで、開発者は1回だけカーネル、つまり計算用の基本コードを書き、その後、これらのプラットフォームが対応するTileLangバックエンドを持っている場合、複数のハードウェアプラットフォームで成功裏に実行できます。
私は、他の中国のAI研究所も次々と参加すると予想しています。これにより、中国のハードウェアメーカーはいわゆる「CUDAの城壁」に対処する手段を得るでしょう。また、これにより、AMDなどの西洋のハードウェアの可能性も引き出されるでしょう。
必ずしもTileLangが必要とは限りませんが、中国の多くの AI ハードウェアプラットフォームはすでに CUDA 互換性を提供しています。CUDA 互換性を実現するために CUDA トランスレーションレイヤーを利用している例として、摩尔線、沐曦、壁仞、そして天数智芯があります。したがって、理論上、それらは必ずしもTileLangが必要とは限りません。
大規模強化学習とRSI
DeepSeekがより多くの計算リソースを入手し、つまり選択肢が増えるにつれて、同時にモデル自体が計算リソースの要求量が低下すると、より野心的なトレーニングプロジェクト、特に強化学習後のトレーニングを進めることができます。
強化学習は大量のトラジェクトリを生成する必要があり、つまり数兆のトークンを生成する必要があります。このプロセスはすぐに非常に高価になります。さらに、100万のコンテキスト長のモデルをトレーニングするためには、同じ長さのトラジェクトを生成する必要があります。これほど長いトラジェクトでのモデルトレーニングのみが、本当に長い周期のタスクをサポートできます。
さらに、ハードウェアオプションが増えることで、DeepSeekがアクセスできるハードウェアリソースも増え、これにより自動化研究、つまりRSIが促進されます。RSIとは、AI自身が実験を設計し実行することを指します。このアプローチには多くの試行錯誤が伴い、コストも急速に上昇します。しかし、RSIは、モデル設計空間を完全に探索するために不可欠です。AGIに向かうため、さらにその後のASIに向かうためには、DeepSeekがRSI能力を備えている必要があります。
DeepSeekが今日行っていることは、すぐに業界全体に波及します
DeepSeekは、エキスパート混合モデル、MLA、DSAなどの分野に焦点を当てた革新により、世界中の他のAI研究所や中国の研究所からも採用され続けています。
たとえば、GLMシリーズモデルの開発者であるZAIは、MLAとDSAを使用しています。Kimi、つまりMoonshot、もMLAを採用しており、そのアーキテクチャはDeepSeekのアーキテクチャ設計に基づいていることを率直に表明しています。逆に、DeepSeekもMuonオプティマイザを使用しており、Muonは元々Kimi(Moonshot)が大規模トレーニングで採用していたものです。
必要な注意点:
MoEは、2017年にGoogleによって初めて提案され、主要な著者はNoam Shazeerです。DeepSeekの貢献は、MoEを大規模に適用し、独自の補完技術を発明したことにあります。
Muon 、つまり Newton-Schulz によって直交化されたモーメントを考慮した最適化器(MomentUm Orthogonalized by Newton-Schulz)は、機械学習研究者の Keller Jordan によって 2024 年末に提案されました。Kimi(Moonshot)チームは、これを大規模トレーニングに初めて導入したチームです。
お金を稼ぐ問題はどうしますか?
面白い例として、OpenAI を見てみることができます。
OpenAI は、AMD と Cerebras の株を低価格で購入するオプションを取得し、これらの権利は彼らの計算消費のマイルストーンに基づいています。AMD と Cerebras にとって、これは非常に収益性の高い取引でした。なぜなら、OpenAI が彼らのハードウェアを使用すると約束すると、成功の可能性が大幅に高まるからです。
AMD の声明には次のように記載されています:
「協定の一環として、両社の戦略的利益をさらに調整するために、AMD は OpenAI に、特定のマイルストーン達成に基づいて段階的に譲渡される、最大 1.6 億株の AMD 株式購入オプションを発行しました。最初の一括は、初期の 1 ギガワットのデプロイが完了した時点で譲渡され、その後の一括は、購入規模が 6 ギガワットに拡大するにつれて段階的に譲渡されます。譲渡条件には、AMD が特定の株価目標を達成し、また OpenAI が AMD の大規模展開に必要な技術およびビジネスのマイルストーンを達成することが含まれます。」
私は、DeepSeek が複数の中国のメモリ、ASIC、CPU、ネットワーク技術スタックメーカーと同様の取引をし、これらのメーカーと緊密に協力し、それらのハードウェアスタックが先進的な AI ワークロードを処理できるようにすると予想しています。
西洋、東アジアを含む全ての AI 株式の時価総額が既に 10 兆米ドルを超えていることを考えると、このような「協力による株式リターン」のアプローチは、DeepSeek に、中国が同様に巨大な産業を構築する手助けをする機会を提供し、自らの 1 兆米ドルの評価額を実現するチャンスを与えます。
これにより、DeepSeek は従来のアプリケーションサブスクリプションビジネスを大幅に凌駕する収益を上げるだけでなく、彼らが述べる 「AGI を普及させる」目標を達成することもできます。梁文锋は Jim Simons の熱心なファンであり、非常に賢い資本家です。彼はこの点を見逃すことはあり得ません。
DeepSeek がこれまでに行ってきたことを考えると、これが最も妥当な説明であると言えます。
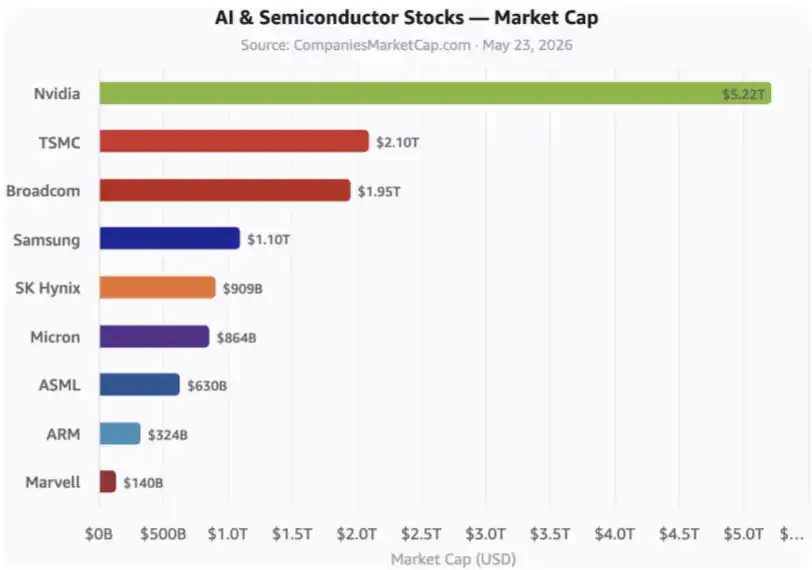
これらは主要な AI 関連株です。グラフにはまだ hyperscalers(大規模クラウドプロバイダ)やその他多くの関連企業が含まれていません。
BlockBeats の公式コミュニティに参加しよう:
Telegram 公式チャンネル:https://t.me/theblockbeats
Telegram 交流グループ:https://t.me/BlockBeats_App
Twitter 公式アカウント:https://twitter.com/BlockBeatsAsia
 関連記事