a16z:ビジュアルAIの未来は画像ではなく、コードにある
原文タイトル:The Next Frontier of Visual AI Is Code
原文著者:@stuffyokodraws、a16z
翻訳:Peggy
編集者注:ここ数年、ビジュアルAIの競争はほぼ一つの問いを中心に展開してきた。すなわち、誰がよりリアルな画像を生成し、誰がより滑らかな動画を生成するか、である。拡散モデルはテキストプロンプトを画像、動画、そしてリアルなシーンへと変換し、外部も「似ているか」「美しいか」という基準でモデルの能力を評価することに慣れてしまった。
しかし、a16zのこの記事は、ビジュアルAIの次の段階は、より美しいピクセルを生成することではなく、ピクセルの背後にあるコードアーティファクト(code artifact:編集、テスト、納品が可能な構造化ファイル)を生成することにあると指摘している。
この違いは一見技術的に見えるが、実際にはAIが本格的に生産ワークフローに参入できるかどうかを決定づける。デザイナーに必要なのは単なるUIのスクリーンショットではなく、HTML/CSS、Reactコンポーネント、レイヤー、そして納品可能なファイルである。アニメーターに必要なのは単なる動画ではなく、キーフレーム、タイムカーブ、そして修正可能なモーションパラメータである。3Dアーティストに必要なのは単なるレンダリング画像ではなく、ジオメトリ構造、マテリアル、ライト、カメラ、そしてシーンの階層である。
そのため、この記事はビジュアル生成を二つの経路に分類している。ピクセルネイティブ生成(画像や動画を直接生成)は、リアリティ、雰囲気、探索に適している。一方、コードネイティブ生成(SVG、Lottie、Blenderスクリプト、USDシーンなどを生成)は、編集、反復、生産に適している。後者が本当に重要なのは、「コード→レンダリング→確認→修正」というループを形成できる点にある。モデルは毎回ランダムサンプリングを繰り返すのではなく、検証可能なビジュアルプログラムをデバッグしているのである。
これこそが、著者が特に3Dに期待を寄せる理由でもある。なぜなら、椅子のレンダリング画像は椅子そのものではなく、単なる椅子の画像に過ぎないからだ。ゲーム、シミュレーター、3Dツールで実際に使用可能なアセットには、安定したジオメトリ構造、パーツの階層、マテリアル、機能的な制約が必要である。ドアは開き、引き出しはスライドし、車輪は回転しなければならない。言い換えれば、未来のビジュアルAIの価値は「見た目が似ているか」ではなく、「使い続けられるか」にある。
この記事は優れた判断の枠組みを提供している。第一波のビジュアルAIは生成の問題を解決し、次の波は生産の問題を解決する。ビジュアルAIが最終出力からソースコードへと向かうとき、本当に変わるのはデザインツールだけではなく、ビジュアルコンテンツの生産チェーン全体である。
以下が原文である:
ここ数年、ビジュアルAIはほとんど「ピクセル」で評価されてきた。最終的に生成された画像や動画が良く見えるほど、モデルが優れているように思えた。
これは不思議なことではない。拡散モデルはまずテキストプロンプトを美しい画像に変え、その後動画へ、さらにますますリアルな世界へと拡大してきた。人々は自然にこれをPhotoshopやカメラと比較するようになる。
しかし、グラフィックデザイン、UIデザイン、3Dモデリングなど多くのビジュアル関連タスクにおいて、ユーザーが本当に必要とする最終的な表現は、単に最終的に表示されるピクセルだけではない。彼らが必要とするのは、フィードバックや新しいアイデアに基づいて繰り返し改良できる成果物だ。デザイナーは単なるモックアップ(設計稿)だけでなく、レイヤー、コンポーネント、納品ファイルを必要とする。アニメーターは単なる動画だけでなく、タイムカーブ、キーフレーム、編集可能なモーションパスを必要とする。3Dアーティストは単なるレンダリング画像だけでなく、ジオメトリ構造、マテリアル、ライティング、カメラ、シーン構造を必要とする。
今日最も興味深いビジュアルAIツールは、もはや最終出力を直接生成しようとはしていない。それらは最終出力の背後にあるソースコードを生成し始めている。この変化は、編集可能性、反復能力、フィードバックループを解放しており、これらはピクセルネイティブモデルでは太刀打ちできないものだ。
ビジュアル生成の二つの技術スタック
ビジュアル生成を理解するには、主に二つの方法がある。
一つ目はピクセルネイティブ生成。この種のシステムは通常、画像や動画を直接生成し、しばしば潜在空間で行われる。テクスチャ、雰囲気、ライティング、リアリティに優れている。映画的なショット、美しいムードボード(moodboard)、または写真のようにリアルな画像を生成することが目的であれば、拡散モデルは依然として主流の手法である。
二つ目はコードネイティブ生成。この種のシステムは、別のエンジンによって実行またはレンダリングされる表現形式を生成する。モデルは最終的なピクセルを直接生成するのではなく、ピクセルを生成できるプログラムを生成する。
このプログラムは、SVGファイル、HTML/CSSレイアウト、Reactコンポーネント、Lottie JSONファイル、Blenderスクリプト、USDシーングラフ、シェーダー(shader)、またはゲームエンジンシーンであり得る。最終的なビジュアル出力は依然としてピクセルだが、真の「事実の源泉」は構造化された表現である。
この違いは重要である。なぜなら、制作ワークフローは「生成後に何が起こるか」を非常に重視するからだ。生成された画像は出力として使用できるが、生成されたビジュアルプログラムは成果物として使用できる。編集、再利用、改良、バージョン管理が可能であり、ソフトウェア技術スタックに統合し、制約に基づいて検証できる。異なる条件下で繰り返しレンダリングでき、デザイナー、エンジニア、エージェント間で引き継ぐこともできる。
重要な転換がすでに起きていると考える。一部のビジュアル問題において、私たちは視覚生成タスクを符号化タスクとして再定義し、境界が明確で検証可能な符号化問題を解決することで、非常に効率的な改善を実現することを学ぶだろう。
コードはビジュアル問題を解決する優れた媒体である
ビジュアルコード生成の価値を最も簡単に理解する方法は、初稿の後に何が起こるかを見ることだ。
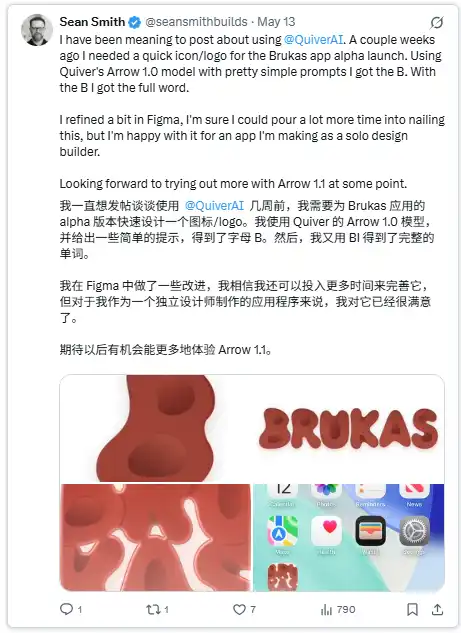
モデルがロゴを生成したと仮定しよう。出力がラスター画像で、その中の曲線が一つ間違っている場合、ユーザーはマスク、部分再生成、再生成、または手動で描き直す必要がある。しかし、出力がSVGであれば、ユーザーはパス、基本図形、グラデーション、ストローク、テキスト要素を直接編集できる。これはすでにデザイナーがQuiverでロゴをデザインする方法である。
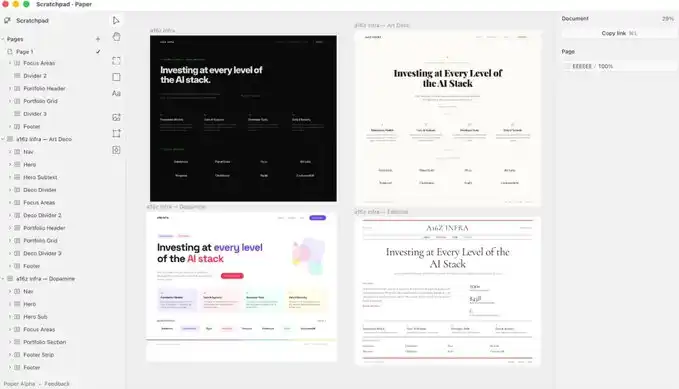
UIデザインの分野では、出力がスクリーンショットであれば、それは主にインスピレーションの参考に過ぎない。しかし、出力がHTML/CSSやReactであれば、デザイナーはDOMを検査し、実際のコンポーネントを置き換え、レスポンシブ状態をテストし、アクセシビリティを確認し、アプリケーションに組み込むことができる。
これこそが、ビジュアルコード生成が特にtest-time compute(テスト時計算)に適している理由である。ピクセルネイティブ生成では、推論計算を増やすことは通常、より多くの出力をサンプリングすることを意味する:20枚の画像を生成し、最良のものを選び、場合によってはもう一度試す。これは確かに有用だが、各試行は本質的にはサイコロを振り直すようなものだ。モデルはフィードバックに応答できるが、そのフィードバックは通常、全体的で正確ではない。
技術的には、拡散モデルもtest-time computeの恩恵を受けることができる。例えば、『Inference-time Scaling of Diffusion Models through Classical Search』は、推論段階での探索が拡散モデルの計画、強化学習、画像生成におけるパフォーマンスを改善できることを示している。しかし、ここでのループメカニズムは異なる。拡散モデルでは、システムは通常、潜在軌跡や最終サンプル間で探索する。報酬信号はモデルに、ある出力が別の出力より優れていることを伝えることができるが、そのフィードバックをソースコードレベルの具体的な修正に明確にマッピングすることはできない。
コードネイティブ生成は、より正確なループを生み出す:コード → レンダリング → 検査 → 修正。
モデルは成果物を生成し、それをレンダリングし、どこが問題かを観察し、ソースファイルを修正する。間隔が正しくなければCSSを修正し、ロゴの曲線がずれていればSVGパスを編集し、アニメーションのテンポが遅すぎれば時間パラメータを調整する。重要なのは、各反復がレンダリングされた出力だけでなく、基盤となる成果物を改善することだ。これこそが、ビジュアルコード生成がより多くのトークン生成とtest-time computeから自然に恩恵を受ける理由である。モデルは、閉じた検証可能な環境でビジュアルプログラムをデバッグしており、単により多くの画像をサンプリングしているわけではない。
コード中心のビジュアル生成技術スタック
上記の例の背後には、次のような技術スタックがあります:エンコーディングモデル + シンボリック表現 + レンダラーまたはエンジン。
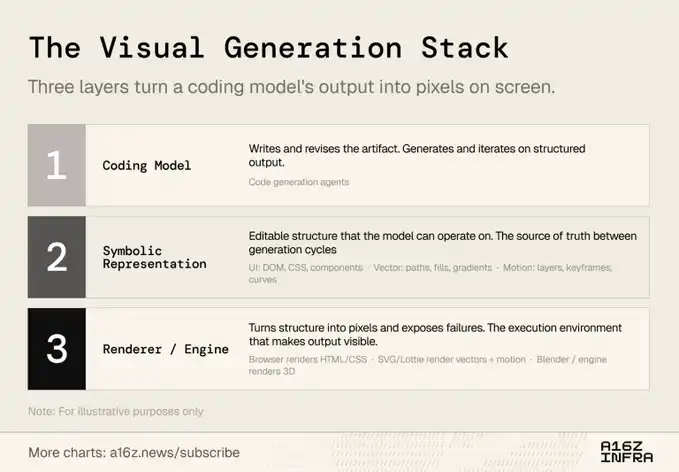
エンコーディングモデルは、成果物の作成者兼編集者です。HTML、SVG、Lottie JSON、Blenderスクリプト、USDシーン、またはカスタム3Dアセットプログラムを記述します。
シンボリック表現は事実の源泉です。これこそが成果物に編集可能性をもたらす理由です。UIにはDOMノード、レイアウトルール、コンポーネントがあります。Lottieアニメーションにはレイヤー、ベクターシェイプ、タイムカーブ、キーフレーム、モーションパラメータがあります。3Dアセットにはジオメトリ構造、マテリアル、ジョイント、制約、階層関係があります。
レンダラーまたはエンジンは、これらの構造をピクセルに変換します。ブラウザはHTML/CSSをレンダリングし、SVGレンダラーはベクターグラフィックを、Lottieプレイヤーはアニメーションを、Blenderやゲームエンジンは3Dシーンをレンダリングし、シミュレーターはジョイント付きアセットが実際に動いたりインタラクションできるかを検証します。
OmniLottieは、シンボリック表現がなぜ重要かを示す良い例です。Lottieは軽量でJSONベースのアニメーションフォーマットであり、アニメーションをフラットな動画として表現するのではなく、編集可能なベクターシェイプ、レイヤー、キーフレーム、時間パラメータで動きを表現します。OmniLottieは、元のLottie JSONをモデルが理解しやすいコマンドシーケンスに変換し、モデルがLottieアニメーションをより確実に生成・編集できるようにします。この論文の焦点は完全なAgentループを構築することではなく、Lottieをモデル生成に適したものにすることです:元のLottie JSONをコンパクトなコマンドとパラメータのシーケンスに変換します。この動作は重要です。なぜなら、Lottie自体がすでに編集可能なアニメーションフォーマットだからです。動きがシェイプ、レイヤー、時間、アニメーションパラメータとして表現されると、フィードバックをソースファイルレベルの変更にマッピングできます。オブジェクトの動きが遅すぎる場合は時間を調整し、パスが間違っている場合はベクターを修正し、変形にずれがある場合はシェイプシーケンスを更新します。
この技術スタックは、エンコーディングAgentが出力品質を向上させるために使用できるtest-time computeループに対応しています:「コード → レンダリング → チェック → 修正」の各サイクルにおいて、モデルは新しいサンプルを生成するのではなく、レンダラーからのフィードバックを活用して基礎となる成果物を改善します。CSSルールを修正し、SVGパスを調整し、アニメーション時間を修正し、3D制約を更新してから再レンダリングし、さらに改善を続けることができます。
これにより、ループが収束する可能性が生まれます。ピクセルネイティブ生成では、再試行のたびに新しい出力が生成されることが多いですが、コードネイティブ生成では、再試行のたびにソースアーティファクト自体を改善できます。モデルは単により多くの画像や動画をサンプリングするのではなく、閉じたループでレンダリング可能な環境内でビジュアルプログラムをデバッグします。
マーケットマップ:ランタイムを中心としたエントリーポイントの形成
ビジュアルコード生成市場は、「ランタイム」、つまりアーティファクトがレンダリングまたは実行される場所を中心に組織化されつつあります。コードネイティブビジュアル生成では、モデルはシンボリックなアーティファクトを生成し、それがブラウザ、SVGレンダラー、Lottieプレイヤー、Blender、ゲームエンジン、シミュレーターなどの環境で実行されます。
各ランタイムは異なるエントリーポイントを形成します。なぜなら、各ランタイムには独自のソース表現、フィードバックループ、プロダクションワークフローがあるからです。
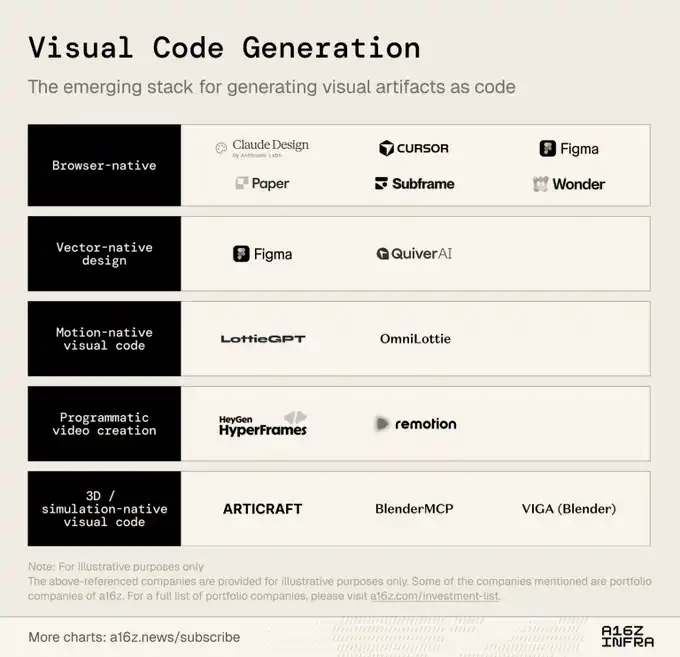
今日最も顕著な応用は2Dデザイン分野、特にUIデザインとグラフィックデザインです。しかし、ビジュアルコード生成はデザインツールに限定されません。ビジュアルアーティファクトの背後に、生成、レンダリング、検査、最適化が可能な基盤となる表現が存在する限り、どこにでも現れる可能性があります。
なぜ3Dが次の重要なフロンティアなのか
プロダクトデザインや2Dデザインが今日最も直感的なユースケースですが、3Dアーティファクトは「一貫性の問題をコーディング問題として再定義する」このアプローチから最も恩恵を受ける可能性があります。
2Dデザインは、見た目が正しければそれで役立つことがあります。しかし、3Dアセットはそうではありません。椅子のレンダリング画像は椅子ではなく、単なる椅子の画像です。このアセットをゲーム、シミュレーター、3D編集ツールで実際に使用可能にするには、正しいジオメトリ、マテリアル、パーツ階層、シーンコンテキストを含む、一貫性のある基盤となる3D表現が必要です。
これこそが、3Dがビジュアルコード生成に自然に適している理由です。その価値は、特定の角度から3Dに見えるものを生成することではなく、異なる視点、編集、インタラクションでも成立する一貫した3D構造を生成することにあります。これには反復ループが必要です:オブジェクトを提案し、レンダリングし、ジオメトリとパーツが妥当かどうかを確認し、基盤となる表現を修正する。しかし、このループはエージェントが適切なツールとコンテキストを持っている場合にのみ機能します。単にBlenderを何度も実行して、何かがより良く見えるまで待つだけでは不十分です。エージェントはカメラ視点を切り替え、シーンの状態をクエリし、オブジェクトを分離し、ターゲットと比較し、以前の試行を記憶し、視覚的な差異をソースファイルレベルの変更に変換できる必要があります。これらの能力こそが、test-time computeを収束へと導く可能性を秘めています。
多くのアセットにとって、視覚的な一貫性は最低条件に過ぎない。オブジェクトには、適切なパーツのセマンティクスと機能的な制約も必要だ。ドアは開き、ヒンジは回転し、引き出しはスライドし、ホイールは回転する必要がある。言い換えれば、出力は単に見た目が合理的な形状であるだけでなく、それが表すものとして機能しなければならない。
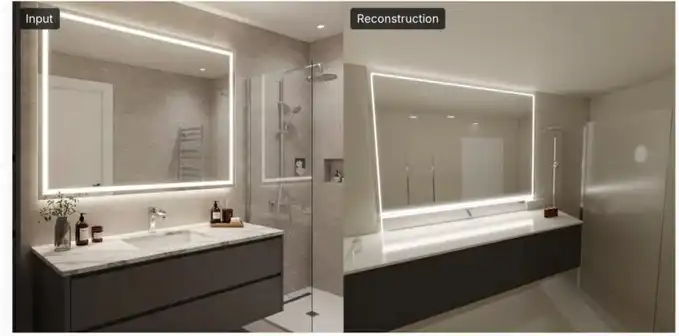
まさにこれこそが、VIGAやArticraft3Dといったプロジェクトが注目される理由だ。今年はさらに多くの関連研究が登場すると予想しており、商業プロジェクトやオープンソースプロジェクトも含まれるだろう。VIGAはBlenderをレンダリングとフィードバック環境として使用し、視覚的な再構築を「コード→レンダリング→チェック」のサイクルに変換する。しかしVIGAは、単に生のBlenderをエージェントループに公開するわけではない。エージェントに観察と修正のためのセマンティックツールを提供し、過去の試行の記憶を保持することで、より良い視点からオブジェクトを検査し、問題を診断し、的を絞った修正を行えるようにする。一方、Articraft3Dはアセット構造をより直接的に扱う。関節付き3D生成を、パーツ、ジオメトリ、ジョイント、テストを定義するプログラムの作成として定義する。
将来の影響と未解決の問題
もしビジュアルコード生成が本当に成立するなら、最終的に勝ち残るプロダクトは、より美しい出力を生成するだけではない。それらはサイクル全体を掌握する。すなわち、アーティファクトを生成し、レンダリングし、問題箇所を検査し、ソースファイルを修正する。
これにはいくつかの影響がある。
第一に、レンダラーがフィードバック環境となる。ブラウザ、SVGレンダラー、Lottieプレイヤー、Blender、ゲームエンジン、シミュレーターは、今日のコーディングエージェントがサンドボックスや仮想マシンを活用しているように、エージェントが作品をテストし改善する環境となる。
第二に、反復コンテキストの品質がこれまで以上に重要になる。エージェントがビジュアルコード版の「Ralphループ」に入るためには、中間表現が次のアクションを導くのに十分な精度を持たなければならない。モデルは「何かがおかしい」と知るだけでなく、ソースファイルのどの部分をなぜ修正すべきかを理解する必要がある。構造、レンダリング、フィードバックの小さなエラーは、複数回の反復で急速に蓄積される可能性がある。
第三に、将来はハイブリッドになる可能性が高い。ピクセルネイティブモデルは、リアリズム、テクスチャ、探索に最も適している。コードネイティブシステムは、構造、反復、プロダクションに適している。最も有用なワークフローは、これらを組み合わせるだろう。
もちろん、多くの未解決の問題もある。各分野で最終的にどの表現が採用されるのか? 前世代のツールを使い続けるのではなく、エンジンやレンダラーを再構築する必要があるのか? 視覚的なセンスは、どの程度まで制約、テスト、フィードバックループで捉えられるのか?
しかし、方向性は明確だ:ビジュアルAIは出力からコード成果物へと移行している。第一の波は画像生成を容易にしたが、次の波は編集可能で、テスト可能で、納品可能で、改善可能なビジュアル成果物の生成を容易にするだろう。
[原文リンク]
BlockBeats の公式コミュニティに参加しよう:
Telegram 公式チャンネル:https://t.me/theblockbeats
Telegram 交流グループ:https://t.me/BlockBeats_App
Twitter 公式アカウント:https://twitter.com/BlockBeatsAsia
 関連記事