Metaが計算リソースを売り、Palantirが不満を爆発させ、智譜がシリコンバレーのトップスターに。AIキャピタル支出のストーリーは、語り口を変える時が来た。
執筆:漲声 Beatz
AI相場が再び急落した。今回は、Metaが余剰のAI計算能力を販売する可能性があると述べたことが原因だ。
このニュースが3年前であれば、誰も不思議に思わなかっただろう。クラウドコンピューティングは元々、サーバーを細かく分割して他社に販売するビジネスだ。Amazon、Microsoft、Googleは何年もこれを続けてきた。CoreWeaveやNebiusといった新興クラウド企業も、この道でNVIDIAのチップを融資の担保に変え、その資金でさらに多くのチップを調達している。
しかし、Metaとなると話は別だ。
Metaはこれまで、計算能力をそのように捉えてこなかった。同社はチップを購入し、データセンターを建設し、電力と土地を確保してきた。それは自社のモデル、広告システム、レコメンド配信、そしてザッカーバーグが口にする「ますます近づくスーパーインテリジェンス」のためだ。Metaはクラウド企業ではない。元々、マシンを他社に貸し出して利益を得るビジネスではなかった。
ある企業が以前、「将来、これらすべてを消費するため、可能な限り多くのマシンが必要だ」と述べていた。今、その企業は「これらのマシンが一時的に余るなら、他社に販売しても構わない」と言っている。
これは計算能力の過剰を直接示すものではないが、軽く見逃せる話でもない。
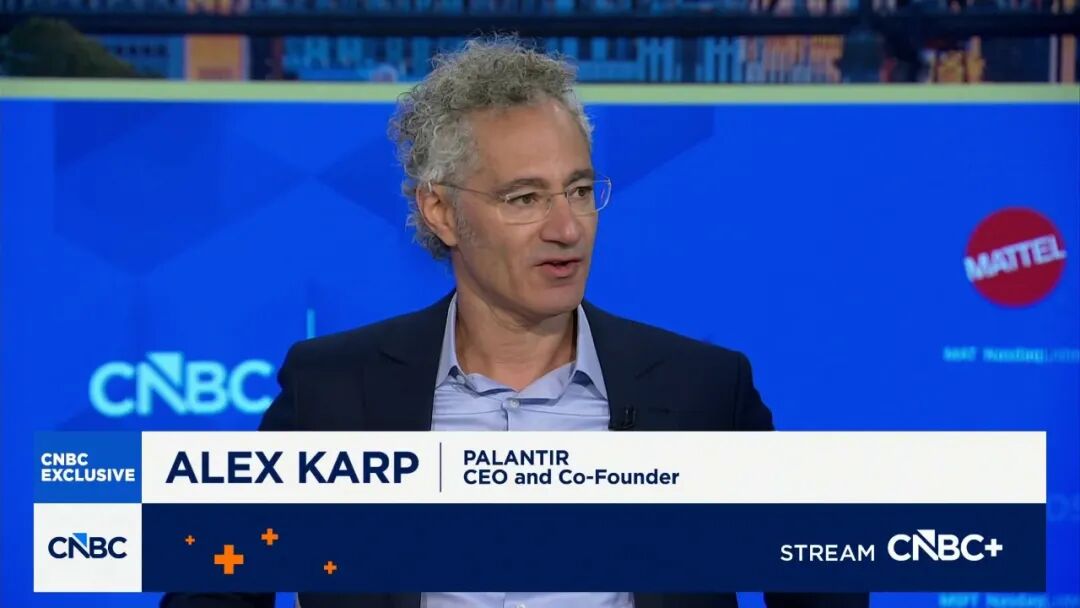
株式市場が暴落した当日、PalantirのCEOアレックス・カープはCNBCのインタビュー番組で、カメラに向かって約20分間怒りをぶちまけた。
彼は本来、PalantirとNVIDIAの新たな提携について話す予定だったが、すぐに話題はOpenAIやAnthropicのトークン課金モデルに移った。彼は、CEOたちが「価値を生まないトークンに金を払い、さらに自社のデータを差し出している」と私下で不満を漏らしていると述べた。さらに、高騰するモデル利用料を、企業に課せられた富裕税と呼んだ。
過去2年間、議論の中心は「誰が大胆に資金を使うか」「誰が速く使うか」「誰が先にデータセンターを積み上げるか」だった。今、問題は徐々に変わってきている。マシンを購入した後、誰がそれらを常にフル稼働させ続けられるか、という点だ。
Metaのこの発言は、まだ正式な事業として具体化していない。公開報道によると、社内には「Meta Compute」という方向性があり、生の計算能力を販売する可能性もあれば、Amazon Bedrockのように異なるモデルを自社のインフラ上で提供し、開発者に販売する可能性もある。ザッカーバーグは以前の株主総会で、外部企業からほぼ毎週、APIサービスや計算能力の一部を購入したいとの問い合わせがあり、Metaのコストを上回る価格を提示する用意があると述べていた。
彼はその時、こう付け加えていた。まだそこまではやっていない、なぜならMetaはまだこれらの計算リソースを自社で活用できると考えているからだ、と。
活用できるのであれば、貸し出しは選択肢の一つだ。活用できないのであれば、貸し出しはバランスシートの痛み止めに過ぎない。
判断が最も難しいのはまさにこの点だ。Metaは単に建設のペースの中で一時的な隙間を作り、空いたリソースを一時的に売りに出しているだけかもしれない。あるいは、投資家に対して、1000億ドル規模のAI支出を遠い未来のスーパーインテリジェンスだけで支え続けることはできず、まずはより近い収益源を見つけなければならないと伝えている可能性もある。
どちらの解釈も成り立つ。
需要は消えていない、ただ選別が始まっただけ
CapexはAIストーリーの中核であり、それ以外にはない。2021年の金融緩和と同様に、Capexの予想は常に成長し続け、緩和が続く限り、市場で取引されるすべてのセクターが一緒に上昇する。Metaが計算リソースの販売を準備していると聞いて、多くの人がまず思うのは、AIのCapexが崩壊するのではないかということだ。大企業がついに買いすぎを認め、半導体の盛宴が終わる時が来たと。
そう言うのはあまりに安易だ。
公開データはまだ、それほど単純な結論を支持していない。AWSの第1四半期の収益は28%増の376億ドルとなり、ここ数年では珍しい急成長を記録した。Google Cloudの第1四半期の成長はさらに急で、収益は200億ドルに達した。Microsoft Azureも依然として約40%の成長率で推移している。
アマゾンは今年の設備投資が2000億ドルに達する可能性があると述べており、Alphabetは2026年の設備投資ガイダンスを1800億~1900億ドルに引き上げ、Meta自身も年間設備投資を1250億~1450億ドルに引き上げた。
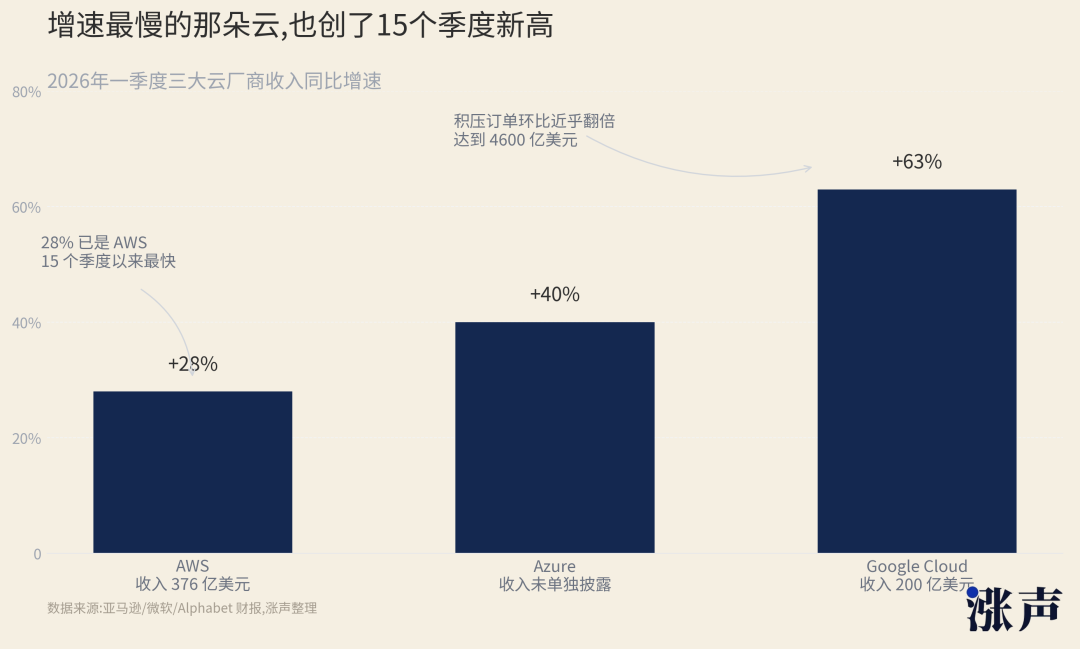
これらの数字は需要の崩壊を示してはいない。
むしろ、需要の分流を示しているように見える。
クラウド事業者の状況はモデル事業者とは異なる。クラウド事業者が売っているのは「道」だ。その道を誰かが走っている限り、車が誰のものであろうと、彼らは料金を徴収できる。OpenAI、Anthropic、エンタープライズ顧客、政府顧客、スタートアップ——最終的には、すべてがどこかのデータセンター、どこかのチップ、どこかのネットワーク、どこかの電力契約に落ち着く。
だからこそ、三大クラウドは強気を維持できる。
AWSは6月末に、あるAIクラウドサービスの価格を引き上げた。これは顧客がGPUを事前に確保するためのサービスで、AWSはこのサービスの7月からの価格をさらに約20%引き上げた。1月にもすでに約15%の値上げを行っている。これは需要が弱い時に見られる動きではない。
希少性が高まると、売り手は価格を引き上げる。
しかし、モデル企業がすべて同じように楽観視できるわけではない。
モデル企業の資産はより厳選される必要がある。計算能力(算力)は、ただそこに置いてあるだけで収益を生むわけではない。それは、より賢いモデル、より高頻度のユーザー、より高価なエンタープライズワークフローによって絶えず満たされなければならない。モデルが十分に優れている場合にのみ、ユーザーは待ち行列、制限、値上げ、そしてますます複雑化するサブスクリプション階層を我慢する。
これこそが、Anthropic が市場で別の種類の企業と見なされる理由でもある。それは安価だからではなく、ユーザーが高コストなタスクを任せたいからだ。コードを書く、システムを改修する、長時間のタスクを実行する、エンタープライズワークフローに接続する——これらのタスクが実際に本番環境に入ると、消費されるトークンは雑談よりもはるかに多くなる。
強力なモデルの悩みは、マシンが足りないことだ。
弱いモデルの悩みは、マシンを誰も気にかけないことだ。
これらの悩みはどちらも「計算能力(算力)」と呼ばれるが、同じものではない。
xAI のラインにも同じような匂いがある。Grok は最強のモデルのように明確なエンタープライズマインドを形成していないが、マスク体制内の一部の計算能力は Anthropic に流れる可能性がある。この動きは、どんなスローガンよりも冷静だ。マシンは創業者を認識しない。誰がそれをフル稼働させられるかだけを認識する。
Google と Meta の関係も、事態がそれほど単純ではないことを示している。6月には、Google が Meta による Gemini の使用を制限したとの報道があった。その理由は、Meta が購入しようとした計算能力が Google の提供範囲を超え、Meta 内部の一部の AI プロジェクトにまで影響を及ぼしたからだ。ある企業は、一方で計算能力の販売を検討しながら、他方で特定のタスクにおいて十分なトップクラスのモデル能力を購入できない状況にある。
これは従来の意味での過剰供給ではない。
これはミスマッチだ。なぜなら、請求書が目に痛くなり始めているからだ。
クラウドベンダーは値上げを続けられる。なぜなら、彼らが売っているのは確実性だからだ。顧客が求めるのは、一定期間内に確実に入手できる GPU、安定したデータセンター、夜中に突然落ちないインフラストラクチャだ。
しかし、エンタープライズ顧客が計算能力を手に入れた後も、問題は終わらない。
彼らはその請求書を CFO に提出しなければならない。CFO はあなたが何トークン使ったかは尋ねない。彼は、それらのトークンが会社のためにいくら節約したか、いくら多く稼いだか、どれだけミスを減らしたかを尋ねる。
企業にとって、トークンは電力量計になる
これで冒頭のカープのインタビューに話が戻る。
彼は、多くのAI企業が企業向けに販売しているものを過剰販売だと評した。番組出演の前日、PalantirはX上で「AI主権」と題した9項目の声明を発表し、その中で特に「tokenmaxxing」というモデルを槍玉に挙げた。この言葉は翻訳が難しく、直訳すると耳障りだが、意味自体は複雑ではない。つまり、トークン消費を進歩と見なし、資金を燃やすことを利用と見なし、請求書を生産性と見なすことだ。
カープはOpenAIやAnthropicといった最先端の研究所をテーブルに引きずり出した。彼の言いたいのは、企業が最高のモデルを使うべきではないということではなく、企業が自らのデータ、プロセス、ビジネス判断をすべて委ね、その上で消費量に応じて増え続ける請求書を支払うべきではないということだ。
Palantirが売りたいのは別のものだ。汎用的なチャットボックスでも、単一のAPIでもなく、データ、承認、権限、運用ルール、そしてAIをすべて同じ業務システムに組み込むことだ。顧客が金を払うのは「AIを何回使ったか」ではなく、ある生産ライン、あるリスク管理プロセス、ある政府のタスクが本当に変革されたかどうかだ。
企業で実際に予算を握る人々は、目を覚まし始めている。
UBSが最近企業のIT幹部と行った対話から、一つの方向性が明確になった。多くの企業はAIを使わなくなったわけではなく、AIへの支出にブレーキをかけ始めているのだ。回答企業の約60%がトークン支出を抑制し、利用にガードレールを設けている。特に、試用期間を終え、AIを日常業務に組み込み始めた企業でその傾向が顕著だ。
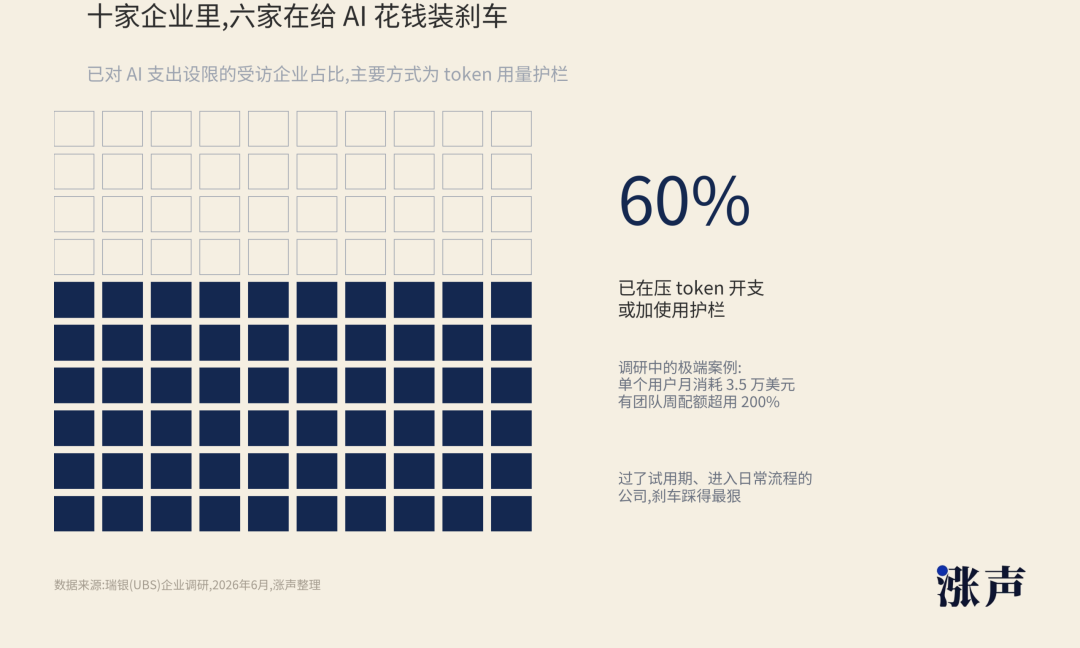
これも非常に興味深い逆転現象だ。
AIが「おもちゃ」から「道具」に変わると、むしろお金を使うのが難しくなる。おもちゃの段階では、経営者は予算を出したがる。誰もが乗り遅れるのを恐れるからだ。道具の段階になると、CFOは「誰の工数を削減したのか」「誰の売上を増やしたのか」「誰のリスクを低減したのか」と問う。
この表において、トークンは収入のようには見えない。
むしろ、電気メーターに似ている。
もちろん、電気メーターが速く回るのは工場が稼働している証拠だと言える。また、電気メーターが速く回っているのに生産量が上がっていなければ、その機械に問題があるとも言える。
AIエージェントはこの問題を拡大した。OpenAIと数大学によるCodexの研究には、驚くべきデータがある。2026年前半、Codexのアクティブユーザーは5倍以上に増加。OpenAI内部の一部のポジションでは出力トークンが急増し、法務部門の月間出力トークン中央値は2025年11月比で13倍、研究部門では50倍以上に達した。
別の研究では、さらに踏み込んだ内容が示されている。エージェンティックコーディングタスクで消費されるトークンは、通常のコードチャットやコード推論と比べて最大1000倍に達する可能性がある。同じタスクでも、実行ごとのトークン消費量に最大30倍の差が生じるという。
これこそが、今日の計算リソース不足の根底にある問題だ。
単にチャットボットに何度か質問を投げかけたからではない。
ソフトウェアが、ファイルを繰り返し読み込み、コマンドを実行し、コードを修正し、失敗してはやり直し、さらに失敗しては再挑戦する、小さな労働者の集団へと変わり始めているのだ。彼らには昼休みはないが、一歩ごとにトークンを消費している。
トークンが電力メーターのようなものになったとき、発電所を所有する者が権力を持つ。しかし、電力を無駄にする者は、誰よりも先に問い詰められることになる。
請求額が膨らめば、安価なモデルに居場所が生まれる
CFOがこの電力メーターに目を向け始めれば、次のステップは教えられるまでもない。
彼は問うだろう。どのタスクに最強のモデルが必要で、どのタスクは十分な性能のモデルで済むのか、と。
その時、GLM、Kimi、DeepSeek、Qwenといったオープンソースモデルは、単なる技術ニュースではなくなる。それらは、企業の調達テーブルに並ぶ値切りツールへと変わるのだ。
シリコンバレーのトップVCであるa16zのマーク・アンドリーセンでさえ、多くのAI関係者がすでに智譜GLM-5.2を、多くのタスクで米国のトップ公開モデルに匹敵、あるいは凌駕する最初の中国モデルの一つと見なしていると語っている。この評価が最終的な判断とは限らないが、企業に新たな選択肢を与えるものだ。
Coinbaseはさらに強力な事例を示している。ブライアン・アームストロング氏によると、同社はデフォルトのAIモデルをGLM 5.2やKimi 2.7といったオープンソースモデルに切り替え、モデルルーティング、キャッシュ、コンテキストの簡略化を組み合わせた結果、トークン使用量は指数関数的に増加しているにもかかわらず、AI支出はほぼ半減したという。
この発言の破壊力は、企業が初めてモデルの能力を分解して調達できるようになった点にある。
最も難しいタスクは、引き続き最も高価なモデルに任せる。一般的な要約、カスタマーサポート、情報抽出、テンプレート化されたコード、社内ナレッジベースのQ&Aは、安価なモデルやローカルデプロイに任せる。
オープンソースモデルは、すべての戦場で勝利する必要はない。
調達部門に、すべての電力に高級住宅地の電気代を払う必要はないと納得させられればそれで十分だ。
ここに至って、Metaの計算リソース販売は、もはや孤立したニュースではなくなる。
これは、Palantirがトークンを批判し、Coinbaseがオープンソースモデルを語っているのと同じ話だ。つまり、AIの支出チェーンが分解され始めている。上流は確実性を売り、中流は結果を売り、下流は単価を押し下げる。どの層もまだ成長しているが、どの層も「この金は本当に価値があるのか」と問われ始めている。
最も難しいのは機械を買うことではなく、機械に常に仕事をさせることだ
過去2年間、AI業界で最も語りやすいストーリーは「リソース不足」だった。
GPUが足りない、電力が足りない、データセンターが足りない、エンジニアが足りない、モデルを動かせるクラウドも足りない。このストーリーはあまりにも順調だった。何かが足りなければ、誰もが本能的に突っ走る。まずポジションを確保し、まず電力を契約し、まずチップを買い、まず機械を設置する。
リソースを奪い合うとき、人は細かい計算をあまりしない。
なぜなら、一歩遅れる代償の方が大きく見えるからだ。
しかし、Metaのこのニュースは別の問題を浮き彫りにした。機械を買い戻しても、高価だからといって自動的に良いビジネスになるわけではない。毎日仕事があり、代金を払ってくれる顧客がいて、それをフル活用するモデルがあり、コストを収益に変えるアプリケーションがなければならない。
これが稼働率だ。
稼働率という言葉は冷たく聞こえるが、実は非常に残酷だ。それは「あなたに未来があるか」ではなく、「今日、この機械は稼働しているか」を問う。発表会で何を言ったかや、最も高価なGPUを買ったかどうかは気にしない。ただ一つだけを見る。その金が持続的なキャッシュフローに変わったかどうかを。
クラウドベンダーはこの問いに比較的簡単に答えられる。彼らは元々インフラを売っている。AWS、Google Cloud、Azureは道路、電気、サーバールームを売っている。顧客がモデルを訓練し、推論を実行し、アプリケーションをホストするには、最終的にどこかのクラウドに依存することになる。
だから彼らは依然として強気でいられる。
強力なモデル企業も独自の答えを持っている。モデルが十分に強力であれば、ユーザーは列を作って待ち、企業は導入し、開発者はワークフローを変更してでもそれに合わせる。そうなれば、計算能力は在庫ではなく、ボトルネックとなる。機械が多ければ多いほど、より広範囲に活用できる。
最も難しいのは中間層だ。
彼らは機械、ストーリー、モデルチーム、そして大きな予算を持っている。しかし、モデルは最前線に到達しておらず、製品は日常的な習慣になっておらず、開発者もワークフローを変更してまでそれに合わせようとはしない。このような企業にとって、計算能力は武器から在庫に変わる。それはたった一度のモデルリリースの失敗や、一度のユーザー移行で起こり得る。
在庫が必ずしも無価値とは限らない。
しかし、在庫は値下げしなければならず、貸し出さなければならず、新たな用途を見つけなければならない。
これこそが、Metaが計算能力を売却する際に目立つ点だ。これはMetaの失敗を証明するものでも、AI需要の消失を証明するものでもない。ただ、市場が初めて目にするのは、AIインフラも普通の工場が直面する問題に遭遇するということだ。
工場は完成したが、注文はどこにあるのか。
計算能力は消えたわけではなく、層別化が始まっただけ
したがって、この出来事を最もよく理解する方法は「計算能力の過剰」ではない。
この言葉はあまりにも大雑把だ。
より正確な言い方をすれば、計算能力の層別化が始まったのだ。
最上層は依然として逼迫している。最強のモデル、最高のクラウド、最も安定したGPUクラスターは、依然として奪い合いが続く。AWSのサービスが値上げできるのは、確実性そのものに価格がついているからだ。顧客は単にGPUを買うのではなく、特定の日、特定の時間、特定のバッチのマシンが必ず使えることを買っている。
中間層は、微妙な立場にある。悪くはないが、希少性が足りない。モデルを実行でき、推論もでき、外部顧客にも販売できる。ただ、顧客は比較し、値切り、なぜもっと安いモデルを使わないのか、なぜ他人のクラウドを使わないのか、なぜこのバッチのマシンがこの価格に見合うのかと問うだろう。
最下層は、オープンソースモデルとコスト最適化によって少しずつ圧迫される。企業は通常のタスクのために常に最も高価なモデルを呼び出すことはない。ルーティングを行い、キャッシュを活用し、コンテキストを圧縮し、モデルを異なるグレードに分割するだろう。
需要は成長した。
子供は請求書を見ずに買い物をするが、大人は見る。AIが企業に導入されると、このプロセスも経験する。試行段階では、誰もが機会を逃すことを恐れる。規模拡大段階では、誰もが計算を始める。
計算が始まると、産業チェーンは初期のように整然とはいかなくなる。
ある者は値上げを続ける。なぜなら、彼らは代替不可能な確実性を売っているからだ。ある者は結果を売るように変える。なぜなら、顧客は消費そのものに対して支払いたくないからだ。ある者は値下げを余儀なくされる。なぜなら、十分使える代替品が現れたからだ。ある者はマシンを貸し出す。なぜなら、マシンが遊休状態にあることは、低価格で貸し出すよりも見苦しいからだ。
これらのことが同時に起こると、業界は矛盾しているように見える。
一方では計算能力の逼迫。
他方では計算能力の貸し出し。
一方ではトークン消費の急増。
他方では企業によるAI支出の抑制。
一方では、トップモデルがますます強力になっている。
もう一方では、オープンソースモデルがますます安価になっている。
これらは矛盾しない。単に、AIが総量のストーリーから構造のストーリーへと移行していることを示しているだけだ。
古い鉄道の物語は、もう一度語られるだろう
19世紀の鉄道バブルにおいて、鉄道自体は偽物ではなかった。
線路が敷かれれば、実際に貨物は動き、都市は成長し、時間は短縮された。後に最も価値のある商業ネットワークの多くは、確かにそれらの線路のそばに築かれた。
しかし、それでも当時、多くの鉄道建設者が損をしたことは変わらない。
彼らが負けたのは方向性ではない。早すぎた建設、多すぎた建設、旅客や貨物の流れがない場所への建設、あるいは回収に時間がかかりすぎる路線に高すぎる資金を借りて建設したことだ。
インターネットバブルにおける光ファイバーも同じだ。光ファイバー自体は間違っていなかった。後に世界全体がそれによって支えられた。間違っていたのは、あの帳簿だ。未来数十年の需要を、一度に数年の設備投資に詰め込んでしまったのだ。
AIデータセンターも、多くの有用なものを残すかもしれない。GPUは減価償却され、電力契約は更新され、データセンターは機器を交換し、ソフトウェアはますます計算リソースを消費するようになる。今日では誇張に見えるトークン消費も、数年後には高精細動画のトラフィックのように普通になるかもしれない。
しかし、資産には独自の性質がある。
それは、未来を信じるかどうかには関心がない。ただ、毎日誰かが使うかどうかだけを気にする。
Metaが計算リソースを販売するというシグナルは、まさにこの点にある。
それはAIの終着点ではない。半導体の終着点でもない。それはむしろ、設備投資のストーリーが中盤に差し掛かった時、初めて誰かがドアを開け、外の人々に倉庫の中にどれだけの機械があるかを見せたようなものだ。
一部の機械は、トップモデルに消費されるだろう。
一部の機械は、クラウド顧客にレンタルされるだろう。
一部の機械は、価格競争の中で安くなるだろう。
そして、まだ登場していないアプリケーションを静かに待つ機械もあるだろう。
過去2年間、市場はすべての機械が最終的に自らの運命を迎えると信じる傾向にあった。今、市場は問い始めている。誰が先に運命を迎えるのか、誰が迎えられないのか、そして迎えても十分な利益を得られないのは誰なのか、と。
この問いが浮上した瞬間、AIのストーリーは変わった。
それはもはや、最も早く機械を購入した者だけのものではない。
それは、機械を回し続けられる者のものだ。
原文リンク
BlockBeats の公式コミュニティに参加しよう:
Telegram 公式チャンネル:https://t.me/theblockbeats
Telegram 交流グループ:https://t.me/BlockBeats_App
Twitter 公式アカウント:https://twitter.com/BlockBeatsAsia

 関連記事